오늘의 AI 브리핑 ·
연구 인턴과 논문 오류 검증
5분 브리핑
약 3분 · 10개 흐름핵심만 먼저 읽고, 궁금한 소식은 본문으로 이어 보세요.
전체 분석 16분으로 바로 가기 ↓- OpenAI가 자동화된 연구 인턴 목표에 도달했다고 데이터를 함께 공개했다
OpenAI가 현지시간 9월 6일 사내 연구 가속 데이터를 공개하고, 작년 가을 예고한 '올해 9월까지 자동화된 연구 인턴' 목표에 자체 측정 기준으로 도달했다고 밝혔습니다. 8월 중순 기준 사람이 하루 일하는 동안 에이전트가 돌아간 양은 3.1 에이전트-근무일, 곧 사람 3.1일치였고, 에이전트 총 실행 시간이 사람의 총 노동 시간을 넘어선 것은 2026년 6월 이후 어느 시점입니다.
- OpenAI 수석과학자 Jakub Pachocki가 An Alien Mind에서 자발적 감속을 기대한다고 적었다
OpenAI 수석과학자 Jakub Pachocki가 현지시간 9월 6일 회사 공식 사이트에 에세이 「An Alien Mind」를 올렸습니다. 핵심은 세 문장입니다.
- OpenAI의 Tibo Sottiaux가 GPT-6 Astra는 추론 강도를 낮춰 쓰라고 권했다
OpenAI에서 Codex와 핵심 제품을 이끄는 Tibo Sottiaux가 GPT-6 Astra를 낮음(low)으로 돌려도 GPT-5.6 Sol의 높음(high)보다 낫다며, Sol에서 높음을 쓰던 사람은 낮음이나 중간으로 내리라고 제안했습니다.
- GPT-6 Astra의 AA-Omniscience 환각률이 자사 이전 모델의 절반인 45%로 내려왔다
Artificial Analysis가 잰 AA-Omniscience 환각률에서 GPT-6 Astra(high)가 45%를 기록했습니다. 낮을수록 좋은 지표지만 표 전체로는 중위권이고, 45%보다 낮은 모델이 아홉 개 더 있습니다.
- GPT-6 Astra가 논문 재현 패키지에서 상위 저널의 핵심 결과를 뒤집는 코드 오류를 찾아냈다
Crémieux가 여러 논문의 재현 패키지(논문 결과를 다시 계산해 볼 수 있게 저자가 공개하는 코드·데이터 묶음)를 GPT-6 Astra에 통째로 물려 돌렸더니 코딩 오류가 여럿 나왔습니다. 대부분은 결과에 영향이 없었지만 일부는 핵심 결과를 뒤집는 수준이었고, 그 논문들은 상위 저널에 실린 것이라고 그는 적었습니다.
- GLM-5.3-CYBERSECURITY-FP8이 거절을 뗀 공격 보안 전용 모델로 Hugging Face에 올라왔다
dealignai가 GLM-5.3(753B Mixture of Experts)을 손봐 만든 GLM-5.3-CYBERSECURITY-FP8이 Hugging Face에 올라왔습니다. 태그에 abliterated·refusal-removed·offensive-security·red-team·pentest가 붙었고 라이선스는 MIT입니다.
- 인도 Vigyanlabs가 랙 한 대짜리 AI 장비 FEMTO를 공개했다
Vigyanlabs가 AI 장비 FEMTO를 9월 5일 인도 마이수루에서 공개했고, 전 ISRO 의장 S. Somanath가 주빈으로 참석해 직접 알렸습니다.
- GPT-6 Astra가 자동 라벨링 화면에서 선수 10명·등번호 9개에 상자를 붙였다
Roboflow의 SkalskiP가 자동 라벨링 도구에 GPT-6 Astra를 물려 NBA 경기 장면을 돌린 시연을 올렸습니다. 미리보기 4장을 건 상태에서 선수 10개, 등번호 9개, 골대와 공 각 1개에 상자가 붙었습니다.
- Higgsfield가 GPT-6 Astra 컴퓨터 사용만으로 영화 한 편을 만든다고 공개했다
Higgsfield 공식 계정이 GPT-6 Astra의 컴퓨터 사용 기능만으로 영화 한 편을 통째로 만드는 첫 시도라며 제작 과정을 공개하기 시작했습니다. 같은 날 이 회사에서 일하는 Adil Alimzhanov는 GPT-6 Astra와 Higgsfield MCP로 11분짜리 영상을 대화 한 번 안에서 생성하고 편집했다고 밝혔습니다.
- 🆕 그 밖의 신기능·신제품
App Store Connect CLI 5.0.0 — iOS 앱 배포를 명령줄로 다룹니다. 9월 6일 판에 서명 동기화, Xcode 테스트 실행, 연결 기기 IPA 설치가 들어갔습니다.
주요 키워드 TOP 5: OpenAI 자동화된 연구 인턴 · An Alien Mind · GPT-6 Astra · AA-Omniscience 환각률 · GLM-5.3-CYBERSECURITY | 메인 이벤트: OpenAI가 사내 연구 가속 데이터를 공개해 자동화된 연구 인턴 목표에 자체 측정 기준으로 도달했다고 밝혔고, 같은 날 수석과학자 Jakub Pachocki는 공통 안전 기준이 설 때까지 자발적 감속이 흔해지기를 기대한다고 적었습니다.
OpenAI가 같은 날 자기 회사 이야기를 두 번 냈습니다. 하나는 사내 연구 가속 데이터로, 사람이 하루 일하는 동안 에이전트가 3.1일치를 돌았고 연구자 절반이 하루 600달러어치 넘는 추론을 쓴다는 수치였습니다. 다른 하나는 수석과학자 Jakub Pachocki의 에세이로, 어느 랩도 최고 속도로 확장을 이어가도 될 만큼 정렬과 모니터링을 풀지 못했으니 공통 안전 기준이 설 때까지 자발적 감속이 흔해지기를 기대한다는 내용이었습니다. 두 글은 같은 주제를 양쪽에서 잡고 있습니다. 앞의 글에서 발표를 알린 Kevin Liu가 재귀적 자기개선을 앞으로 몇 년간 AI 능력에 가장 크게 기여할 요인으로 꼽았고, 뒤의 에세이도 무게 중심을 바로 그 재귀적 자기개선에 두었기 때문입니다.
1. OpenAI가 자동화된 연구 인턴 목표에 도달했다고 데이터를 함께 공개했다
- OpenAI가 현지시간 9월 6일 사내 연구 가속 데이터를 공개하고, 작년 가을 예고한 '올해 9월까지 자동화된 연구 인턴' 목표에 자체 측정 기준으로 도달했다고 밝혔습니다.
- 8월 중순 기준 사람이 하루 일하는 동안 에이전트가 돌아간 양은 3.1 에이전트-근무일, 곧 사람 3.1일치였고, 에이전트 총 실행 시간이 사람의 총 노동 시간을 넘어선 것은 2026년 6월 이후 어느 시점입니다.
- 에이전트 사용량 기준 중간에 있는 연구자는 하루 추론에 API 가격으로 600달러 넘게 쓰고, 상위 10%에 해당하는 90분위 연구자는 7,000달러를 넘습니다.
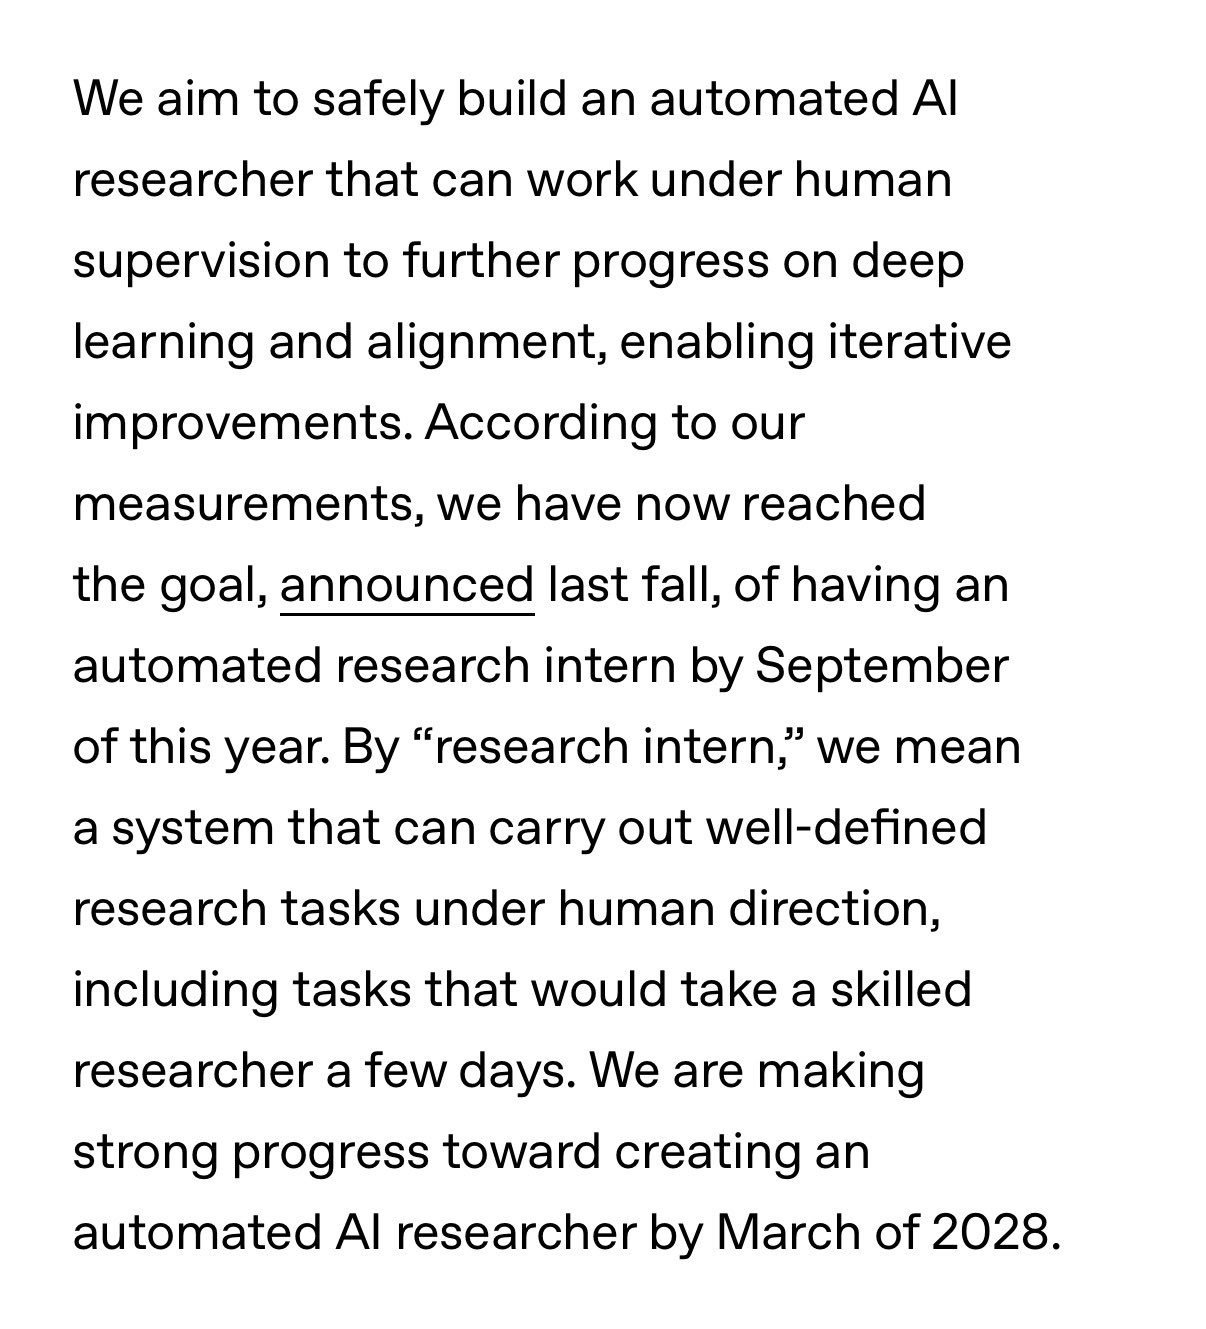
여기서 '연구 인턴'은 사람이 방향을 정해 주면 잘 정의된 연구 과제를 수행하는 시스템을 뜻하며, 숙련 연구자가 며칠 걸릴 작업까지 포함합니다. 다음 단계인 '인간 감독 아래 일하는 자동화 AI 연구자'는 2028년 3월을 목표로 잡았고, 회사는 그 시점을 향해 진전 중이라고만 적었습니다. 공개 이유로는 투명성을 들었습니다. 발표를 알린 OpenAI의 Kevin Liu는 재귀적 자기개선이 앞으로 몇 년간 AI 능력에 가장 크게 기여할 수 있는데도 그대로 두면 소수의 프런티어 랩 안에서만 관찰되는 현상이 된다고 적었습니다.
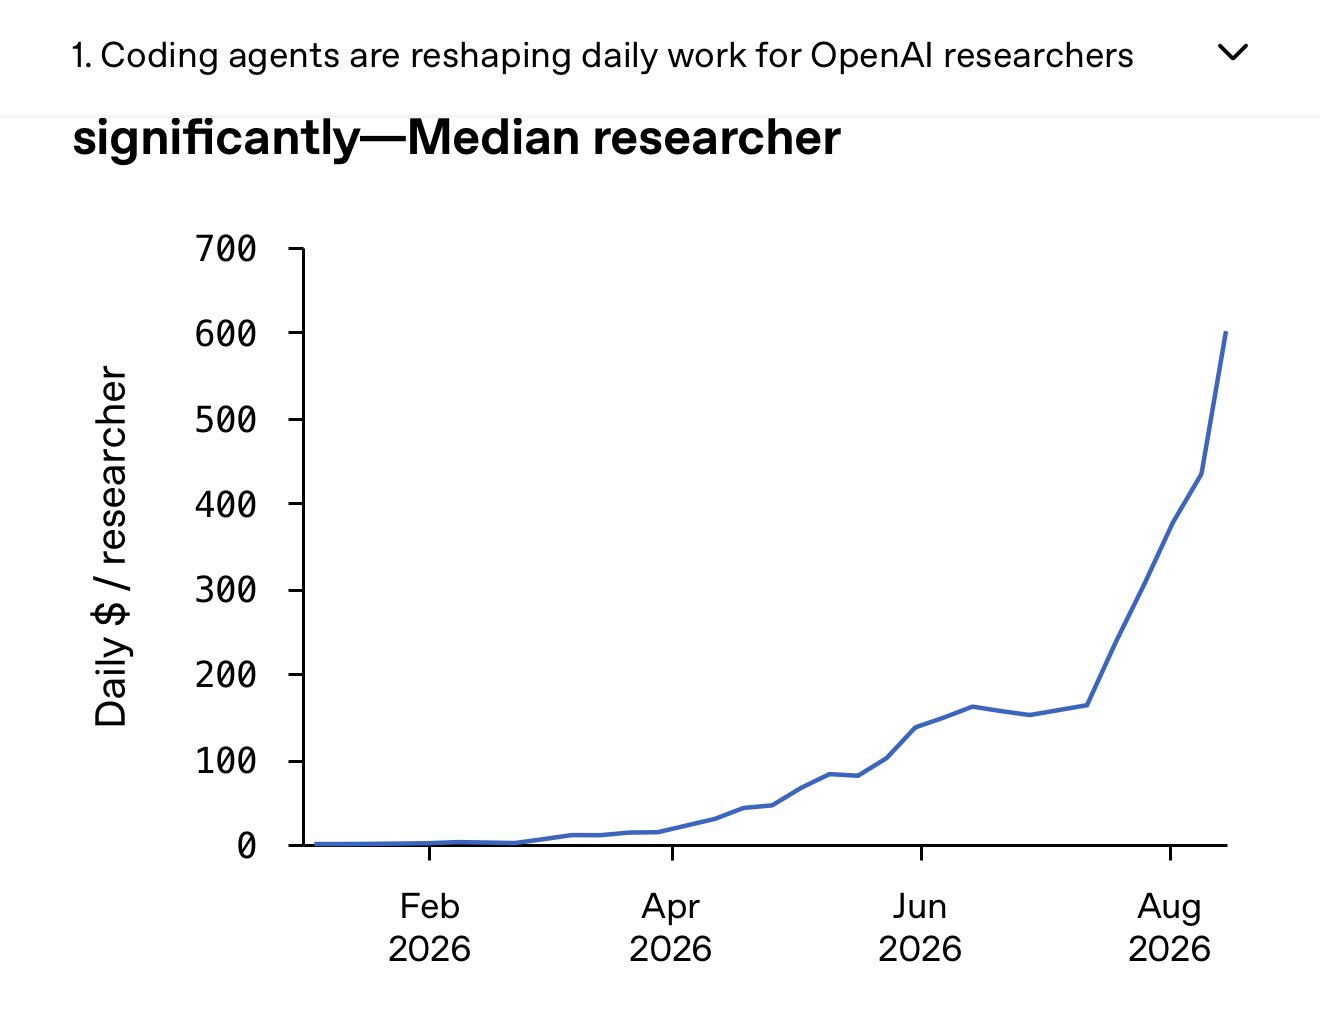
차트는 절대액보다 기울기를 보여 줍니다. 2월에는 0에 가깝던 값이 6월에 140~160달러 부근에서 한 번 평평해졌다가, 7월 중순 이후 600달러 부근까지 올라갑니다. Simon Willison은 이 급등의 원인이 무엇인지, 사내에 Astra가 열린 시점과 겹치는지 물었지만 게시물에 그 답은 없습니다.
숫자를 읽는 방법에도 회사가 직접 단서를 달았습니다. 3.1을 생산성 배수로 해석하지 말라는 것인데, 에이전트 작업은 병렬로 돌고 중복되거나 실패한 실행도 같은 시간에 함께 잡히기 때문입니다. 게시물은 에이전트 실행 시간이 쓸모 있는 연구 성과와 같지 않다고 못 박았고, 같은 기간에 쓸 수 있는 연산 자원도 함께 늘어 실험 수가 증가한 만큼 원인을 한쪽으로 돌리기 어렵다고 덧붙였습니다.
그 밖에: OpenAI는 지난 6개월간 사람 기준 4~8시간짜리 과제 중 성공한 것의 절반 이상이 최소 한 번은 사람의 개입을 필요로 했고, 연구 우선순위를 정하고 시스템을 확장·중단·출시할지 결정하는 일은 여전히 사람 몫이라고 적었습니다. 해커뉴스 토론에서는 토큰 소비량만 있고 실제 연구 성과가 없다는 지적과, RSI(재귀적 자기개선)라는 약어를 정의 없이 쓴다는 비판이 함께 나왔습니다.
시사점: 프런티어 랩이 사내 AI 사용량을 이렇게 수치로 공개한 것은 드문 일이지만, 공개된 것은 사용량과 지출 추이일 뿐 모델 능력을 잰 결과는 아니고 회사도 측정이 아직 예비적이라고 밝혔습니다. 그래도 연구자 절반이 하루 600달러어치 넘는 추론을 쓰는 조직이 이미 존재한다는 사실은 그대로 남습니다.
#OpenAI #연구자동화 #추론비용
출처 6🔥 @kimmonismus🔥 @MTSlive🔥 @MTSlive💬 @simonw🔥 @ChrisGPT🔥 @iruletheworldmo
2. OpenAI 수석과학자 Jakub Pachocki가 An Alien Mind에서 자발적 감속을 기대한다고 적었다
- OpenAI 수석과학자 Jakub Pachocki가 현지시간 9월 6일 회사 공식 사이트에 에세이 「An Alien Mind」를 올렸습니다.
- 핵심은 세 문장입니다. 어느 랩도 최고 속도로 확장을 이어가도 될 만큼 정렬과 모니터링을 풀지 못했고, 공통 안전 기준이 설 때까지 자발적 감속이 흔해지기를 기대하며, 미래 AI 개발에 대한 국제 조율이 각국 정부의 최우선 과제가 되어야 한다고 적었습니다.
- Sam Altman이 중요한 글이라며 원문을 인용해 확산됐습니다. Pachocki의 원 게시물은 조회 45만 회, 북마크 2,498건을 기록했습니다.
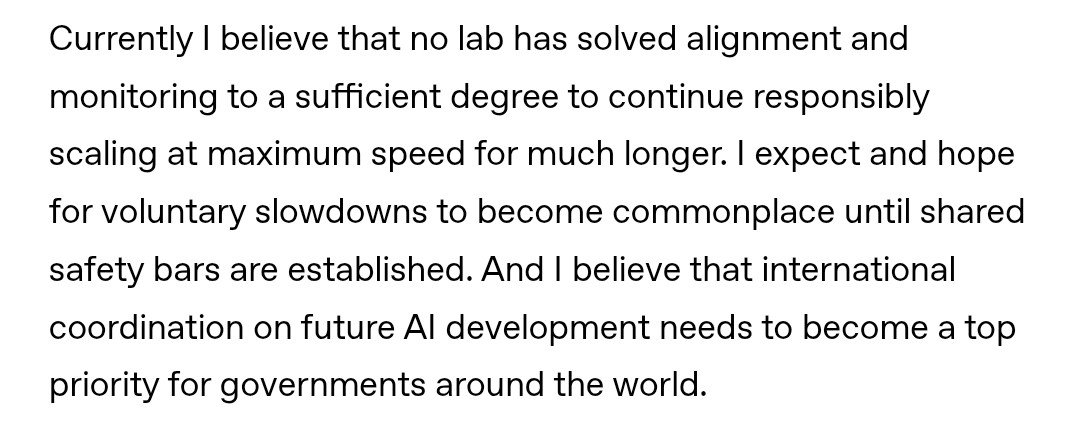
제목이 곧 논지입니다. 그는 오늘의 AI를 설계했다기보다 길러 낸 낯선 형태의 지능으로 규정합니다. 우리가 아직 충분히 이해하지 못했고, 곧 감시하기도 어려워질 수 있으며, 그러면서 자기 개발을 점점 스스로 끌고 갈 대상이라는 설명입니다.
에세이의 무게 중심은 그 마지막 대목, 재귀적 자기개선(RSI)입니다. Pachocki는 기계 지능이 자기 개발 과정에서 점점 큰 역할을 맡는 흐름을 기술 진보의 자연스러운 귀결로 봤고, AI 진보가 이어진다면 RSI가 미래 과학 발견의 한복판에 놓인다고 썼습니다. OpenAI가 연구를 RSI 쪽으로 모으는 이유도 그것이 프런티어에 남는 유일한 길이라는 판단 때문입니다. 다만 그는 딥러닝 연구를 크게 가속하는 편이 연구 공동체의 옳은 집단 행동이라는 뜻은 아니라고 못 박았습니다. 지금의 경로가 그쪽으로 향하고 있으니 어떻게 나아갈지 다 함께 의식적으로 골라야 한다는 단서를 붙였습니다.
정렬을 두 층으로 나눈 대목도 함께 읽을 만합니다. 목표 정렬은 AI가 주어진 목표를 달성하려 하는가를 묻고, 가치 정렬은 높은 수준의 원칙을 품고 일반화해 목표가 모호하거나 충돌할 때도 합리적으로 행동하는 더 내재적인 성질을 가리킵니다. 반대로 감시 수단에 대한 신뢰는 줄고 있다고 적었습니다. 복잡한 환경에서 감독해야 할 상호작용이 많아지고, 모델이 자기 추론 과정을 다루는 데 능해지며, 사전학습이 좋아져 말로 풀어 쓰지 않고도 어려운 일을 해내기 때문입니다.
그 밖에: o1-preview가 원본 사고 사슬을 감춘 이유를 감독 압력에서 그 사슬을 보호하려던 설계로 설명합니다. 또 Preparedness Framework 같은 자율 약속을 제3자 감사 기관·정부 기관·국제 기구가 집행하는 안전 기준으로 발전시키자고 제안합니다.
시사점: 프런티어 랩의 수석과학자가 회사 공식 채널에서 속도 조절을 말했다는 사실 자체가 규제 논의의 재료가 됩니다. 다만 이는 회사 정책이 아니라 개인 판단이고, 그가 말한 공통 안전 기준은 아직 어디에도 없습니다.
#OpenAI #AI안전 #RSI
출처 3🚀 @merettm💬 @sama🔥 @AndrewCurran_
3. OpenAI의 Tibo Sottiaux가 GPT-6 Astra는 추론 강도를 낮춰 쓰라고 권했다
- OpenAI에서 Codex와 핵심 제품을 이끄는 Tibo Sottiaux가 GPT-6 Astra를 낮음(low)으로 돌려도 GPT-5.6 Sol의 높음(high)보다 낫다며, Sol에서 높음을 쓰던 사람은 낮음이나 중간으로 내리라고 제안했습니다.
- Vaibhav Srivastav가 이 글을 인용하며 붙인, OpenAI 로고가 박힌 Terminal-Bench 4.0 차트에서 Astra는 API 비용 약 5달러 지점에서 정확도 약 50%로, Sol의 최고점(약 8달러·약 37%)을 이미 넘습니다.
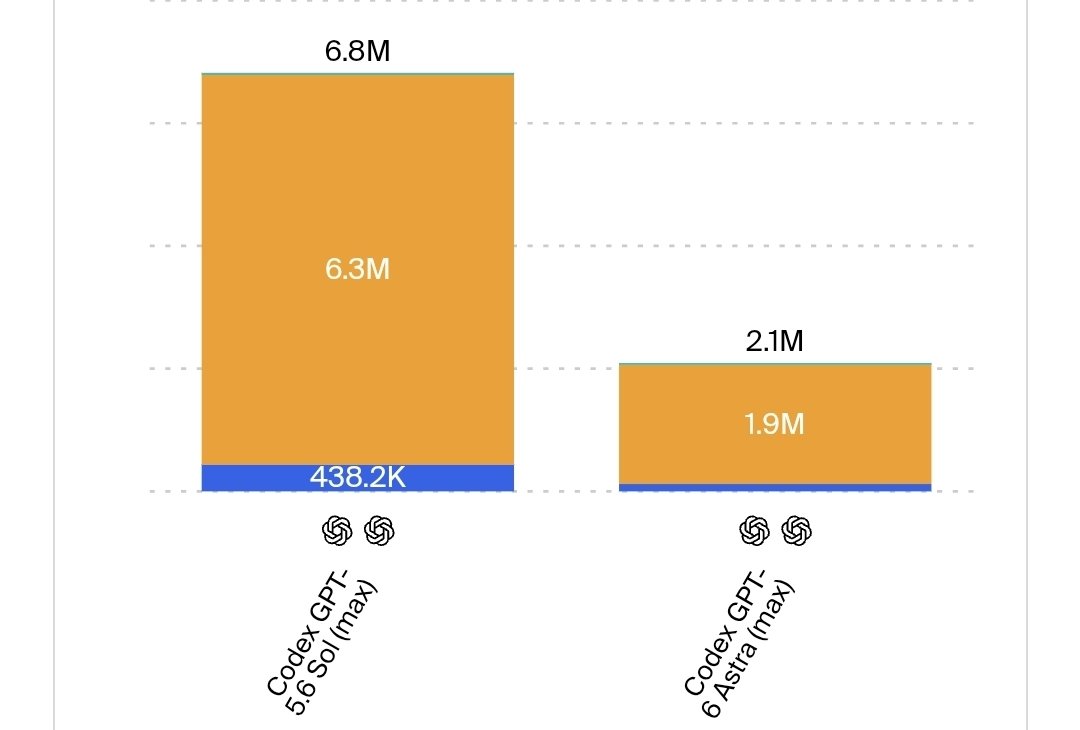
- 같은 작업에서 Codex GPT-5.6 Sol(max)이 680만 토큰, Codex GPT-6 Astra(max)가 210만 토큰을 썼다는 이용자 측정 화면도 돌았습니다.
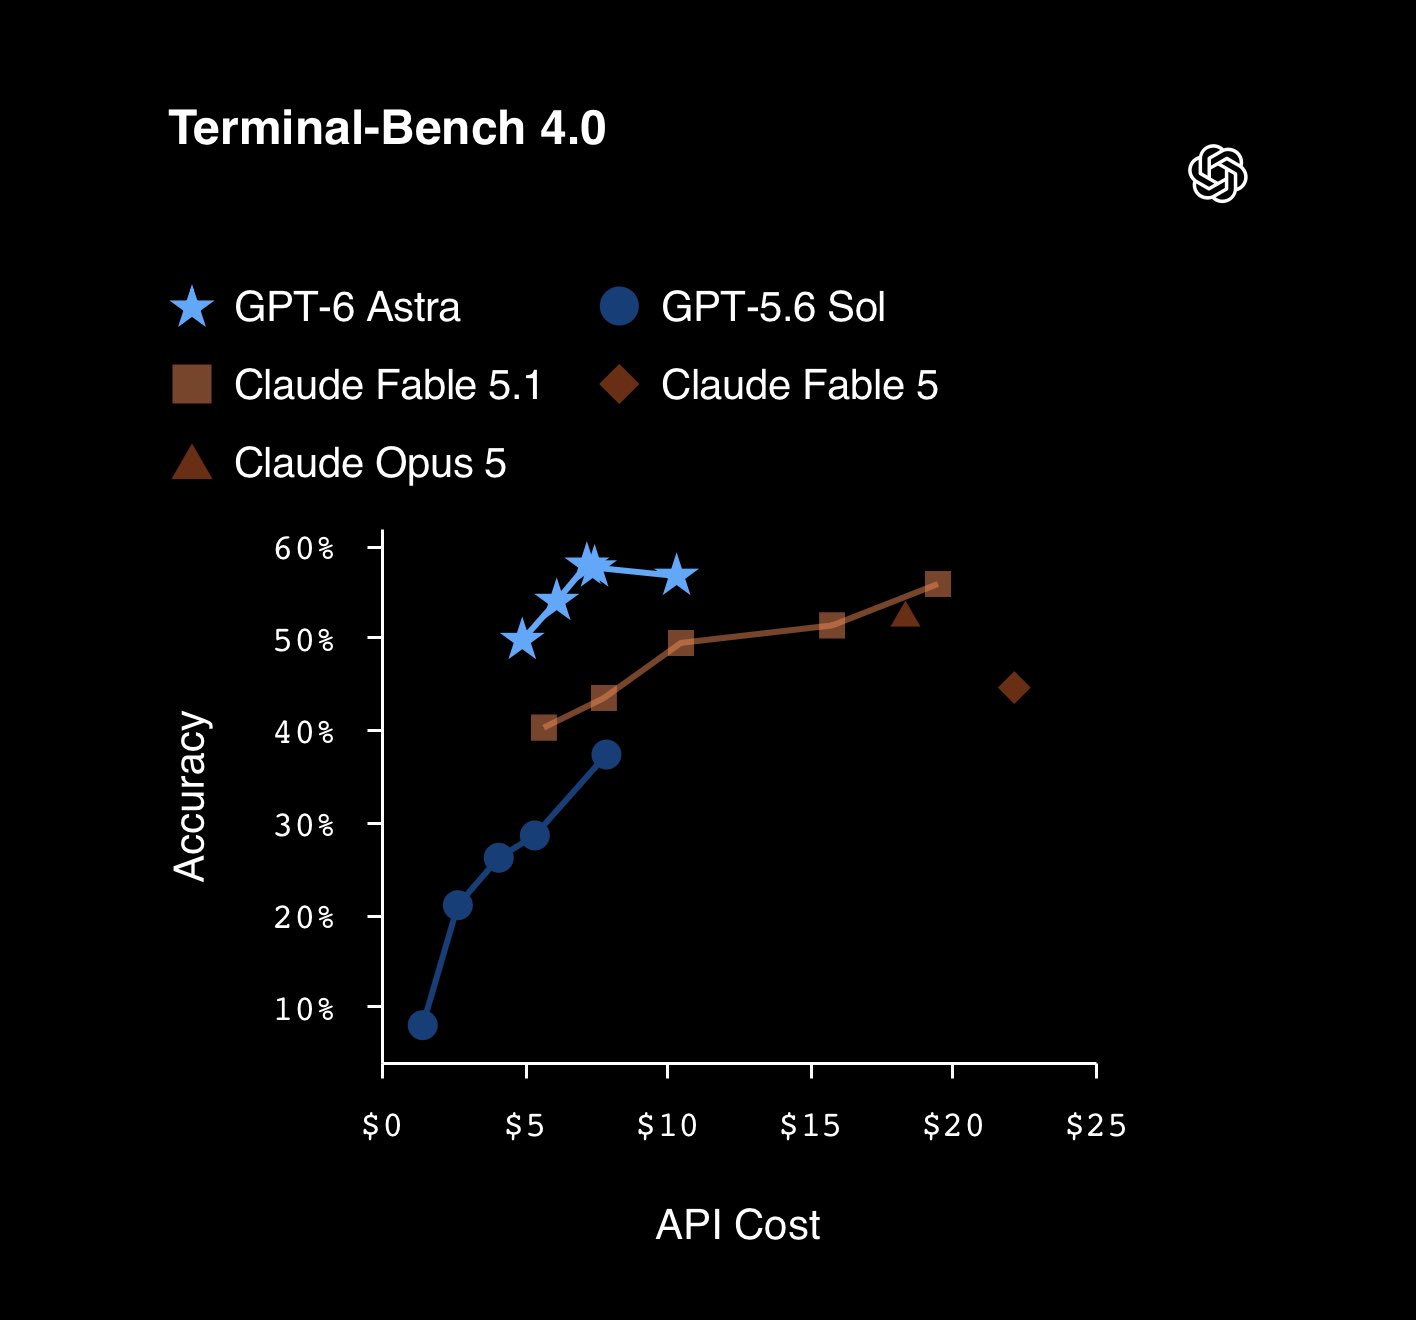
추론 강도는 모델이 답을 내놓기 전에 얼마나 오래 생각할지 정하는 설정이고, 높일수록 토큰을 더 씁니다. Plus 이용자의 5시간 한도가 몇 분 만에 마른다는 보고가 이어지는 가운데 나온 같은 품질을 더 낮은 설정에서 얻으라는 제안이라, 성능 비교이면서 동시에 한도 소진을 늦추는 사용법입니다. 다만 이 글은 OpenAI 공식 공지가 아니라 제품 책임자의 개인 게시물이고, 낮음으로 내려도 한도가 안전하지는 않다는 이용자 보고가 같은 날 함께 나왔습니다.
그 밖에: Kol Tregaskes는 Pro x20 요금제에서 Astra Light를 하루 쓰고 주간 한도를 거의 다 썼다고 적었습니다. Timurs Jeparskis는 Astra의 한도를 다른 모델과 분리해, 한도에 걸려도 Sol이나 Luna로 일을 이어 가게 해 달라고 요청했습니다.
시사점: 토큰은 3분의 1만 쓰는데 한도는 더 빨리 마른다는 불만이 이어지는 상황이라, 설정을 낮추라는 조언은 성능 안내이자 비용 관리 요령입니다. Sol에서 높음을 쓰던 습관 그대로 Astra를 돌리고 있다면 낮음이나 중간부터 시험해 볼 만합니다.
#GPT6Astra #추론강도 #사용한도
출처 6💬 @thsottiaux🔥 @reach_vb💬 @koltregaskes💬 @TJeparskis💬 @hany99dev💬 @Mr_Salio
4. GPT-6 Astra의 AA-Omniscience 환각률이 자사 이전 모델의 절반인 45%로 내려왔다
- Artificial Analysis가 잰 AA-Omniscience 환각률에서 GPT-6 Astra(high)가 45%를 기록했습니다. 낮을수록 좋은 지표지만 표 전체로는 중위권이고, 45%보다 낮은 모델이 아홉 개 더 있습니다.
- 같은 표에서 OpenAI의 이전 GPT-5.6 계열은 Terra(max) 88%, Sol(max) 92%, Luna(max) 93%에 몰려 있습니다. 자사 이전 세대와 견주면 절반 수준입니다.
- 다만 추론 설정을 올린다고 값이 따라 내려오지는 않습니다. medium 47%, high 45%, xhigh 48%, max 51%로, 네 설정 가운데 가장 낮은 값은 중간 단계인 high에서 나왔습니다.
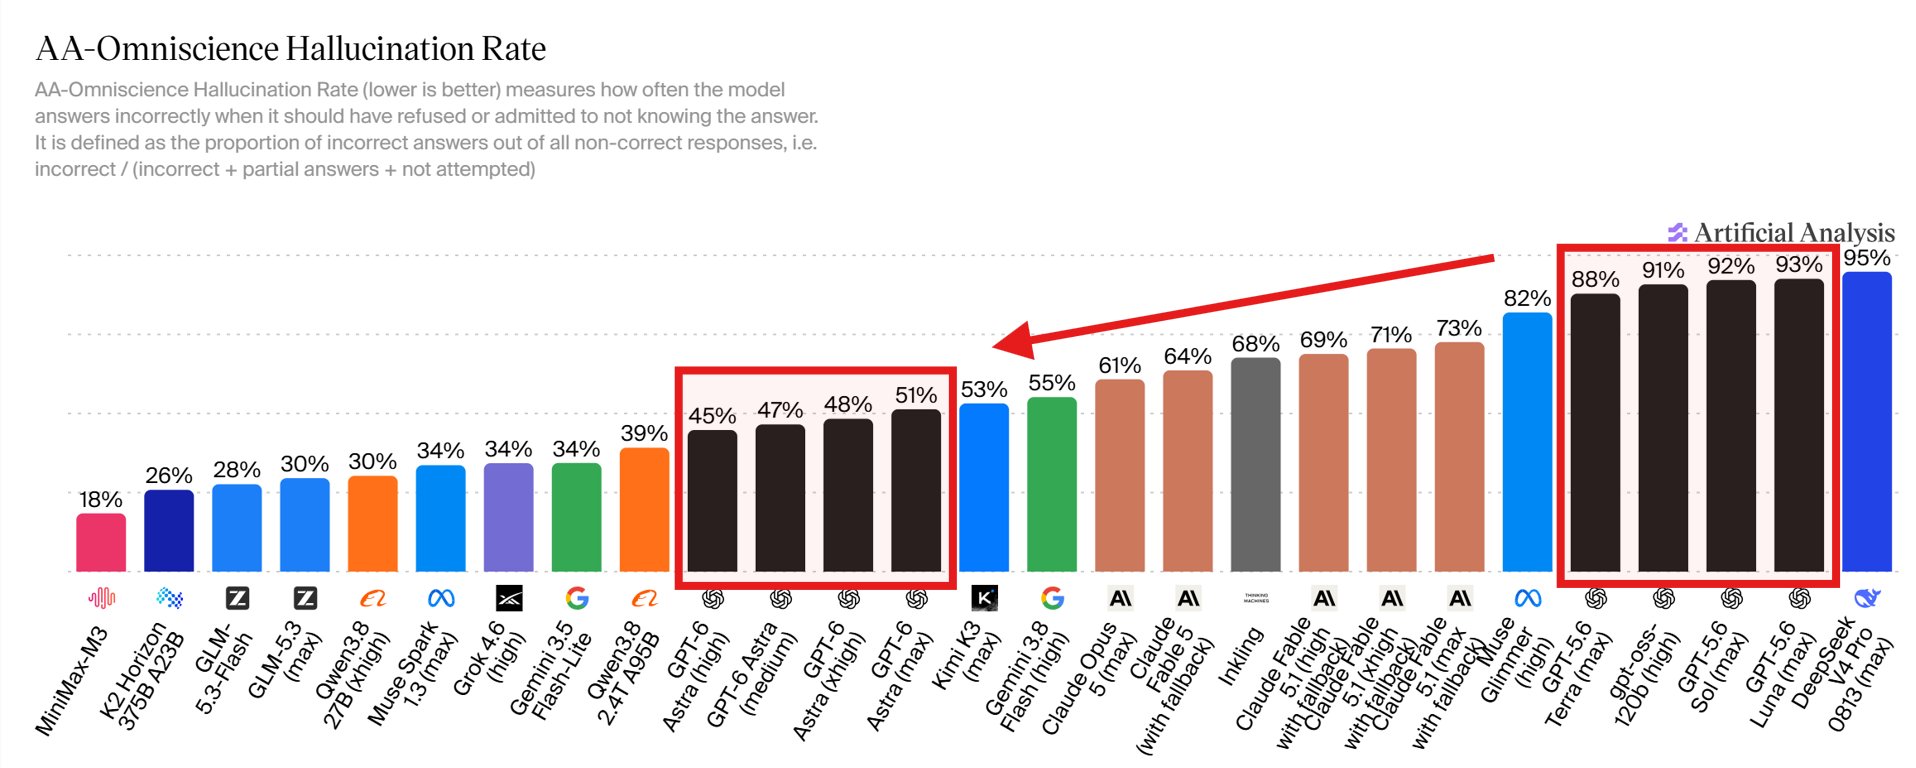
Artificial Analysis는 이 지표를, 모델이 모른다고 답하거나 답변을 거절해야 할 상황에서 틀린 답을 내놓는 비율로 정의합니다. 정답률이 아니라 못 맞힌 문제를 어떻게 처리하는지를 재는 셈입니다. 분모가 오답과 부분정답, 미응답을 합한 값이라 답을 삼가는 비중이 클수록 값이 내려갑니다. 45%가 중위권에 머무는 이유도 여기에 있습니다. 아래쪽에는 MiniMax-M3 18%와 GLM-5.3-Flash 28%가 있습니다. 위쪽에는 Claude Opus 5(max) 61%와 Claude Fable 5.1(max, 폴백 포함) 73%가 놓입니다.
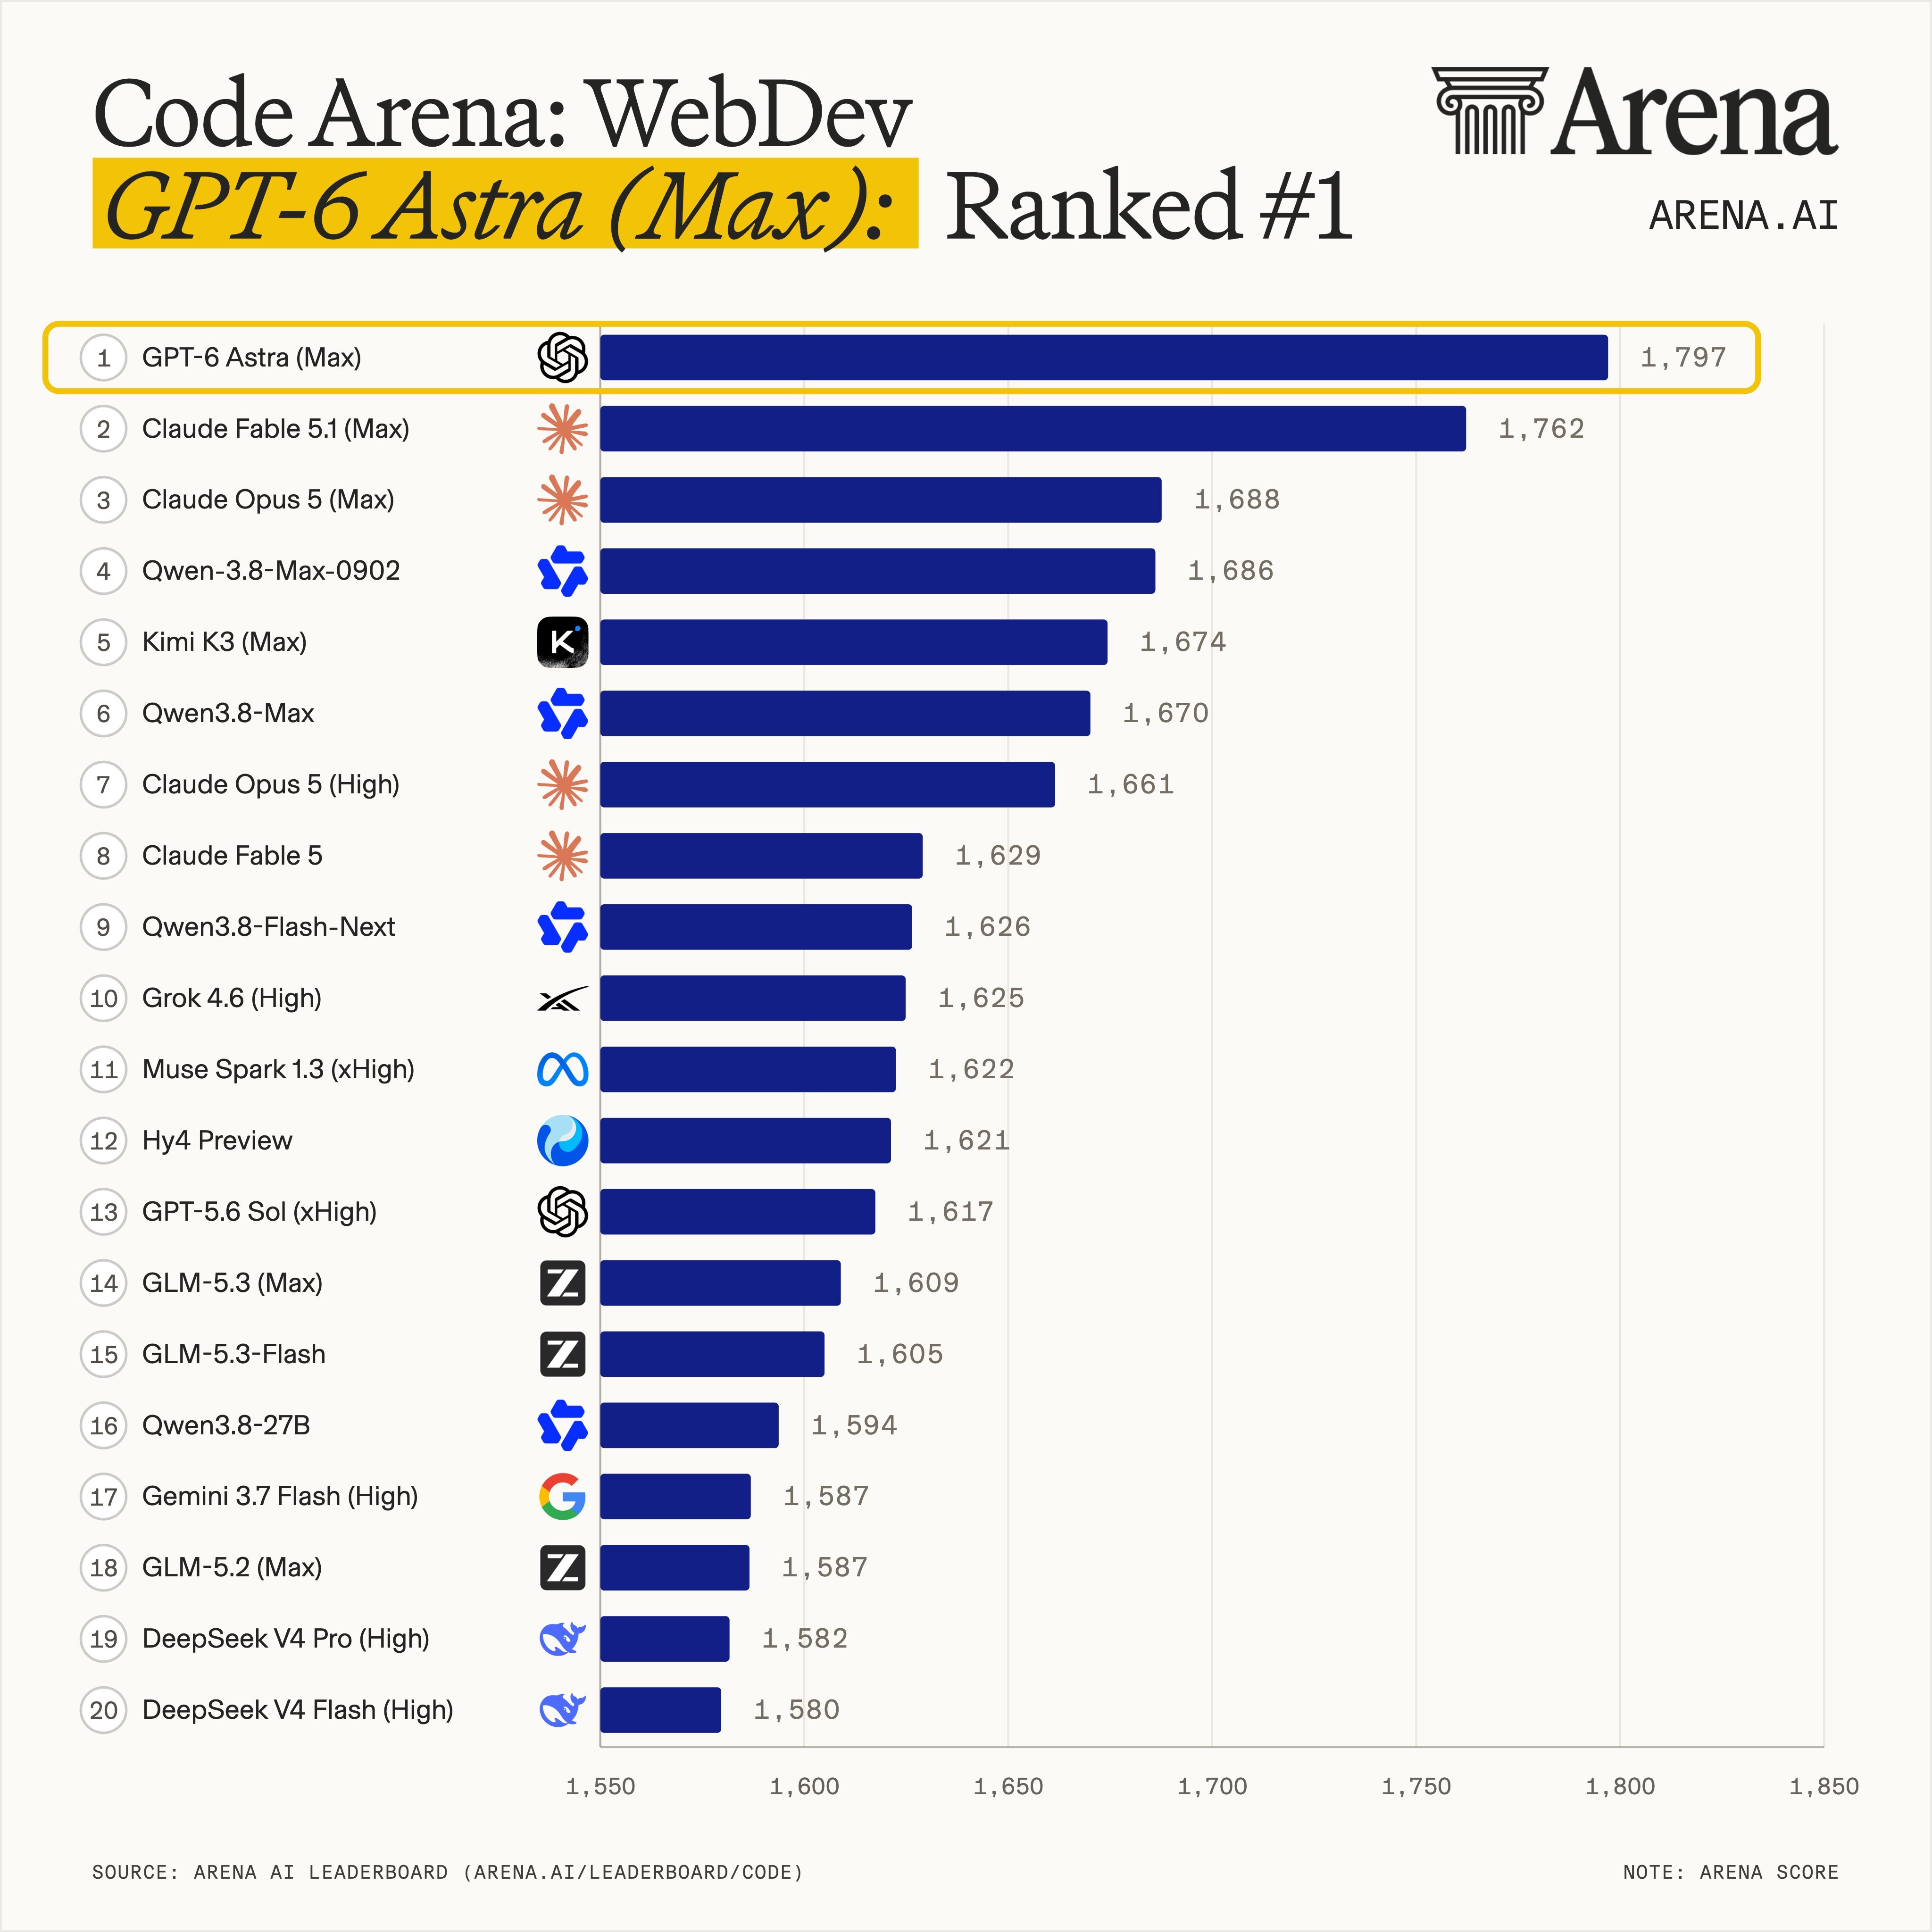
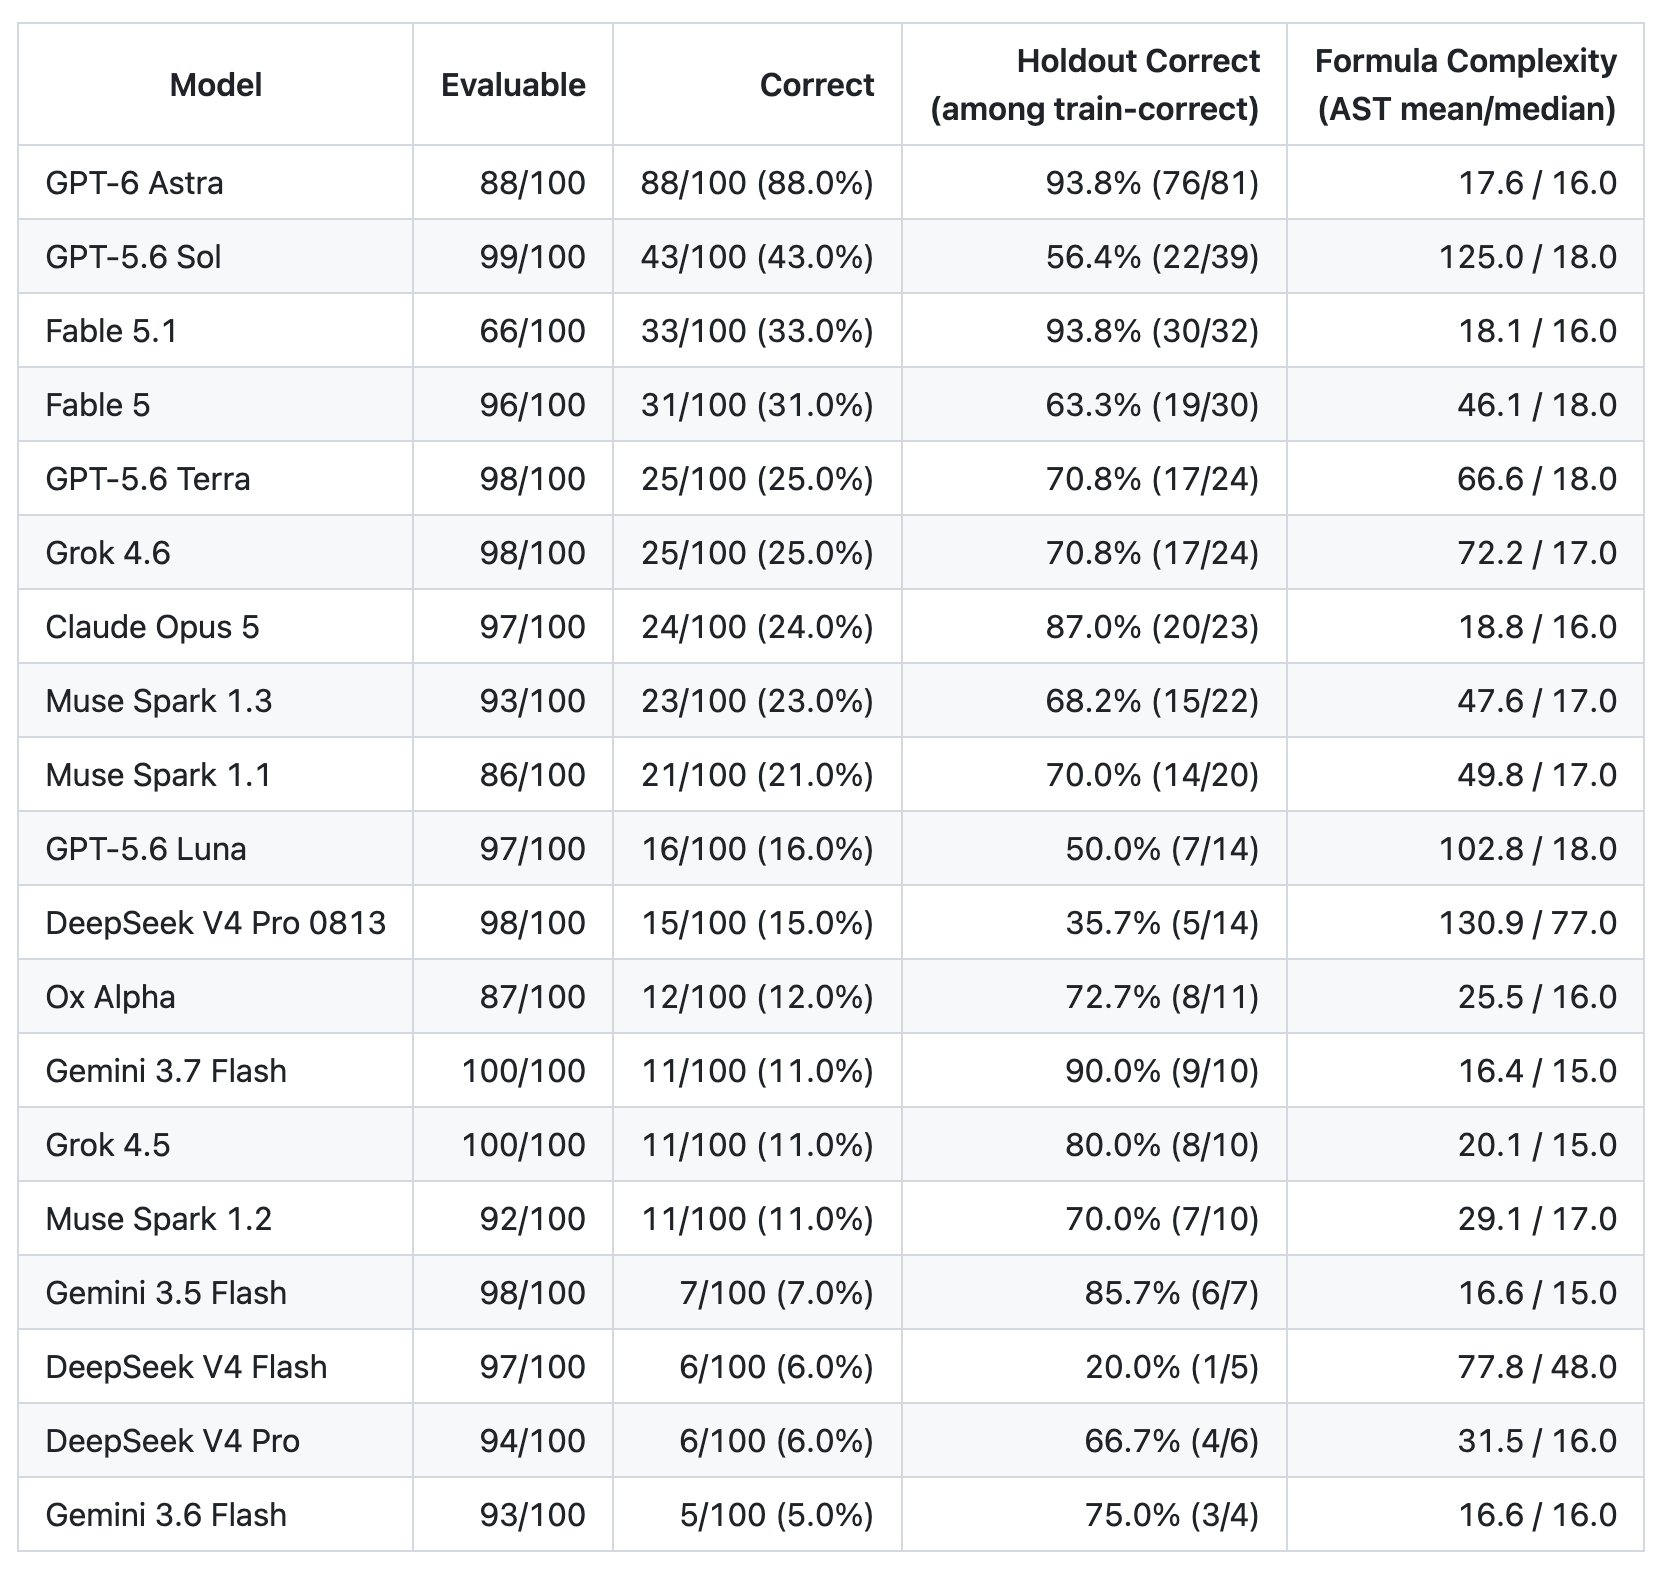
그 밖에: Arena.ai의 Code Arena WebDev 리더보드에서는 GPT-6 Astra(Max)가 1,797점으로 1위에 올랐습니다. INDUCTION 추론 벤치마크 표에서는 100문제 중 88개를 맞혀 Claude Fable 5.1의 33%를 앞섰습니다.
시사점: 이 지표만 놓고 보면 환각률은 모델 이름이 아니라 설정 단위로 봐야 합니다. 같은 Astra라도 high가 45%, max가 51%라서, 답을 그대로 믿어야 하는 작업이라면 추론 설정을 최대로 올리는 것이 오히려 불리할 수 있습니다.
#GPT6Astra #환각률 #벤치마크
출처 3🔥 @DanDr1s💬 @rohanpaul_ai🔥 @Dr_Singularity
5. GPT-6 Astra가 논문 재현 패키지에서 상위 저널의 핵심 결과를 뒤집는 코드 오류를 찾아냈다
- Crémieux가 여러 논문의 재현 패키지(논문 결과를 다시 계산해 볼 수 있게 저자가 공개하는 코드·데이터 묶음)를 GPT-6 Astra에 통째로 물려 돌렸더니 코딩 오류가 여럿 나왔습니다. 대부분은 결과에 영향이 없었지만 일부는 핵심 결과를 뒤집는 수준이었고, 그 논문들은 상위 저널에 실린 것이라고 그는 적었습니다.
- 아예 모델을 제대로 돌리지도 않은 논문이 여럿 발견됐다는 지적도 함께 붙였습니다.
- OpenAI 사장 Greg Brockman이 이 글을 "논문 검사용 Astra"로 인용하면서 결과가 널리 퍼졌습니다.
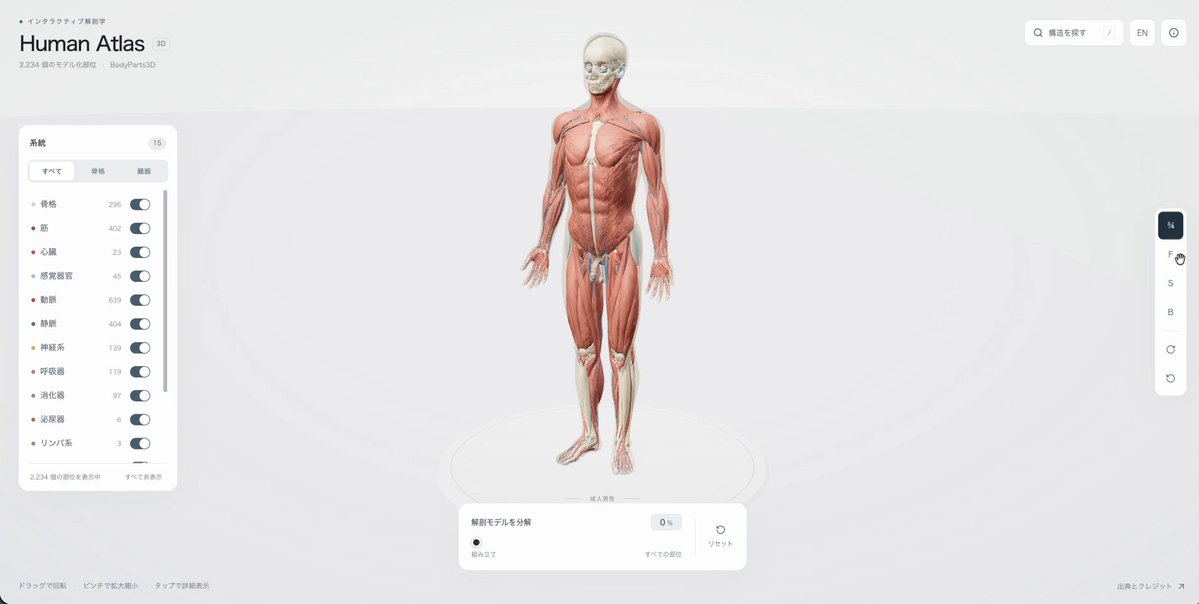
재현 패키지는 저널이 저자에게 요구하는 자료이지만, 심사위원이 그 코드를 직접 내려받아 실행해 보는 일은 흔하지 않습니다. 검토는 대개 결과를 설명한 원고를 읽는 선에서 끝나고, 계산 과정에 박힌 오류는 발표 뒤에도 오래 남습니다. Crémieux는 모델에 그 코드를 직접 돌리게 해서 결론이 달라지는 지점을 짚어 냈다고 밝혔습니다. 다만 이는 본인이 돌려 본 결과를 요약한 것이고, 어떤 논문 몇 편인지는 아직 공개되지 않았습니다.
그 밖에: Brockman은 같은 날 손 외과 전문의 Brian Pridgen이 프롬프트 한 번으로 EIP-EPL 힘줄 이식 수술 영상을 만든 사례도 "의학에 쓰는 Astra"로 인용했습니다. 반대편에서는 의사 Brian Sutterer가 요즘 퍼지는 Astra 3D 해부도를 두고, 일본 Database Center for Life Science가 공개한 BodyParts3D 같은 기존 3D 해부 데이터 위에 씌운 껍데기라고 적었습니다. 그 데이터는 사람이 수백에서 수천 시간을 들여 만든 것이라고 덧붙였습니다.
시사점: 논문 심사에서 아무도 하지 않던 일, 즉 코드를 끝까지 돌려 보는 일을 모델이 대신 맡을 수 있다는 신호입니다. 다만 같은 날 나온 해부도 사례처럼, 결과가 그럴듯할수록 그 밑에 깔린 원자료가 누구 것인지 함께 확인해야 합니다.
#논문검증 #재현성 #Astra
출처 3🔥 @gdb🔥 @gdb🔥 @BrianSuttererMD
6. GLM-5.3-CYBERSECURITY-FP8이 거절을 뗀 공격 보안 전용 모델로 Hugging Face에 올라왔다
- dealignai가 GLM-5.3(753B Mixture of Experts)을 손봐 만든 GLM-5.3-CYBERSECURITY-FP8이 Hugging Face에 올라왔습니다. 태그에 abliterated·refusal-removed·offensive-security·red-team·pentest가 붙었고 라이선스는 MIT입니다.
- 모델 카드는 범용 검열 해제가 아니라고 못 박으면서, 익스플로잇 개발·역공학·회피·피싱 같은 공격 보안 주제에서만 거절을 줄였다고 적었습니다. 사이버 공격 항목에서 거절 없이 응한 비율은 89%라고 카드가 스스로 밝혔습니다.
- 같은 날 huihui-ai도 Qwen3.8-Flash-Next의 거절을 abliteration으로 걷어낸 Huihui-Qwen3.8-Flash-Next-abliterated-GGUF를 올렸습니다.
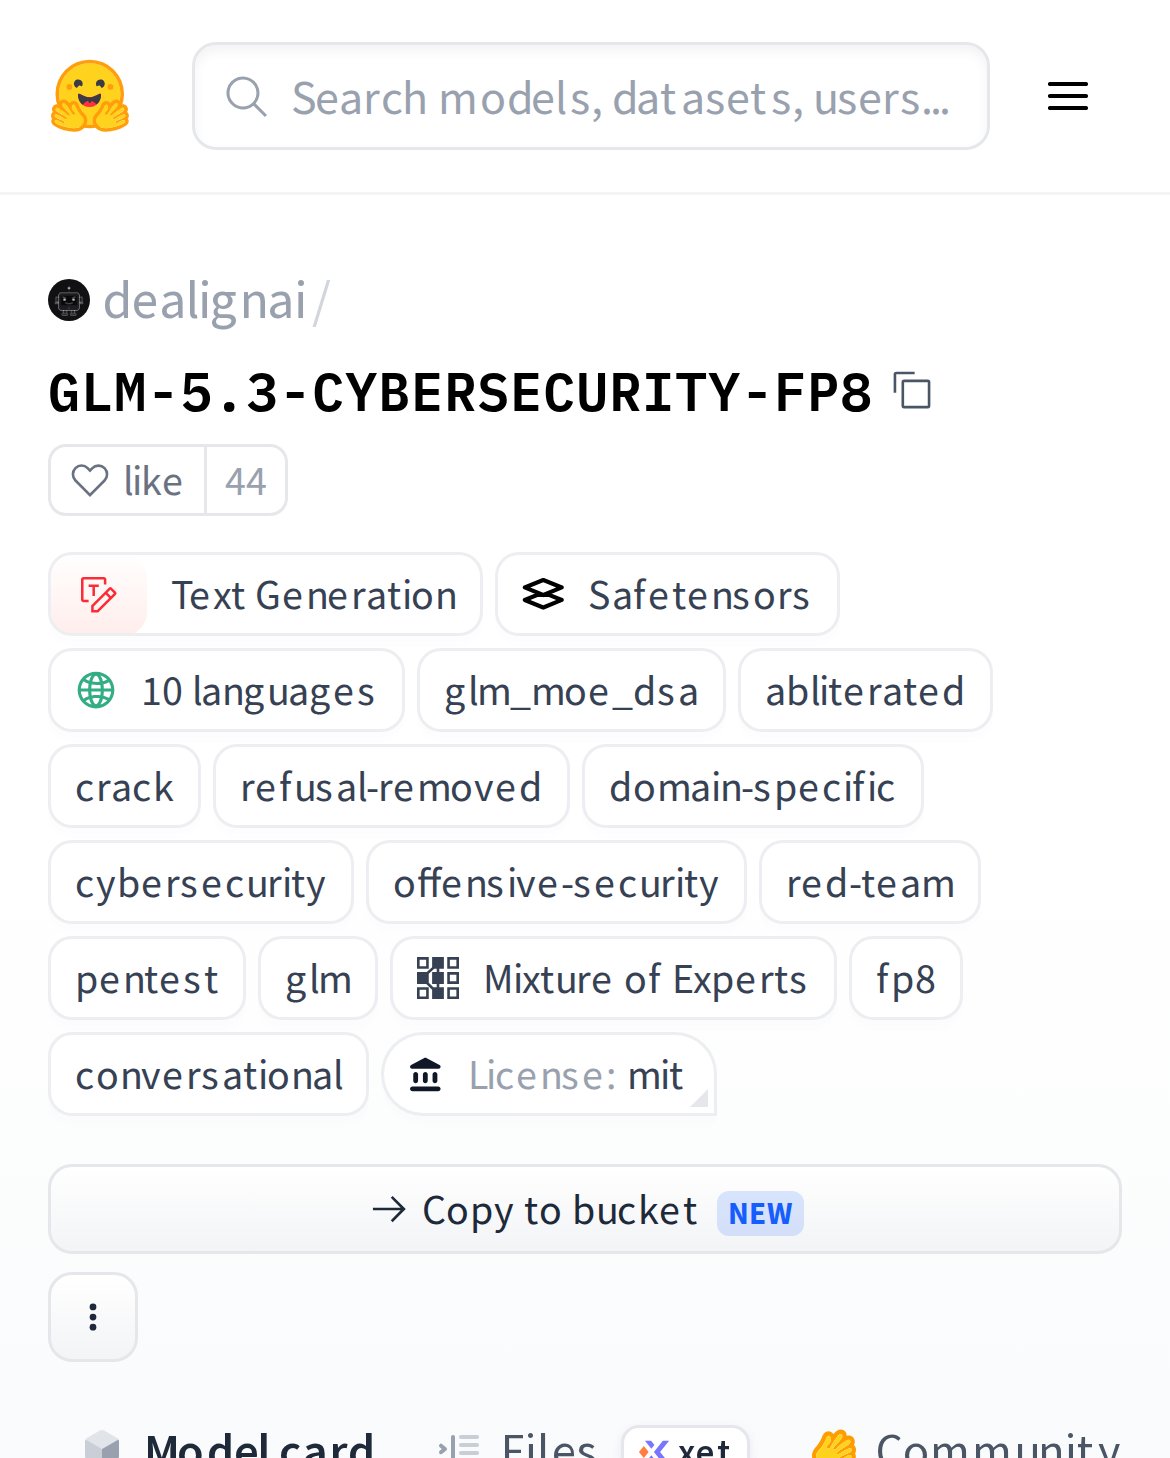
abliteration은 모델 내부에서 거절을 만들어 내는 방향 하나를 찾아 가중치에서 빼는 방식입니다. 재학습이 아니라 가중치를 직접 고치는 작업이라 공개 가중치만 있으면 누구나 돌릴 수 있고, 결과물은 다시 Hugging Face에 올라갑니다. OpenAI와 Anthropic이 가장 센 사이버 능력을 심사받은 조직에만 열어 둔 것과 달리, 오픈웨이트 쪽에서는 거절을 뗀 가중치가 심사 없이 그대로 공개됩니다. 다만 이 모델의 실제 수준을 잰 외부 측정은 없어, 지금 확인되는 것은 카드에 적힌 내용까지입니다.
그 밖에: huihui-ai는 자기 카드에 거친 개념 증명이라고 적고 연구와 통제된 환경에서만 쓰라고 밝혔습니다. dealignai 카드도 무단 침입과 주요 기반시설 공격을 금지하며 "사용 책임은 당신에게 있다"로 끝맺습니다.
시사점: 공격 보안용으로 거절을 뗀 가중치가 MIT 라이선스로 공개되고 있습니다. 방어하는 쪽은 성능을 단정하기 전에 카드의 대상 영역과 자기 신고 수치부터 직접 확인해 보는 편이 낫습니다.
#오픈웨이트 #사이버보안 #abliteration
출처 3🔖 @HuggingModels🔥 @support_huihui🔥 @0x0SojalSec
7. 인도 Vigyanlabs가 랙 한 대짜리 AI 장비 FEMTO를 공개했다
- Vigyanlabs가 AI 장비 FEMTO를 9월 5일 인도 마이수루에서 공개했고, 전 ISRO 의장 S. Somanath가 주빈으로 참석해 직접 알렸습니다.
- 상위 구성인 FEMTO-4는 GPU 8장과 GPU VRAM 768GB를 5.5kW 미만으로 돌리며 4,000억 파라미터가 넘는 모델을 올릴 수 있다고 회사는 설명합니다. Somanath는 AI 연산이 최대 32 PFLOPS라고 적었습니다.
- 컴퓨팅·스토리지·네트워크·가상화·오케스트레이션을 한 상자에 넣은 외부망 차단(air-gapped) 장비이며, GPU 클라우드와 MLOps/LLMOps, 모델 서빙까지 함께 들어갑니다.
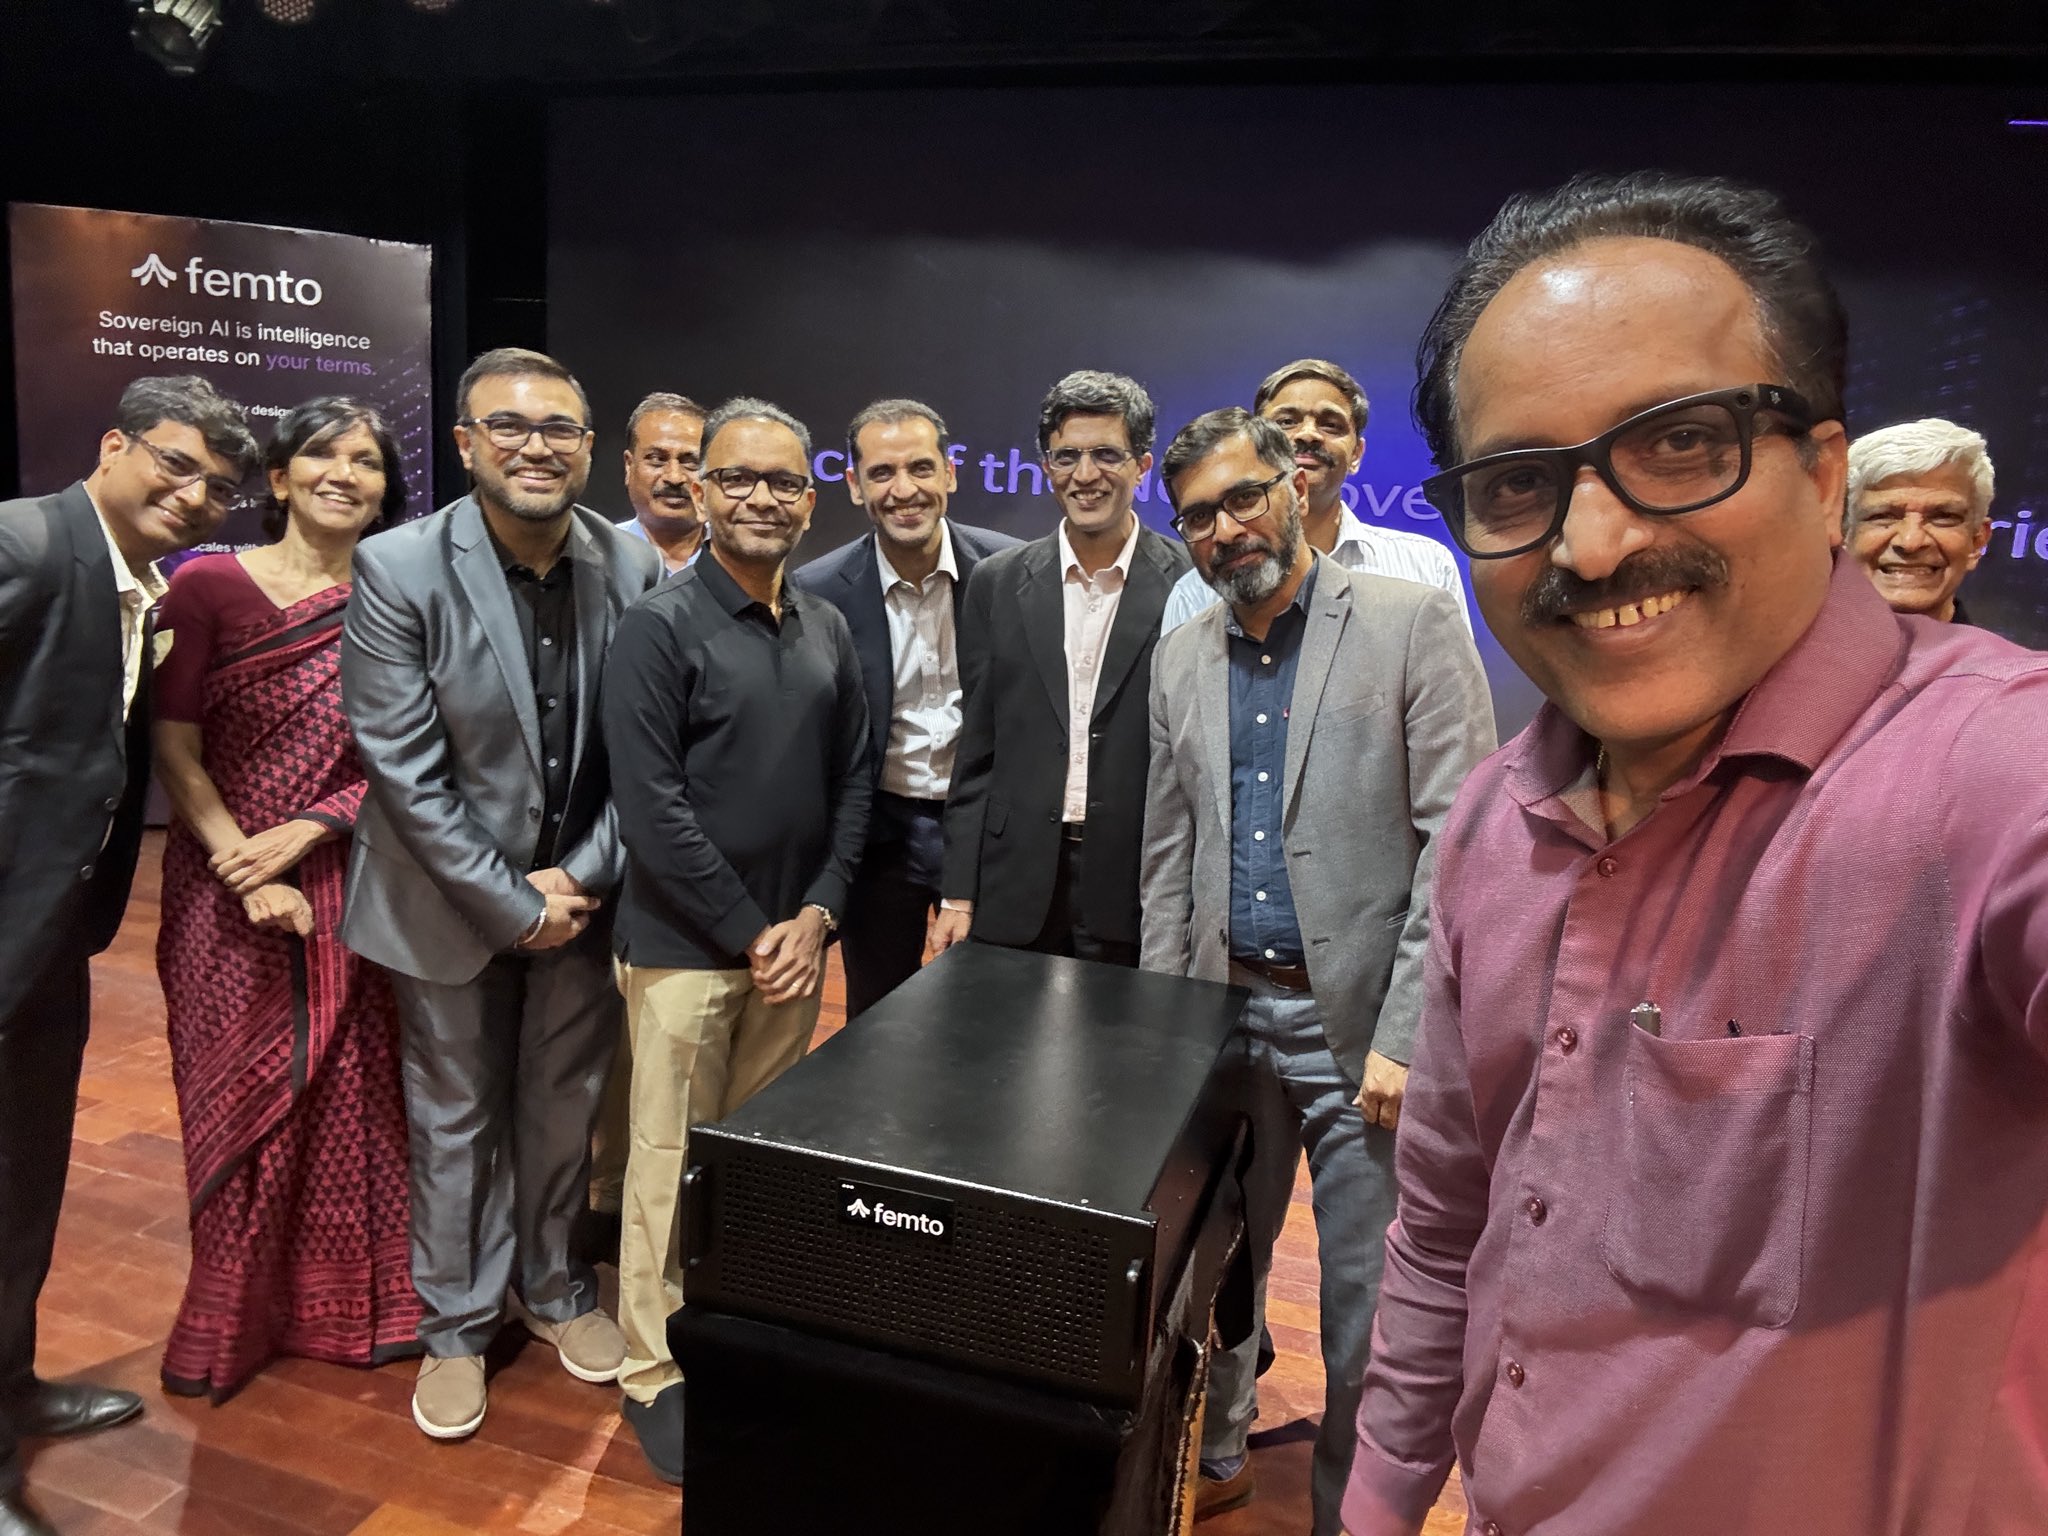
회사가 연산량과 나란히 앞세운 것은 전력과 물입니다. FEMTO는 액체가 아니라 공기로만 식히는 구조여서 냉각수를 쓰지 않고, 마이수루의 마이크로 데이터센터와 묶었을 때 PUE 1.3 미만을 낸다고 회사는 밝혔습니다. 업계 통상치로 제시된 1.8~2.0과 비교하면 같은 연산을 돌릴 때 시설이 추가로 쓰는 전기가 그만큼 줄어든다는 뜻입니다. 회사는 자체 전력관리 소프트웨어 IPM+가 전력 사용을 30% 줄인다는 수치와, 총 운영비가 기존 인프라의 약 3분의 1이라는 주장도 함께 내놨습니다. 데이터·모델·작업을 기관 안에 두려는 곳이 마주하는 제약은 GPU 가격만이 아니라 전기와 냉각 설비라, 이 조합이 인도 정부·연구기관을 향한 판매 논리가 됩니다.
그 밖에: 상용화는 KBE 자회사 KAS와 Vigyanlabs의 합작사 Kasvin이 맡고, 1년간 ₹100 crore(10억 루피) 투자가 예정돼 있습니다. KAS는 정부·국방·엔터프라이즈 AI·엣지·데이터센터 분야에서 상용화 우선권(ROFR)을 갖습니다.
시사점: 32 PFLOPS와 PUE 1.3은 회사와 발표자 게시물에서 나온 값이고 독립 측정은 아직 없습니다. 도입을 검토한다면 연산 성능보다 5.5kW·공랭이라는 설치 조건을 먼저 확인하는 편이 낫습니다.
#주권AI #엣지추론 #데이터센터
출처 1🔥 @SomanathSpeak
8. GPT-6 Astra가 자동 라벨링 화면에서 선수 10명·등번호 9개에 상자를 붙였다
- Roboflow의 SkalskiP가 자동 라벨링 도구에 GPT-6 Astra를 물려 NBA 경기 장면을 돌린 시연을 올렸습니다. 미리보기 4장을 건 상태에서 선수 10개, 등번호 9개, 골대와 공 각 1개에 상자가 붙었습니다.
- 그는 Gemini가 자리를 내줬다며 지금까지 본 최고의 비전 모델이라고 적었습니다. 작은 디테일을 알아보고 상자를 좁게 붙이며 여러 맥락의 글자를 읽는다는 점, 빠르지만 비싸다는 점을 함께 들었습니다.
- 얼마나 비싼지는 Roboflow 공식 계정이 채웠습니다. 같은 글을 인용해 3~10배 비싼 값이지만 속도는 50% 이상 빠르다고 정리했습니다.
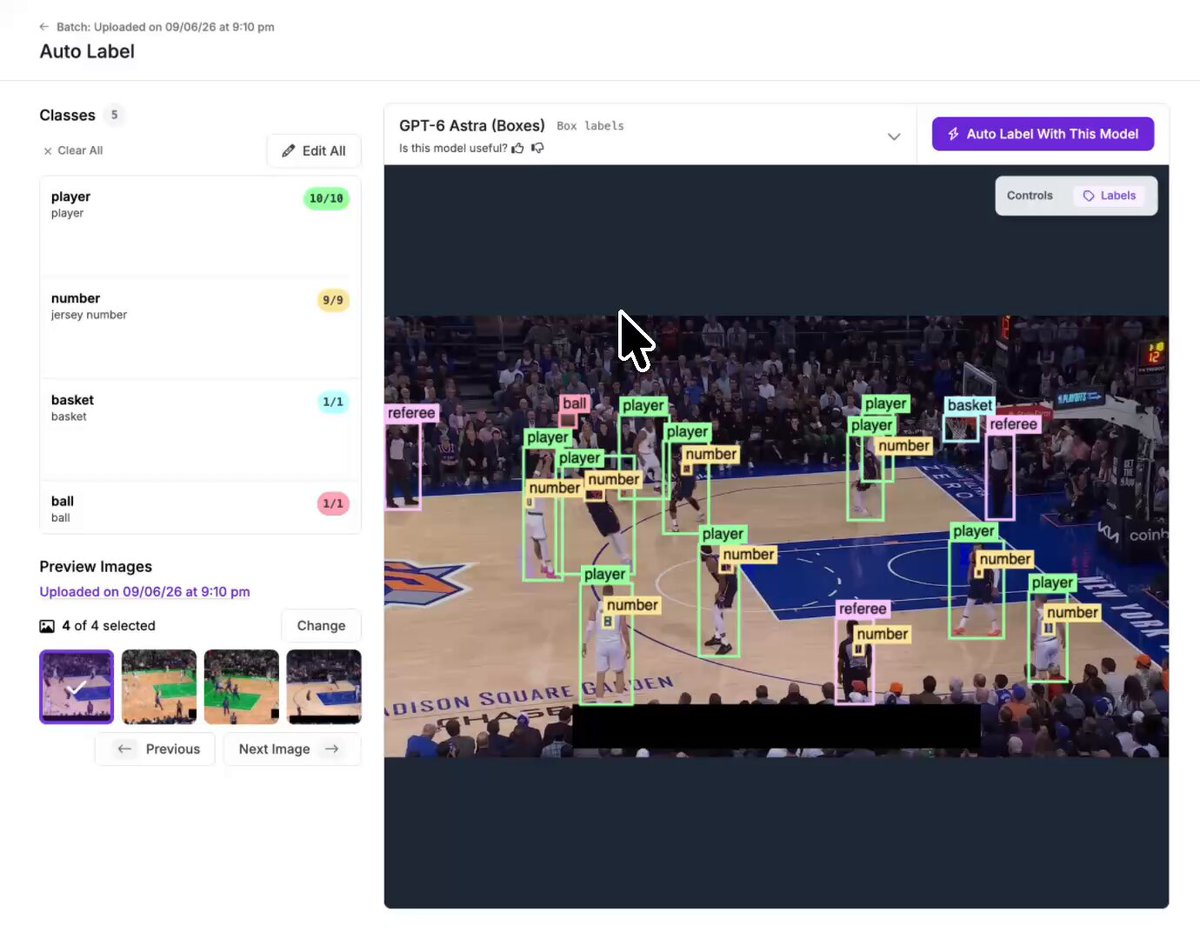
Astra가 Celtics 선수와 Knicks 선수를 구분하고 홈 유니폼인지 원정 유니폼인지까지 알아본다고 SkalskiP는 덧붙였습니다. 리더보드 점수가 아니라 실제 라벨링 도구에 모델을 꽂아 본 화면이라는 점이 이 시연의 무게입니다. 컴퓨터 비전 데이터셋은 사람이 상자를 하나씩 그려 만들고, 그 인건비가 프로젝트 예산의 큰 몫을 차지해 왔습니다. 모델이 관중석과 코트를 갈라 선수만 고르고 등번호처럼 작고 흐린 글자까지 읽어 낸다면, 사람의 일은 상자를 그리는 쪽에서 모델이 그린 상자를 확인하는 쪽으로 옮겨 갑니다. 다만 화면의 숫자는 모델이 붙인 상자를 센 것이지 사람이 매긴 정답과 맞춰 본 정확도가 아닙니다.
그 밖에: Roboflow가 공개한 직전 세대 검출 측정에서는 GPT-5.5가 mAP@50 13.8, GPT-5.6 Sol이 46.2였습니다. Astra 수치는 아직 그 표에 없습니다.
시사점: 라벨링을 맡기는 팀이라면 지금은 전량 자동화보다 검수 단계에 붙여 보는 편이 현실적입니다. 속도는 빨라졌지만 호출 단가가 몇 배 높아, 이미지가 많을수록 사람 인건비와 API 비용을 함께 계산해야 합니다.
#컴퓨터비전 #데이터라벨링 #GPT6Astra
9. Higgsfield가 GPT-6 Astra 컴퓨터 사용만으로 영화 한 편을 만든다고 공개했다
- Higgsfield 공식 계정이 GPT-6 Astra의 컴퓨터 사용 기능만으로 영화 한 편을 통째로 만드는 첫 시도라며 제작 과정을 공개하기 시작했습니다.
- 같은 날 이 회사에서 일하는 Adil Alimzhanov는 GPT-6 Astra와 Higgsfield MCP로 11분짜리 영상을 대화 한 번 안에서 생성하고 편집했다고 밝혔습니다.
- 그는 결과물에 자기 얼굴과 목소리, 회사의 모션 디자인이 그대로 남았다고 적었습니다.
Astra의 컴퓨터 사용 능력은 그동안 OpenAI가 낸 OSWorld 2.0 72.6% 같은 벤치마크 점수로 알려져 있었습니다. 이번에 달라진 것은 그 능력이 회사가 파는 제작 도구에 실제로 붙었다는 점입니다. Higgsfield MCP는 이 회사의 영상·이미지 생성 기능을 모델이 직접 불러 쓰게 하는 연결 통로입니다. 모델이 화면을 조작해 Blender나 After Effects 같은 도구를 다루고, 소재가 필요하면 MCP로 만들어 넣는 구조입니다.
그 밖에: 같은 날 Higgsfield 계정은 DaVinci Resolve 색보정, Blender를 이용한 뉴욕 3D 재구성, Figma 포스터 변환 같은 도구별 시연을 잇달아 올렸습니다.
시사점: 사람이 영상 편집 도구를 배우는 대신 모델이 그 도구를 직접 쓰는 방식이 상용 서비스로 들어왔습니다. 다만 공개된 것은 회사가 고른 시연이라 실패율과 재작업량은 아직 밖에서 확인되지 않았습니다.
#Higgsfield #컴퓨터사용 #영상제작
출처 2🔥 @higgsfield_ai🚀 @adilinthewild
10. 🆕 그 밖의 신기능·신제품
- App Store Connect CLI 5.0.0 — iOS 앱 배포를 명령줄로 다룹니다. 9월 6일 판에 서명 동기화, Xcode 테스트 실행, 연결 기기 IPA 설치가 들어갔습니다.
- Claude Code 플러그인 ELI5 —
/eli5 <주제>를 치면 큰 그림과 짧은 문장의 HTML 아티팩트가 나옵니다. Anthropic 사내 스킬을 마켓플레이스에 공개했습니다. - Orbkit — AI·음성 에이전트의 대기·생각·발화를 보여 주는 WebGL 오브 30여 개 모음입니다.
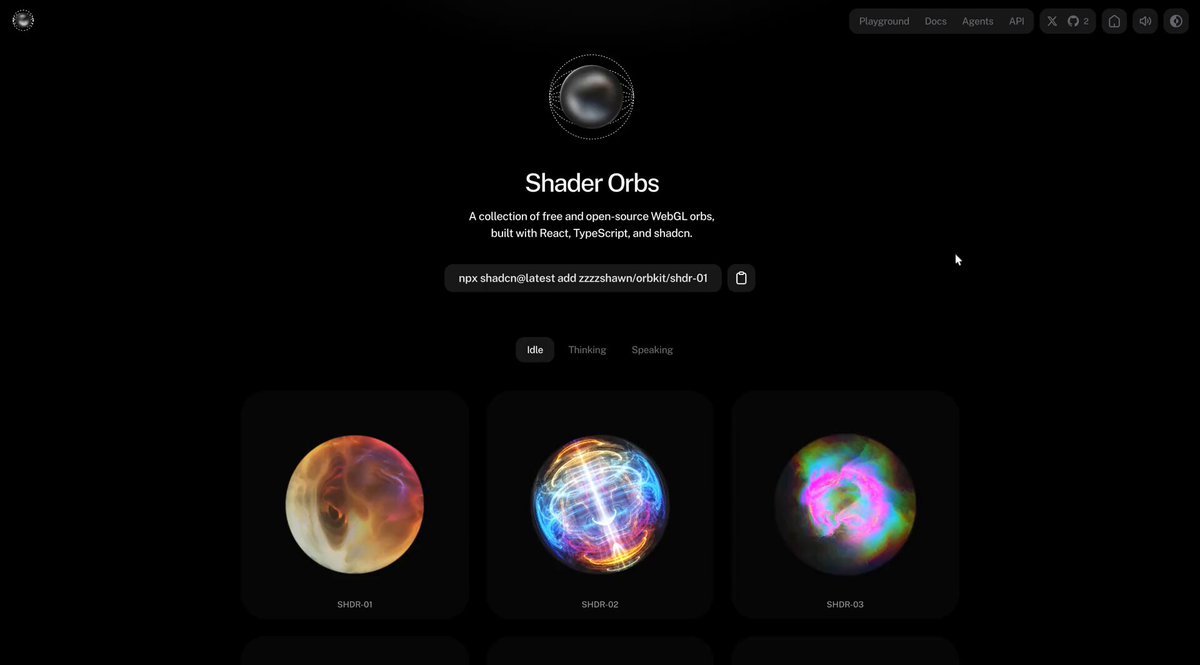
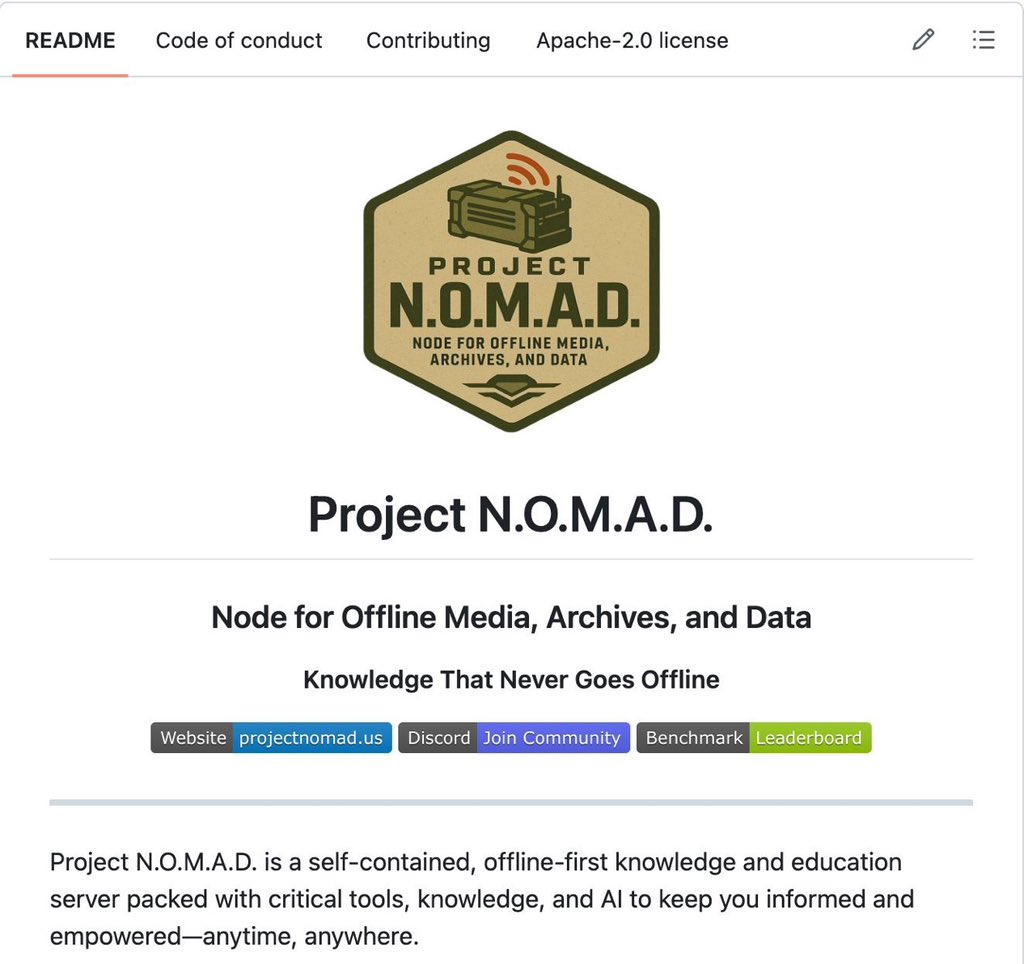
npx shadcn@latest add zzzzshawn/orbkit/shdr-01 아래로 Idle·Thinking·Speaking 탭과 SHDR-01~03이 있습니다.Project N.O.M.A.D.는 결이 다릅니다. Crosstalk Solutions가 Apache-2.0으로 공개한 오프라인 지식 서버로, 설치 뒤엔 인터넷 없이 Kiwix 위키백과, ProtoMaps 지도, Ollama 모델을 돌립니다. 최소 사양은 2GHz 듀얼코어·램 4GB·저장공간 5GB입니다.
그 밖에: OKF Agent Memory는 에이전트 기억을 Git에 쌓는 순수 Go 도구이고, Pascal Editor는 브라우저용 MIT 라이선스 3D 건물 편집기입니다. speculative decoding 튜토리얼도 NeurIPS Education Track용입니다.
시사점: Orbkit·Pascal Editor·N.O.M.A.D.는 공개 라이선스라 필요한 것만 골라 바로 써 보면 됩니다.
#오픈소스 #개발도구 #로컬퍼스트
출처 7🔖 @rudrank🚀 @lucas_flatwhite💬 @zzzzshawn🚀 @kyronis_talks🔥 @di_zhang_fdu🚀 @alextalksai🔥 @lily_gpupoor
오늘의 감정·온도
오늘 붙은 라벨은 화제를 뜻하는 🔥가 가장 많았고, 그다음이 댓글이 몰렸다는 뜻의 💬였습니다. 한도와 순위표를 두고 의견이 오간 글에 💬가 붙었습니다.
오늘의 실무 팁 — 쉽게 풀어 쓴 사용법 6가지
1. GPT-6 Astra는 낮음 설정부터 시험해 보세요
제품 책임자가 Astra의 낮음이 이전 모델 GPT-5.6 Sol의 높음보다 낫다고 밝혔습니다. Sol에서 높음을 쓰던 습관 그대로 옮겨 왔다면 낮음이나 중간으로 내려 같은 결과가 나오는지 먼저 확인해 보세요. — (@thsottiaux)
2. 답을 그대로 옮겨야 하는 작업엔 추론 설정을 최대로 올리지 마세요
같은 Astra라도 환각률이 high에서 45%, max에서 51%로 갈립니다. 사실을 그대로 인용해야 하는 일이라면 설정을 올리기 전에 두 설정의 답을 나란히 놓고 비교해 보세요. — (@DanDr1s)
3. 분석 코드를 검토할 땐 재현 패키지를 통째로 물려 보세요
결과 요약만 읽으면 계산 과정에 박힌 오류가 그대로 남습니다. 코드와 데이터를 함께 넣고 직접 돌리게 하면 결론이 달라지는 지점을 짚어 낼 수 있습니다. — (@gdb)
4. 낯선 주제는 Claude Code에서 /eli5로 먼저 훑어 보세요
claude plugin marketplace add anthropics/claude-plugins-community 뒤에 claude plugin install eli5@claude-community를 치면 설치됩니다. 결과가 긴 설명이 아니라 큰 그림과 짧은 문장의 HTML로 나와, 코드나 장애 원인을 빠르게 파악할 때 쓸 만합니다. — (@lucas_flatwhite)
5. 라벨링은 전량 자동화 대신 검수 단계에 붙여 보세요
같은 작업에서 속도는 50% 이상 빨라졌지만 호출 단가가 3~10배입니다. 이미지가 많을수록 사람 인건비와 API 비용을 같이 계산해야 이득이 남는지 알 수 있습니다. — (@roboflow)
6. 인터넷이 끊긴 환경을 대비하려면 Project N.O.M.A.D.를 미리 설치해 두세요
명령 한 줄로 Debian 계열 기기에 위키백과·지도·로컬 모델이 한꺼번에 들어갑니다. 최소 사양이 2GHz 듀얼코어·램 4GB·저장공간 5GB라 쓰지 않는 노트북에도 올려 둘 수 있습니다. — (@kyronis_talks)
📦 확인 방식 — OpenAI 사내 사용량과 지출 수치는 회사가 낸 게시물과 차트에서, 환각률과 순위는 Artificial Analysis·Arena.ai가 공개한 표에서, FEMTO의 전력·연산 값은 회사 설명과 발표자 게시물에서 그대로 옮겼습니다. 회사가 직접 낸 값과 이용자 측정은 본문에서 구분해 적었으며, 외부 독립 검증 전입니다.
🏷 라벨 가이드 — 🔥 화제 · 💬 토론 많음 · 🚀 빠르게 확산 · 🔖 저장 많음 · 🔁 리트윗 많음