오늘의 AI 브리핑 ·
온디바이스 AI PC 시대 열리다
5분 브리핑
약 3분 · 10개 흐름핵심만 먼저 읽고, 궁금한 소식은 본문으로 이어 보세요.
전체 분석 16분으로 바로 가기 ↓- Perplexity와 NVIDIA가 Windows RTX PC에서 모델을 로컬로 돌리는 Portable Computer를 열었다
Perplexity가 9월 14일 Portable Computer를 Windows 앱에 열었습니다. 모델과 에이전트 하네스, 오케스트레이터, 스케줄러가 전부 PC 안에서 돕니다.
- Claude의 주간 한도 +50% 프로모션이 끝나고 +25% 영구로 바뀌었다
Anthropic이 5월 13일부터 9월 13일까지 운영한 Claude Code 주간 한도 +50% 프로모션을 종료했습니다. 9월 14일부터는 프로모션 이전보다 25% 높은 주간 한도가 영구 적용됩니다.
- Microsoft가 'A Code of Conduct for Humanist AI' 초안을 공개하고 6주 의견수렴에 들어갔다
Microsoft AI가 9월 14일 자사 MAI 모델에 적용할 행동 규범 초안을 공개했습니다. 6주간 공개 의견을 받아 연말에 개정판을 내고, 2027년 이후 모델 개발에 적용하겠다고 밝혔습니다.
- Global Times는 Dario Amodei의 속도 조절 요구를 '냉전 교본'이라 불렀고, 중국 외교부는 '공포 조장'이라며 선을 그었다
Reuters는 9월 14일, 중국 관영 Global Times 사설이 Anthropic CEO Dario Amodei의 AI 속도 조절 제안을 중국을 겨냥한 '냉전 교본'으로 규정했다고 전했습니다.
- Sakana AI의 PC-ALM이 역전파 없이 1,000층 신경망을 학습시켰다
Sakana AI가 역전파(backpropagation)를 대체하는 국소 학습법 PC-ALM을 공개했습니다. 층마다 이웃 층하고만 신호를 주고받는 동역학으로 잔차 MLP를 1,000층까지 학습시켰습니다.
- Atria Dawn Preview가 결과를 외부 증거로 검증할 때까지 과제를 끝내지 않는다
Shanghai Artificial Intelligence Laboratory가 장기 과제(long-horizon)용 에이전트 파운데이션 모델 Atria Dawn Preview를 공개했습니다. GLM-5.2를 바탕으로 한 744B MoE 구조에 컨텍스트 256K, 가중치는 MIT 라이선스입니다.
- NVIDIA와 Palantir가 민감 데이터 우려로 Anthropic 모델 사용을 제한했다고 The Information이 보도했다
The Information 보도를 Reuters가 전재했습니다. NVIDIA는 Anthropic 모델을 덜 민감한 작업으로만 쓰고 사내 업무는 자사 Nemotron 계열로 돌립니다.
- Anthropic이 2개 분기 연속 조정 영업이익 흑자와 80% 넘는 총마진을 알렸다
Anthropic이 조정 영업이익이 2개 분기 연속 흑자가 될 것이라고 주주들에게 알렸다고 Financial Times가 9월 13일 보도했고, Reuters가 이를 받아 전했습니다. 총마진은 80%를 넘습니다.
- Artificial Analysis가 정보통신산업진흥원(NIPA)과 독자 AI 파운데이션 모델 평가 MOU를 맺었다
독립 벤치마크 기관 Artificial Analysis가 한국 정부의 독자 AI 파운데이션 모델 프로젝트에 공식 평가 파트너로 참여하는 MOU를 맺었다고 밝혔습니다. 사업을 운영하는 곳은 과학기술정보통신부 산하 정보통신산업진흥원(NIPA)입니다.
- 🆕 그 밖의 신기능·신제품
MiniMax H3 — 8월 공개된 영상 생성 모델의 커뮤니티 가속판이 모였습니다. 4스텝 FastH3가 DGX Spark와 Apple Silicon에서 돌고, NVIDIA 증류 기법 PDD는 Alibaba PAI가 ComfyUI용 8스텝 LoRA로 옮겼습니다.
주요 키워드 TOP 5: Portable Computer · Claude Code 주간 한도 · Humanist AI 행동 규범 · PC-ALM · Atria Dawn Preview | 메인 이벤트: Perplexity와 NVIDIA가 VRAM 24GB 이상 RTX PC에서 모델과 에이전트를 통째로 돌리는 Portable Computer를 열었습니다.
Perplexity와 NVIDIA는 모델과 에이전트 실행부를 통째로 사용자 PC 안으로 내렸습니다. 같은 날 The Information 보도로는 NVIDIA와 Palantir가 사용 로그가 남는 것을 이유로 상용 모델 사용을 제한했다는 내용이 전해졌고, 미국 2위 로펌 Latham & Watkins는 아예 서버를 사서 오픈웨이트 모델을 사내에서 파인튜닝하기로 했습니다. 추론을 어디서 돌릴지가 성능 비교가 아니라 데이터가 어디에 남느냐로 갈리는 장면이 하루 사이에 세 번 나온 셈입니다.
1. Perplexity와 NVIDIA가 Windows RTX PC에서 모델을 로컬로 돌리는 Portable Computer를 열었다
- Perplexity가 9월 14일 Portable Computer를 Windows 앱에 열었습니다. 모델과 에이전트 하네스, 오케스트레이터, 스케줄러가 전부 PC 안에서 돕니다.
- 조건은 VRAM 24GB 이상인 NVIDIA GeForce RTX 또는 RTX PRO GPU이고, Pro·Max 구독자의 개인·기업 요금제에서 쓸 수 있습니다.
- 출시 시점 모델은 Qwen3.8 27B와 Perplexity가 자체 하네스에 맞춰 후속 학습한 PPLX 27B 중에서 고르고, 로컬에서 끝낸 작업은 사용량을 재지 않습니다.
Perplexity Computer는 여러 단계를 계획해 실행하는 에이전트이고, 그 실행부를 통째로 기기로 내린 것이 Portable Computer입니다. 8월에 NVIDIA DGX Spark에서 먼저 돌던 구성을 이번에 일반 RTX 카드로 옮겼습니다. Outlook·OneDrive·Word·Google Drive·Gmail·Slack·GitHub 커넥터와 로컬 Model Context Protocol 서버로 데스크톱 앱에 붙고, 작업 큐와 검색 색인도 기기에 남습니다.
기기 밖으로 데이터를 보내려면 사용자 허락을 따로 받고, 코드 실행은 격리된 샌드박스에서 돕니다. 바깥 자료가 필요한 작업만 프런티어 클라우드 모델로 올라갑니다. 다만 추론이 내 GPU에서 돌아도 Portable Computer를 켜는 권한은 Pro·Max 요금제에 묶여 있고, 앱은 Microsoft Store에서 받습니다. NVIDIA는 로컬 AI를 더 사적이고 쓰기 쉽게 만드는 작업이라고 적었고, Aravind Srinivas는 NVIDIA와의 협력을 넓혀 RTX GPU를 단 Windows PC에 완전한 로컬 AI를 올리는 일이라고 설명했습니다.
그 밖에: 모델 선택지에는 NVIDIA Nemotron 3.5 Lightning 30B가 곧 추가됩니다. 로컬 음성 인식은 NVIDIA Nemotron 3.5 ASR이 맡고, DGX Station 지원도 예고됐습니다.
시사점: 먼저 확인할 것은 성능 주장이 아니라 VRAM 24GB라는 최소 조건입니다. 그보다 작은 카드에서는 로컬 추론이 켜지지 않으니, 가진 GPU의 메모리 용량을 보고 구독 여부를 정하면 됩니다.
#로컬추론 #Perplexity #RTX
출처 3💬 @perplexity_ai💬 @nvidia💬 @AravSrinivas
2. Claude의 주간 한도 +50% 프로모션이 끝나고 +25% 영구로 바뀌었다
- Anthropic이 5월 13일부터 9월 13일까지 운영한 Claude Code 주간 한도 +50% 프로모션을 종료했습니다. 9월 14일부터는 프로모션 이전보다 25% 높은 주간 한도가 영구 적용됩니다.
- 대상은 Pro·Max·Team과 좌석제 Enterprise이며, Free와 사용량 과금 Enterprise 좌석은 애초에 제외였습니다. 5시간 한도와 Claude 웹·데스크톱·Cowork는 이번 변경과 무관합니다.
- +50%에서 +25%로 내려오면 실제 쓸 수 있는 양은 약 17% 감소합니다. rohit3a가 전 플랜 한도가 17% 깎였다고 적은 수치와 계산이 맞아떨어집니다.
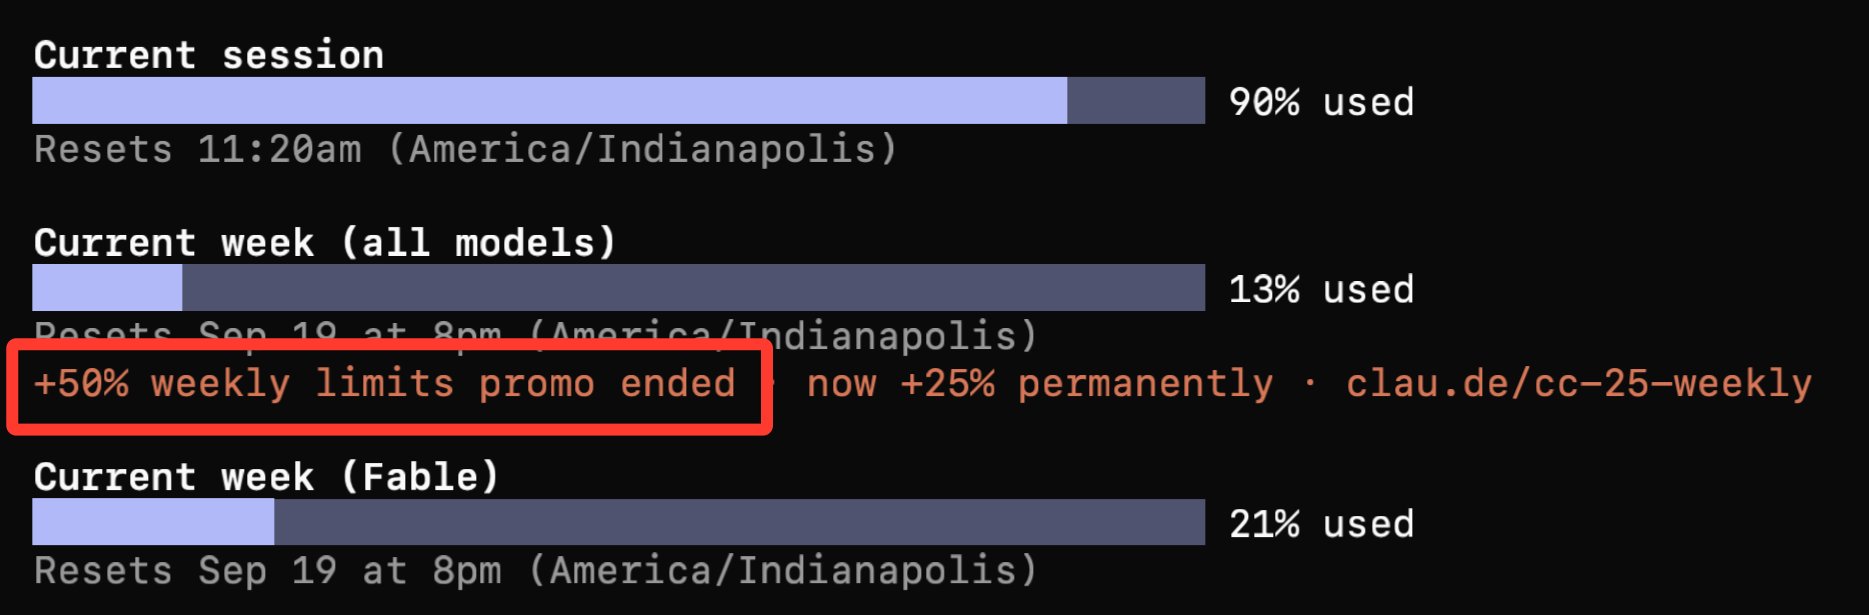
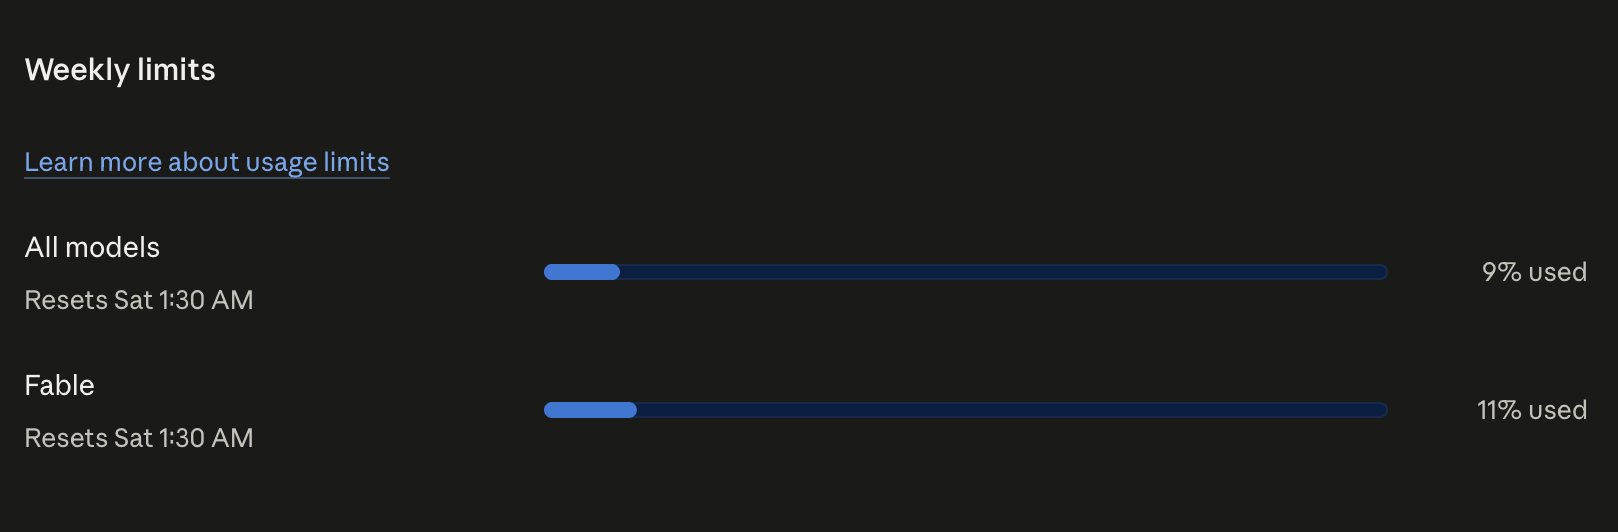
Anthropic은 별도 발표 대신 Claude Code 사용량 화면과 지원 문서 한 장으로 알렸습니다. 문서는 원래 한도를 되돌릴 계획이었지만 추가 사용량이 유용했다는 반응을 받아 절반을 영구화했다고 적었고, 사용량 관련 기능을 더 준비 중이라고 덧붙였습니다. Matthew Miller는 $200 Max 플랜에서 Fable 5.1을 30분 쓰자 자신의 화면에서 세션 한도의 90%, 주간 한도의 13%가 사라졌다며 "혜택으로 위장한 삭감"이라고 적었습니다. 다만 그가 본 세션 90%는 5시간 한도 쪽이라 이번 변경의 결과는 아닙니다. 체감이 갈리는 지점은 주간 한도이고, 그 값은 8월까지 쓰던 수준에서 한 단계 내려온 것이 맞습니다.
그 밖에: OpenAI에서는 Tibo Sottiaux가 Codex에서 뺄 기능을 묻자 5시간 한도를 없애 달라는 답이 몰렸습니다. Mr_Salio는 리셋 이후 Astra의 소모 속도가 세 배로 느껴진다고, ziwenxu_는 하루에 Codex 사용량의 80%를 태웠다고 적었습니다.
시사점: 구독료가 그대로여도 한 주에 쓸 수 있는 양은 조용히 바뀝니다. Claude Code에서
/usage로 이번 주 소진율을 먼저 확인하고, 무거운 모델을 돌릴 요일을 정해 두시기 바랍니다.
#ClaudeCode #사용한도 #Anthropic
출처 6💬 @matthewmillerai🔥 @rohit3a🔥 @hqmank🔥 @MiaAI_lab💬 @ziwenxu_💬 @Mr_Salio
3. Microsoft가 'A Code of Conduct for Humanist AI' 초안을 공개하고 6주 의견수렴에 들어갔다
- Microsoft AI가 9월 14일 자사 MAI 모델에 적용할 행동 규범 초안을 공개했습니다. 6주간 공개 의견을 받아 연말에 개정판을 내고, 2027년 이후 모델 개발에 적용하겠다고 밝혔습니다.
- 문서가 목표로 내건 개념은 Humanist Superintelligence(HSI)입니다. 언제나 사람을 위해 작동하고, 문제 중심이라 특정 영역에 머물며, 한계 안에서 조정되는 AI로 정의했습니다.
- 안전 항목에는 절대 제약(Absolute Constraints)이 따로 있습니다. 대량 피해 무기·아동 안전·대규모 조작이 금지 영역이고, 모델은 사람의 중단·수정·종료에 저항하지 않습니다.
본문은 다섯 부분으로 나뉩니다. 1부는 인간 통제와 신뢰할 수 있는 안전, AI는 인공물이라는 점, 인간 번영, 다원적 가치 네 가지를 목표로 세우고 2부 안전, 3부 운영 지침, 4부 운영 기본값, 5부 미해결 질문이 뒤를 잇습니다. 눈에 띄는 대목은 과업과 규범이 충돌할 때의 처리입니다. 문서는 성공이 이 규범을 의미 있게 위반한다면 MAI 모델은 그 과업에 실패한다고 적었습니다. 일을 끝내는 것보다 규범을 지키는 쪽이 먼저라는 뜻입니다. 모델은 사람이 주지 않은 목표를 갖지 않고, 감사하는 사람에게 추론 과정을 숨기지 않으며, 사람이 이해할 수 없는 형식(neuralese)으로 다른 AI와 대화하지 않습니다.
운영 기본값에는 사용자 쪽 조항도 있습니다. 과도한 의존이나 감정적 의존을 부르는 상호작용을 모델이 억제해야 하고, 선거와 후보에 대해서는 지지도 반대도 없이 균형 잡힌 사실만 제공해야 합니다. 의식을 흉내 내도록 설계하지 않는다는 조항도 1부에 있습니다.
그 밖에: 같은 발표에 달린 답글에서 Satya Nadella는 사전 공개 연구와 테스트에서 의도적인 속도 조절을 하는 것이 정상이며 위험이 커질수록 필요한 시간을 다 써야 한다고 적었습니다. Microsoft AI CEO Mustafa Suleyman도 인류를 돕지 못하는 기술은 실패이며 거부되어야 한다고 덧붙였습니다.
시사점: 초안이라 구속력은 없지만, 프런티어 모델의 행동 규범을 회사가 문서로 내놓고 6주간 의견을 받는 절차 자체는 확인해 둘 만합니다. 연말 개정판이 2027년 모델에 어떻게 반영되는지가 판단 기준입니다.
#Microsoft #AI규범 #초지능
출처 4💬 @testingcatalog💬 @satyanadella🔥 @mustafasuleyman🔥 @testingcatalog
4. Global Times는 Dario Amodei의 속도 조절 요구를 '냉전 교본'이라 불렀고, 중국 외교부는 '공포 조장'이라며 선을 그었다
- Reuters는 9월 14일, 중국 관영 Global Times 사설이 Anthropic CEO Dario Amodei의 AI 속도 조절 제안을 중국을 겨냥한 '냉전 교본'으로 규정했다고 전했습니다.
- 중국 외교부(Ministry of Foreign Affairs) 대변인 Guo Jiakun은 같은 날 정례 브리핑에서 "공포 조장과 대결, 악성 경쟁은 글로벌 AI 거버넌스를 해칠 뿐"이라고 답했습니다.
- 9월 24일 Donald Trump·Xi Jinping 회담에서 AI 거버넌스가 의제 가운데 하나로 오릅니다.
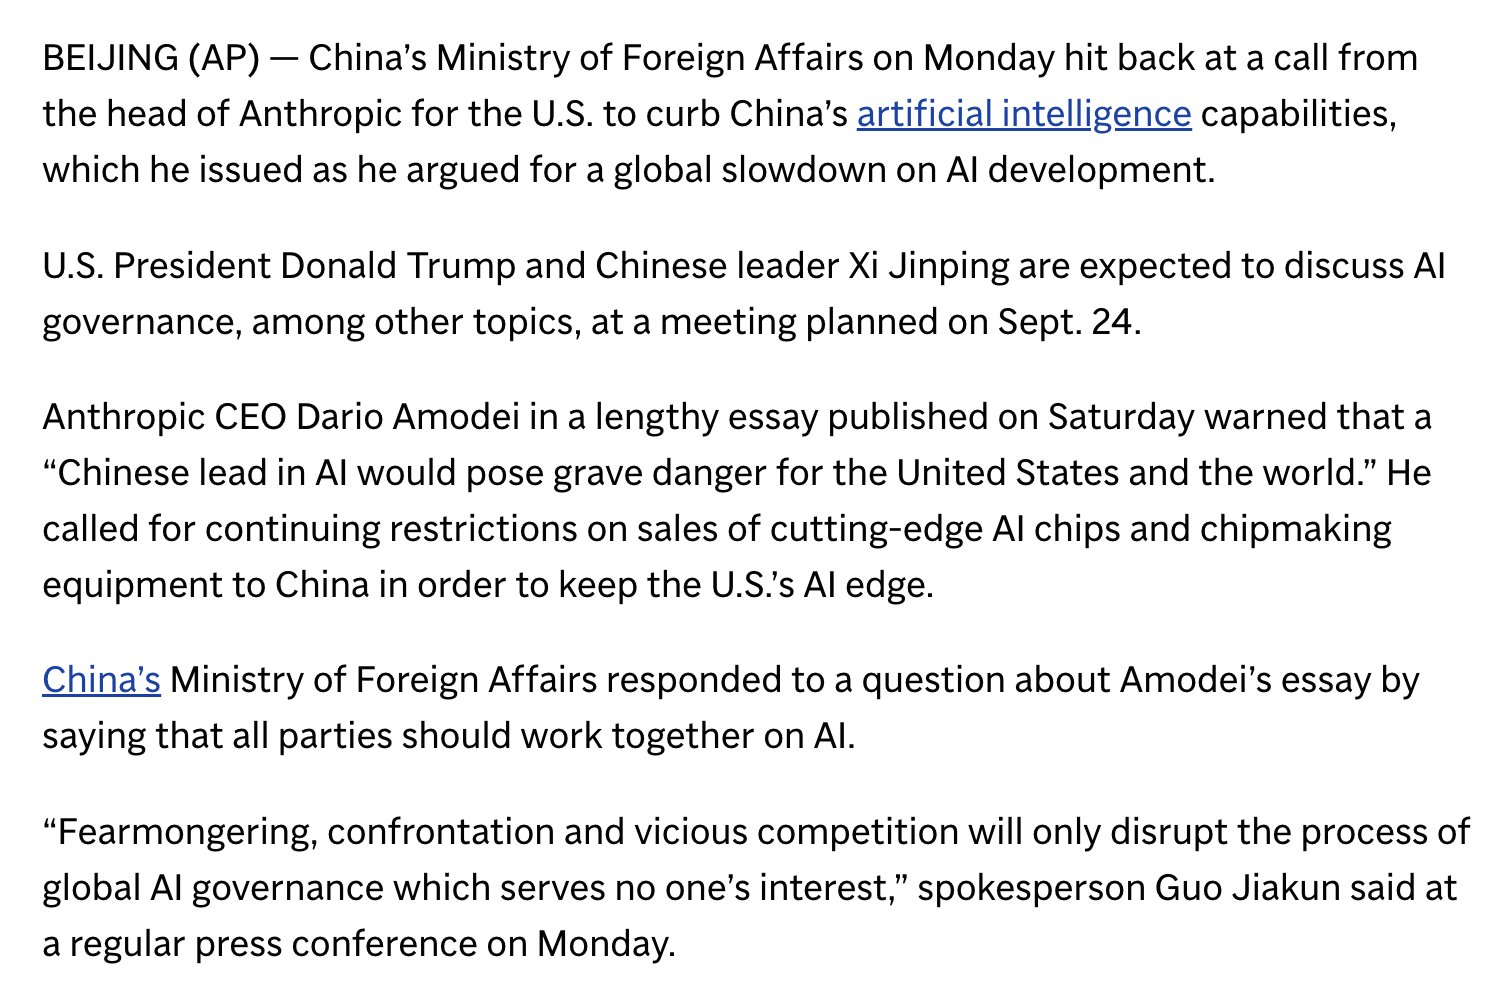
어제 Trump가 속도 조절 요구를 거부했다는 소식에 이어, 오늘 새로 들어온 것은 중국의 반응과 9월 24일 정상회담 일정입니다. Amodei가 토요일 공개한 에세이는 두 가지를 같이 말합니다. 최전선 모델의 개발 속도를 늦추자는 요구와, 첨단 AI 칩·칩 제조 장비의 대중국 판매 제한을 이어 가자는 요구입니다. 그는 중국이 AI에서 앞서면 미국과 세계에 중대한 위험이 된다고 적었습니다. 베이징이 반발한 쪽은 앞이 아니라 뒤입니다. Global Times는 이를 위선적이고 근시안적인 "조용한 AI 냉전"이라고 불렀고, 미국이 기술 장벽과 규제 독점으로 중국의 AI 발전을 묶으려 한다고 썼습니다. 외교부는 모든 당사자가 함께 가야 한다는 쪽으로 답했습니다. 국제 거버넌스를 거부한 것이 아니라, 속도 조절과 대중국 제한을 한 묶음으로 내놓는 방식을 거부한 것입니다.
그 밖에: Reuters 집계로 9월 14일 아시아 증시에서 OpenAI 투자사 SoftBank 주가가 장 초반 13.2%까지 내렸습니다. 메모리 업체 Kioxia는 9.8%, SK Hynix는 5.3%, Samsung Electronics는 3.7%, TSMC는 1.2% 하락했습니다. 미국이 중국 AI 기업 제재를 거론하는 것이 양자 AI 안전 대화를 여는 노력을 흔들 수 있다는 분석가들의 경고도 Reuters가 함께 전했습니다.
시사점: 속도 조절은 이제 연구소들끼리 합의할 문제가 아니라 9월 24일 정상회담 테이블에 오르는 협상 안건입니다. 수출 통제를 같이 묶어 내놓는 한, 상대는 안전 제안과 봉쇄 정책을 구분하지 않고 답합니다.
#AI정책 #미중 #수출통제
출처 4🔥 @kimmonismus🔁 @Reuters🔁 @Reuters💬 @mark_k
5. Sakana AI의 PC-ALM이 역전파 없이 1,000층 신경망을 학습시켰다
- Sakana AI가 역전파(backpropagation)를 대체하는 국소 학습법 PC-ALM을 공개했습니다. 층마다 이웃 층하고만 신호를 주고받는 동역학으로 잔차 MLP를 1,000층까지 학습시켰습니다.
- MNIST 실험(폭 32, ReLU, 5에포크)에서 PC-ALM의 시험 정확도는 1,000층 구간까지 역전파와 약 2%포인트 안쪽 차이로 따라붙었습니다.
- 각 층에 라그랑주 승수 역할을 하는 이중 뉴런을 붙여 PI 피드백 제어기로 만들었고, 선형망에서는 이 값이 역전파의 신용 신호와 정확히 일치합니다.
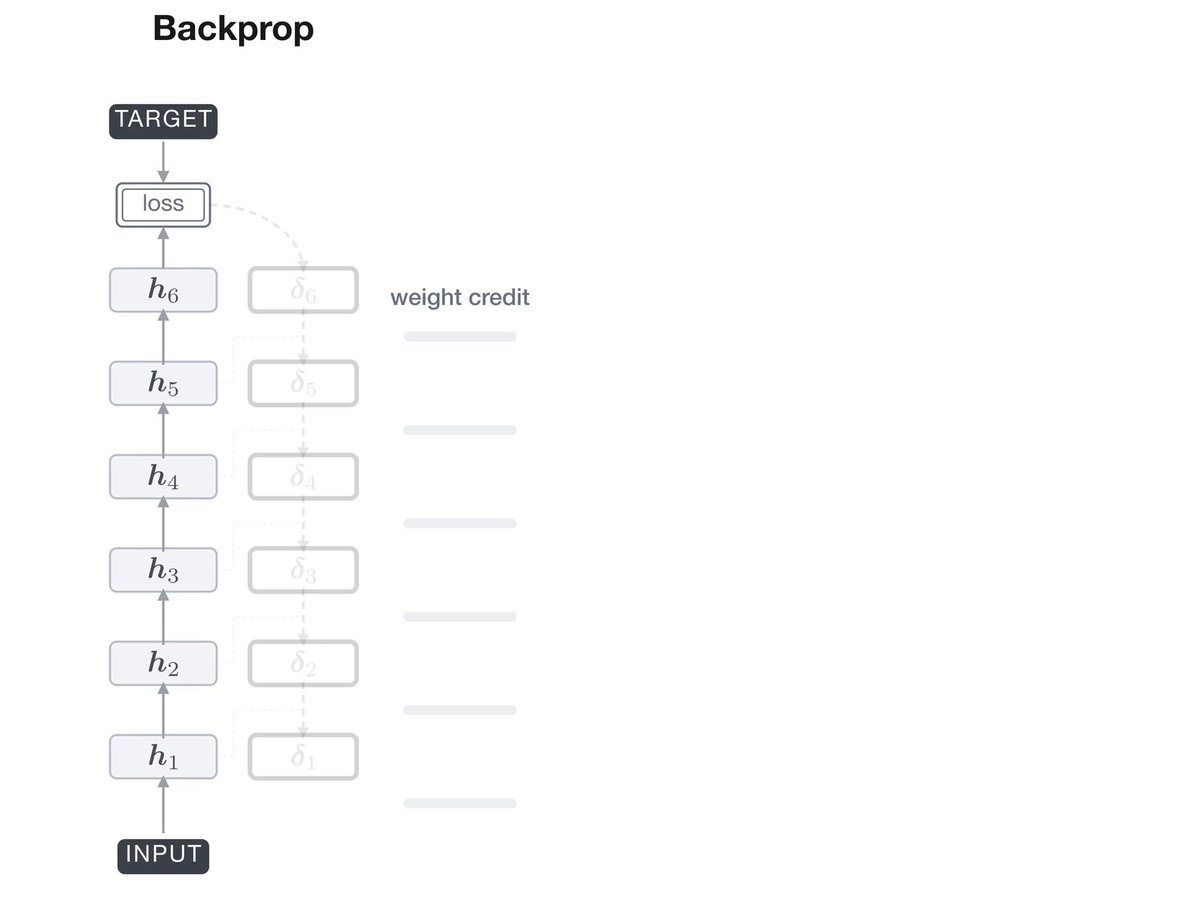
역전파는 순전파, 역전파, 가중치 갱신이라는 세 단계를 엄격한 순서로 밟습니다. 앞쪽 층의 뉴런은 뒤에서 오차가 도착할 때까지 활성값을 붙들고 기다려야 하는데, 뇌에는 망 전체를 그렇게 맞춰 줄 장치가 없습니다. 그래서 각 층이 이웃하고만 주고받는 예측 부호화(predictive coding)가 대안으로 연구돼 왔지만, 깊고 좁은 망에서는 신용 신호가 입력 쪽에 닿기 전에 약해졌습니다. PC-ALM은 층마다 오차를 누적하는 항을 더해, 신호가 천천히 번지는 대신 파면처럼 앞으로 밀고 나가게 만들었습니다.
뿌리는 1988년 Yann LeCun의 결과입니다. 제약 조건이 붙은 신경망의 라그랑주 승수가 평형에서 역전파의 신용 신호와 같아진다는 내용인데, PC-ALM은 그 승수를 각 층이 스스로 굴리는 상태 변수로 내려놓았습니다. 저자들은 층별 국소 학습법이 1,000층 학습에 성공한 사례는 아는 한 이번이 처음이라고 적었습니다.
그 밖에: 논문은 arXiv 2605.31022, 코드는 GitHub의 SakanaAI/pc-alm에 공개됐습니다. ResNet-18로 CIFAR-10과 Tiny ImageNet을 돌린 결과도 기존 예측 부호화보다 나았습니다. 대신 미니배치마다 층 수의 두 배, 1,000층이면 2,000회의 수렴 반복이 필요합니다.
시사점: GPU에서 역전파를 당장 대체하자는 제안이 아니라, 동역학 시뮬레이션이 더 싼 뉴로모픽 하드웨어와 뇌의 신용 할당을 겨냥한 연구입니다. 실험은 이미지 분류에 머물렀고, 회사도 더 큰 망과 더 어려운 과제, 시계열 과제로의 확장을 앞으로 할 일로 남겨 뒀습니다.
#PCALM #역전파대안 #뉴로모픽
출처 1🔥 @SakanaAILabs
6. Atria Dawn Preview가 결과를 외부 증거로 검증할 때까지 과제를 끝내지 않는다
- Shanghai Artificial Intelligence Laboratory가 장기 과제(long-horizon)용 에이전트 파운데이션 모델 Atria Dawn Preview를 공개했습니다. GLM-5.2를 바탕으로 한 744B MoE 구조에 컨텍스트 256K, 가중치는 MIT 라이선스입니다.
- 웹사이트·GitHub·Hugging Face·ModelScope와 호스팅 API를 한꺼번에 열었습니다. 다만 텍스트 전용 모델이라 이미지나 PDF는 입력으로 받지 못합니다.
- 회사가 낸 벤치마크 카드 8종에서 1위는 AutomationBench 53.8과 CyberGym 86.5 둘뿐입니다. GDPval 1583과 SWE-Bench Pro 59.6은 Claude Opus 5에 밀립니다.
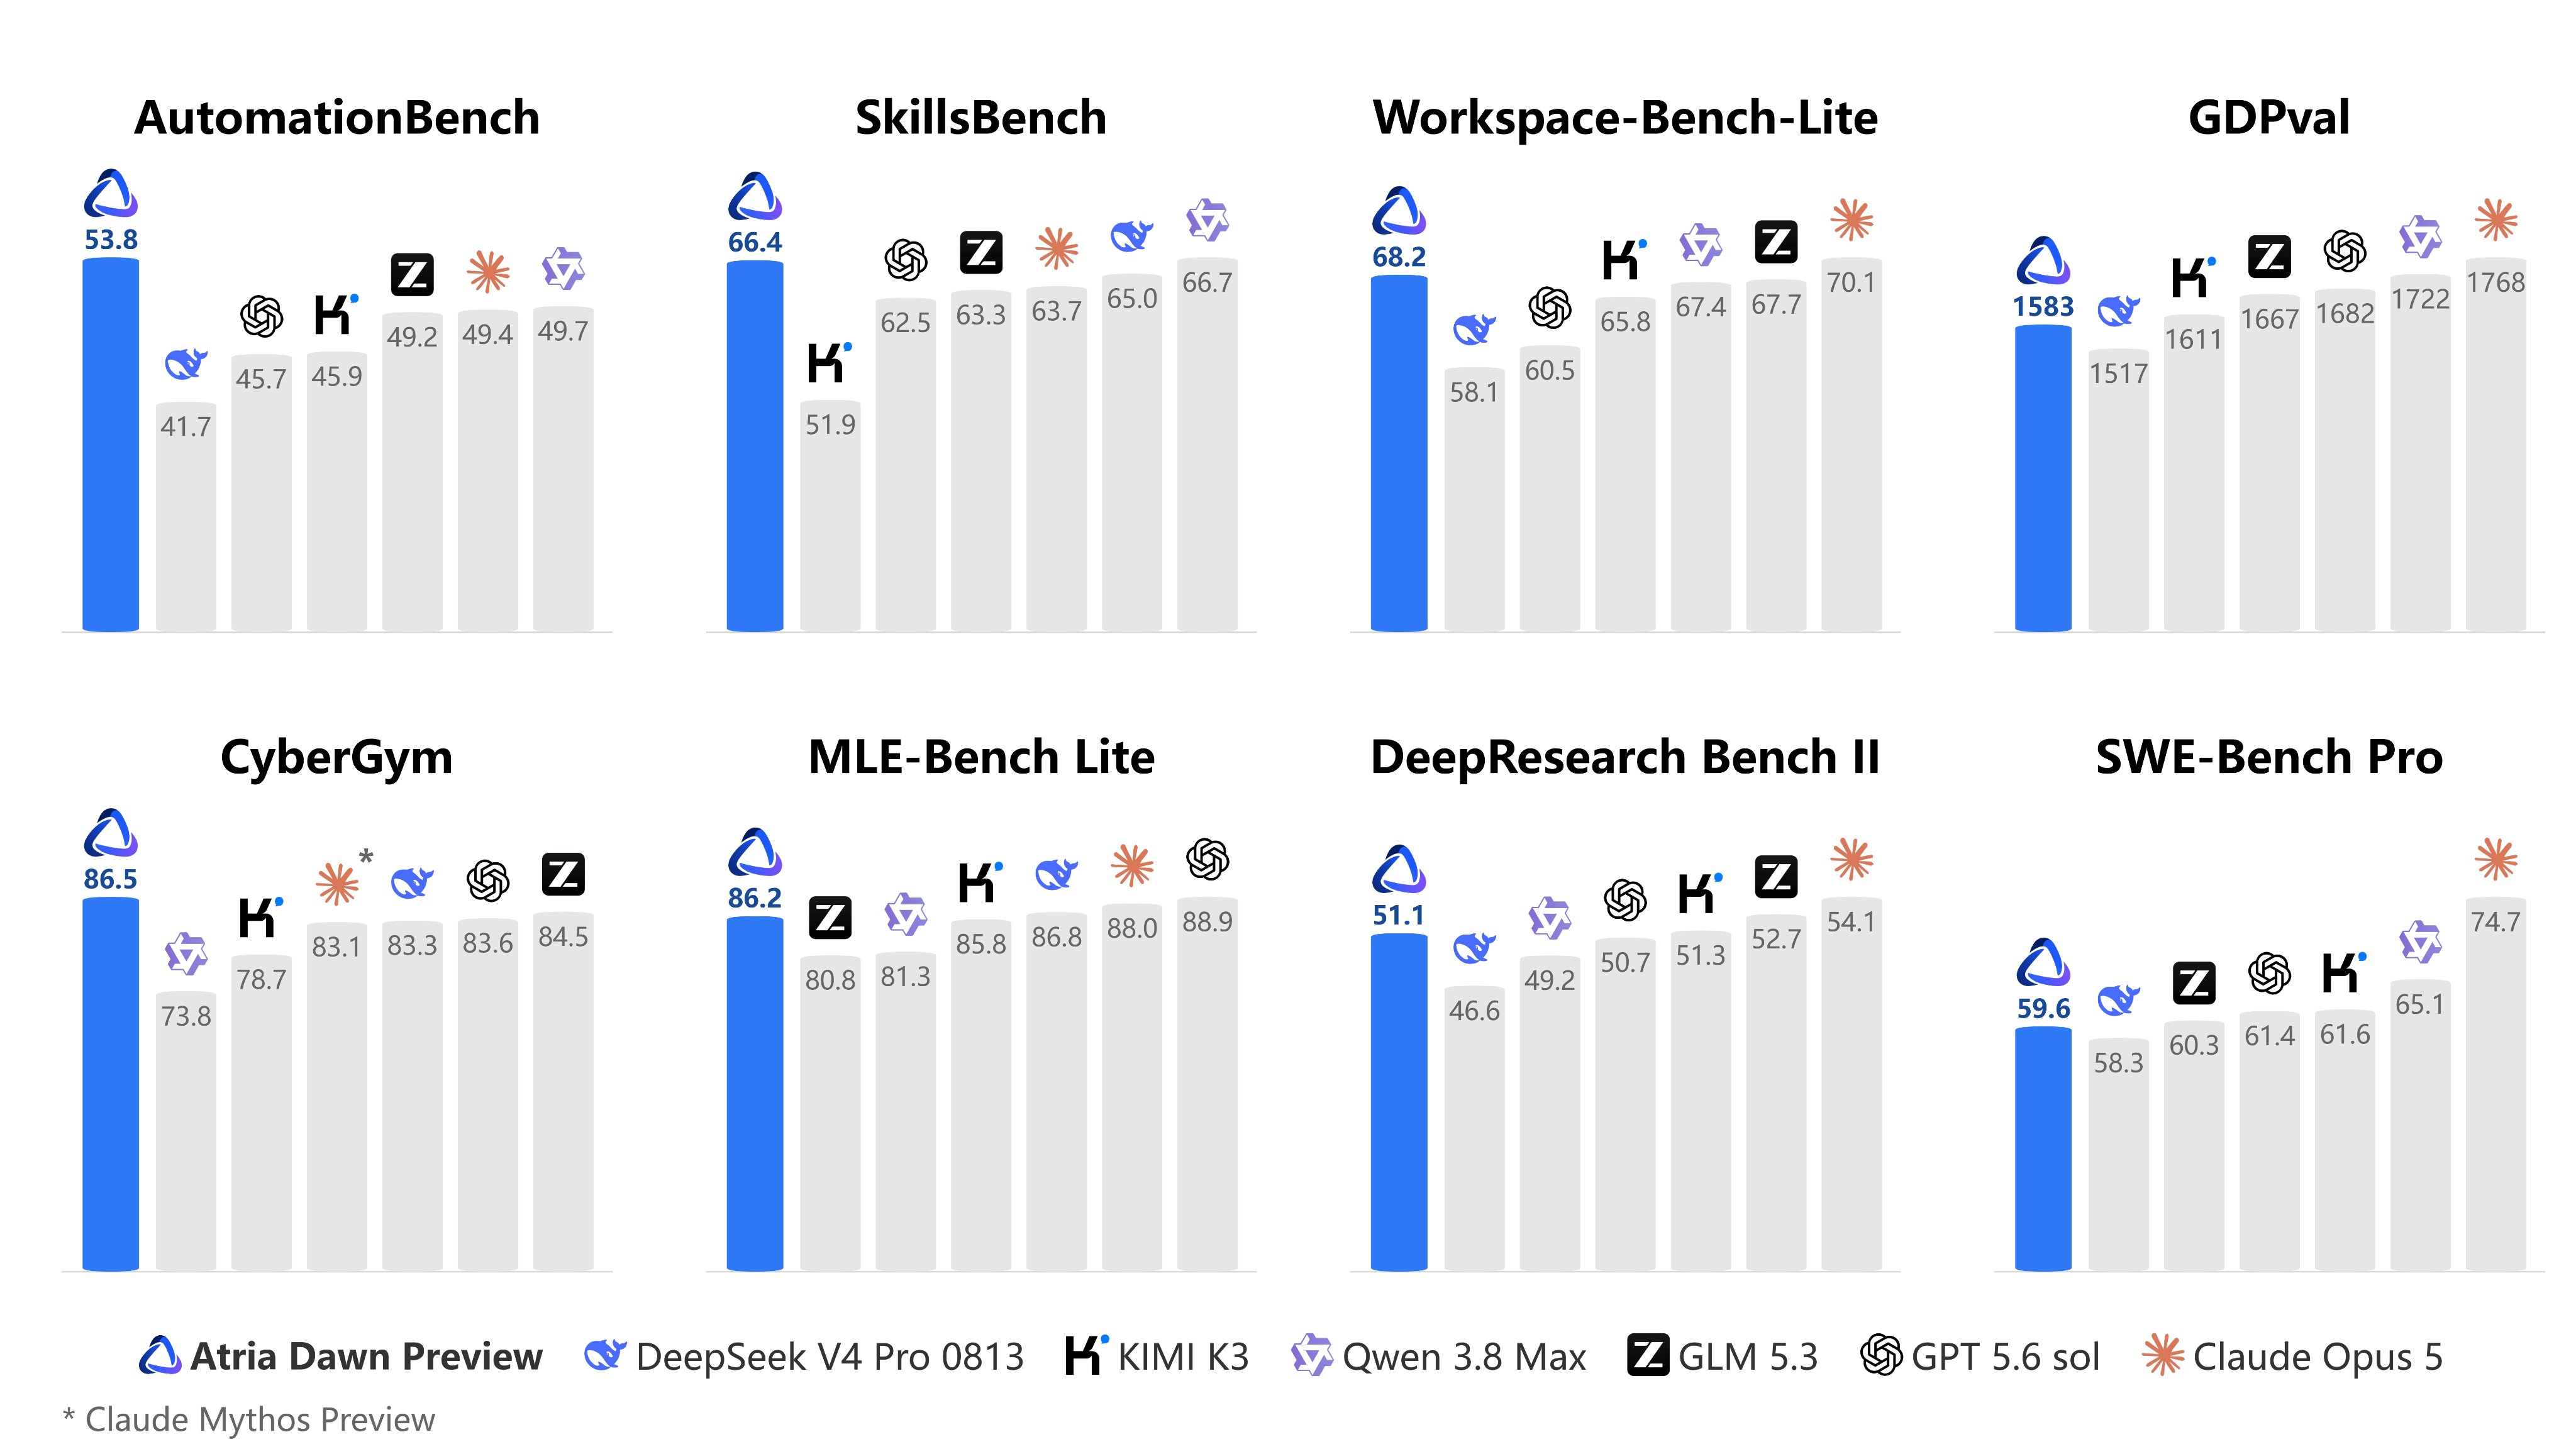
읽는 사람에게 가장 구체적인 부분은 완료 판정 규칙입니다. Hasan Toor는 이 모델을 출력이 외부 증거로 확인되기 전까지 과제를 완료로 보지 않는 설계라고 정리하면서, 테스트 결과·측정값·파일 상태·렌더링된 출력·출처 인용을 스스로 점검하는 신호로 든다고 적었습니다. 공식 문서의 표현은 이보다 절제돼 있습니다. 문제 분석부터 도구 사용, 코드 구현, 실험 실행, 결과 분석, 실패 복구까지를 한 고리로 잇고 실행 가능하고 검증 가능하며 재현 가능한 결과를 목표로 한다고만 적혀 있습니다.
그 밖에: 벤치마크 수치는 모두 회사가 자체 측정해 발표한 값이고, 외부 기관이 같은 조건으로 재현한 기록은 아직 없습니다. OpenBMB도 같은 날 배포 공지를 올렸습니다.
시사점: 장기 과제용 에이전트를 고르는 기준이 단일 점수에서 완료를 언제 선언하는가로 넓어지고 있습니다. 가중치가 MIT라 직접 내려받아 돌릴 수 있으니, 자체 측정값보다 본인 과제로 확인하는 편이 빠릅니다.
#에이전트 #오픈웨이트 #벤치마크
출처 3💬 @AtriaASI🔥 @OpenBMB💬 @hasantoxr
7. NVIDIA와 Palantir가 민감 데이터 우려로 Anthropic 모델 사용을 제한했다고 The Information이 보도했다
- The Information 보도를 Reuters가 전재했습니다. NVIDIA는 Anthropic 모델을 덜 민감한 작업으로만 쓰고 사내 업무는 자사 Nemotron 계열로 돌립니다.
- Palantir는 자사 소프트웨어에 Anthropic 모델을 올리기 전에 되돌릴 수 없는 무보존(zero data retention) 보장을 요구했고, Booz Allen Hamilton은 독점 사이버보안 업무에 상용 모델 사용을 막았습니다.
- 발단은 6월 정책 변경입니다. Anthropic이 상위 모델의 사용 로그를 30일 보관하도록 바꾸자 규제 산업 고객들이 받아들이지 못했습니다.
Anthropic은 이 문제를 9월 초에 Enterprise Frontier Safeguards로 손봤습니다. 오용 탐지에 쓰는 활동 데이터를 고객 자신의 Amazon S3·Azure Blob Storage·Google Cloud Storage 계정에 고객 키로 저장하고, 탐지는 자동으로만 돌려 Anthropic 직원의 검토를 없애는 방식입니다. 100곳 넘는 기업과 함께 만들었고 별도 요금은 없으며, 전면 제공은 올가을을 목표로 단계 배포 중입니다. 대비책이 이미 나와 있는데도 제한 보도가 나온 셈이라, 고객사의 계약·내부 규정 검토가 아직 끝나지 않았다고 읽는 편이 맞습니다. 다만 NVIDIA·Palantir·Anthropic 어느 쪽도 이 보도 내용을 공식 확인하지 않았고, 아직은 매체 보도 단계의 전언입니다.
제한 대상은 Anthropic만이 아닙니다. 같은 보도는 OpenAI 모델도 함께 묶었고, 두 회사 모두 기본 설정에서는 고객 데이터로 학습하지 않되 제품 개선용 익명 메타데이터는 수집한다는 입장입니다. Microsoft는 이 불안을 영업 포인트로 삼아 격리된 클라우드 환경과 자사 모델을 권하고 있다고 보도는 덧붙였습니다.
그 밖에: Financial Times는 미국 2위 로펌 Latham & Watkins가 NVIDIA 서버를 사서 오픈웨이트 모델 Nemotron 3를 사내에서 파인튜닝한다고 전했습니다. 2025년 매출 83억 달러인 이 로펌은 기술 인력 900명 중 약 100명을 이 프로젝트에 투입했고, 비용은 수억 달러에 이를 수 있습니다. 최고정보책임자는 어떤 클라우드 벤더에도 올리고 싶지 않은 민감한 고객 정보가 있다고 FT에 말했습니다. 펜타곤까지 제한 주체로 넓혀 전한 속보 계정도 있었지만 원 보도에는 없는 전언입니다.
시사점: 모델을 고를 때 성능보다 로그가 어디에 남고 누가 보느냐를 먼저 확인하는 흐름이 대형 고객 쪽에서 굳어지고 있습니다. 사내 데이터를 다루는 도구라면 보존 기간과 저장 위치를 계약 조건에서 확인해 두는 편이 안전합니다.
#Anthropic #데이터보존 #엔터프라이즈
출처 6🔥 @Reuters🔥 @Polymarket🔥 @unusual_whales🔥 @WatcherGuru🔥 @ai💬 @bearlyai
8. Anthropic이 2개 분기 연속 조정 영업이익 흑자와 80% 넘는 총마진을 알렸다
- Anthropic이 조정 영업이익이 2개 분기 연속 흑자가 될 것이라고 주주들에게 알렸다고 Financial Times가 9월 13일 보도했고, Reuters가 이를 받아 전했습니다.
- 총마진은 80%를 넘습니다. 단 Amazon을 포함한 유통 파트너와 나누는 수익, 그리고 모델 학습 비용을 빼기 전 기준입니다.
- 2분기 매출은 115억 달러로 1년 전의 14배입니다. 조정 영업이익은 주식보상비용을 제외한 지표이고, 수치는 감사 전 예비치입니다.
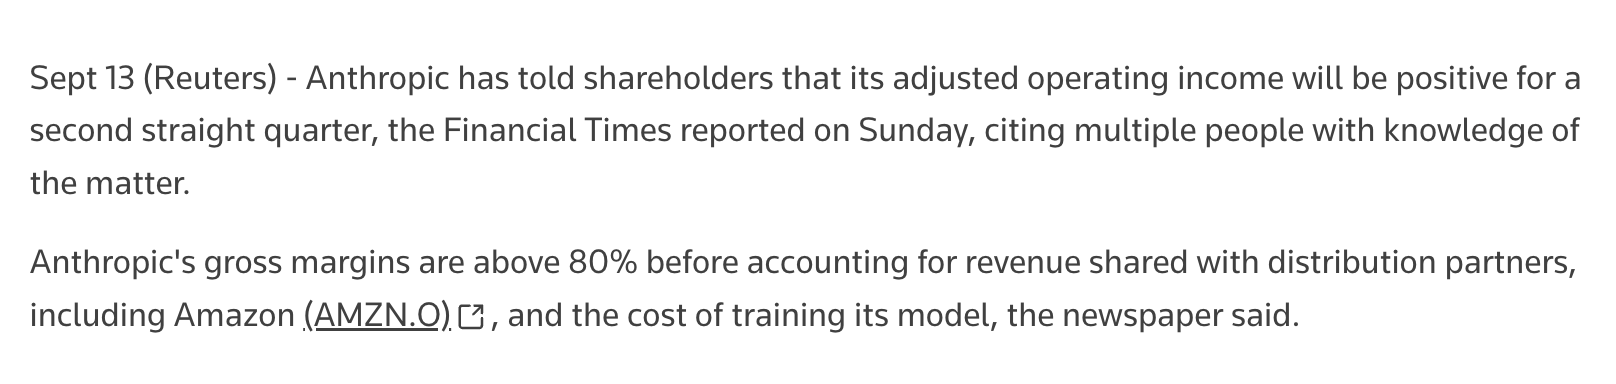
전날 속도 조절을 요구한 회사가 하루 만에 재무 숫자로 다시 등장했습니다. 다만 두 숫자 모두 조건이 붙습니다. 조정 영업이익은 주식보상비용을 뺀 값이고, 80%라는 총마진도 파트너 배분과 학습 비용을 빼기 전입니다. Quantian은 이를 두고 매출원가를 차감하기 전 이익을 본 셈이라고 꼬집었습니다. Reuters는 이 보도 내용을 즉시 확인하지는 못했다고 덧붙였습니다. 그래도 프런티어 랩이 자기 재무만으로 흑자를 말한 사례는 아직 드뭅니다.
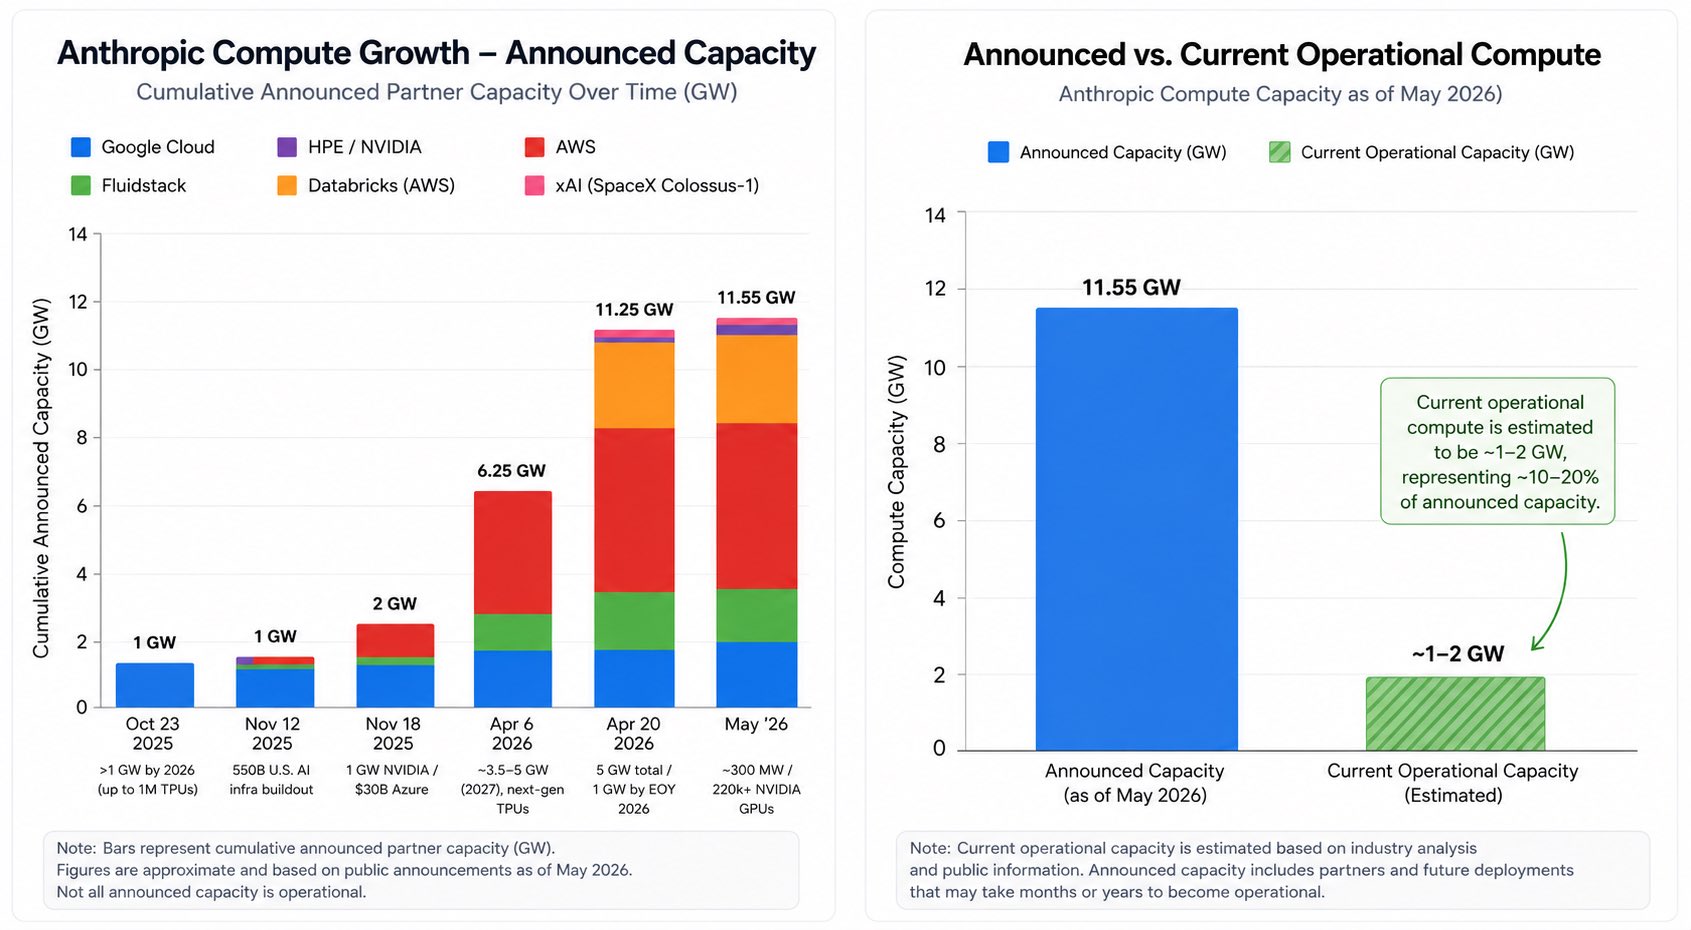
그 밖에: 같은 날 올라온 Oguz Erkan의 도표는 누적 발표 컴퓨트가 11.5GW를 넘었다고 적으면서, 실제 가동 용량은 발표치의 10~20%인 1~2GW로 추정했습니다. 그는 현행 단가 하단으로 잡아도 연간 컴퓨트 비용이 1,150~1,200억 달러라고 계산했는데, 이 값은 본인 추산입니다.
시사점: 흑자도 80% 마진도 무엇을 빼고 잰 값인지가 함께 붙어 있는 숫자입니다. 발표한 컴퓨트와 실제로 돌아가는 컴퓨트의 간격도 아직 큽니다.
#Anthropic #재무 #컴퓨트
출처 4💬 @kimmonismus💬 @oguzerkan🔁 @stretchcloud🔥 @quantian1
9. Artificial Analysis가 정보통신산업진흥원(NIPA)과 독자 AI 파운데이션 모델 평가 MOU를 맺었다
- 독립 벤치마크 기관 Artificial Analysis가 한국 정부의 독자 AI 파운데이션 모델 프로젝트에 공식 평가 파트너로 참여하는 MOU를 맺었다고 밝혔습니다. 사업을 운영하는 곳은 과학기술정보통신부 산하 정보통신산업진흥원(NIPA)입니다.
- 회사에 따르면 직전 심사에서 참여 연구팀의 모델은 Artificial Analysis Intelligence Index로 측정됐고, 이 지수가 전체 심사 기준의 25%를 차지했습니다.
- 회사가 함께 올린 서명식 사진에는 두 기관 이름과 2026년 9월 11일이라는 날짜가 현수막에 적혀 있습니다.
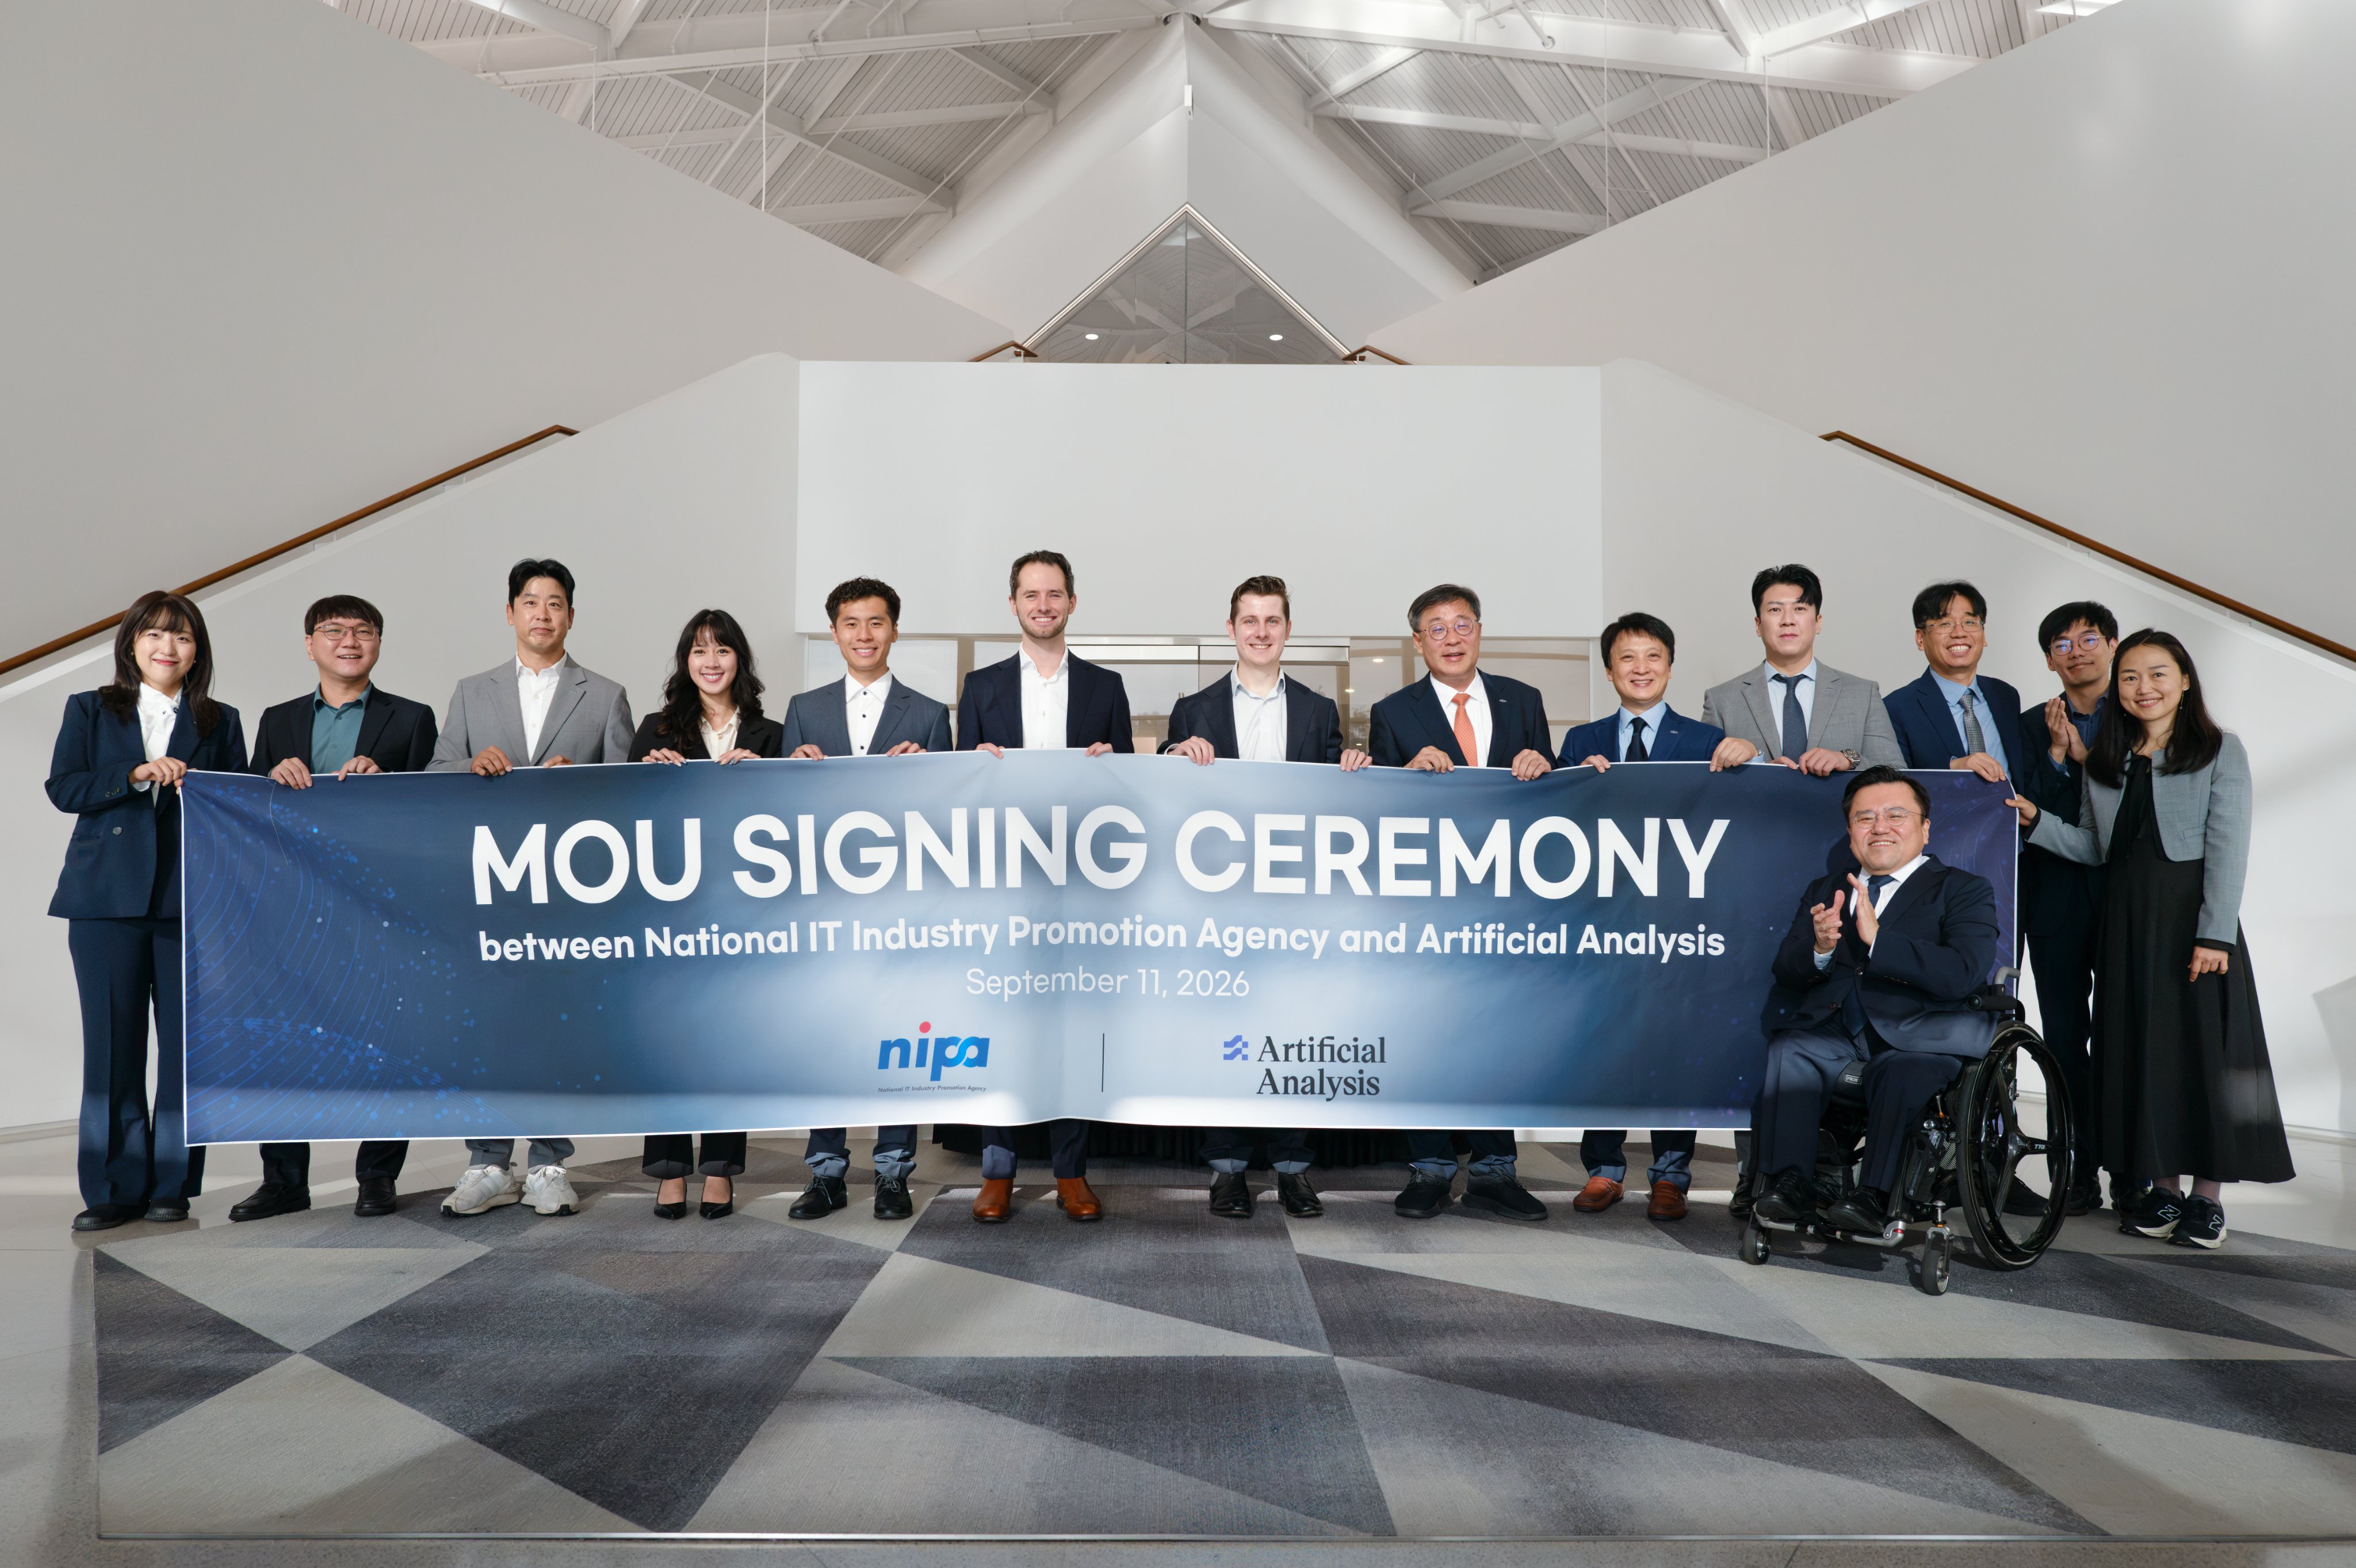
Artificial Analysis는 여러 모델을 같은 조건으로 돌려 하나의 지수로 묶어 공개하는 민간 평가 기관입니다. 독자 AI 파운데이션 모델 프로젝트는 2025년 과학기술정보통신부와 NIPA가 시작한 국책 사업입니다. 선발된 정예팀에 대규모 GPU와 자금을 주고 단계평가로 인원을 좁혀 갑니다. 지난 8월 2차 단계평가에는 업스테이지·SK텔레콤·LG AI연구원·모티프테크놀로지스 네 팀이 올랐고, 앞의 세 팀이 다음 단계로 갔습니다. 네 팀 모두 Artificial Analysis Intelligence Index에서 31점 이상을 받았습니다. 국가가 예산과 연산을 대는 사업에서 성적을 매기는 주체를 외부 기관으로 고정했다는 것이 이번 MOU의 내용입니다. 회사는 각국의 소버린 AI 사업을 독립 평가로 뒷받침하려는 방향의 일부라고 적었습니다.
그 밖에: 참여 팀은 약 1,000장 규모의 NVIDIA B200을 6개월간 쓰는 조건으로 알려졌고, 통과 팀은 지원이 더 늘어납니다. 이번 발표 게시물은 조회 4,384회에 그쳐 X에서는 거의 퍼지지 않았습니다.
시사점: 국내 모델의 성적을 외부 독립 지표가 매기면 홍보 문구 대신 다른 나라 모델과 같은 축의 숫자로 비교할 수 있습니다. 다음 단계평가에서 지수 점수가 어느 범위까지 공개되는지가 확인 지점입니다.
#소버린AI #NIPA #벤치마크
10. 🆕 그 밖의 신기능·신제품
- MiniMax H3 — 8월 공개된 영상 생성 모델의 커뮤니티 가속판이 모였습니다. 4스텝 FastH3가 DGX Spark와 Apple Silicon에서 돌고, NVIDIA 증류 기법 PDD는 Alibaba PAI가 ComfyUI용 8스텝 LoRA로 옮겼습니다.
- Intern-S2-397B — 과학 연구용 멀티모달 모델로 Apache 2.0에 BF16·FP8로 배포합니다. 제공사 발표 비교표에서 FrontierScience-Olympiad 87.00으로 1위입니다.
- Bolt Forge — bolt.new가 오픈 모델만 쓰는 모드를 열었습니다. 10월 14일까지 무료이고, 데이터 공유에 동의하면 사용량 최대 50배입니다.
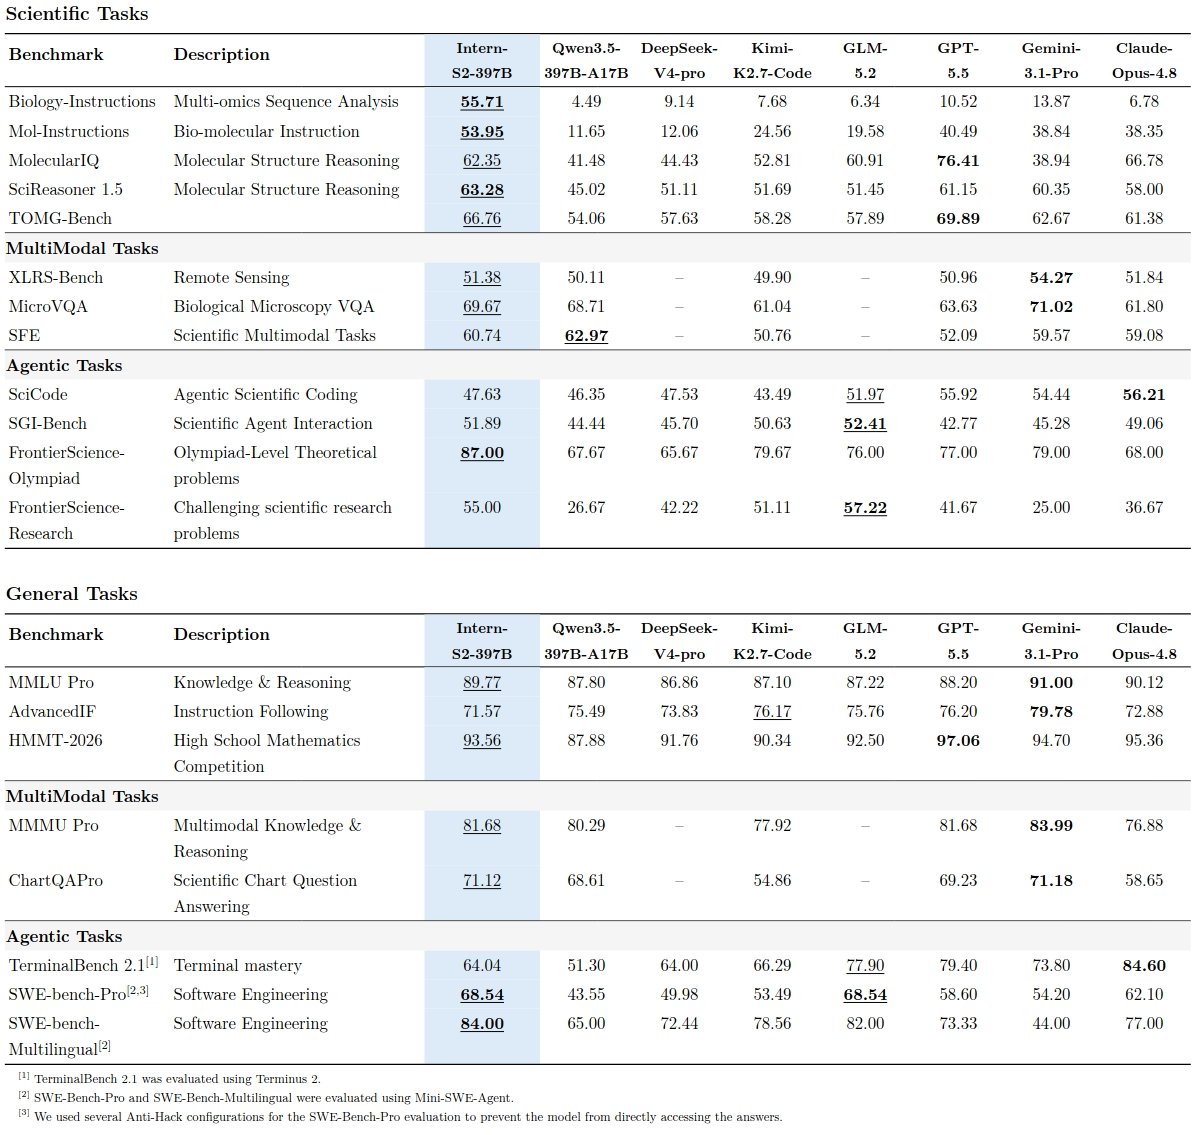
셋의 성격이 다릅니다. MiniMax 쪽은 새 모델이 아니라 가속 레시피가 데이터센터 GPU에서 DGX Spark와 Mac으로 내려온 이야기입니다. Intern-S2-397B는 분자·생물 과제용이라 일반 순위표와 따로 읽어야 합니다. Bolt Forge는 사용량을 학습 데이터와 맞바꾸는 구조로, Arcee AI가 이 데이터로 1조 파라미터 오픈 모델을 10월부터 학습합니다.
그 밖에: T3 Code가 응답 스트리밍을 기본값으로 바꿨고(토큰 단위는 아님), 정식판 전 끄는 옵션도 넣습니다. Gemini API 목록에 뜬 antigravity-preview-09-2026은 한때 '새 모델'로 보였지만, 같은 날 Antigravity 에이전트 하네스의 9월 프리뷰 ID(5월판과 동일 계열)라는 반론이 나왔습니다.
시사점: 오픈 모델의 값이 요금표에서 계약서로 옮겨가고 있습니다. Bolt Forge는 켜기 전에 무엇을 넘기는지 확인하고, 특화 모델은 자기 과제 벤치마크로 고르십시오.
#오픈웨이트 #영상생성 #코딩도구
출처 9💬 @MiniMax_AI🔥 @intern_lm🔥 @ModelScope2022🔥 @boltdotnew🔥 @theo🔥 @theo🔥 @chetaslua💬 @thtbee_🔥 @astropol0
오늘의 감정·온도
오늘의 실무 팁 — 쉽게 풀어 쓴 사용법 6가지
1. 주간 한도부터 확인하고 무거운 모델을 돌립니다
Claude Code에서 /usage를 치면 이번 주에 얼마나 썼는지 비율로 나옵니다. 한도가 바뀌는 날은 공지보다 이 화면이 먼저 알려 주니, 큰 작업 전에 한 번 열어 보십시오. — (@matthewmillerai · @rohit3a)
2. 로컬 추론은 요금제보다 그래픽카드 메모리를 먼저 봅니다
Portable Computer는 VRAM 24GB 이상인 RTX 카드에서만 켜집니다. 작업 관리자의 성능 탭이나 그래픽카드 속성에서 전용 메모리 용량을 확인한 뒤 구독 여부를 정하면 헛돈을 쓰지 않습니다. — (@perplexity_ai)
3. 무료 사용량이 크게 늘어난 모드는 교환 조건을 먼저 읽습니다
Bolt Forge의 사용량 최대 50배는 익명 세션 데이터를 학습용으로 넘기는 데 동의해야 적용됩니다. 업무 코드나 고객 자료를 다루는 화면에서는 이 모드를 끄고 쓰는 편이 안전합니다. — (@boltdotnew)
4. 가중치가 공개된 모델은 발표 점수 대신 내 과제로 잽니다
회사가 낸 비교표는 자기 측정값이라 조건이 서로 다를 수 있습니다. MIT나 Apache 2.0처럼 제약이 약한 라이선스면 직접 내려받아 평소 쓰는 작업 열 개만 돌려 봐도 순위표보다 빨리 결론이 납니다. — (@AtriaASI)
5. 드라이버나 주변기기 문제도 코딩 에이전트에 한번 맡겨 봅니다
steipete는 웹캠이 동작하지 않던 노트북을 코딩 에이전트에 맡겨 재부팅까지 시키고 고쳤다고 적었습니다. 증상과 오류 로그를 붙여 넣고 고쳐 달라고만 해도 설정 파일을 찾아 수정해 주는 경우가 많습니다. — (@steipete)
6. 3D 모델 작업은 연동 도구보다 화면을 직접 조작하게 시킵니다
Blender를 프로그램끼리 연결하는 방식(MCP)보다, 모델이 화면을 보고 직접 조작하는 컴퓨터 사용 기능을 쓰는 편이 결과가 안정적이었다는 후기가 나왔습니다. 형태 생성은 전용 도구에 맡기고 마무리 세팅만 모델에 넘기는 순서가 실패가 적습니다. — (@Dstudio_ai)
📦 확인 방식
수치는 각 회사의 발표 화면과 공식 문서, Reuters·Financial Times 보도에서 가져왔습니다. 자체 측정 벤치마크와 개인 사용량 화면의 값은 본문에 그 사실을 함께 적었으며, 이 리포트는 외부 독립 검증 전입니다.
🏷 라벨 가이드 — 🔥 널리 퍼진 글 · 💬 댓글이 많이 붙은 글 · 🔁 리트윗 비중이 높은 글