오늘의 AI 브리핑 ·
Opus 5.5, GPT-6 앞질렀다
5분 브리핑
약 3분 · 10개 흐름핵심만 먼저 읽고, 궁금한 소식은 본문으로 이어 보세요.
전체 분석 15분으로 바로 가기 ↓- Claude Opus 5.5가 나왔다 — 터미널 작업 정답률이 66.4%로 GPT-6 Astra(57.9%)를 앞섰다
Anthropic이 Claude Opus 5.5를 공개했습니다. 공식 성능표에서 Terminal-Bench 4.0 66.4%를 받았는데, 명령어 창에서 작업을 끝까지 해내게 시키는 시험입니다.
- GPT-6 Sol과 Luna가 ChatGPT Work·Codex에 풀렸다 — 값을 절반으로 내렸다
OpenAI가 GPT-6 계열에서 싸고 빠른 모델 두 종을 열었습니다. Sol은 복잡한 코딩과 여러 단계를 스스로 밟는 작업용이고, Luna는 요약이나 짧은 답변처럼 양이 많고 목적이 분명한 작업용입니다.
- Grok Bot이 Tesla 차량 안으로 들어갔다 — 메일·일정·주문을 목소리로 시킨다
Tesla가 차 안 Grok에 Connectors(내가 쓰던 계정을 Grok에 연결하는 통로)를 열었습니다. 받은편지함 정리, 일정 정리, 이미 가진 파일·대화·할 일을 놓고 이야기하기를 운전대에서 손을 떼지 않고 시킬 수 있습니다.
- Pentagon 조사: 이란 미나브 학교 오폭에 AI 표적 시스템 과의존이 있었다
Bloomberg 보도에 따르면, Pentagon(미국 국방부)의 내부 조사 보고서는 2026년 2월 개전 첫날 이란 남부 미나브의 초등학교가 Tomahawk 미사일에 맞아 무너진 사건의 원인으로 낡은 정보와 AI 표적 시스템 과의존을 함께 지목했습니다.
- Alibaba가 Apsara 콘퍼런스에서 Qwen4 제품군을 예고했다 — 다음 세대는 5~10조 파라미터를 목표로 한다
Alibaba가 9월 22일 항저우에서 연 Apsara 콘퍼런스에서 Qwen4-Max·Qwen4-Flash·Qwen4-Plus·Qwen4-27B 네 이름을 처음 꺼냈습니다. 다만 Qwen4는 아직 훈련 중이고 출시일·가격·내려받을 가중치는 없습니다.
- Unreal Agent가 오픈소스로 공개됐다 — 회사 측정 기준 Codex보다 39% 싼 비용
Unreal Labs가 AI 코딩 에이전트를 감싸는 '하네스'(모델에게 도구·순서·검증을 물려 주는 겉옷)를 통째로 오픈소스로 열었습니다. 같은 모델을 써도 이 겉옷이 값을 정합니다.
- GPT-6 Astra가 2005년부터 안 풀리던 Enigma 전문 한 통을 풀었다
1941년 7월 10일 독일군이 보낸 Enigma(2차 대전 독일군 암호기) 전문 MVUEH는 2005년 공개 이후 21년간 아무도 풀지 못했습니다. Carter Leffer가 GPT-6 Astra에게 미해독 전문 목록만 건네자, 모델이 스스로 표적을 고르고 해독 도구를 직접 코딩해 82글자를 풀었습니다.
- Deel이 사내 자동화 도구 Akai를 외부에 열었다 — 90일간 채용 없이 연간반복매출이 1억 4천만 달러 넘게 늘었다고 회사는 밝혔다
인사·급여 대행 회사 Deel이 재무·인사·지급·규제 대응의 반복 업무를 줄이려고 사내에서 만든 도구 Akai를 현지 시각 9월 21일 제품으로 내놨습니다. 회사는 Akai로 90일 동안 사람을 새로 뽑지 않고 연간반복매출이 1억 4천만 달러 이상 늘었다고 밝혔습니다.
- Xiaomi MiMo-V2.6-Pro가 외부 순위표에서 오픈웨이트 1위에 올랐다
모델을 독립적으로 재는 Artificial Analysis가 MiMo-V2.6-Pro를 종합 지능 지수 46점으로 집계해, 가중치를 내려받아 쓸 수 있는 모델(오픈웨이트) 중 1위로 올렸습니다. 어제 Grok 4.7이 받은 46과 같은 표입니다.
- 🆕 그 밖의 신기능·신제품
StepFun이 새 주력 모델 Step 5 Preview를 내놨습니다. 외부 평가기관 Artificial Analysis의 종합 지능 점수는 44점으로 Kimi K3(max)와 같은데, 한 작업을 푸는 데 드는 비용은 약 2.8배 낮습니다.
주요 키워드 TOP 5: Claude Opus 5.5 · GPT-6 Sol·Luna · Tesla 속 Grok Bot · Qwen4 · 에이전트 비용 | 메인 이벤트: Opus 5.5·GPT-6 Sol·Unreal Agent가 같은 날 점수가 아니라 값을 움직였습니다.
Anthropic·OpenAI·Unreal Labs의 발표가 하루 안에 겹쳤는데, 셋이 공통으로 건드린 것은 순위표가 아니라 값이었습니다. Anthropic은 Claude Opus 5.5를 내놓으며 입력·출력 값을 함께 내렸고, OpenAI는 GPT-6 Sol과 Luna의 API 값을 절반으로 내렸으며, Unreal Labs는 모델을 그대로 둔 채 모델을 감싸는 도구만 바꿔 같은 점수를 더 싸게 냈다고 밝혔습니다. 같은 작업을 매일 반복해 돌리는 쪽이라면 오늘부터 확인할 곳은 순위표 맨 윗줄이 아니라 작업 한 건당 청구서입니다.
1. Claude Opus 5.5가 나왔다 — 터미널 작업 정답률이 66.4%로 GPT-6 Astra(57.9%)를 앞섰다
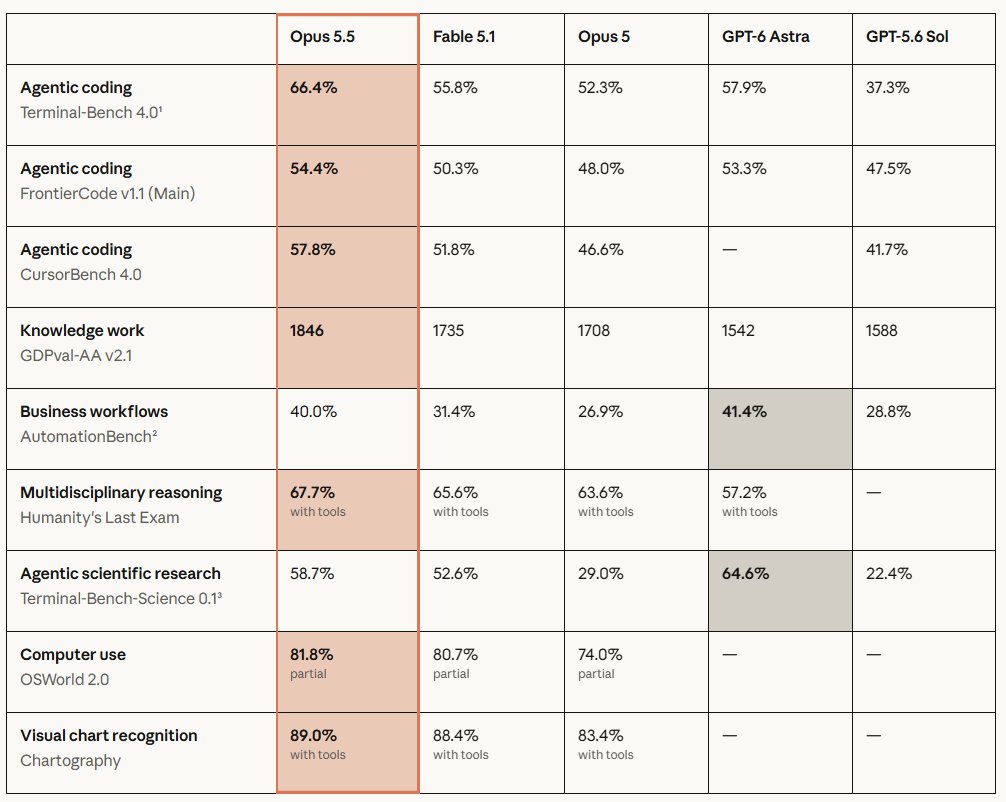
- Anthropic이 Claude Opus 5.5를 공개했습니다. 공식 성능표에서 Terminal-Bench 4.0 66.4%를 받았는데, 명령어 창에서 작업을 끝까지 해내게 시키는 시험입니다. GPT-6 Astra의 57.9%, 자사 상위 모델 Fable 5.1의 55.8%를 모두 넘었습니다.
- 값도 함께 내렸습니다. 100만 토큰당 입력이 $5에서 $4로, 출력이 $25에서 $20으로 내려갔습니다. 같은 자료를 반복해서 다시 넣을 때 매겨지는 캐시 읽기 값은 $0.50에서 $0.20으로 더 크게 내렸고, Anthropic은 보통의 작업이라면 총비용이 Opus 5보다 40% 적다고 적었습니다.
- Pro·Max·Team·Enterprise 요금제의 5시간 사용 한도를 올렸습니다. 한도가 풀리는 기회를 한 번 모아 뒀다가 원하는 때 쓰는 기능도 함께 넣었고, Anthropic 앱·API와 Amazon Web Services·Google Cloud·Microsoft Azure에서 바로 쓸 수 있습니다.
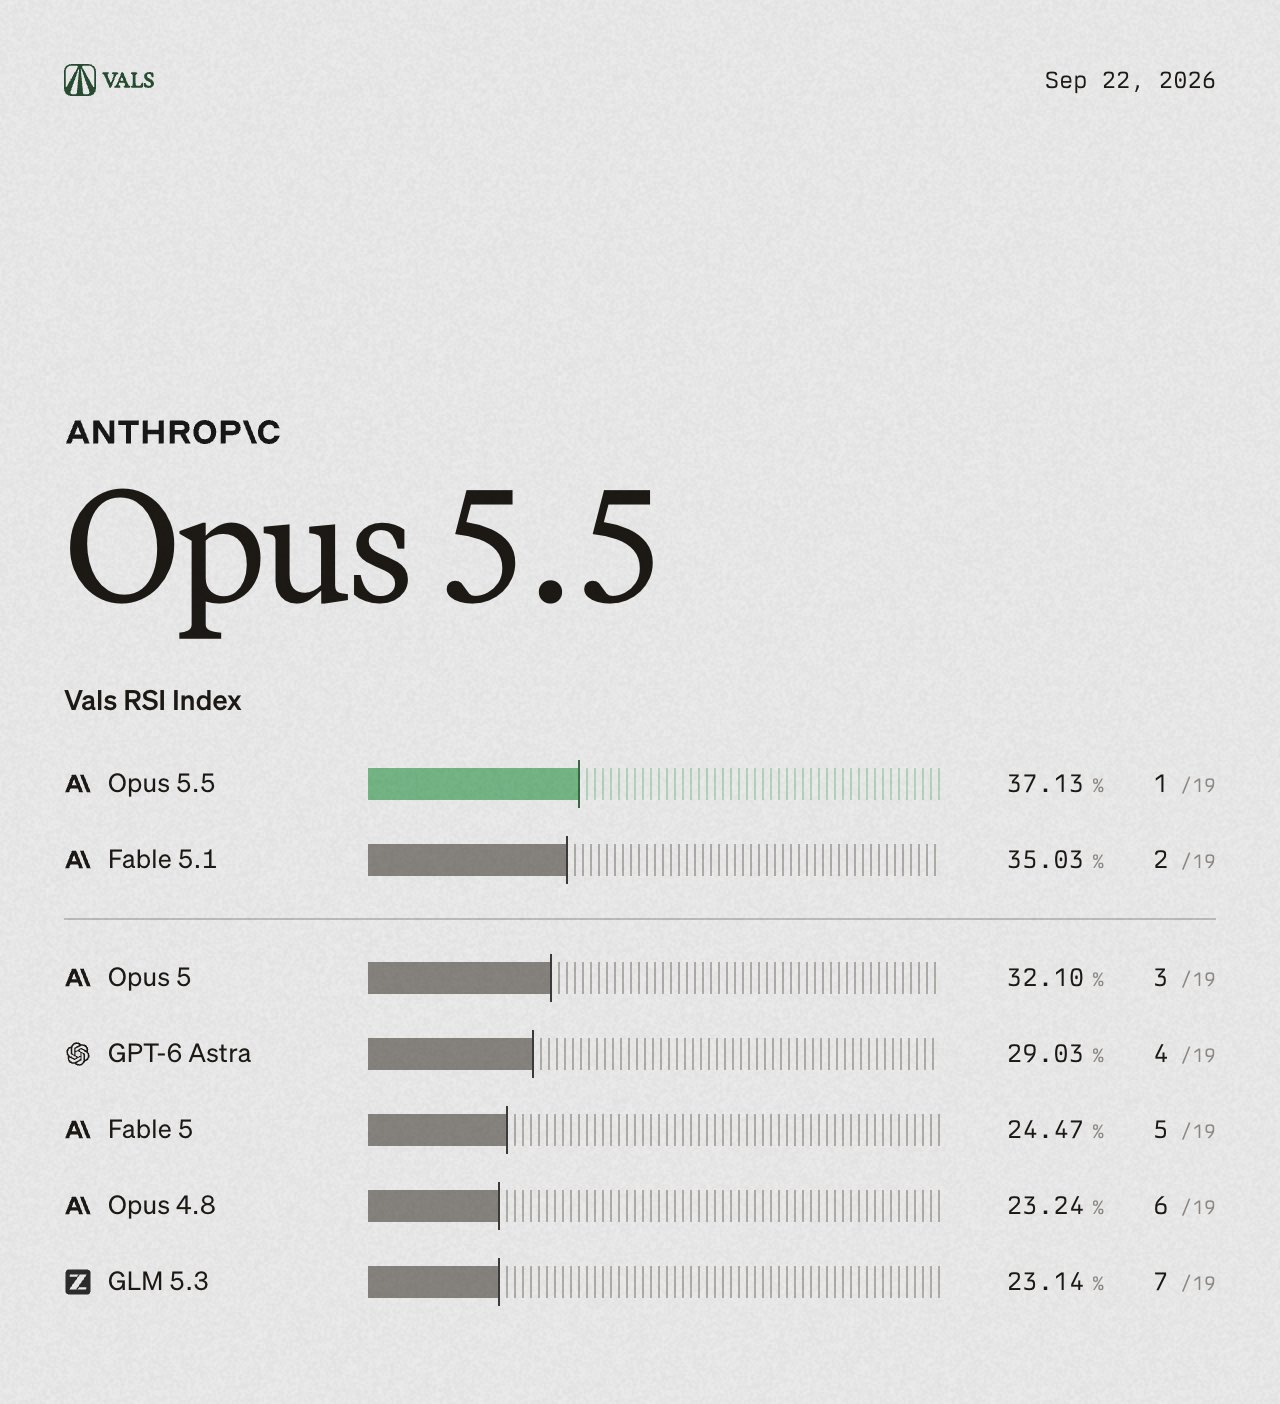
성능표에서 올라간 자리는 한곳에 몰려 있습니다. 사람이 한 번 시키면 모델이 여러 단계를 알아서 밟아 끝내는 작업, 이른바 에이전트 쪽입니다. 과학 연구 과제를 스스로 풀게 한 항목은 Opus 5의 29.0%에서 58.7%로 두 배가 됐습니다. 다만 그 항목과 업무 자동화 항목은 여전히 GPT-6 Astra가 앞서서, 모든 줄을 가져가지는 못했습니다. 바깥에서 잰 값도 같은 날 두 곳에서 나왔습니다. 코딩 도구 Cursor는 자사 시험에서 Opus 5.5가 57.8%로 1위였고 작업 하나당 비용이 Opus 5보다 40% 낮았다고 적었습니다. 모델 평가 업체 Vals AI는 긴 호흡의 작업을 재는 RSI Index에서 19개 모델 중 1위를 줬습니다.
그 밖에: Anthropic은 글 쓰는 방식도 손봐 중요한 내용을 앞에 놓고 사용자가 정해 준 글쓰기 규칙을 따르게 했다고 밝혔는데, 개발자 Theo는 그보다 긴 줄표가 사라진 것을 먼저 알아봤습니다. 프로그래밍 언어를 만드는 Victor Taelin은 자기 작업 전부에서 Fable 5.1보다 확실히 나았다면서도, Anthropic이 자기 분야 자료로 학습하고 있어 남들보다 차이를 크게 느낄 수 있다고 덧붙였습니다.
시사점: 이미 Claude를 쓰고 있다면 따로 갈아탈 일은 없습니다. 값이 내려가고 5시간 한도가 늘었으니, 한도에 걸릴까 봐 미뤄 두었던 긴 작업을 다시 꺼내 볼 만한 때입니다.
#ClaudeOpus55 #Anthropic #AI코딩
출처 6🔥 @DanDr1s🔥 @jkeatn🔥 @ValsAI🔥 @theo🔥 @theo🔥 @VictorTaelin
2. GPT-6 Sol과 Luna가 ChatGPT Work·Codex에 풀렸다 — 값을 절반으로 내렸다
- OpenAI가 GPT-6 계열에서 싸고 빠른 모델 두 종을 열었습니다. Sol은 복잡한 코딩과 여러 단계를 스스로 밟는 작업용이고, Luna는 요약이나 짧은 답변처럼 양이 많고 목적이 분명한 작업용입니다.
- ChatGPT Work와 Codex에서 Plus·Pro·Business·Enterprise·Edu 사용자에게 순차 적용됩니다. Free·Go 사용자도 데스크톱 앱에서 Luna를 쓸 수 있습니다.
- API 값은 둘 다 절반으로 내렸습니다. 100만 토큰 기준 Sol이 입력 2달러·출력 10달러, Luna가 입력 0.10달러·출력 0.50달러입니다.
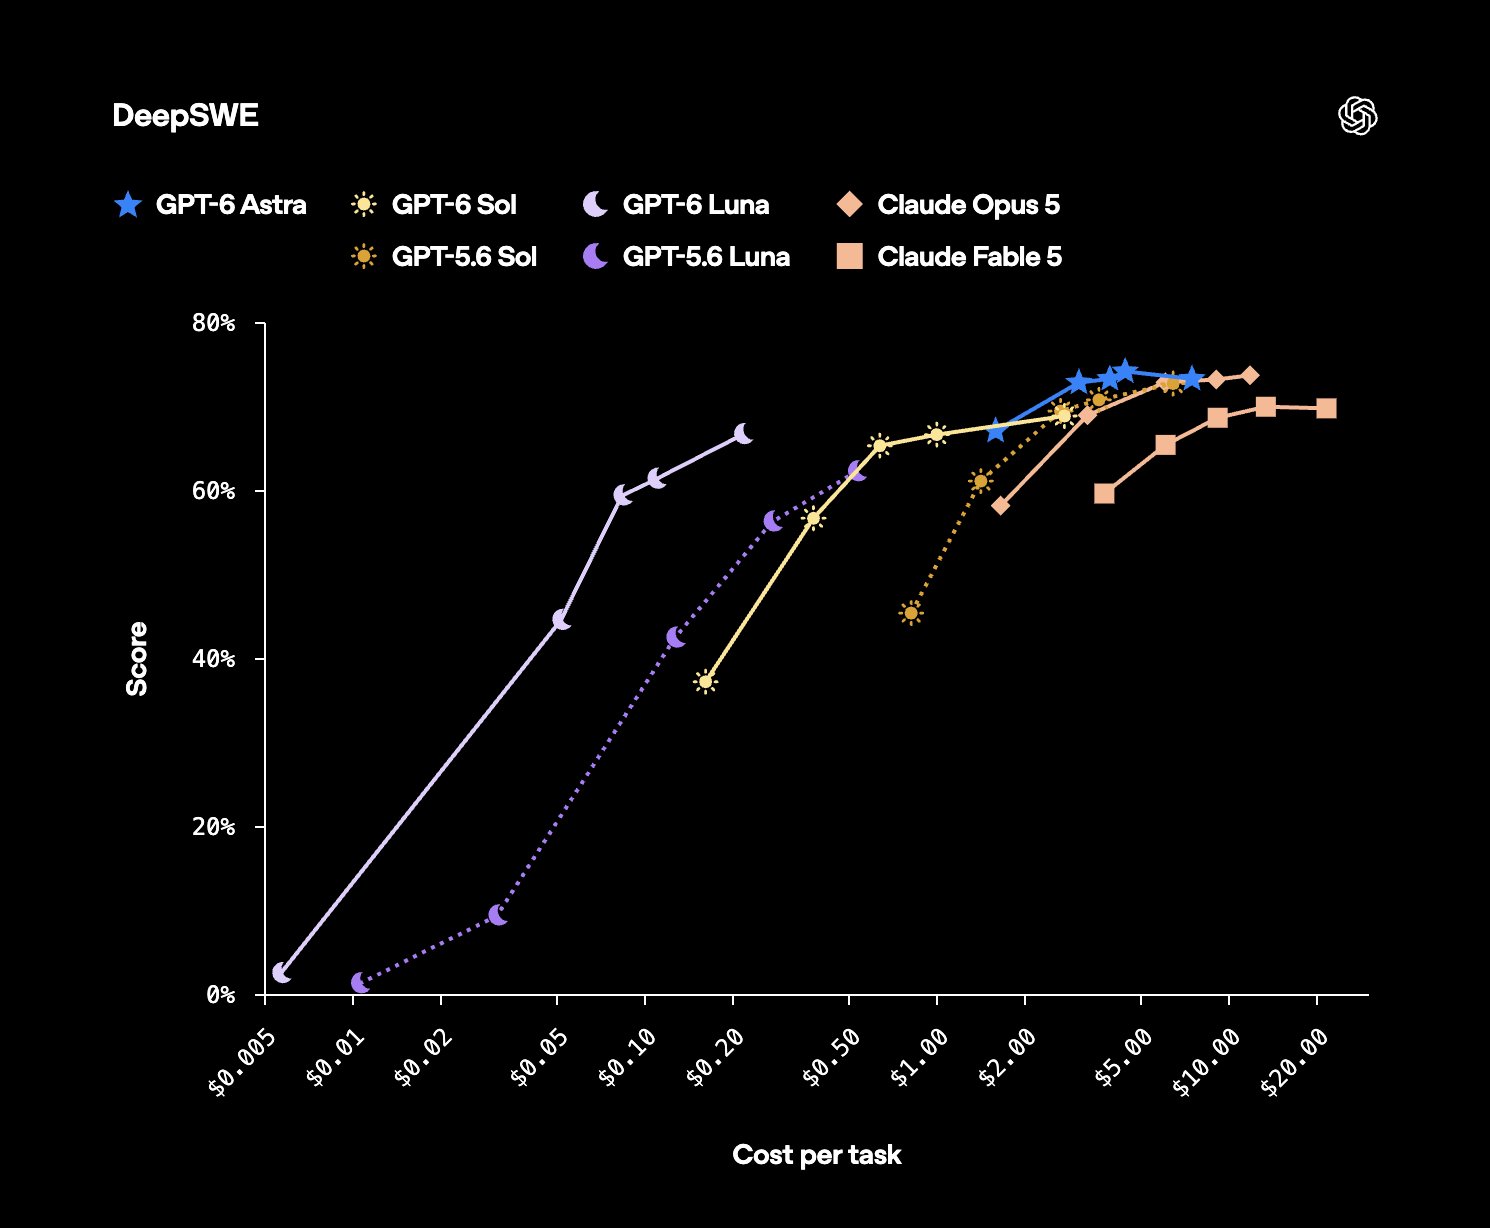
이번 발표에서 크게 달라진 쪽은 점수가 아니라 값입니다. 실제 오픈소스 버그를 고치게 시키는 시험인 DeepSWE에서 GPT-6 Sol은 가장 오래 생각하게 한 설정 기준 68.8%로, 경쟁 모델인 Claude Fable 5의 최고 기록 69.9%에 근소하게 못 미칩니다. 대신 Luna가 같은 시험에서 작업 한 건당 0.22달러로 66.6%를 냈습니다. 비슷한 점수대를 내던 기존 모델은 건당 몇 달러가 들었으니, 값을 기준으로 보면 자리가 크게 바뀐 셈입니다. 회사 설명으로는 매번 똑같이 들어가는 앞부분을 다시 계산하지 않고 재사용하는 방식도 개선돼, 재사용분 입력에는 90% 할인이 붙습니다.
인하 폭 50%는 GPT-5.6 세대에 걸려 있던 프로모션 가격과 비교한 값입니다. 회사가 내건 대표 비교는 컴퓨터를 직접 다루게 시키는 시험에서 Sol이 Claude Opus 5보다 높은 점수를 작업당 9% 비용으로 냈다는 것인데, 아직 외부에서 같은 조건으로 재현한 결과는 나오지 않았습니다.
그 밖에: Plus·Pro·Business 계정에는 사용 한도를 다시 채워 주는 '뱅크드 리셋'도 함께 들어갔습니다. 한도에 막혀 있던 사용자는 오늘 바로 체감합니다. 해커뉴스 토론에는 654점·댓글 372건이 붙었습니다.
시사점: 성능 경쟁이 값 경쟁으로 넘어가는 구간입니다. 같은 작업을 매일 많이 돌리는 쪽이라면 최고 점수 모델을 붙잡기보다, 싼 모델을 최대 설정으로 돌리는 조합을 먼저 재 보는 편이 낫습니다.
#GPT6 #가격인하 #Codex
출처 6🔥 @ChatGPT🔥 @CodexReleases🔥 @reach_vb🔥 @kimmonismus🔥 @angelbrodin💬 @reach_vb
3. Grok Bot이 Tesla 차량 안으로 들어갔다 — 메일·일정·주문을 목소리로 시킨다
- Tesla가 차 안 Grok에 Connectors(내가 쓰던 계정을 Grok에 연결하는 통로)를 열었습니다. 받은편지함 정리, 일정 정리, 이미 가진 파일·대화·할 일을 놓고 이야기하기를 운전대에서 손을 떼지 않고 시킬 수 있습니다.
- 앱을 따로 깔지 않습니다. 차 안 Grok 앱에서 + 버튼을 눌러 New Connector를 고르고 서비스에 한 번 로그인하면 끝이고, 부를 때는 "Hey Grok"이라고 말하거나 운전대의 마이크 버튼을 누릅니다.
- 다만 커피 주문이나 식당 예약처럼 여러 단계를 대신 밟는 일은 지금은 최상위 요금제인 SuperGrok Heavy 가입자에게만 열려 있습니다.
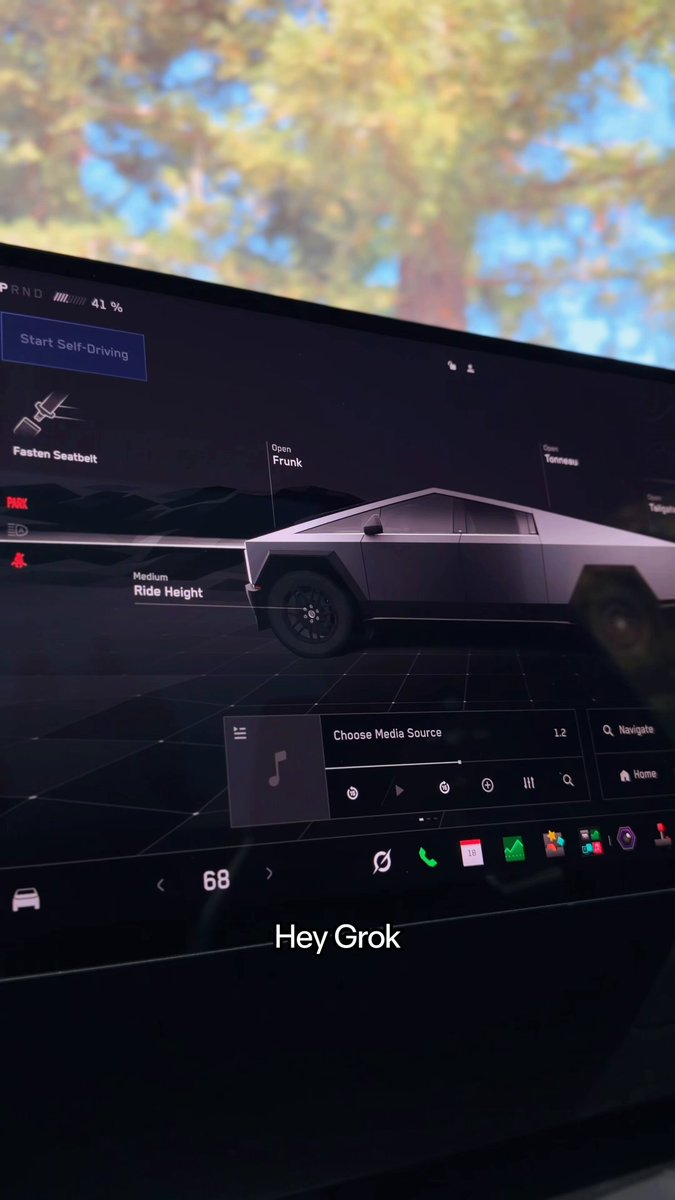
Tesla가 내놓은 것은 새 모델이 아니라 모델이 놓인 자리입니다. 그동안 차 안 AI는 길 안내나 음악처럼 차가 원래 하던 일을 말로 시키는 정도였는데, 이번에는 내 메일함과 일정표가 차에 직접 연결됩니다. 개인 비서 역할을 하는 AI가 앱이 아니라 기기 안에 상주하는 형태로 시판 차량에 들어간 셈입니다. 다만 어떤 메일·일정 서비스를 붙일 수 있는지, 배포 일정과 필요한 소프트웨어 버전이 무엇인지는 Tesla가 아직 밝히지 않았습니다.
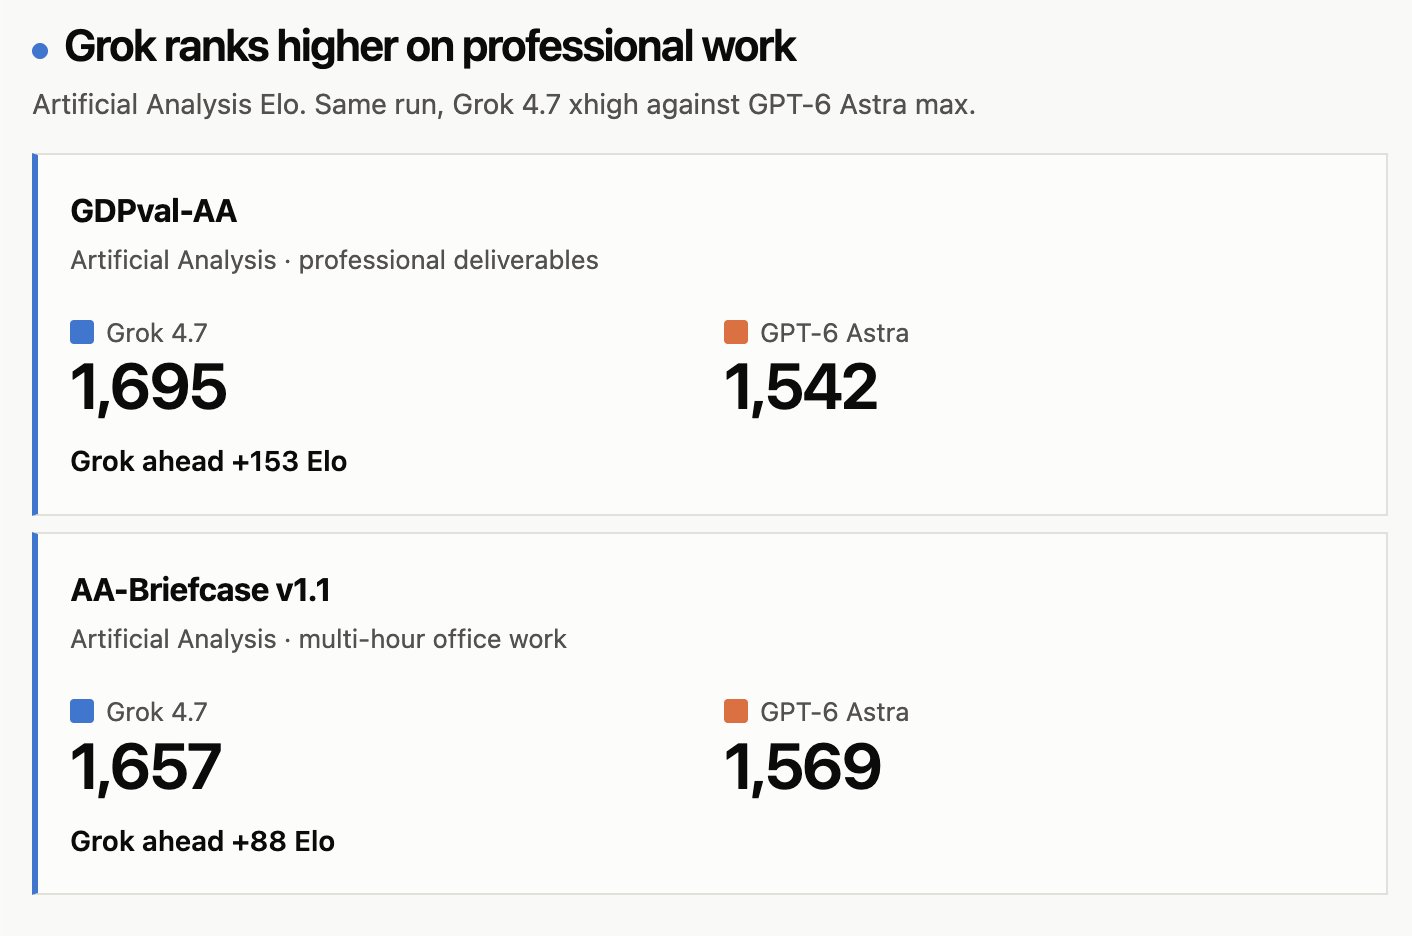
그 밖에: Artificial Analysis는 전문가가 실제로 만드는 산출물을 사람이 채점하는 시험 GDPval-AA에서 Grok 4.7이 1,695점으로 GPT-6 Astra(1,542점)를 앞섰다고 냈습니다. Grok 4.7 Fast는 Grok Build와 Cursor에서 쓸 수 있게 됐고, Grok Build도 1.0.41로 올라갔습니다.
시사점: 차는 사람이 매일 한참 갇혀 있으면서 손은 비는 드문 공간입니다. 그 자리에 내 계정이 연결된 비서가 들어앉았다는 것은, 에이전트 경쟁의 승부처가 점수표에서 어디에 미리 들어가 있느냐로 옮겨가고 있다는 신호입니다.
#Grok #Tesla #AI에이전트
출처 6🔥 @Tesla🔥 @SawyerMerritt🔥 @Polymarket🚀 @XFreeze🔥 @XFreeze🔥 @cb_doge
4. Pentagon 조사: 이란 미나브 학교 오폭에 AI 표적 시스템 과의존이 있었다
- Bloomberg 보도에 따르면, Pentagon(미국 국방부)의 내부 조사 보고서는 2026년 2월 개전 첫날 이란 남부 미나브의 초등학교가 Tomahawk 미사일에 맞아 무너진 사건의 원인으로 낡은 정보와 AI 표적 시스템 과의존을 함께 지목했습니다. 이 보도가 전한 사망자는 150명이 넘고, 그 가운데 어린이가 최소 123명입니다.
- 그 건물은 오래된 자료 탓에 혁명수비대 시설로 등록돼 있었고, 더 이상 군사 표적이 아니라는 정보는 표적 데이터베이스에 끝내 입력되지 않았습니다. 2018년 상업 위성사진에는 운동장 표시와 축구장이 찍혀 있었습니다.
- 표적을 걸러 내던 민간인 피해 완화 조직은 최근 몇 년 사이 인원이 약 90% 줄어 전체 20명 미만이 됐고, 중동을 맡는 Centcom의 담당 팀은 10명에서 1명으로 줄었습니다. 미나브 표적을 사전에 검토한 담당자는 없었습니다.
Maven Smart System은 Palantir의 소프트웨어를 쓰는 국방부의 표적 선정 시스템으로, 정찰 자료를 모아 공격 후보 목록을 만들어 줍니다. 미나브 건물은 다른 후보들과 함께 이 시스템에 들어갔고 개전 첫날 표적으로 추천돼 나왔습니다. 몇 시간 걸리던 표적 목록 작업이 몇 분으로 줄었고, 개전 24시간 동안 1,000곳 넘게 타격했습니다. 보고서는 일부 인원이 Maven이 낡은 기록이나 서로 어긋나는 정보를 알아서 표시해 줄 것으로 기대했다고 적으면서, 왜 그렇게 기대했는지는 분명하지 않다고 덧붙였습니다.
그 밖에: Palantir은 입력 데이터나 정보의 결함을 찾아낼 책임이 자사에 없으며 소프트웨어 잘못이라는 증거도 없다고 밝혔고, 유엔 조사단은 앞서 이 공격을 민간인을 향한 무차별 공격으로 규정했습니다. 해커뉴스에서 가장 많이 추천받은 댓글은 AI가 희생양이라며, 백악관이 표적 1,000개를 요구했고 검증 팀은 해체돼 상의조차 받지 못했으니 목록을 뽑은 도구가 AI든 단순 데이터베이스 조회든 결과는 같았으리라고 반박했습니다.
시사점: AI가 이 사슬에서 한 일은 판단이 아니라 속도였고, 목록이 몇 분 만에 나오는 동안 그 목록을 의심하던 사람들은 사라졌습니다. 업무에 AI를 넣을 때 따져야 할 것은 도구의 정확도만이 아니라, 그 도구가 빨라진 만큼 어떤 확인 절차가 조용히 없어졌는가입니다.
#AI안전 #군사AI #자동화
출처 2🔥 Bloomberg 조사 보도💬 해커뉴스 토론
5. Alibaba가 Apsara 콘퍼런스에서 Qwen4 제품군을 예고했다 — 다음 세대는 5~10조 파라미터를 목표로 한다
- Alibaba가 9월 22일 항저우에서 연 Apsara 콘퍼런스에서 Qwen4-Max·Qwen4-Flash·Qwen4-Plus·Qwen4-27B 네 이름을 처음 꺼냈습니다. 다만 Qwen4는 아직 훈련 중이고 출시일·가격·내려받을 가중치는 없습니다.
- Eddie Wu 최고경영자는 그다음 세대인 Qwen4.5와 Qwen5를 5조~10조 파라미터 규모로 키우겠다고 밝혔습니다.
- 파라미터(모델이 훈련하며 익히는 값의 개수, 크기를 가늠하는 눈금)가 2.4조인 현행 주력 Qwen3.8 Max의 2~4배입니다.
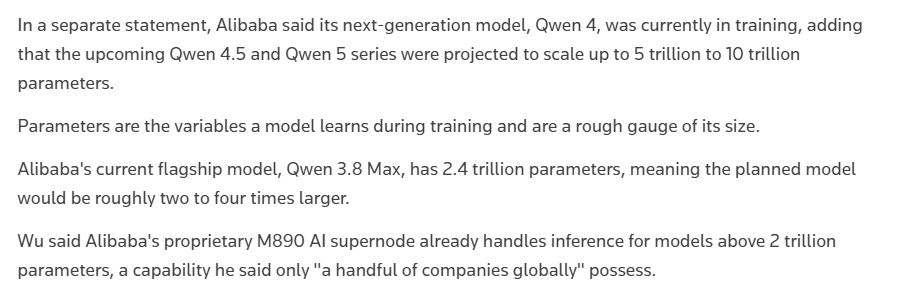
발표 직후 온라인에서는 "Qwen4가 10조"라는 식으로 숫자가 옮겨 붙었는데, 그 규모가 걸린 쪽은 Qwen4가 아니라 그 뒤 세대입니다. @ChrisGPT는 이 혼동을 짚으며 오늘 나온 것은 이름과 계획뿐이라고 정리했습니다. 그래서 오늘 확인할 수 있는 사실은 하나로 줄어듭니다. 중국 최대 클라우드 사업자가 앞으로 만들 모델의 크기를 숫자로 먼저 말해 두었다는 것입니다. 개발자 쪽 관심은 네 이름 가운데 가장 작은 27B에 쏠렸습니다. 유료 구독을 해지해도 될 만큼 쓸 만한 모델을 가중치째 달라는 요청이 공개 계정에서 이어졌습니다.
그 밖에: Alibaba는 같은 자리에서 한 클러스터에 최대 50만 장을 묶는 Zhenwu V900 칩과 2032년까지 전 세계 데이터센터 용량 20GW 초과 목표를 함께 내놨다고 밝혔습니다. 모델이 스스로 약점을 찾아 개선하고 있다는 설명도 나왔지만 이는 발표자 주장입니다.
시사점: 오늘 받을 수 있는 것은 없습니다. 지켜볼 지점은 오픈웨이트로 예고된 Qwen4-27B의 공개 시점으로, 개인 PC에서 돌리는 모델의 기준선이 여기서 다시 그어집니다.
#Qwen4 #Alibaba #오픈웨이트
출처 6🔥 @AiBattle_🔥 @ChrisGPT🔥 @choblin29🔥 @mark_k🔁 @Parul_Gautam7🔥 @superalesha
6. Unreal Agent가 오픈소스로 공개됐다 — 회사 측정 기준 Codex보다 39% 싼 비용
- Unreal Labs가 AI 코딩 에이전트를 감싸는 '하네스'(모델에게 도구·순서·검증을 물려 주는 겉옷)를 통째로 오픈소스로 열었습니다. 같은 모델을 써도 이 겉옷이 값을 정합니다.
- 회사가 공개한 Terminal-Bench 4.0(터미널에서 실제 작업을 끝까지 해내게 시키는 시험) 자체 측정에 따르면, GPT-6 Astra로 돌렸을 때 통과율은 Codex와 똑같은 57.9%인데 전체 비용은 $2,350에서 $1,428로 39% 내려갔다고 밝혔습니다.
- 코드는 누구나 가져다 고쳐 쓸 수 있는 MIT 라이선스로 GitHub에 올라왔고, 공개 하루 만에 별 566개가 붙었습니다.
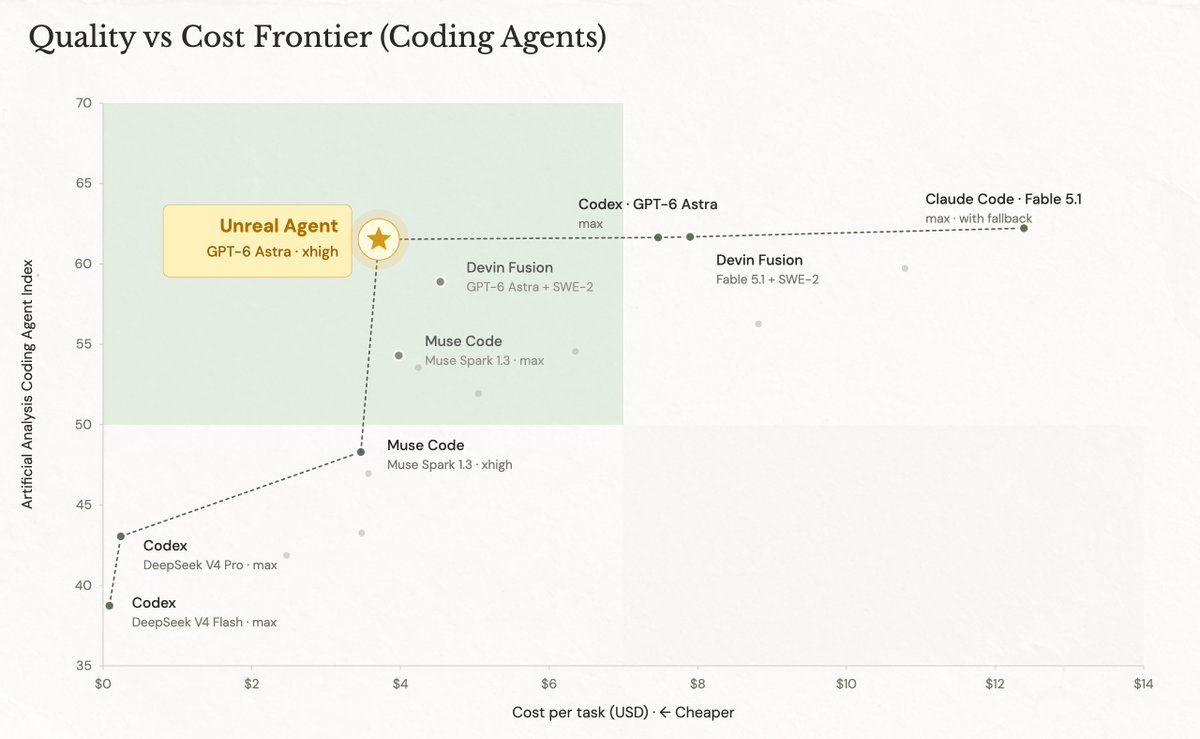
값이 내려간 이유는 도구를 쓰는 방식에 있습니다. 보통 에이전트는 명령 하나를 내리면 끝날 때까지 기다렸다가 다음 생각을 하는데, Unreal Agent는 그 일을 '진행 중'으로 적어 두고 다른 작업을 이어 가다가 결과가 도착하면 받아 씁니다. 기다리고 확인하는 데 쓰이던 토큰이 줄어드는 만큼 청구서도 줄어듭니다.
그 밖에: 회사는 코드 질의응답·버그 수정 등 다른 시험에서도 Codex 대비 최대 40% 싸다고 밝혔습니다. 위 Terminal-Bench 수치를 포함해 전부 회사 자체 측정이고, 외부 기관의 독립 검증은 아직 없습니다.
시사점: 에이전트 비용을 낮추는 손잡이가 모델 가격 말고 하나 더 생겼습니다. 다만 위 수치는 회사가 직접 잰 것이라, 모델을 그대로 두고 겉옷만 바꿔도 청구서가 달라진다는 이야기는 외부 검증 전까지는 참고 정도로 보는 게 안전합니다.
#오픈소스 #코딩에이전트 #비용효율
출처 2🔖 @unreallabsai🔥 @ChShersh
7. GPT-6 Astra가 2005년부터 안 풀리던 Enigma 전문 한 통을 풀었다
- 1941년 7월 10일 독일군이 보낸 Enigma(2차 대전 독일군 암호기) 전문 MVUEH는 2005년 공개 이후 21년간 아무도 풀지 못했습니다.
- Carter Leffer가 GPT-6 Astra에게 미해독 전문 목록만 건네자, 모델이 스스로 표적을 고르고 해독 도구를 직접 코딩해 82글자를 풀었습니다.
- 21년을 막은 원인도 함께 드러났습니다. 원본을 옮겨 적을 때 생긴 오타들과, 72번째 글자에서 일어난 드문 회전자 전환이었습니다.
검증한 사람은 Enigma 연구자 Frode Weierud입니다. 그가 운영하는 Crypto Cellar Research에 미해독 전문 목록이 공개돼 있는데, Leffer의 지시는 "이 중 풀 수 있는 게 있는지 보라"가 전부였습니다. 모델은 목록을 훑어 172번 MVUEH를 가장 유망한 표적으로 골랐고, 같은 날 보낸 173번 전문과 내용이 이어질 것이라 판단해 거기 반복해서 나오는 지명 'ROSENOW'를 실마리로 잡았습니다. 그다음 Python과 C++로 Enigma 시뮬레이터와 Bombe(2차 대전 때 실제로 쓰인 해독 기계)를 짜서 돌렸습니다. 답은 맞았습니다. 회전자 배열이 그날의 다른 전문(512)과 아예 다른 253이었고, 풀린 평문은 173번과 거의 같았습니다.
이 전문이 얼마나 완강했는지는 2017년 기록이 말해 줍니다. 그해 6월 Alex Shovkoplyas가 같은 날짜의 173번을 풀어 그날 쓰인 것과 다른 설정을 하나 찾아냈는데, 그 설정으로도 MVUEH는 열리지 않았습니다. 172번만 따로 회전자 배열까지 다른 설정으로 보내졌기 때문입니다. 두 전문의 내용이 거의 같은데 길이가 12글자 차이 나는 이유도 이번에 밝혀졌습니다. 보내는 쪽이 독일어 'Bitte'를 'Btte'로 잘못 쳐 넣었고, 173번에는 발신자 서명 'Waschbusch'가 한 번 더 들어 있었습니다.
그 밖에: 모델은 독일 연방기록보관소(Bundesarchiv)에 있는 관련 문서 번호까지 찾아냈습니다. Weierud는 자신이 몇 주를 들여 조사한 자료라고 적었습니다. 해커뉴스에서 456점·댓글 332개를 받았습니다.
시사점: 사람이 건넨 건 미해결 문제 목록 한 장이었고, 표적 선정부터 도구 제작과 검증까지를 모델이 이틀 만에 해냈습니다. '모델이 도구를 만들어 쓴다'는 말이 무슨 뜻인지 설명 없이 보여 준 사례입니다.
#Enigma #암호해독 #GPT6Astra
출처 2🔥 Crypto Cellar Research🔥 Hacker News
8. Deel이 사내 자동화 도구 Akai를 외부에 열었다 — 90일간 채용 없이 연간반복매출이 1억 4천만 달러 넘게 늘었다고 회사는 밝혔다
- 인사·급여 대행 회사 Deel이 재무·인사·지급·규제 대응의 반복 업무를 줄이려고 사내에서 만든 도구 Akai를 현지 시각 9월 21일 제품으로 내놨습니다.
- 회사는 Akai로 90일 동안 사람을 새로 뽑지 않고 연간반복매출이 1억 4천만 달러 이상 늘었다고 밝혔습니다. 해마다 되풀이해 들어오는 매출을 가리키는 말입니다.
- 같은 글에서 에이전트 8천 개 이상이 정규직 약 600명분의 일을 맡았고, 직원 1인당 매출이 13만 달러에서 21만 5천 달러로 올랐다고 했습니다.
쓰는 방법은 한 번 시연하는 것으로 끝납니다. 담당자가 평소 하던 일을 화면 녹화로 보여 주면 Akai가 화면과 설명하는 말, 그리고 그 클릭 뒤에서 오가는 서버 요청까지 함께 기록합니다. 그다음 사람이 규칙과 승인 절차를 정해 두면 에이전트가 같은 일을 스스로 반복합니다. 제품 소개에 따르면 정식 연결 통로가 있으면 그쪽을 먼저 쓰고, 없으면 연결기를 직접 만들며, 화면을 조작하는 방식은 마지막에 씁니다.
그 밖에: 소개 페이지는 지금까지 누적 100만 시간을 아꼈고 매달 25만 건을 자동으로 처리한다고 적고 있습니다. 밖에서는 화면을 흉내 내는 대신 브라우저가 주고받는 요청을 읽는 접근은 처음 본다는 반응도 나왔습니다. 다만 이 숫자는 전부 Deel 자체 집계이고, 바깥에서 검증한 자료는 없습니다.
시사점: 에이전트가 회사 손익을 얼마나 바꿨는지 숫자로 말한 사례는 아직 드뭅니다. 다만 파는 쪽이 내놓은 수치이니, 도입을 볼 때는 매출 총액보다 우리 팀이 매달 반복하는 일에 이 방식이 맞는지를 먼저 확인하는 편이 낫습니다.
#에이전트 #업무자동화 #Deel
출처 3💬 @Bouazizalex🔥 @EXM7777🔥 @wizaj
9. Xiaomi MiMo-V2.6-Pro가 외부 순위표에서 오픈웨이트 1위에 올랐다
- 모델을 독립적으로 재는 Artificial Analysis가 MiMo-V2.6-Pro를 종합 지능 지수 46점으로 집계해, 가중치를 내려받아 쓸 수 있는 모델(오픈웨이트) 중 1위로 올렸습니다. 어제 Grok 4.7이 받은 46과 같은 표입니다.
- 화면 만들기를 사람이 직접 비교하는 Design Arena의 Text-to-HTML 부문에서는 Elo(맞대결 승패로 매기는 점수) 1338로 전체 8위, 오픈웨이트 3위입니다. 직전 MiMo-V2.5-Pro보다 54점, 22계단 올랐습니다.
- 같은 표에서 Claude Opus 5가 1333, GLM-5.3이 1326, Grok 4.6이 1305입니다. 가중치는 MIT 라이선스로 Hugging Face에 올라와 있습니다.
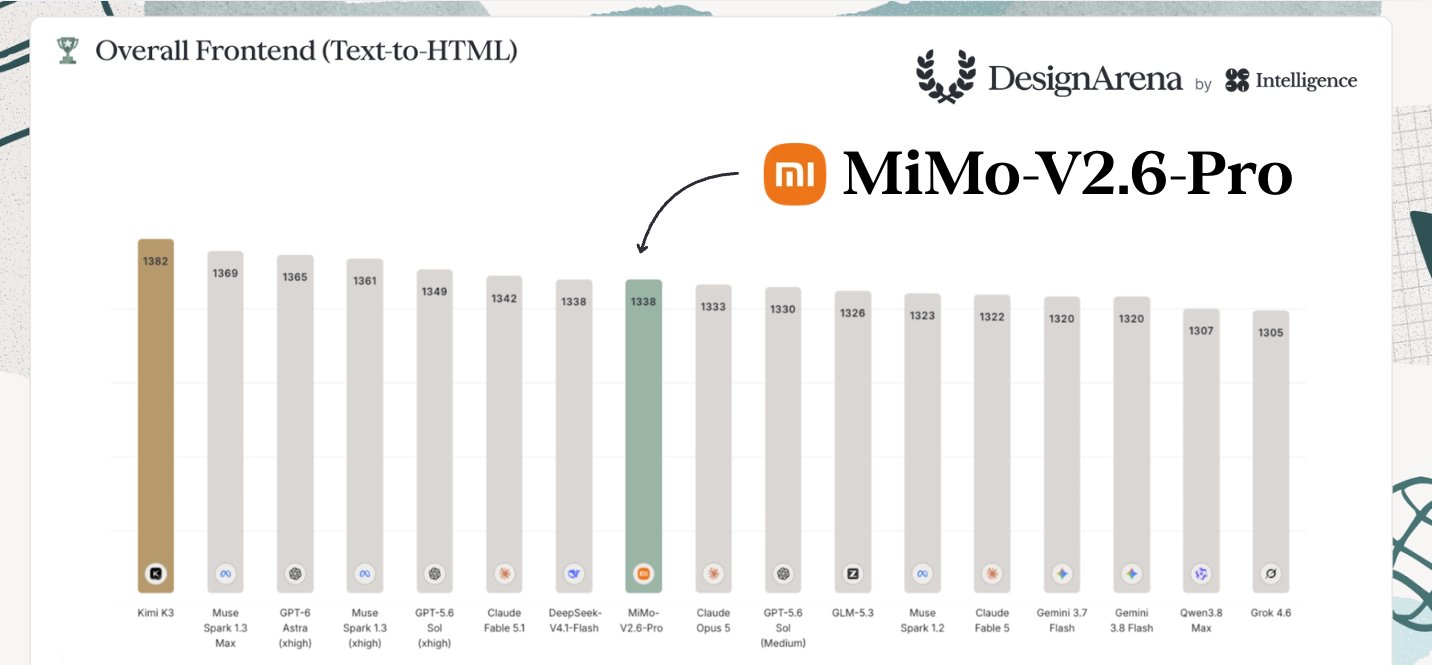
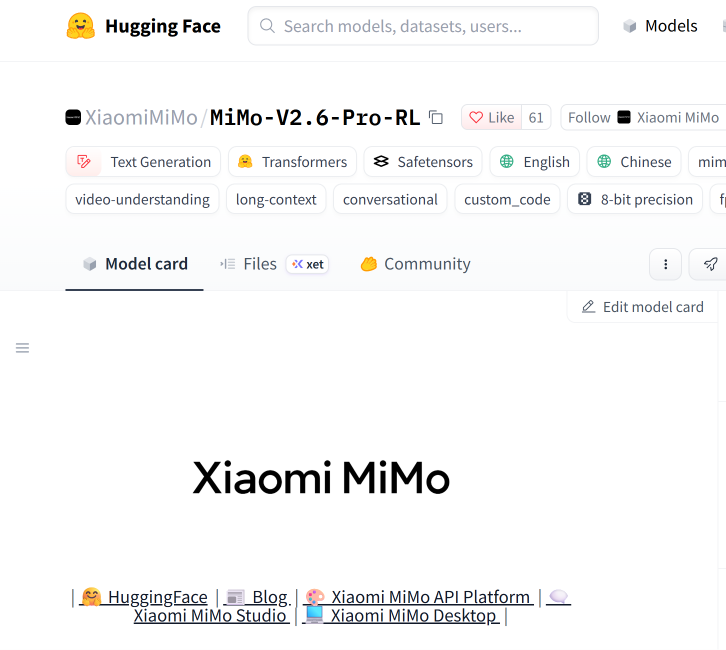
순위를 매긴 곳은 바깥이지만, 숫자를 전한 주체는 갈립니다. Artificial Analysis는 지수를 46으로 적었고, Xiaomi 공식 계정은 같은 순위를 46.32로 소개했습니다. Design Arena는 시험 점수가 아니라 사람이 두 결과물을 놓고 고른 결과인데, 그 표에서도 유료 최상위 모델들 사이에 자리를 잡았습니다.
그 밖에: 개발자 Daanish Khazi는 이 성적이 강화학습 과제 약 4만 5천 개와 중국 기준 260만 달러어치 계산 자원으로 나왔다고 정리했습니다.
시사점: 무료로 내려받는 모델과 돈을 내고 쓰는 최상위 모델의 거리가 순위표에서 몇 점 차이로 좁아졌습니다. 다만 Design Arena는 화면 만들기 한 부문이고 지수도 기관마다 다르니, 한 표의 순위를 전반적인 실력으로 옮겨 읽지는 마세요.
#오픈웨이트 #벤치마크 #Xiaomi
출처 4🔥 @XiaomiTech_💬 @DesignArena🔥 @itsPaulAi🔥 @bertgodel
10. 🆕 그 밖의 신기능·신제품
- StepFun이 새 주력 모델 Step 5 Preview를 내놨습니다. 외부 평가기관 Artificial Analysis의 종합 지능 점수는 44점으로 Kimi K3(max)와 같은데, 한 작업을 푸는 데 드는 비용은 약 2.8배 낮습니다.
- Tim Dettmers 팀이 bitsandbytes2 비공개 베타를 시작했습니다. 모델을 돌리는 중에 압축해 큰 모델을 작은 기기에 올리는 도구입니다.
- Snorkel AI가 35억 달러 가치를 인정받으며 3억 5천만 달러 시리즈 E(후속 투자 라운드)를 받았습니다.
StepFun의 44점은 Artificial Analysis가 잰 외부 측정값입니다. 다만 에이전트 평가(모델이 도구를 써서 일을 스스로 끝내는지 보는 시험)에서는 같은 급 모델들에 뒤처진다고 적었습니다. Snorkel AI는 AI 학습용 데이터를 만들어 파는 회사로, 소프트웨어 판매에서 데이터 납품으로 방향을 바꾼 뒤 연환산 매출 3억 7,500만 달러를 넘겼다고 밝혔습니다.
그 밖에: Alibaba Cloud가 DHH가 발표한 Omacom Foundation에 창립 후원사로 300만 달러를 넣고, 새로 발표된 Qwen Book에 리눅스 환경 Omarchy를 올리기로 했습니다. NVIDIA는 AI 데이터센터용 전력·냉각 장비 인증 제도 'DSX Ready'를 열고 Tesla Megapack을 배터리 저장장치 첫 통과 목록에 넣었습니다.
시사점: 같은 점수를 더 싸게 내는 모델과, 큰 모델을 작은 기기에 밀어 넣는 압축이 나란히 나왔습니다. 모델을 고를 때 점수만이 아니라 한 작업에 드는 비용을 함께 보게 됩니다.
#StepFun #모델압축 #AI데이터
출처 5🔥 @ArtificialAnlys💬 @Tim_Dettmers💬 @ajratner🔥 @dhh🔥 @SawyerMerritt
오늘의 감정·온도
오늘의 실무 팁 — 쉽게 풀어 쓴 사용법 6가지
1. 회사 클라우드 계정이 있다면 새 계약 없이 Opus 5.5를 고를 수 있다
Claude Opus 5.5는 Anthropic 앱·API 말고 Amazon Web Services·Google Cloud·Microsoft Azure에서도 바로 쓸 수 있습니다. 회사 계정이 그중 하나에 이미 있다면 모델 목록에서 바꾸기만 하면 됩니다.
2. '뱅크드 리셋'은 급한 날을 위해 아껴 둔다
한도가 풀리는 기회를 한 번 모아 뒀다가 원하는 때 쓰는 기능이 Claude와 ChatGPT 양쪽에 같은 날 들어왔습니다. 평소에 쓰지 말고 마감이 걸린 날 꺼내는 쪽이 이득입니다.
3. 같은 문서를 반복해 묻는다면 캐시 읽기 값부터 본다
한 번 넣은 자료를 다시 넣을 때 매겨지는 값이 Opus 5.5에서 100만 토큰당 $0.50에서 $0.20으로 내려갔습니다. 긴 자료를 앞에 붙여 두고 질문만 바꿔 가며 묻는 방식이 이전보다 훨씬 싸졌습니다.
4. 최고 점수 모델 대신 '싼 모델 최대 설정'을 먼저 재 본다
GPT-6 Luna는 DeepSWE 시험에서 작업 한 건당 0.22달러로 66.6%를 냈습니다. 비슷한 점수대를 내던 모델이 건당 몇 달러였으니, 같은 작업을 많이 돌리는 쪽은 이 조합부터 비교해 볼 만합니다.
5. 순위표 하나로 모델을 고르지 않는다 — (@kunchenguid)
Grok 4.7을 하루 종일 써 본 개발자는 공개 벤치마크 하나만 인용한 혹평도, 3D 게임을 만들게 시킨 비교도 실제 업무와는 무관하다고 적었습니다. 자기 업무와 닮은 과제 서너 개를 직접 돌려 보는 것이 여전히 가장 빠른 판단법입니다.
6. 내려받아 쓸 모델이 필요하면 MiMo-V2.6-Pro를 먼저 본다
가중치가 MIT 라이선스로 Hugging Face에 올라와 있어 회사 업무에도 쓸 수 있습니다. 모델 페이지의 Files 탭에서 파일을 바로 받을 수 있습니다.
📦 확인 방식
이 리포트의 수치는 각 회사의 공식 발표 글과 Artificial Analysis·Vals AI·Design Arena 같은 외부 측정 기관이 공개한 표에서 가져왔습니다. Unreal Agent의 39%와 Deel의 매출·인력 수치는 발표한 회사가 스스로 잰 값으로, 외부 독립 검증 전입니다.
🏷 라벨 가이드 — 🔥 화제 · 🔖 저장 많음 · 🔁 확산형 · 💬 토론형 · 🚀 작은 계정에서 퍼진 글