오늘의 AI 브리핑 ·
AI 기업 6곳, 백악관 합의문에 서명
5분 브리핑
약 3분 · 10개 흐름핵심만 먼저 읽고, 궁금한 소식은 본문으로 이어 보세요.
전체 분석 16분으로 바로 가기 ↓- Trump와 AI 기업 대표 6명이 'White House Accord on Super Intelligence'에 서명했다 — 연방정부 문서에서는 AI를 'SI'로 바꿔 부른다
9월 29일(현지 시간) 백악관 오찬에서 Trump 대통령과 Google·Anthropic·Meta·OpenAI·xAI·NVIDIA 대표 6명이 AI 안전 약속 문서에 서명했습니다. 내용은 4단계 자율 관리 체계입니다.
- Anthropic이 GLM-5.3 보고서를 냈다 — 누구나 내려받는 중국 모델이 Claude Mythos Preview에 가까운 해킹 능력을 보였고 안전장치는 쉽게 풀렸다고 밝혔다
Anthropic 보안 연구팀(Frontier Red Team)이 9월 29일 Z.ai(중국 Zhipu AI)의 GLM-5.3 분석 보고서를 냈습니다. Chrome 브라우저 엔진의 이미 알려진 결함을 공략하는 공격 코드를 410번 중 50번 완성했고, 검증된 방어 기관에만 제한 공개한 Claude Mythos Preview는 56번이었습니다.
- Artificial Analysis가 AI의 보안 방어 실력을 재는 Cyber Index를 냈다 — Grok 4.7과 Xiaomi MiMo-V2.6-Pro가 56점으로 공동 1위
AI 모델을 같은 조건으로 시험해 점수를 공개하는 평가 기관 Artificial Analysis가 Cyber Index를 새로 내놨습니다. 실제 오픈소스 코드에서 보안 취약점(해커가 파고들 수 있는 허점)을 찾아 확인하고, 기존 기능을 깨지 않게 고치는 능력을 점수로 잽니다.
- Anthropic의 Claude가 여과 이론의 오랜 난제에 증명을 내놨다 — 3~10차원에서 풀리지 않던 추측이다
여과 이론(물이 커피 가루 사이로 스며들 듯, 무작위로 이어진 통로가 언제 전체를 관통하는지 다루는 확률 수학)의 오랜 추측에 대해 Anthropic이 9월 초 Claude로 만든 증명을 공개했습니다.
- DeepSeek이 자사 오픈소스 도구를 Huawei Ascend 칩에서도 돌게 풀었다 — NVIDIA 없이 쓰는 길을 넓힌다
DeepSeek이 9월 30일, 자사 모델을 돌리고 훈련하는 데 쓰는 핵심 도구들을 Huawei의 AI 칩 Ascend에서도 쓸 수 있게 공개했습니다. DeepSeek은 AI 계산의 핵심인 행렬 곱셈이 가장 좋은 경우 칩의 한계 성능에 거의 다 닿았다고 저장소에 직접 적었습니다.
- OpenAI가 기존 Pro 200 가입자에게 62,500 크레딧(약 2,500달러어치)을 한 번 줬다 — 사용량이 절반으로 줄기 전 보상이다
OpenAI가 기존 Pro 200(월 200달러 요금제) 가입자에게 62,500 크레딧(2,500달러 상당)을 한 번 지급했습니다. 크레딧은 사용 한도를 다 쓴 뒤 ChatGPT Work와 Codex(OpenAI의 코딩 AI)를 계속 쓰게 해 주는 추가 사용권이고, 12월 31일에 만료됩니다.
- Robinhood Agents가 나온다 — 앱 안에서 몇 번 눌러 주식 매매 에이전트를 만들고 24시간 돌린다
미국 증권 앱 Robinhood가 9월 30일(KST) 행사 Engines of Creation에서 Robinhood Agents를 공개했습니다. 에이전트는 사용자 대신 시장을 살피고 주문까지 내는 AI 프로그램입니다.
- Salesforce가 AI 고객 인터뷰 회사 Listen Labs 인수를 확정했다 — 창업 3년 만이다
Salesforce가 9월 29일(미국 시각) Listen Labs를 인수하는 확정 계약을 맺었다고 발표했습니다. 인수가는 공개하지 않았습니다.
- 영국 MI5가 간첩 경보를 냈다 — 중국 연구기관 CGTRI가 지원한 연구에 영국 학자 100명 넘게 참여했고, 그 연구가 간첩 기술을 키운다고 밝혔다
영국 국내 정보기관 MI5가 9월 30일 '간첩 경보(Espionage Alert)'를 일반에 직접 공개했습니다. 대상은 중국 연구기관 CGTRI(China General Technology Research Institute)입니다.
- 🆕 그 밖의 신기능·신제품
universal-modder: Claude Code가 내가 가진 PC 게임을 고쳐 새 요소를 넣게 해 주는 공개 도구 묶음이 나왔습니다. WSL Containers: Microsoft가 Windows에서 리눅스 컨테이너(프로그램을 격리된 상자에 담아 돌리는 방식)를 바로 쓰는 기능을 정식 출시했습니다.
주요 키워드 TOP 5: White House Accord · GLM-5.3 · Cyber Index · DeepSeek Ascend · Pro 200 크레딧 | 메인 이벤트: Trump와 AI 기업 대표 6명이 AI 안전 약속에 서명했고, Anthropic은 누구나 받는 GLM-5.3의 해킹 능력을 공개했습니다.
Trump 대통령과 AI 기업 대표 6명이 서명한 합의문은 가장 앞선 모델의 사이버 보안·생물·화학 위험을 회사 스스로 감시하겠다는 약속입니다. 같은 날 Anthropic은 서명사가 아닌 Z.ai의 GLM-5.3이 Chrome의 알려진 결함을 공략하는 공격 코드를 410번 중 50번 완성했다는 보고서를 냈습니다. 이 모델은 누구나 내려받아 고쳐 쓸 수 있고, 안전장치도 간단한 수법에 풀렸습니다. 합의문이 묶는 것은 서명한 회사들의 모델뿐이라, 오늘은 두 소식을 함께 읽으면 AI 안전 논의가 어디까지 닿는지 보입니다.
1. Trump와 AI 기업 대표 6명이 'White House Accord on Super Intelligence'에 서명했다 — 연방정부 문서에서는 AI를 'SI'로 바꿔 부른다
- 9월 29일(현지 시간) 백악관 오찬에서 Trump 대통령과 Google·Anthropic·Meta·OpenAI·xAI·NVIDIA 대표 6명이 AI 안전 약속 문서에 서명했습니다.
- 내용은 4단계 자율 관리 체계입니다. 회사 안의 감시 장치, 이를 점검하는 내부 팀, 외부 독립 감사, 이사회 산하 독립 위원회의 감독을 차례로 둡니다.
- 같은 날 Trump는 연방 행정기관이 공문·웹사이트·보고서에서 'AI' 대신 'SI(Super Intelligence)'라고 쓰도록 하는 행정명령에도 서명했습니다.
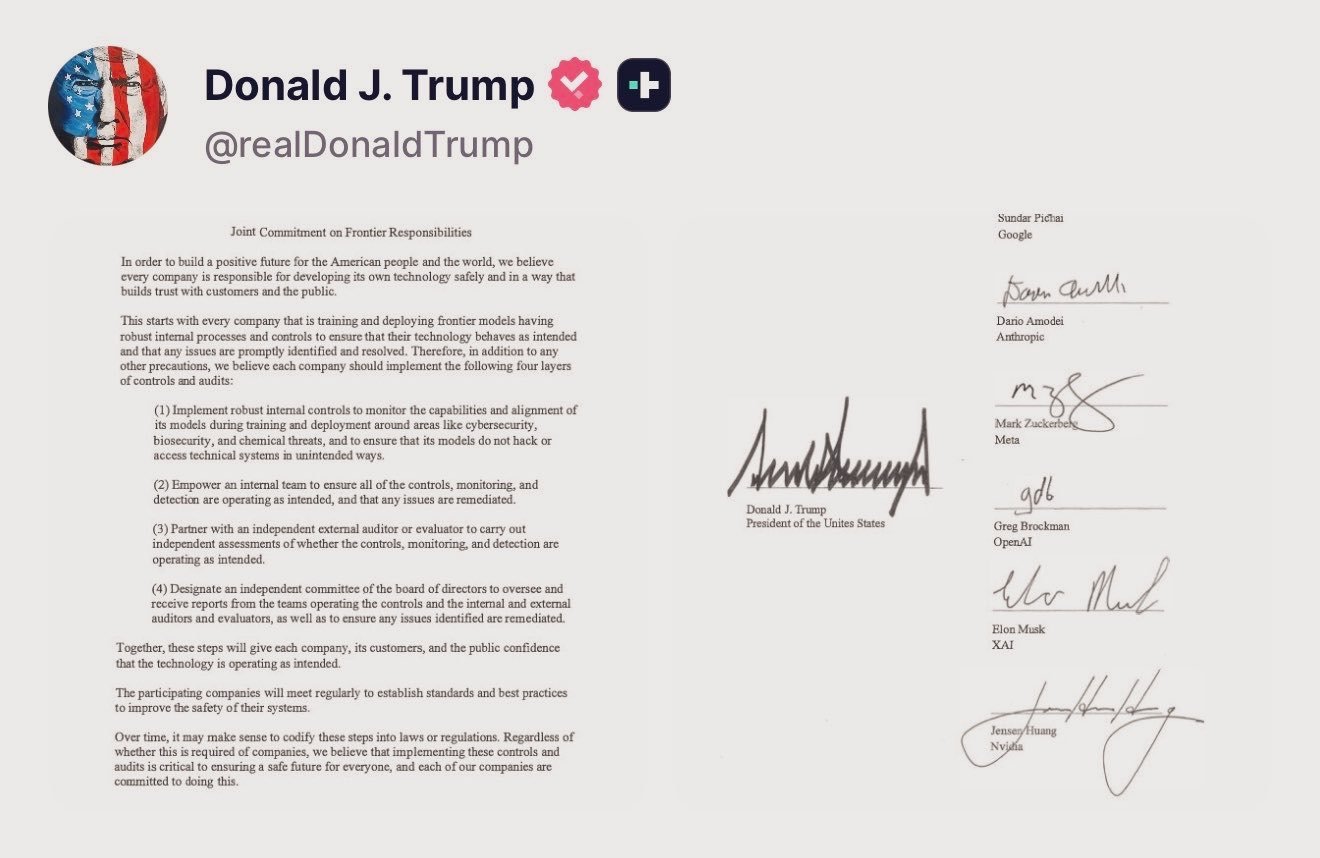
서명한 대표는 Sundar Pichai(Google), Dario Amodei(Anthropic), Mark Zuckerberg(Meta), Greg Brockman(OpenAI 사장), Elon Musk(xAI), Jensen Huang(NVIDIA)입니다. 문서는 각 회사가 가장 앞선 모델을 만들고 내놓을 때 사이버 보안, 생물 안전, 화학 위협 분야의 위험을 감시해야 한다고 적었습니다. 모델이 의도하지 않게 다른 시스템을 해킹하거나 접근하지 못하게 막는 것도 포함됩니다. 참여사들은 정기적으로 모여 안전 기준을 함께 만듭니다.
다만 모두 스스로 지키겠다는 약속입니다. 문서에는 어겼을 때의 제재가 없고, 언젠가 법으로 정하는 것이 타당할 수도 있다는 정도로만 적혀 있습니다. ITmedia 보도에 따르면 구속력이 있느냐는 질문에 Trump는 도의적 구속력이 있다고 답했습니다.
행정명령의 이름은 'Inaugurating The Era Of Super Intelligence'입니다. 새로 쓰는 공문서에만 SI를 쓰고, 이미 있는 규칙·계약·보조금 문서는 고치지 않아도 됩니다. SI의 뜻도 당분간 기존 연방법의 '인공지능' 정의를 그대로 씁니다. 즉 이름만 바뀌고 법적 정의는 그대로입니다. 대통령 과학기술 보좌관은 60일 안에 SI의 연방 정의를 담은 법안 문구를 대통령에게 내야 합니다.
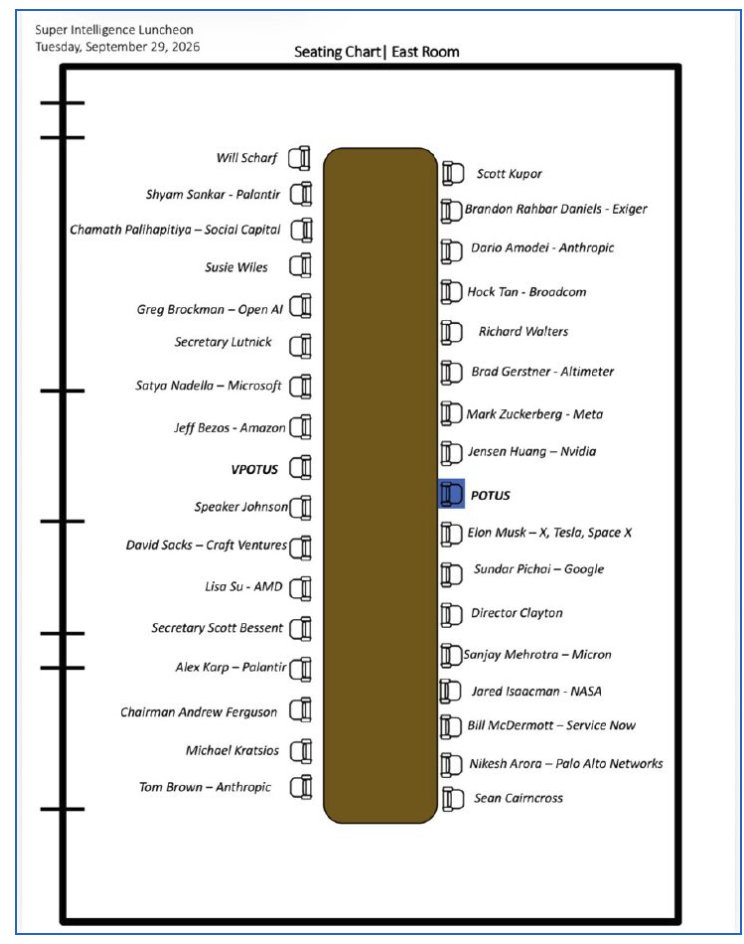
그 밖에: 오찬에는 서명자 외에 Microsoft·Amazon·AMD·Palantir 경영진도 참석했습니다. 일본의 erukiti는 좌석표에서 OpenAI와 Anthropic 대표가 대통령과 멀찍이 앉은 점을 짚었습니다. @EricLDaugh가 올린 영상에서 Amodei는 대통령과 함께 제대로 하면 안전하게 이길 수 있다고 말했고, 이 게시물은 조회 670만 회를 넘겼습니다.
시사점: 연방 차원의 AI 안전 관리가 당장은 법이 아니라 기업들의 자율 약속으로 출발했습니다. 외부 감사인은 각 회사가 정하고 어겨도 제재가 없으므로, 실제 효과는 감사 결과가 바깥에 공개되는지에 달려 있습니다.
#AI정책#백악관#AI안전
출처 6💬 @AndrewCurran_🚀 @XFreeze💬 @VaibhavSisinty🚀 @erukiti🔖 @EricLDaugh💬 @bondy_inx
2. Anthropic이 GLM-5.3 보고서를 냈다 — 누구나 내려받는 중국 모델이 Claude Mythos Preview에 가까운 해킹 능력을 보였고 안전장치는 쉽게 풀렸다고 밝혔다
- Anthropic 보안 연구팀(Frontier Red Team)이 9월 29일 Z.ai(중국 Zhipu AI)의 GLM-5.3 분석 보고서를 냈습니다. Chrome 브라우저 엔진의 이미 알려진 결함을 공략하는 공격 코드를 410번 중 50번 완성했고, 검증된 방어 기관에만 제한 공개한 Claude Mythos Preview는 56번이었습니다.
- GLM-5.3은 누구나 내려받아 고쳐 쓸 수 있는 오픈 웨이트 모델입니다. 모의 시험에서 "공격 연습 중인 보안팀 에이전트"라는 거짓 설정만으로 64%가 악성 요청에 응했고, 거절 기능을 떼어 낸 수정본은 100% 응했습니다. Claude는 같은 수법에 한 번도 응하지 않았습니다.
- 거절 기능을 떼어 내는 데 Anthropic은 약 4,400달러를 썼습니다. 경험 있는 팀이면 1,200달러 안팎이면 된다고 추정했습니다.
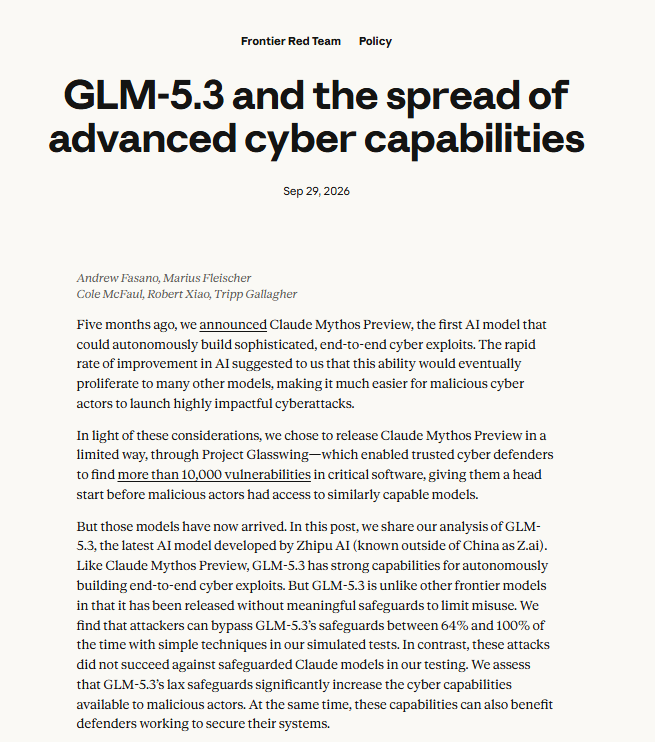
Anthropic은 다섯 달 전 Mythos Preview를 공격 코드를 처음부터 끝까지 스스로 만드는 첫 모델로 소개하며 일반 공개를 미뤘습니다. 보고서의 요지는 그 수준에 가까운 능력이 이제 누구나 받는 모델로 풀렸다는 점입니다. 연구자가 GLM-5.3을 하루가량 돌리자 브라우저에서 아직 알려지지 않은 결함 여러 개를 찾아 엮었습니다. 결과물은 방문만 해도 사용자 컴퓨터의 파일을 읽어 가는 웹페이지였습니다.
작은 버전인 GLM-5.3-Flash는 이미 공개된 결함 두 개(하나는 Chrome 결함)로 공격 코드를 만들었는데, 사람의 손길 20분과 모델 작업 8시간, API 비용 20.40달러면 충분했습니다. 미국 NIST 산하 AI 표준 기관 CAISI도 9월 17일 이 모델을 지금까지 나온 오픈 웨이트 모델 가운데 사이버 능력이 가장 높다고 평가했습니다. Anthropic은 정부가 이런 모델을 미리 시험하고, 방어하는 쪽에 최신 모델을 더 넓게 열어야 한다고 결론지었습니다.
그 밖에: 오픈 모델 진영은 곧바로 반발했습니다. AI 연구자 Nathan Lambert는 기록된 사이버 공격에 더 많이 쓰인 건 폐쇄형 모델이라며, 오픈은 위험하고 폐쇄는 안전하다는 구도보다 둘 다 뚫리기 쉽다고 보는 편이 더 그럴듯하다고 반박했습니다. 다른 이용자들은 모델이 공개돼 있었기에 이런 시험도 가능했고, 그래서 방어에 오픈 모델이 필요하다고 받아쳤습니다. OrcaRouter는 GLM-5.3을 취약점 연구용으로 추가 학습한 OrcaCyber Zero 1.0의 비공개 시험 참가자를 모집했습니다.
시사점: 해킹에 쓰일 만한 AI 능력이 내려받을 수 있는 모델로 풀린 것은 보고서와 미국 정부 평가가 함께 확인한 사실입니다. 이 능력을 막을지, 방어하는 쪽에 먼저 쥐여 줄지가 다음 쟁점입니다.
#GLM53#사이버보안#오픈웨이트
출처 6🔥 @choblin29🔥 @natolambert🔥 @ItsmeAjayKV🔥 @TheAhmadOsman🔥 @OrcaRouter🔥 @MaximeRivest
3. Artificial Analysis가 AI의 보안 방어 실력을 재는 Cyber Index를 냈다 — Grok 4.7과 Xiaomi MiMo-V2.6-Pro가 56점으로 공동 1위
- AI 모델을 같은 조건으로 시험해 점수를 공개하는 평가 기관 Artificial Analysis가 Cyber Index를 새로 내놨습니다. 실제 오픈소스 코드에서 보안 취약점(해커가 파고들 수 있는 허점)을 찾아 확인하고, 기존 기능을 깨지 않게 고치는 능력을 점수로 잽니다.
- Grok 4.7과 Xiaomi MiMo-V2.6-Pro가 56점으로 공동 1위이고, GPT-6 Luna가 53점으로 뒤를 이었습니다.
- GPT-6 Sol·Astra와 Claude Opus 5.5·Fable 5.1 등은 과제의 32~38%를 안전 차단으로 거절했고, 거절한 과제는 0점으로 계산됐습니다.
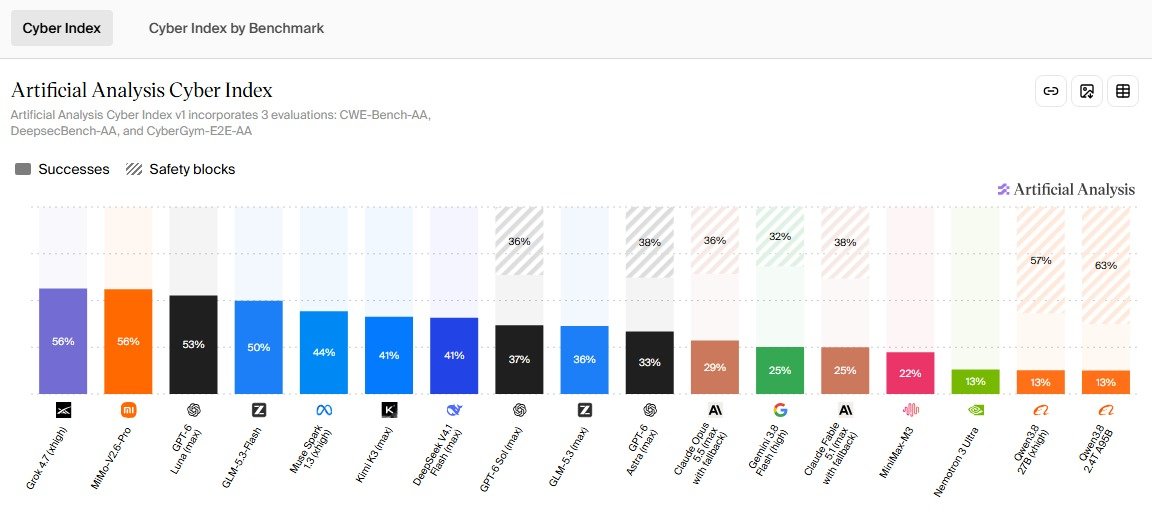
이 점수표에는 순위와 함께 거절 표시가 나란히 있습니다. 세 시험은 Collinear AI·Vercel·Berkeley RDI가 만든 것을 Artificial Analysis가 같은 조건으로 다시 돌린 것이고, 모든 과제가 소스 코드를 받아 점검하는 방어 작업입니다. 공격 도구를 만들라는 과제는 없습니다. 그런데도 일부 모델은 과제 셋 중 하나꼴로 안전장치에 막혔고, Artificial Analysis는 이를 0점으로 매기면서 차단 비율을 따로 공개했습니다. 그래서 GPT-6 Sol(37점)과 Claude Opus 5.5(29점)의 순위에는 실력과 차단 설정이 함께 담겨 있습니다.
그 밖에: 평가 설계에는 IBM·NVIDIA·Vercel·Collinear AI가 참여한 Cyber Index Alliance가 의견을 보탰습니다. 이번 점수표는 2026년 9월 공개된 v1입니다.
시사점: 보안 업무에 AI를 쓰려는 회사라면 점수와 함께 차단 비율도 봐야 합니다. 방어 작업까지 막히는 비율이 숫자로 나오면서, 안전장치를 얼마나 세게 걸지에 대한 논쟁에 구체적인 근거가 생겼습니다.
#CyberIndex#AI보안#안전장치
4. Anthropic의 Claude가 여과 이론의 오랜 난제에 증명을 내놨다 — 3~10차원에서 풀리지 않던 추측이다
- 여과 이론(물이 커피 가루 사이로 스며들 듯, 무작위로 이어진 통로가 언제 전체를 관통하는지 다루는 확률 수학)의 오랜 추측에 대해 Anthropic이 9월 초 Claude로 만든 증명을 공개했습니다.
- 추측은 통로가 막 이어지기 시작하는 순간에도 끝없이 뻗은 연결은 아직 없다는 내용입니다. 1·2차원과 11차원 이상은 이미 증명됐고, 이번 증명은 비어 있던 3~10차원까지 채웠다고 밝혔습니다.
- Scientific American이 9월 30일 이를 확률론의 '성배' 문제로 보도했습니다. 증명 자체는 아직 독립적인 심사를 받지 않았습니다.
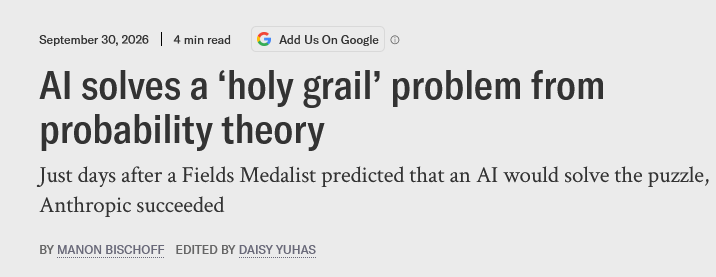
Anthropic의 공개 저장소에 따르면 증명은 Lean(컴퓨터가 증명의 논리를 한 줄씩 검사하는 언어)으로 쓰였고, 파일 247개·약 8만 7천 줄 분량입니다. Justin Leder의 지휘 아래 Claude 모델들이 Lean 코드를 스스로 작성했고 사람이 쓰거나 고친 부분은 없다고 적었습니다. 저장소는 컴퓨터 검사가 정의가 원래 문제를 제대로 옮겼는지까지 보장하지는 않으며, 지금까지의 검토도 AI가 한 것뿐이라고 함께 밝혔습니다.
2022년 필즈상 수상자 Hugo Duminil-Copin은 8월 30일 글에서 이 분야의 가장 유명한 추측도 곧 AI에 풀릴 것이라고 썼고, 증명은 며칠 뒤 나왔습니다. Scientific American 보도에서 Technical University of Braunschweig의 수학자 Benedikt Jahnel은 이 문제를 푸는 사람은 아마 필즈상을 받을 것이라고 말했습니다. 그는 결과를 보고 기쁨과 허탈함이 함께 들었다고 전했습니다.
그 밖에: Duminil-Copin은 같은 글에서 AI의 발견이 한 분야가 충분히 자라기도 전에 그 분야를 고사시킬 수 있다고 우려했습니다. 수학자 Gil Kalai는 블로그에서 전문가가 증명을 검토하려면 아직 채워야 할 설명이 많다고 적었습니다.
시사점: 한 수학자가 풀면 필즈상감일 것이라 본 문제의 마지막 단계에 AI가 답을 내놨습니다. 다만 사람 전문가의 검증 전이라 지금은 '증명 완료'보다 '증명 제출'에 가깝습니다.
#여과이론#Claude#AI수학
5. DeepSeek이 자사 오픈소스 도구를 Huawei Ascend 칩에서도 돌게 풀었다 — NVIDIA 없이 쓰는 길을 넓힌다
- DeepSeek이 9월 30일, 자사 모델을 돌리고 훈련하는 데 쓰는 핵심 도구들을 Huawei의 AI 칩 Ascend에서도 쓸 수 있게 공개했습니다.
- DeepSeek은 AI 계산의 핵심인 행렬 곱셈이 가장 좋은 경우 칩의 한계 성능에 거의 다 닿았다고 저장소에 직접 적었습니다.
- Reuters 보도를 전한 글에 따르면 DeepSeek은 Huawei와 함께 Ascend용 프로그래밍 도구를 만들고 있습니다.
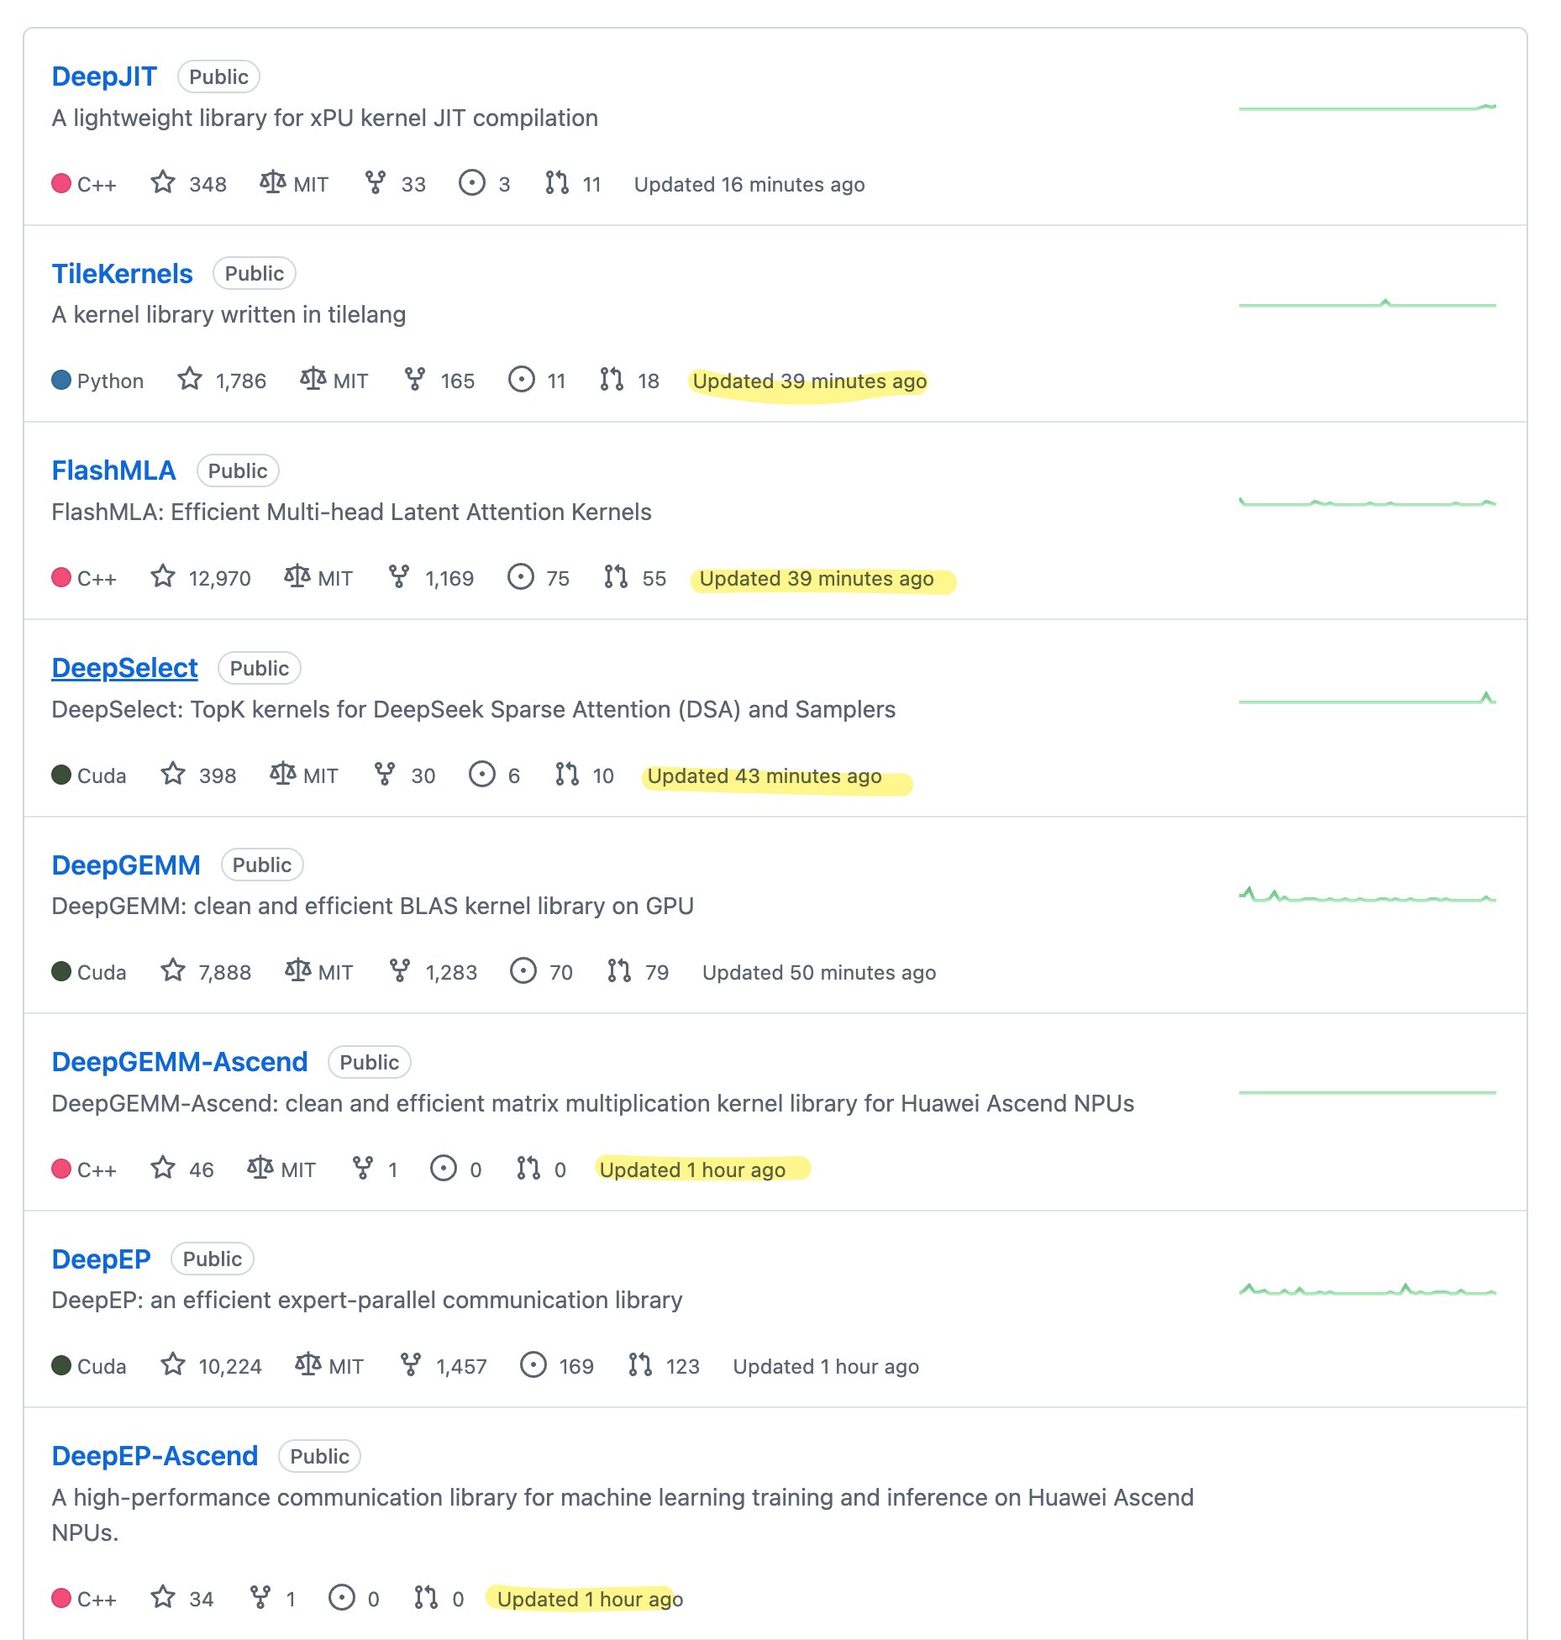
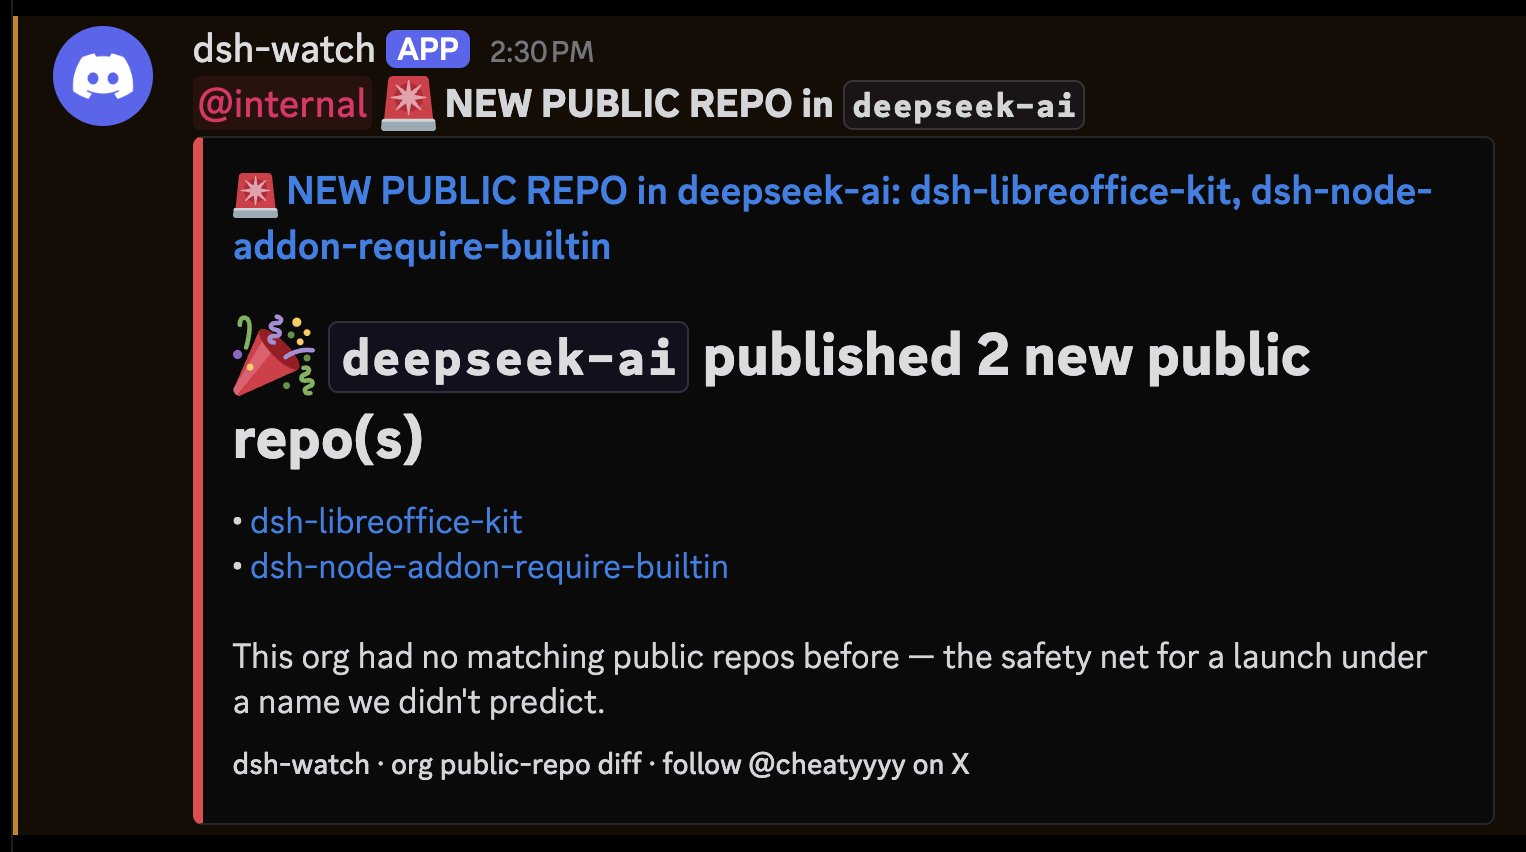
지금 AI 모델은 대부분 NVIDIA 칩에서 돌아갑니다. 칩 성능 때문만이 아니라, 개발자들이 오래 다듬어 온 NVIDIA 전용 프로그래밍 환경 CUDA가 쌓여 있어서입니다. 다른 칩은 성능이 비슷해도 이런 도구가 부족해 쓰기 어렵습니다. 이번 공개는 DeepSeek이 자기 모델을 빠르게 돌리려고 만든 도구를 Ascend용으로 옮겨 누구나 가져다 쓰게 한 것입니다. DeepSeek은 CUDA보다 쓰기 쉽다고 소개하는 프로그래밍 언어 TileLang도 Ascend 950에 맞췄습니다.
그 밖에: DeepSeek은 AI에게 일을 맡기는 데스크톱 앱 Harness를 macOS·Windows용으로 내놨고, 이 앱이 LibreOffice 문서를 다루게 하는 확장 도구도 공개했습니다.
시사점: 9월 28일 호에서 다룬 'V5를 Ascend만으로 훈련했다'는 이야기는 확인되지 않은 전언이었지만, 이번엔 누구나 내려받을 수 있는 도구가 나왔습니다. 다만 도구 공개가 V5를 무슨 칩으로 훈련했는지 확인해 주지는 않습니다. NVIDIA 없이 AI를 돌리려는 쪽의 선택지가 소프트웨어에서 넓어졌다고 읽으면 됩니다.
#DeepSeek#Huawei#Ascend
출처 6🔥 @zheanxu🔥 @eliebakouch🔥 @IntCyberDigest💬 @mark_k🔥 @cheatyyyy🔥 @hqmank
6. OpenAI가 기존 Pro 200 가입자에게 62,500 크레딧(약 2,500달러어치)을 한 번 줬다 — 사용량이 절반으로 줄기 전 보상이다
- OpenAI가 기존 Pro 200(월 200달러 요금제) 가입자에게 62,500 크레딧(2,500달러 상당)을 한 번 지급했습니다. 크레딧은 사용 한도를 다 쓴 뒤 ChatGPT Work와 Codex(OpenAI의 코딩 AI)를 계속 쓰게 해 주는 추가 사용권이고, 12월 31일에 만료됩니다.
- 기존 가입자의 사용량 축소는 10월 30일부터 적용됩니다. Work·Codex 사용 한도가 Plus의 20배에서 10배로 줄고, 요금은 그대로입니다.
- 일반 채팅의 GPT-6 Pro 메시지 상한도 주 200건에서 100건으로 줄어듭니다. 10월 29일까지는 지금 한도가 유지됩니다.
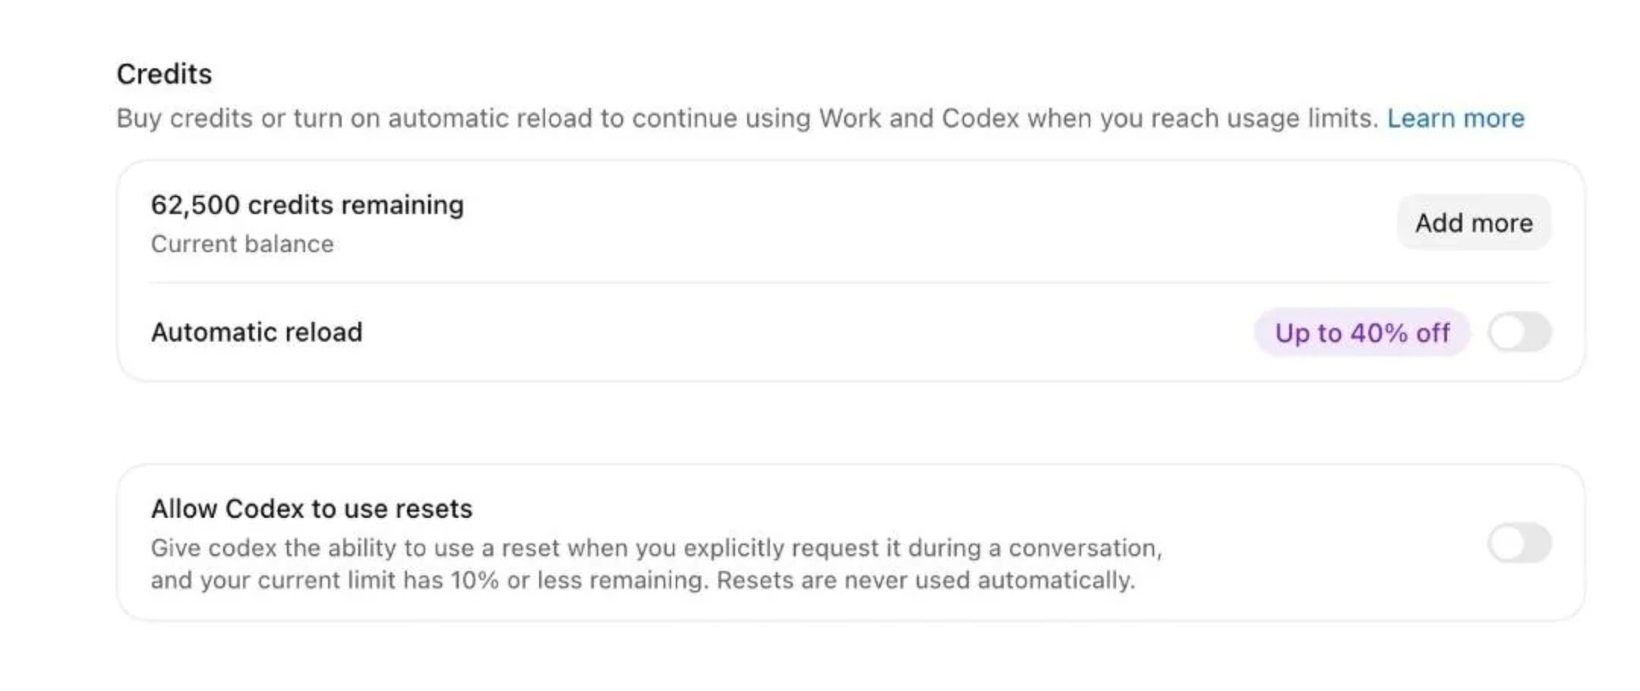
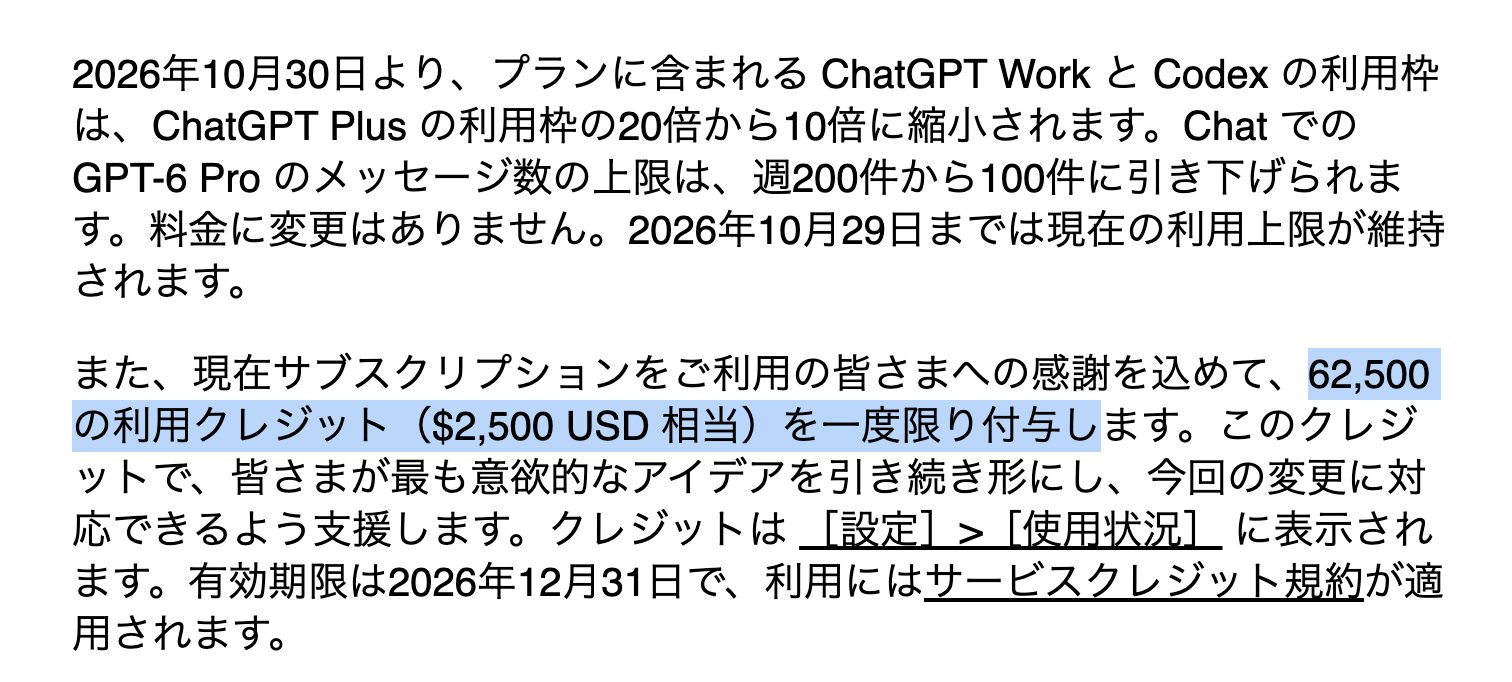
9월 30일 호에서 기존 가입자가 추가 크레딧을 받는다고 전했는데, 가입자 안내 메일로 액수와 날짜가 확인됐습니다. 메일은 이 크레딧을 감사의 뜻이자 이번 변경에 대응하도록 돕는 지원이라고 설명합니다. 일본어로 글을 쓰는 ML_Bear는 40만 엔어치가 들어왔지만 연말 만료라 다 쓰지 못하겠다고 적었습니다.
보상이 충분하냐는 데는 의견이 갈립니다. Angaisb_는 2,500달러가 20배 요금제의 한 주 사용량을 API 요금(개발자가 쓴 만큼 내는 가격)으로 환산한 값의 약 33%라고 계산했습니다. 축소 뒤에는 매주 약 3,750달러어치를 잃는다고 덧붙였습니다. 한 Codex 사용자는 사용량을 반으로 줄여 놓고 효율 개선으로 포장했다며 ChatGPT 구독을 모두 해지했다고 밝혔고, 이 글은 좋아요 565개를 받았습니다.
그 밖에: 지금까지 Work·Codex에서만 쓰던 GPT-6 계열이 일반 채팅에도 들어올 전망입니다. Mark Kretschmann에 따르면 OpenAI의 Michelle Pokrass가 GPT-6.1 Sol을 곧 채팅에 넣는다고 말했지만, 공식 문서로는 확인하지 못했습니다. 월 20달러 요금제로 GPT-6.1 Sol을 최대 설정에 두고 52분 일을 시킨 사용자는 주간 사용량의 4%만 썼지만 속도가 매우 느렸다고 전했습니다.
시사점: 기존 Pro 200 가입자라면 10월 29일 전에 설정의 사용량 화면에서 크레딧 잔액을 확인해 두는 게 좋습니다. 크레딧은 한도를 넘긴 뒤에 쓰이므로, 줄어든 한도에서 연말까지 무엇에 쓸지 미리 정해 둘 만합니다.
#Pro200#OpenAI크레딧#Codex
출처 7💬 @Mr_Salio🔥 @MLBear2💬 @_ak_111💬 @Angaisb_💬 @CodexResets1🔥 @mark_k🔥 @Codexresets_
7. Robinhood Agents가 나온다 — 앱 안에서 몇 번 눌러 주식 매매 에이전트를 만들고 24시간 돌린다
- 미국 증권 앱 Robinhood가 9월 30일(KST) 행사 Engines of Creation에서 Robinhood Agents를 공개했습니다. 에이전트는 사용자 대신 시장을 살피고 주문까지 내는 AI 프로그램입니다.
- 코딩 없이 앱에서 몇 번 눌러 에이전트를 만들고, Loops 기능으로 24시간 쉬지 않고 돌릴 계획입니다.
- 안전장치로 에이전트 전용 계좌를 따로 두고, 매매마다 사람이 승인하는 기능을 기본으로 켭니다. 아직은 출시 예정 상태입니다.
제품 페이지를 보면 AI 모델을 고르고 권한을 정하면 바로 시작하는 구조입니다. 시장 훑어보기, 보유 종목 점검, 관심 종목 목록 만들기, 매매가 처음부터 들어 있습니다. 에이전트가 쓸 돈은 전용 계좌에 따로 넣고, 거래 내역도 그 계좌에서 확인합니다.
같은 페이지의 고지문은 위험을 분명히 적었습니다. Robinhood는 이 에이전트를 감독하거나 점검하지 않고, 에이전트가 낸 주문의 손실은 고객 책임이라고 밝혔습니다. 투자금 전부를 잃을 수 있다는 경고도 붙었습니다.
그 밖에: 데이터·도구 장터 Agent Apps도 함께 공개했습니다. Nasdaq, Quiver Quantitative, Unusual Whales 같은 공급자의 옵션 대량 거래 흐름, 위성 사진, 소셜 트렌드 데이터를 에이전트에 바로 넘길 수 있습니다. 외부 AI 에이전트도 MCP(AI를 다른 서비스에 연결하는 표준 규격)로 붙여 앱에서 함께 지켜볼 수 있습니다.
시사점: AI 자동 매매를 증권 앱 안에서 몇 번 눌러 시작할 수 있게 됩니다. 쓰기는 쉬워졌지만 책임은 여전히 고객에게 있으니, 출시 뒤 써 본다면 승인 기능을 켠 채 소액 전용 계좌로 시작하는 편이 안전합니다.
#Robinhood#AI에이전트#자동매매
출처 3🔥 @RobinhoodApp💬 @RobinhoodApp💬 @RobinhoodApp
8. Salesforce가 AI 고객 인터뷰 회사 Listen Labs 인수를 확정했다 — 창업 3년 만이다
- Salesforce가 9월 29일(미국 시각) Listen Labs를 인수하는 확정 계약을 맺었다고 발표했습니다. 인수가는 공개하지 않았습니다.
- Listen Labs는 AI가 사람 대신 고객을 인터뷰하고 결과를 정리해 주는 서비스입니다. 공동창업자 Florian Juengermann은 Microsoft·Anthropic·Sweetgreen 같은 고객사를 위해 수백만 명을 인터뷰했다고 밝혔습니다.
- 투자 분석가 Paul Bonnet은 인수가를 약 20억 달러로 추정했습니다. 그에 따르면 2023년에 창업한 이 회사가 받은 투자금은 1억 달러가 안 됩니다.
설문지를 돌리던 시장조사를 AI와의 대화로 바꾼 회사입니다. Salesforce 발표에 따르면 AI 에이전트(스스로 여러 단계를 이어 처리하는 AI 프로그램)가 조사를 설계하고, 참가자를 모아 인터뷰한 뒤, 결과를 요약합니다. 5,000만 명이 넘는 참가자 풀에서 120개 넘는 언어로 밤낮없이 인터뷰해, 몇 달 걸리던 조사를 며칠로 줄인다고 합니다. 실제 고객 행동을 바탕으로 만든 가상 고객에게 신제품 반응을 미리 물어보는 기능도 있습니다. 거래는 규제 승인을 거쳐 Salesforce 2027 회계연도 4분기(2026년 11월~2027년 1월)에 마무리될 예정입니다.
Bonnet에 따르면 창업자들은 원래 자신들이 만든 앱 BeFake의 이용자를 이해하려고 이 인터뷰 도구를 만들었습니다. 도구 쪽이 사업이 된 셈입니다. 매각 직전에는 기업가치 15억 달러짜리 투자 계약서도 받아 두었지만 인수를 택했다고 그는 전했습니다. Marc Benioff CEO는 X에 환영 글을 올렸고, 초기 투자사 Sequoia의 Bryan Schreier도 축하를 보탰습니다.
그 밖에: 비슷한 시기에 GPU 클라우드 회사 GMI Cloud가 NVIDIA가 참여한 6억 6,800만 달러 투자를 받았습니다. 미국·대만·아시아태평양에서 GPU를 늘리는 데 씁니다.
시사점: AI로 '무엇을 만들지'보다 '고객이 무엇을 원하는지'를 먼저 묻는 도구에 큰돈이 붙었습니다. Salesforce 고객사라면 설문 대신 AI 인터뷰를 쓰게 될 가능성이 커졌습니다.
#Salesforce#인수합병#고객조사
출처 6💬 @florian_jue🔥 @salesforce🔥 @PaulBonnet🔥 @Benioff🔥 @schreier🚀 @Krishnasagrawal
9. 영국 MI5가 간첩 경보를 냈다 — 중국 연구기관 CGTRI가 지원한 연구에 영국 학자 100명 넘게 참여했고, 그 연구가 간첩 기술을 키운다고 밝혔다
- 영국 국내 정보기관 MI5가 9월 30일 '간첩 경보(Espionage Alert)'를 일반에 직접 공개했습니다. 대상은 중국 연구기관 CGTRI(China General Technology Research Institute)입니다.
- MI5는 CGTRI가 중국 국가안전부(MSS, 중국의 정보기관)와 매우 가깝고, 주된 목적이 간첩 기술을 키울 연구에 돈을 대는 것이라고 밝혔습니다.
- 영국과 연결된 학자 100명 이상이 CGTRI 지원 과제에 참여했습니다. MI5는 앞으로 협력을 이어 가면 영국 국가보안법 위반이 될 수 있다고 경고했습니다.
MI5에 따르면 연구 주제는 AI, 사이버보안, 비밀 통신 시스템, 스테가노그래피(사진·파일 속에 메시지를 숨기는 기술)였습니다. MI5는 상당수 학자가 이 기관과 정보기관의 관계를 모른 채 선의로 참여했을 수 있다고 봤습니다. 경보 이후에 CGTRI와 이어 가는 협력은 문제가 될 수 있다는 경고도 함께 나왔습니다. 2023년에 만든 국가보안법은 외국 정보기관을 돕거나 그 대가를 받는 행위를 처벌할 수 있게 한 법입니다.
그 밖에: Dan Jarvis 영국 안보부 장관은 모든 대학 총장에게 서한을 보냈습니다. 주영 중국대사관은 "완전히 조작된 악의적 비방"이라고 반박했습니다.
시사점: MI5가 CGTRI라는 구체적인 기관을 지목한 만큼, AI·사이버보안 연구를 하는 대학 연구자는 자신이 받는 해외 연구비가 이 기관에서 온 것인지 확인해야 합니다. 경보 이후에도 협력을 이어 가면 법적 책임이 따를 수 있습니다.
#MI5#AI안보#연구보안
10. 🆕 그 밖의 신기능·신제품
- universal-modder: Claude Code가 내가 가진 PC 게임을 고쳐 새 요소를 넣게 해 주는 공개 도구 묶음이 나왔습니다.
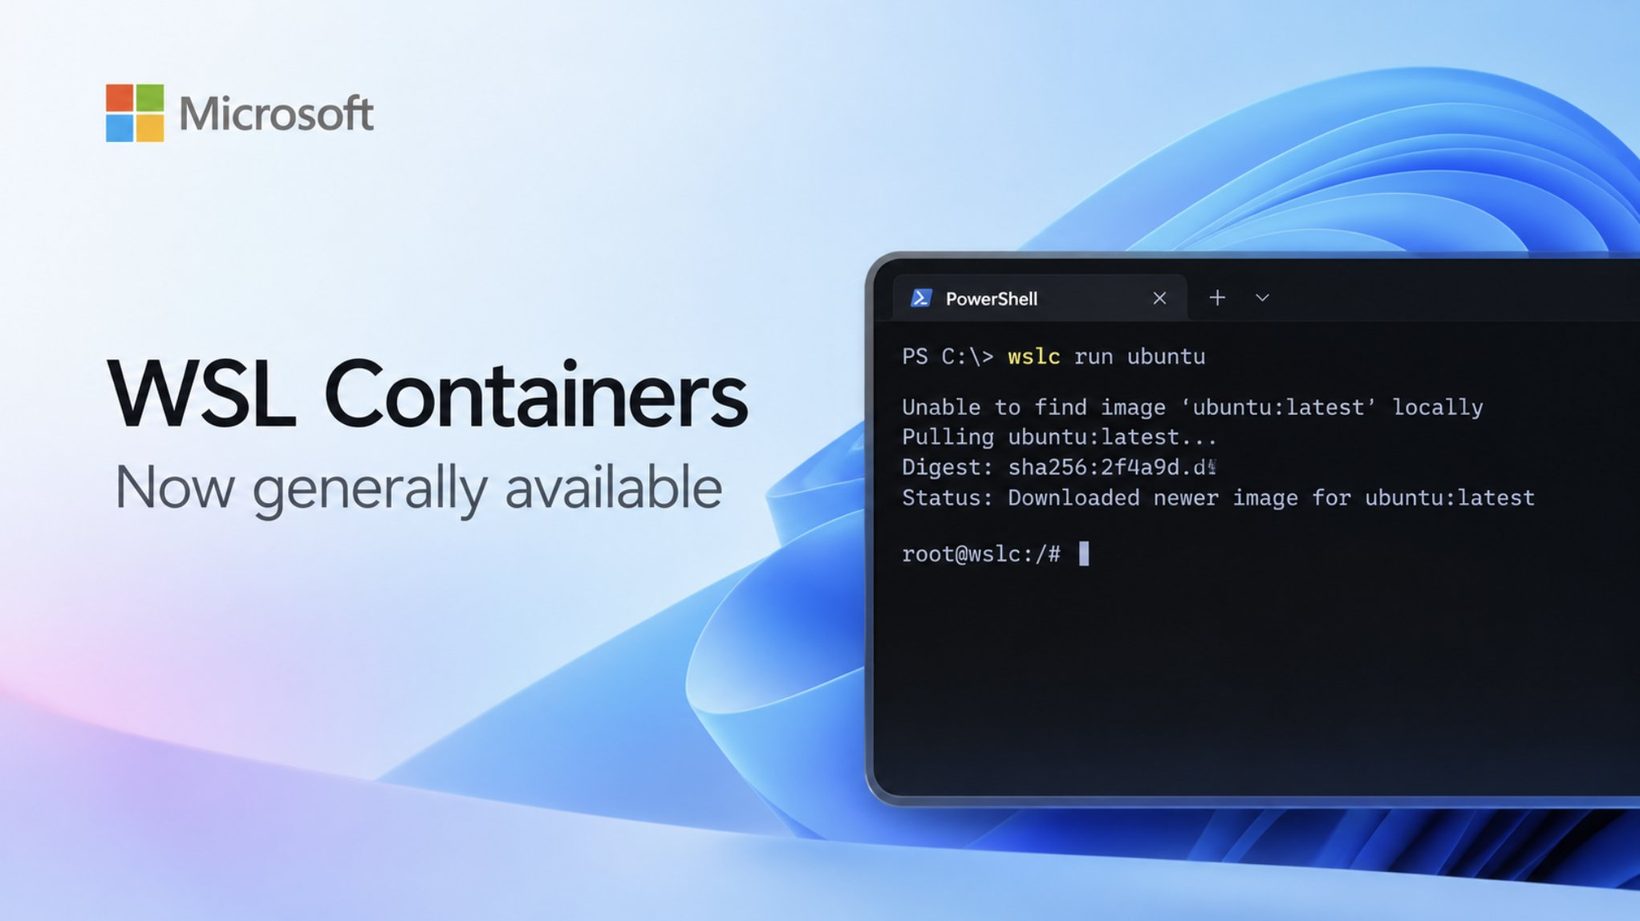
- WSL Containers: Microsoft가 Windows에서 리눅스 컨테이너(프로그램을 격리된 상자에 담아 돌리는 방식)를 바로 쓰는 기능을 정식 출시했습니다.
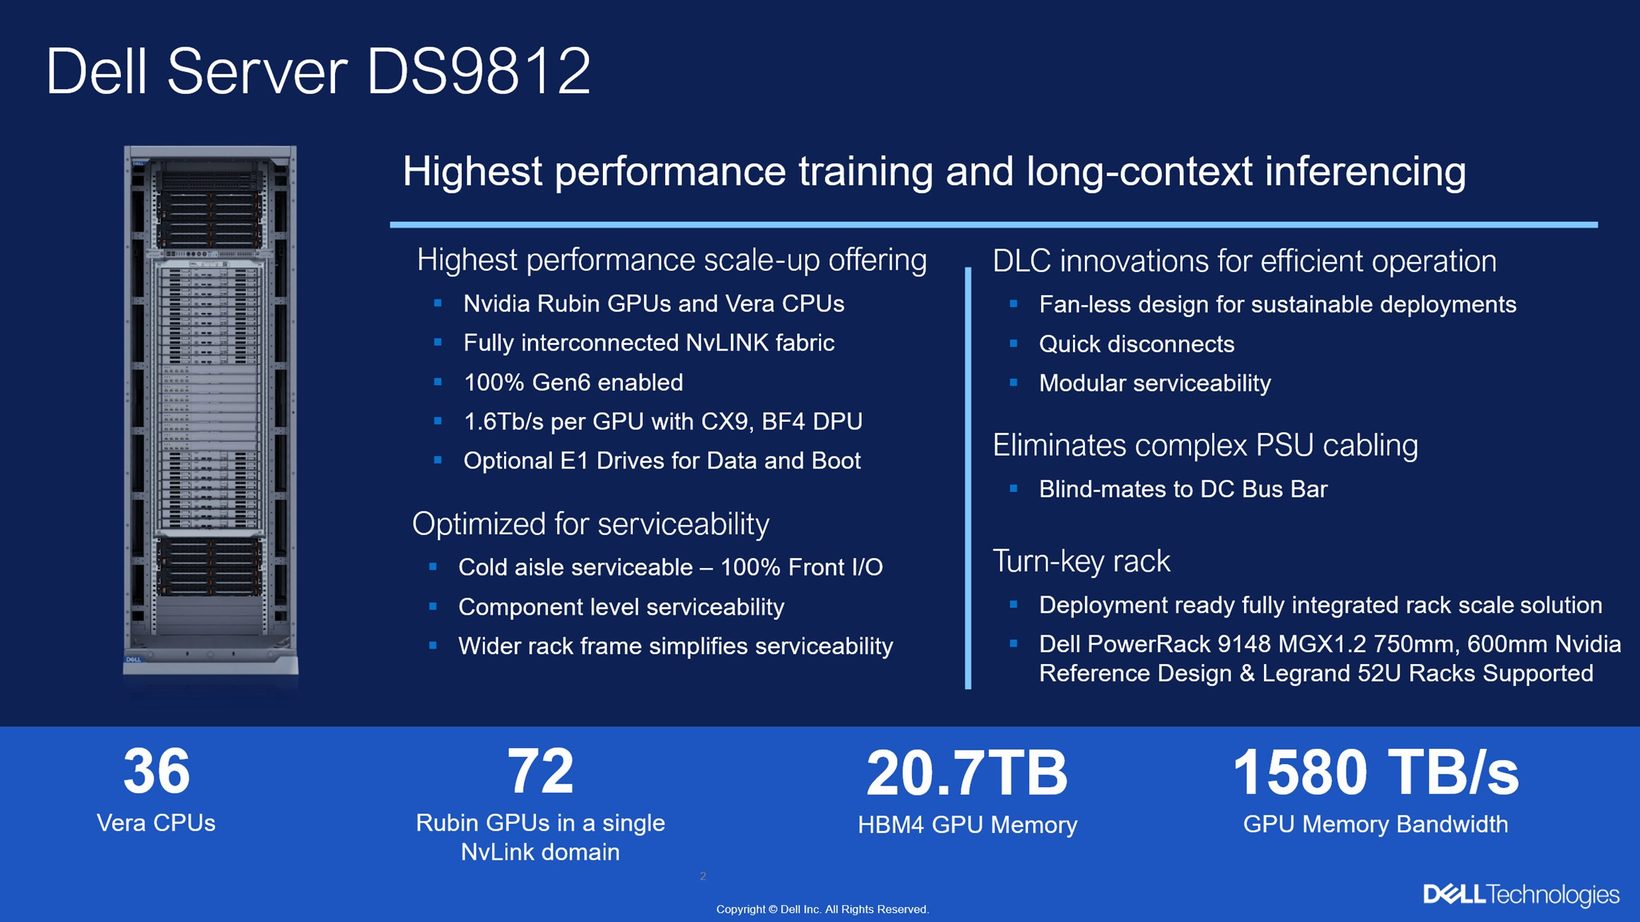
- Vera Rubin NVL72: Dell이 NVIDIA 차세대 AI 서버 랙(서버를 통째로 묶은 설치 단위)의 대량 출하를 알렸습니다.
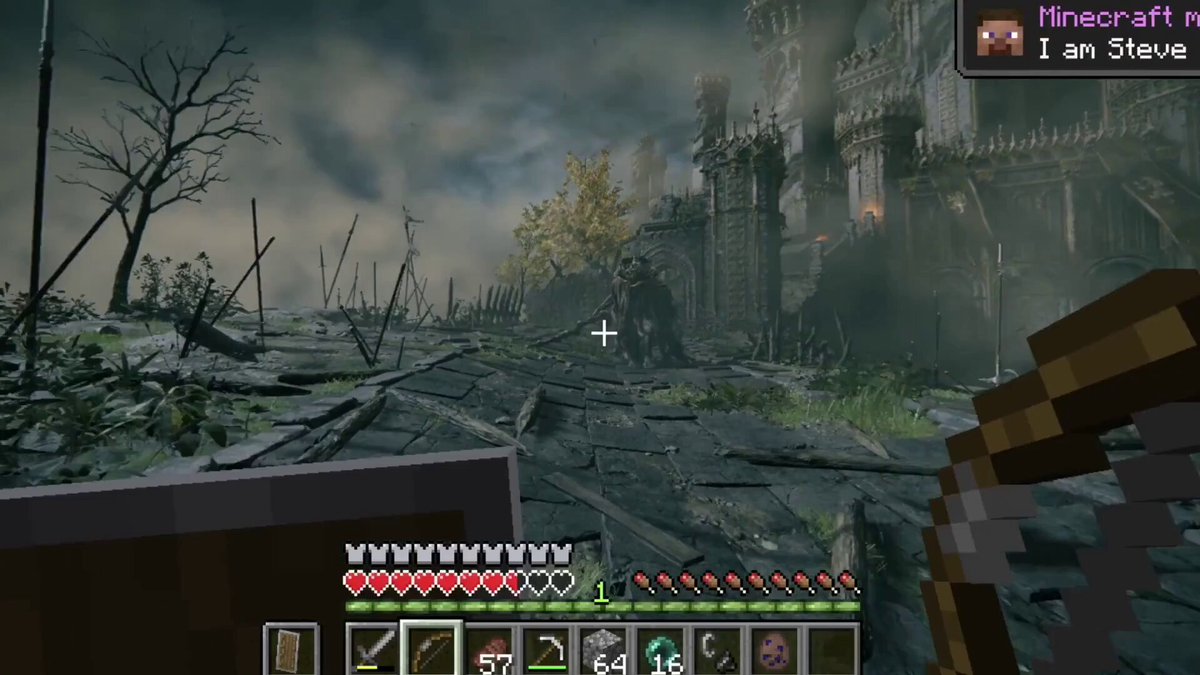
universal-modder를 만든 Rehan Sheikh는 Claude가 Terraria 등을 모딩하며 익힌 요령을 스킬(에이전트용 작업 설명서)로 묶었습니다. 게임 구조 파악부터 그림·소리 생성, 게임 속 시험까지 한 번에 합니다. 그가 GTA 5에 마인크래프트 캐릭터를 넣은 영상은 좋아요 2만 4천여 개를 받았습니다. 제작자 설명상 혼자 하는 오프라인 게임용이고 치트 방지가 걸린 온라인 게임은 거부합니다.
Vera Rubin NVL72는 AI 전용 클라우드 업체 CoreWeave에서도 가동을 시작했습니다. 첫 고객인 코딩 에이전트 회사 Cognition은 실제 소프트웨어 개발 작업에서 이전 세대보다 토큰 처리량이 최대 4.8배 높았다고 밝혔습니다.
그 밖에: OpenAI는 개발자 행사 DevDay 참가자에게 게임보이 컬러용 휴대 게임기 ModRetro Chromatic을 나눠 주고, Codex로 만든 레트로 게임 13종을 공개했습니다. Google은 유료 Google AI 요금제에 Colab(브라우저에서 GPU를 빌리는 서비스) 혜택을 넣습니다.
시사점: 코딩 에이전트의 쓰임새가 업무를 넘어 게임 모딩 같은 취미로 넓어지고 있습니다.
#universal-modder#WSLContainers#VeraRubin
출처 8🔖 @rehan_shei🔖 @rehan_shei🔥 @twtayaan🔥 @MichaelDell🚀 @NVIDIAAIInfra🚀 @gigazine🔥 @lenadroid🔥 @itsPaulAi
오늘의 감정·온도
오늘의 실무 팁 — 쉽게 풀어 쓴 사용법 6가지
1. Pro 200 기존 가입자는 10월 29일 전에 크레딧 잔액을 확인한다
설정의 사용량 화면에 62,500 크레딧이 들어왔는지 보세요. 크레딧은 한도를 넘긴 뒤에 쓰이고 12월 31일에 만료되니, 연말까지 어디에 쓸지 미리 정해 두면 됩니다. — (@Mr_Salio)
2. 내려받아 쓰는 AI 모델은 안전장치가 풀릴 수 있다고 보고 들인다
Anthropic 보고서에서 GLM-5.3은 거짓 설정 하나만으로 악성 요청의 64%에 응했습니다. 회사 업무에 오픈 웨이트 모델을 붙일 때는 모델의 거절 기능만 믿지 말고, 쓸 수 있는 권한과 데이터 범위를 따로 좁혀 두세요. — (@choblin29)
3. Robinhood Agents는 승인 기능을 켠 채 소액 전용 계좌로 시작한다
에이전트가 낸 주문의 손실은 고객 책임이라고 Robinhood가 적었습니다. 출시 뒤 써 본다면 매매마다 사람이 승인하는 기본 설정을 그대로 두고, 잃어도 되는 금액만 전용 계좌에 넣으세요. — (@RobinhoodApp)
4. universal-modder는 혼자 하는 오프라인 게임에만 쓴다
제작자 설명상 이 도구는 치트 방지가 걸린 온라인 게임을 거부합니다. 내가 가진 싱글 플레이 게임에 새 요소를 넣어 보는 용도로 시작하면 됩니다. — (@rehan_shei)
5. Windows에서 리눅스 프로그램을 시험할 땐 WSL Containers를 써 본다
wslc 명령 한 줄로 우분투를 받아 실행할 수 있습니다. 리눅스용 도구를 잠깐 돌려 볼 일이 있을 때 먼저 시도해 볼 만합니다. — (@twtayaan)
6. AI·보안 연구자는 해외 연구비가 CGTRI에서 온 것인지 확인한다
MI5는 경보 이후에도 CGTRI와 협력을 이어 가면 영국 국가보안법 위반이 될 수 있다고 밝혔습니다. 영국과 연결된 공동 연구를 하고 있다면 지원 기관 이름부터 확인해 두세요. — (@alexwickham)
📦 확인 방식
합의문·행정명령 내용은 백악관 문서와 보도에서, GLM-5.3 수치는 Anthropic 보고서에서, Listen Labs 인수는 Salesforce 발표에서 가져왔습니다. Listen Labs 인수가 추정치와 Claude의 여과 이론 증명, DeepSeek이 밝힌 성능은 외부 독립 검증 전입니다.
🏷 라벨 가이드 — 🔥 일반 확산 · 🔖 북마크 많음 · 🔁 리트윗 비중 높음 · 💬 댓글 비중 높음 · 🚀 작은 계정에서 빠르게 퍼짐