AI 브리핑 ·
Meta, Muse Spark Open 공개
5분 브리핑
약 3분 · 8개 흐름핵심만 먼저 읽고, 궁금한 소식은 본문으로 이어 보세요.
전체 분석 15분으로 바로 가기 ↓- Meta, Muse Spark Open 공개…모델 파일을 내려받거나 7개 API로 바로 쓴다
Meta가 미국 시간 15일 Muse Spark Open을 공개했습니다. 그동안 가중치(모델 파일)를 공개하지 않던 Muse Spark를 누구나 내려받아 직접 돌릴 수 있게 한 공개판입니다.
- Microsoft AI, 사내에서 처음부터 훈련한 기반 모델 MAI-Base-2 발표…총 2.8T 파라미터, 공개 가중치 모델들보다 앞섰다고 밝혔지만 아직 쓸 수는 없다
Microsoft AI가 기반 모델 MAI-Base-2의 사전훈련을 마쳤다고 10월 15일 공개했습니다. 기반 모델은 대화용으로 다듬기 전, 많은 글을 읽고 다음 글자를 예측하도록 배운 단계의 모델입니다.
- ARC Prize, Gemini 4 Argon 검증 점수 공개…ARC-AGI-3 97.5%로 두 번째 95% 돌파, 표준 조건에선 49.8%
ARC-AGI-3는 처음 보는 퍼즐 게임을 규칙 설명 없이 풀게 하는 시험입니다. 시험을 만든 ARC Prize가 직접 검증한 Gemini 4 Argon 점수는 회사 전용 연결 방식에서 97.5%, 비용은 약 4,800달러였습니다.
- OpenCode, DeepSeek V4.1 Flash 무료 제공…코딩 도구 모델 목록에 'Free'로 올라왔다
오픈소스 코딩 에이전트 OpenCode(터미널·데스크톱 앱에서 AI에게 코드를 맡기는 도구)가 10월 15일 오후 DeepSeek V4.1 Flash를 무료로 열었다고 공식 계정에 알렸습니다. 모델 선택 목록에 'DeepSeek V4.1 Flash Free'가 따로 생겼습니다.
- NVIDIA, 공개 모델 Nemotron 3.5 Super VL 출시…이미지·영상까지 읽는 120B 모델, 24GB에 들어가는 Bolt도
NVIDIA가 10월 15일 Hugging Face에 Nemotron 3.5 Super VL을 공개했습니다. 매개변수 1,200억 개 중 한 번에 120억 개만 쓰는 모델로, 글·이미지·문서·영상을 읽고 글로 답합니다.
- Claude Code 데스크톱 앱, 여러 세션을 나란히 돌리도록 개편…쉬는 동안 대화를 미리 압축하고 메뉴에서 Opus 5.5 빠른 모드도 켠다
데스크톱 앱 개편: Anthropic 개발자 계정 ClaudeDevs가 Claude Code 데스크톱 앱을 여러 작업 세션을 나란히 돌리기 좋게 바꿨다고 알렸습니다. 세션을 더 빨리 열고, 세션마다 지금 무엇을 하는지 늘 볼 수 있으며, Claude가 제안한 후속 작업을 한 번 눌러 새 세션으로 돌릴 수 있습니다.
- Anthropic 3분기 매출 168억 달러…Bloomberg "투자자 설명회서 영업이익·현금흐름 흑자"
Bloomberg 보도에 따르면 Anthropic은 10월 14일(현지) 잠재 투자자 설명회에서 3분기 매출 168억 달러를 제시했습니다. 8월 보도된 2분기 매출(115억 달러 이상)보다 40% 넘게 많습니다.
- 🆕 그 밖의 신기능·신제품 — Kling 4.0·Krea 3·Goodfire 해석가능성 연구·Perplexity SPACE·Google Deep Review·Claude로 만든 무료 Office 대안
Kling 4.0 정식 공개 — 영상 생성 모델 Kling 4.0을 이제 누구나 씁니다. 새 제작 화면 외에 MCP(AI 비서가 외부 도구를 불러 쓰는 연결 규격)와 명령줄로도 부를 수 있고, 4K HDR 출력과 기업용 API는 곧 나올 예정입니다.
주요 키워드 TOP 5: Muse Spark Open · MAI-Base-2 · Gemini 4 Argon · DeepSeek V4.1 Flash · Nemotron 3.5 | 메인 이벤트: Meta가 816B 공개 가중치 모델 Muse Spark Open을 공개해, 누구나 내려받거나 7곳의 API에서 바로 쓸 수 있게 됐습니다
Meta가 미국 시간 15일 Muse Spark Open을 공개했습니다. 그동안 가중치(모델 파일)를 공개하지 않던 Muse Spark를 누구나 내려받아 직접 돌릴 수 있게 한 공개판으로, 전체 매개변수는 816B이지만 답할 때는 42B만 골라 씁니다. 설치 없이 쓰려면 OpenRouter·Groq 등 7곳의 API가 있고, 직접 돌리려면 M5 Ultra 칩을 넣은 Mac Studio 두 대로 전체 모델이 돌아간다고 Meta는 밝혔습니다. 다만 Meta 자체 비교표에서도 코딩 시험에서는 Kimi K3 같은 다른 공개 모델이 앞선 항목이 있으니, 맡길 일로 직접 시험해 보고 고르는 편이 좋습니다.
1. Meta, Muse Spark Open 공개…모델 파일을 내려받거나 7개 API로 바로 쓴다
- Meta가 미국 시간 15일 Muse Spark Open을 공개했습니다. 그동안 가중치(모델 파일)를 공개하지 않던 Muse Spark를 누구나 내려받아 직접 돌릴 수 있게 한 공개판입니다.
- 매개변수는 전체 816B(8,160억 개)지만 답할 때마다 42B(420억 개)만 골라 쓰는 구조입니다. 한 번에 100만 토큰(책 여러 권 분량)을 읽고, 글·이미지·영상·음성을 받아 글로 답합니다.
- Hugging Face 등에서 내려받을 수 있고, Baseten·Fireworks AI·Groq·Modal·Nebius·OpenRouter·Together AI 7곳의 API로는 설치 없이 바로 씁니다.
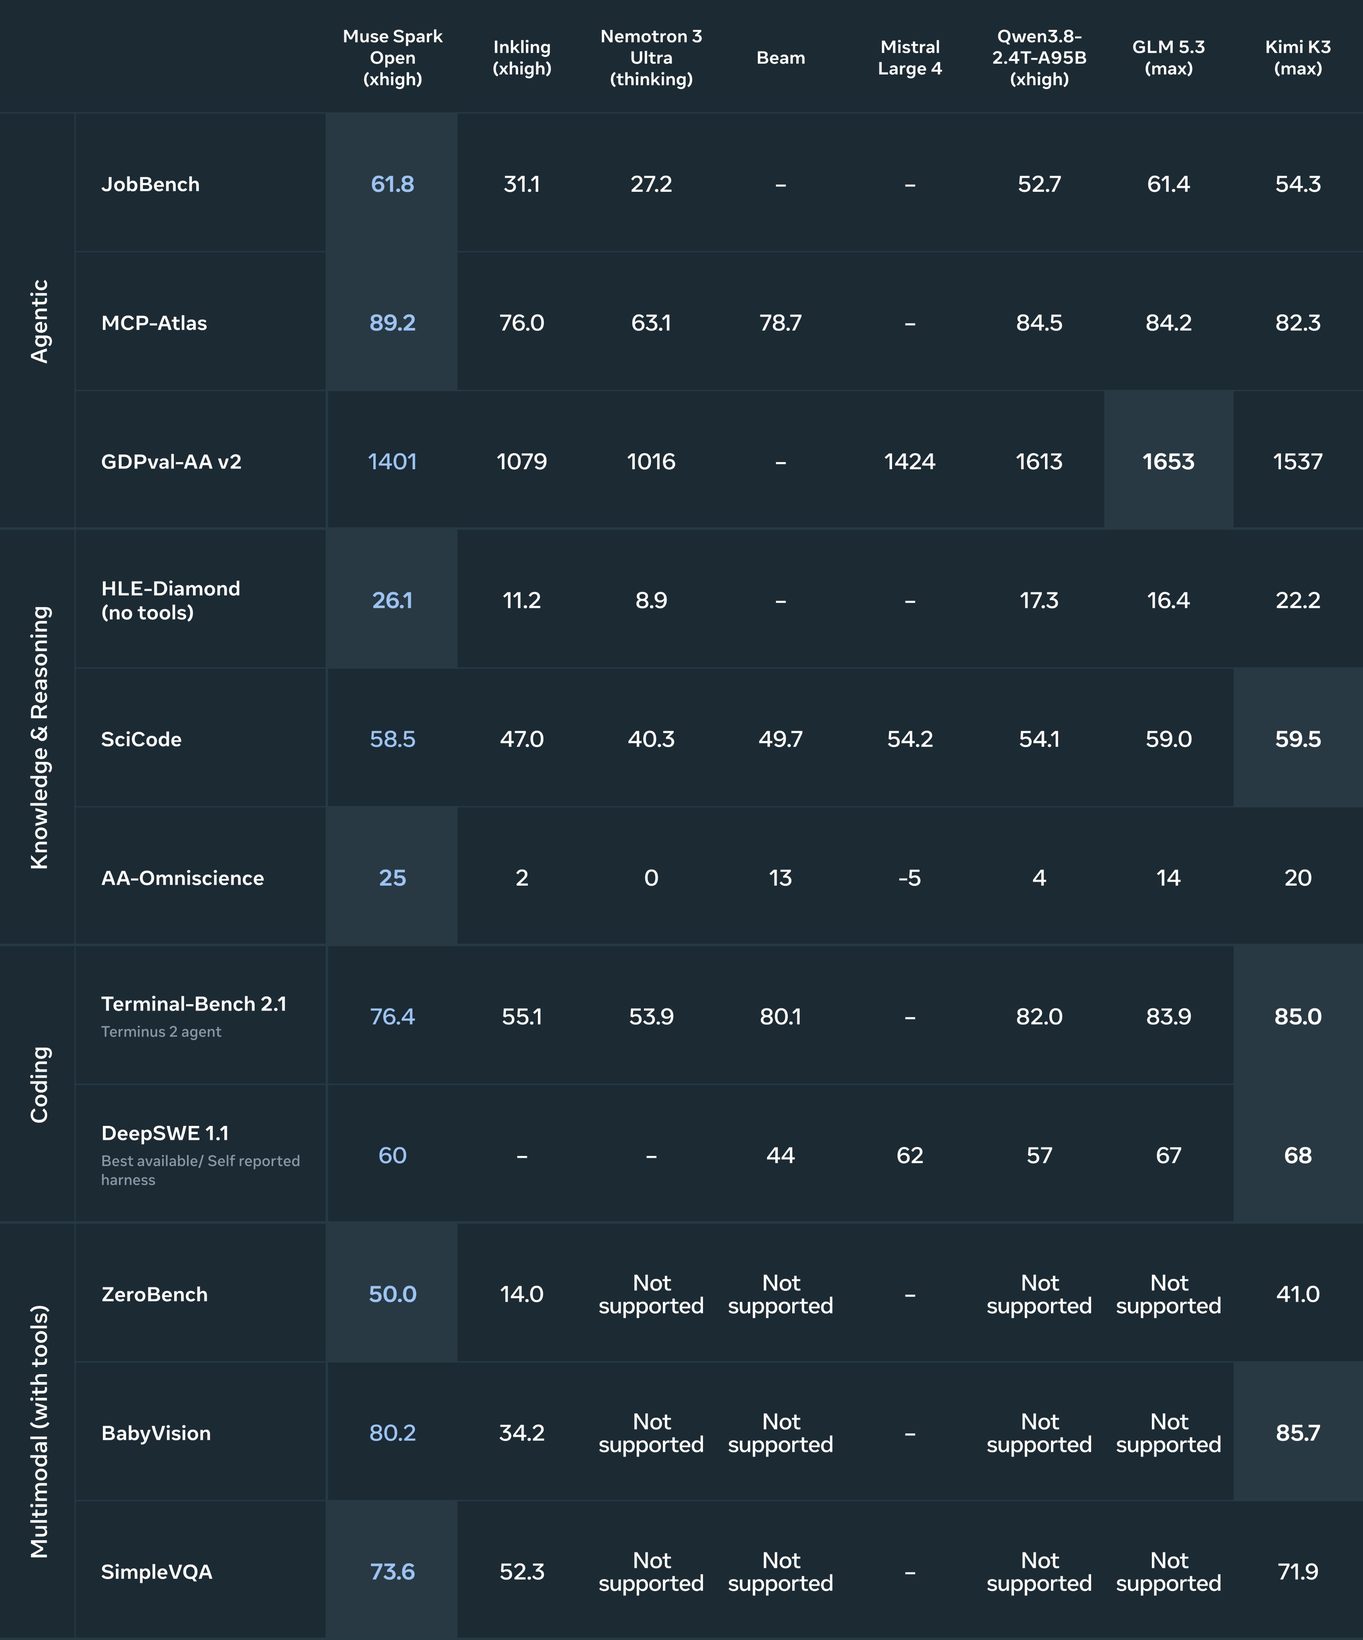
공개 가중치 모델은 누구나 파일을 받아 자기 컴퓨터나 서버에서 돌리고 고쳐 쓸 수 있는 모델입니다. Meta AI 조직을 이끄는 Alexandr Wang은 이 모델을 지금까지 가장 강력한 미국산 공개 가중치 모델이라고 소개했습니다. 다만 Meta 자체 비교표에서도 모든 항목 1위는 아닙니다. 여러 외부 도구를 불러 일을 처리하는 MCP-Atlas와 도구 없이 전문가급 난제를 푸는 HLE-Diamond에서는 Muse Spark Open이 가장 높았습니다. 반면 Terminal-Bench 2.1과 또 다른 코딩 시험 DeepSWE 1.1에서는 Kimi K3·GLM 5.3 등 중국 회사 모델이 더 높았습니다.
실제로 눈여겨볼 부분은 돌리는 장비입니다. Meta는 Apple과 함께 작업해 M5 Ultra 칩을 넣은 Mac Studio 두 대로 전체 모델이 돌아간다고 밝혔습니다. 한 대에 메모리를 최대 512GB까지 쓸 수 있어, 두 대를 이으면 약 1TB 메모리를 가진 한 대처럼 쓰는 방식입니다. 데이터센터용 GPU로 돌리려면 압축판(NVFP4)으로도 GPU 메모리가 700GB 이상 필요하다고 모델 카드에 적혀 있습니다.
그 밖에: 라이선스는 Meta의 Muse Model License입니다. 많은 개발자가 무료로 쓸 수 있지만 제품에 'Built with Muse Spark Open'을 표시해야 합니다. 이 모델을 API 서비스로 제공하는 회사의 12개월 총매출이 2,000만 달러를 넘으면 Meta에 알리고 따로 계약해야 합니다. Meta는 출시 전 안전성 기준을 통과했다고 밝혔고, 전체 평가 보고서는 곧 내겠다고 했습니다.
시사점: 회사 데이터를 외부로 보내기 어려워 AI 도입을 미뤘다면, 사내 장비에서 돌릴 수 있는 큰 모델이 하나 늘었습니다. 다만 코딩용으로 고른다면 Meta 표에서도 다른 공개 모델이 앞선 항목이 있으니 직접 시험해 보고 고르는 편이 좋습니다.
#MuseSparkOpen#공개가중치#Meta
출처 7🔥 @alexandr_wang🔥 @alexandr_wang💬 @jack_w_rae💬 @mervenoyann🔥 @LuminaBench🔥 @testingcatalog🔥 @AlexFinn
2. Microsoft AI, 사내에서 처음부터 훈련한 기반 모델 MAI-Base-2 발표…총 2.8T 파라미터, 공개 가중치 모델들보다 앞섰다고 밝혔지만 아직 쓸 수는 없다
- Microsoft AI가 기반 모델 MAI-Base-2의 사전훈련을 마쳤다고 10월 15일 공개했습니다. 기반 모델은 대화용으로 다듬기 전, 많은 글을 읽고 다음 글자를 예측하도록 배운 단계의 모델입니다.
- 크기는 총 2.8T 파라미터(모델 크기를 나타내는 값, 2조 8천억 개)입니다. 회사는 자체 시험에서 가중치(모델 파일)를 공개한 모델 넷보다 앞섰다고 밝혔습니다.
- 대화용으로 다듬는 후속 훈련이 아직 진행 중이라 지금 써 볼 수 있는 제품은 없습니다. 가중치도 공개 다운로드가 아니라, Microsoft의 AI 서비스 플랫폼 Foundry를 통해 '신뢰할 수 있는 파트너'에게만 사용 허가를 내줄 계획입니다.
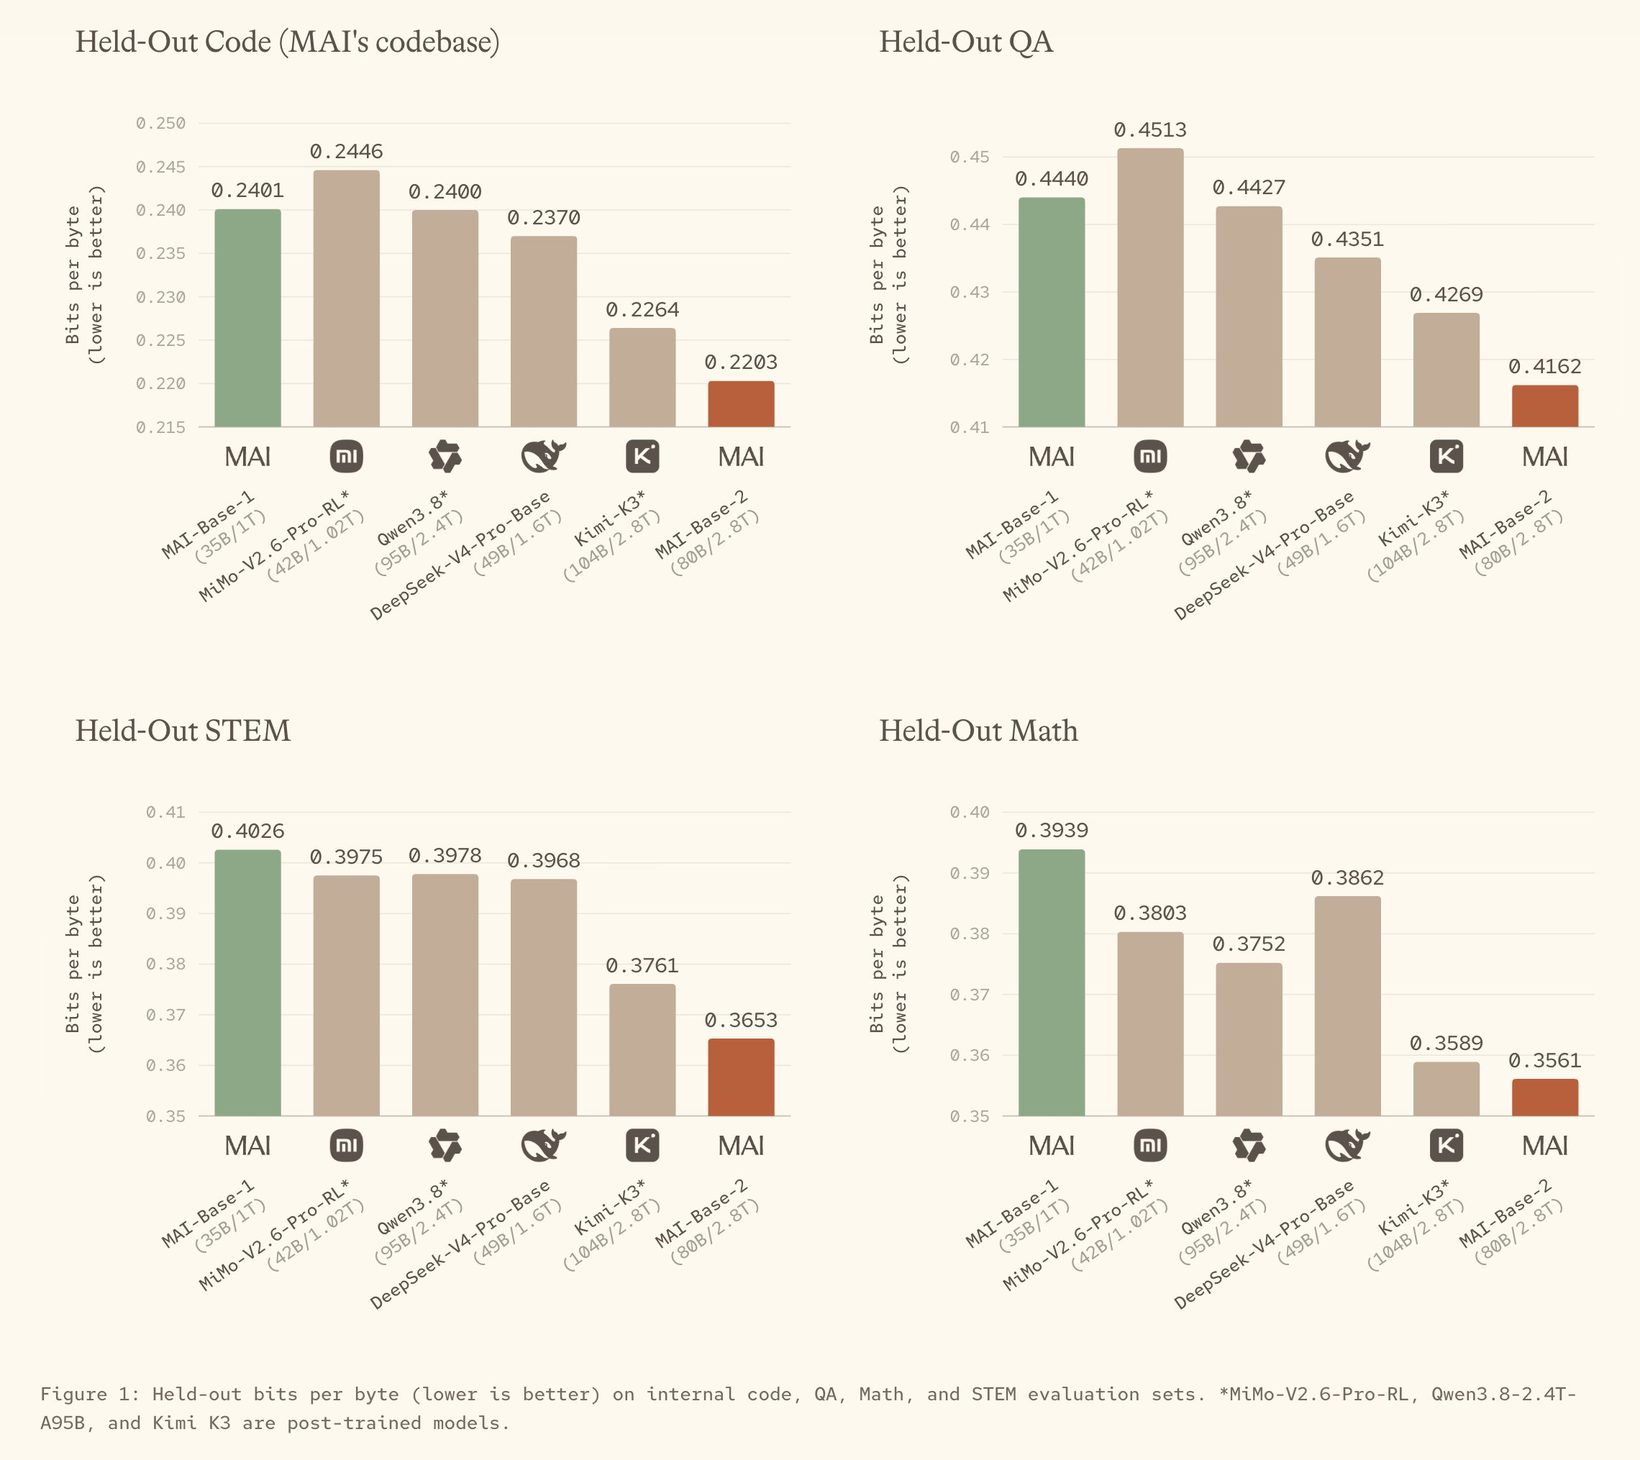
Microsoft AI를 이끄는 Mustafa Suleyman은 이 모델을 같은 크기급에서 최고 수준인 기반 모델이며 전부 사내에서 만들었다고 소개했습니다. 회사에 따르면 NVIDIA GB200 GPU 1만 6천 개로 8~9월에 38일 동안 훈련했습니다. 다른 모델의 답을 받아 배우는 증류 없이 사내에서 직접 처리한 데이터로 50조 토큰(글을 잘게 나눈 단위) 분량을 학습했습니다. 질문마다 일부 전문가 묶음만 켜는 구조라 한 번에 실제로 쓰는 부분은 800억 파라미터입니다.
비교는 회사가 따로 마련한 내부 시험으로 했습니다. 처음 보는 코드·질의응답·과학·수학 글을 주고 다음 글자를 얼마나 잘 맞히는지 재며, 값이 낮을수록 잘 맞힌다는 뜻입니다. 비교 대상 중 DeepSeek-V4-Pro-Base만 같은 기반 모델입니다. Kimi K3·Qwen3.8-2.4T-A95B·MiMo-V2.6-Pro-RL은 후속 훈련을 마친 버전만 나와 있어 그것으로 비교했고, 블로그도 이 차이가 결과에 영향을 줄 수 있다고 적었습니다. 같은 점수를 내는 데 DeepSeek-V4-Pro-Base보다 연산이 4.2~12.3배 적게 든다는 주장도 직접 잰 값이 아니라 규모별 성능 추세로 계산한 추정치입니다.
그 밖에: 이전 모델 MAI-Base-1 위에 후속 훈련을 얹은 MAI-Thinking-1은 6월에 나왔고, 다음 모델 MAI-Base-3 준비도 이미 시작했다고 회사는 밝혔습니다. 연구자 Luca Soldaini는 비교 그래프를 올리며 후속 훈련에는 시간이 걸린다고 양해를 구했습니다.
시사점: 지금 숫자는 회사가 자기 시험으로 잰 첫 성적표입니다. 실제로 얼마나 쓸 만한지는 후속 훈련을 마친 모델이 나오고 외부 평가를 거쳐야 알 수 있습니다.
#MicrosoftAI#MAIBase2#기반모델
출처 2🔥 @mustafasuleyman🔥 @soldni
3. ARC Prize, Gemini 4 Argon 검증 점수 공개…ARC-AGI-3 97.5%로 두 번째 95% 돌파, 표준 조건에선 49.8%
- ARC-AGI-3는 처음 보는 퍼즐 게임을 규칙 설명 없이 풀게 하는 시험입니다. 시험을 만든 ARC Prize가 직접 검증한 Gemini 4 Argon 점수는 회사 전용 연결 방식에서 97.5%, 비용은 약 4,800달러였습니다.
- 모든 모델에 같은 조건을 거는 표준 연결 방식에서는 49.8%로 절반 수준이었고, 비용은 약 5,800달러였습니다.
- 격자 그림 몇 쌍을 보고 숨은 규칙을 찾는 이전 시험 ARC-AGI-2에선 91.3%, 문제당 0.32달러였습니다. ARC Prize는 Google DeepMind를 ARC-AGI-3에서 95%를 넘긴 두 번째 연구소로 꼽았습니다.
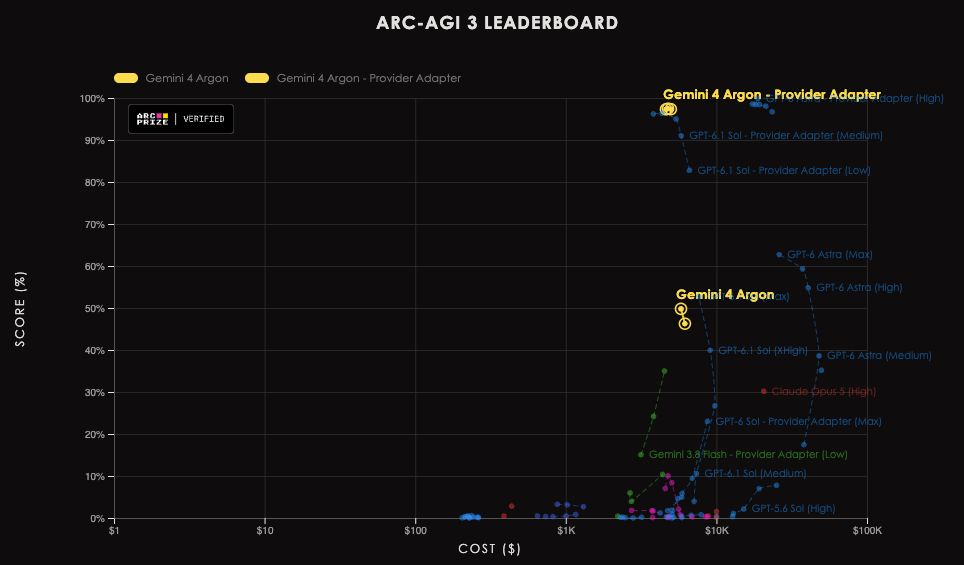
그래서 Argon은 어느 쪽에서도 1위가 아닙니다. 전용 방식에선 맨 위 점수에 가까운 결과를 훨씬 적은 비용으로 냈고, 표준 방식에선 GPT-6 Astra(Max)보다 10점 넘게 낮습니다. 같은 모델인데 점수가 두 배 가까이 벌어진 건 연결 방식만 달랐기 때문입니다. 연결 방식은 게임하는 동안 모델이 무엇을 기억할지 정합니다. ARC Prize 설명에 따르면 표준 방식은 모델이 스스로 골라 적은 메모만 다음 단계로 넘기고, 전용 방식은 앞서 생각한 과정을 이어 쓰게 하며 긴 기록은 줄여서 넘겨 줍니다. 규칙을 시행착오로 알아내야 하는 시험이라 이 차이가 점수에 크게 드러난 셈입니다. 100%는 사람만큼 효율적으로 모든 게임을 깼다는 뜻입니다. 이번 수치는 Google 자체 발표가 아니라 시험 주최 측이 직접 돌려 확인한 값입니다.
그 밖에: ARC Prize 공동창업자 Mike Knoop은 Argon을 전용 방식으로 이 시험을 사실상 다 푼 두 번째 모델 계열이라고 평가했습니다. 첫 시험 ARC-AGI-1에선 98.5%, 문제당 0.16달러였습니다.
시사점: 'ARC-AGI-3 97.5%'라는 숫자를 보면 전용 방식 점수라는 점을 함께 기억하세요. 다른 회사 모델과 같은 조건으로 견주는 숫자는 표준 방식의 49.8%입니다.
#ARCAGI3#Gemini4Argon#벤치마크
4. OpenCode, DeepSeek V4.1 Flash 무료 제공…코딩 도구 모델 목록에 'Free'로 올라왔다
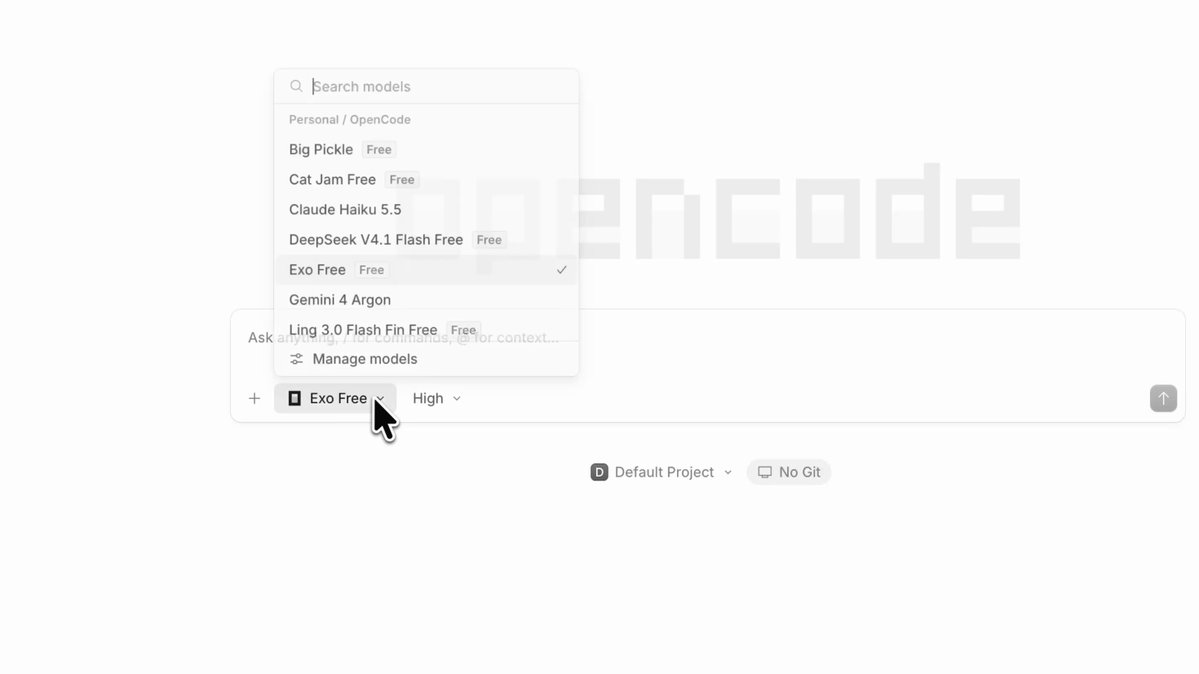
- 오픈소스 코딩 에이전트 OpenCode(터미널·데스크톱 앱에서 AI에게 코드를 맡기는 도구)가 10월 15일 오후 DeepSeek V4.1 Flash를 무료로 열었다고 공식 계정에 알렸습니다.
- 모델 선택 목록에 'DeepSeek V4.1 Flash Free'가 따로 생겼습니다. OpenCode 문서에 적힌 같은 모델의 유료 가격은 100만 토큰(AI가 글을 잘게 나눠 읽는 단위)당 입력 $0.30·출력 $1.20입니다.
- 문서에는 한정 기간 무료라고만 적혀 있습니다. 공식 게시와 문서 어디에도 끝나는 날짜나 사용 한도는 없습니다.
이 모델은 원래도 값이 싼 편입니다. 10월 9일호에 실린 한 사용자 사례에서는 같은 지시로 게임을 만들게 했을 때 비용이 Claude Haiku 5.5의 약 5분의 1이었습니다. 실행 조건이 달라 그대로 비교하기는 어려운 한 사람의 경험이었습니다. 이제 OpenCode 안에서는 그 비용도 내지 않습니다. 공지 게시물은 좋아요 7,134건을 받았습니다. Ben Dickson은 최상위에 가까운 모델을 공짜로 받은 셈이라고 평했습니다. 그는 모든 일에 Opus 5.5 같은 최상위 모델을 쓸 필요는 없다고 봤습니다. 모델 구조와 모델을 돌리는 기술이 나아지면서 쓸 만한 모델의 값이 0에 가까워질 것이라는 전망도 덧붙였습니다.
데이터 조건도 문서에서 확인됩니다. OpenCode는 모델을 실제로 돌리는 제공 업체가 입력을 보관하지 않고 학습에도 쓰지 않는 것을 원칙으로 둡니다. 무료 기간의 입력을 모델 개선에 쓰는 모델 등 예외를 따로 적어 두었는데, 이 모델은 그 목록에 없습니다.
그 밖에: 한 사용자는 모델 설정에서 이 항목을 켜야 목록에 나타난다고 안내했습니다.
시사점: 코딩 에이전트를 비용 걱정 없이 써 볼 기회입니다. 다만 무료가 언제 끝날지 모르니 작업 흐름을 이 모델 하나에 묶지 않는 편이 안전합니다.
#OpenCode#DeepSeek#무료모델
출처 4🔥 @opencode💬 @k2sbhai🔥 @bendee983💬 @buildwithhassan
5. NVIDIA, 공개 모델 Nemotron 3.5 Super VL 출시…이미지·영상까지 읽는 120B 모델, 24GB에 들어가는 Bolt도
- NVIDIA가 10월 15일 Hugging Face에 Nemotron 3.5 Super VL을 공개했습니다. 매개변수 1,200억 개 중 한 번에 120억 개만 쓰는 모델로, 글·이미지·문서·영상을 읽고 글로 답합니다.
- 함께 나온 Nemotron 3.5 Bolt 74B-A9B는 모델 속 숫자 대부분을 하나당 약 2비트로 줄여 저장해 24GB 메모리에 맞춘 모델입니다.
- 두 모델 모두 가중치(학습으로 정해진 모델 속 숫자)와 학습 방법, 학습 데이터 일부까지 공개했고 상업적 이용도 허용합니다.
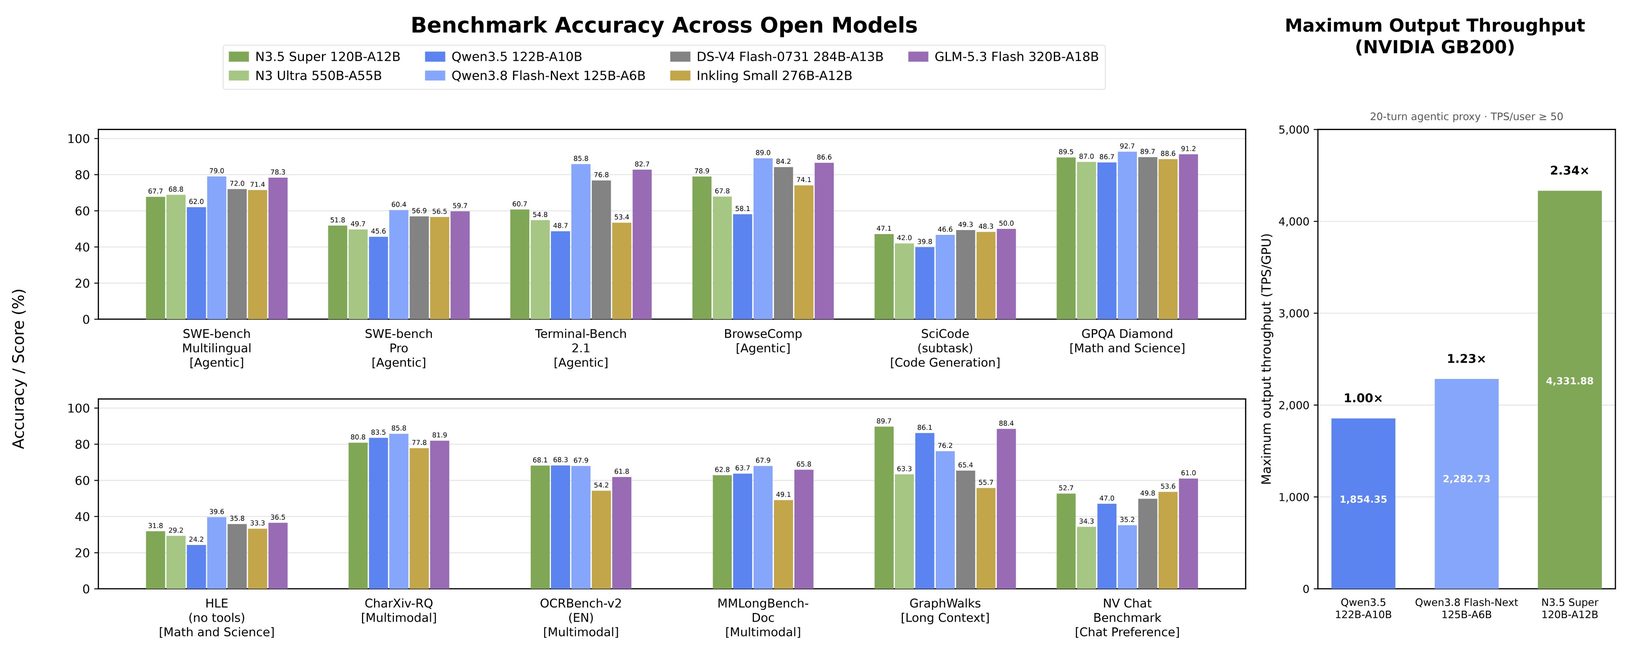
Super VL은 오래 일하는 에이전트(사람 대신 여러 단계의 작업을 이어서 처리하는 AI)를 겨냥했습니다. NVIDIA가 밝힌 수치로 보면 정확도 1등 모델은 아닙니다. SWE-bench Pro(실제 소프트웨어 문제를 고치게 하는 시험)에서 51.8%로 이전 대형 모델 Nemotron 3 Ultra(49.7%)보다는 높지만, Alibaba의 Qwen3.8 Flash-Next(60.4%)에는 못 미칩니다. 터미널 명령으로 과제를 푸는 시험 Terminal-Bench 2.1에서도 Qwen3.8 Flash-Next에 60.7점 대 85.8점으로 뒤집니다. 앞서는 쪽은 속도입니다. 20턴짜리 에이전트 작업에서 NVIDIA의 데이터센터용 AI 칩 GB200의 GPU 하나가 초당 만들어 내는 토큰(글 조각) 수가 Qwen3.5 122B의 2.34배, Qwen3.8 Flash-Next의 약 1.9배라고 NVIDIA는 밝혔습니다.
Bolt의 24GB는 RTX 3090 한 장의 메모리와 같은 크기입니다. NVIDIA가 밝힌 비교에서는 Qwen3.6-35B-A3B보다 Terminal-Bench 2.1(51.0점 대 44.4점)과 웹을 뒤져 답을 찾는 BrowseComp(66.8점 대 48.7점)에서 앞섰습니다. 내 컴퓨터에서 모델을 돌리는 도구 llama.cpp용 공식 파일도 함께 나왔습니다. 다만 모델 카드의 공식 지원 목록에 RTX 3090은 없습니다.
그 밖에: Bolt 모델 카드에는 텍스트 학습 데이터 일부를 Moonshot AI의 공개 모델 Kimi K3가 만든 합성 데이터(AI가 만든 학습용 글)로 채웠다고 적혀 있습니다. 기술 보고서에 함께 실린 Lightning(300억 개 중 30억 개를 쓰는 텍스트 전용 모델)은 8월에 이미 공개된 모델입니다. 에이전트 앱 Hermes Agent를 만드는 Nous Research는 두 새 모델을 지원한다고 알리며, NVIDIA가 에이전트 성능 시험 Hermes Bench에서 Super VL을 재 63.44점이 나왔다고 전했습니다.
시사점: 가장 똑똑한 공개 모델이 아니라 빠르게 오래 돌리는 공개 모델을 노린 출시입니다. 70B대 모델을 24GB 그래픽카드 한 장에 올릴 길이 열렸지만, 수치는 전부 NVIDIA 자체 측정이라 외부 평가를 기다려야 합니다.
#NVIDIA#Nemotron#공개모델
출처 5💬 @gordic_aleksa💬 @superalesha💬 @MiaAI_lab💬 @NousResearch🔥 @Teknium
6. Claude Code 데스크톱 앱, 여러 세션을 나란히 돌리도록 개편…쉬는 동안 대화를 미리 압축하고 메뉴에서 Opus 5.5 빠른 모드도 켠다
- 데스크톱 앱 개편: Anthropic 개발자 계정 ClaudeDevs가 Claude Code 데스크톱 앱을 여러 작업 세션을 나란히 돌리기 좋게 바꿨다고 알렸습니다. 세션을 더 빨리 열고, 세션마다 지금 무엇을 하는지 늘 볼 수 있으며, Claude가 제안한 후속 작업을 한 번 눌러 새 세션으로 돌릴 수 있습니다.
- 유휴 압축: 긴 대화를 켜 둔 채 자리를 비우면, 1시간짜리 프롬프트 캐시(같은 대화를 싸게 다시 읽도록 잠시 저장해 둔 사본)가 사라지기 전에 대화를 요약해 둡니다. 돌아와서 보내는 다음 메시지는 대화 전체가 아니라 요약만 다시 읽어 사용량이 덜 듭니다.
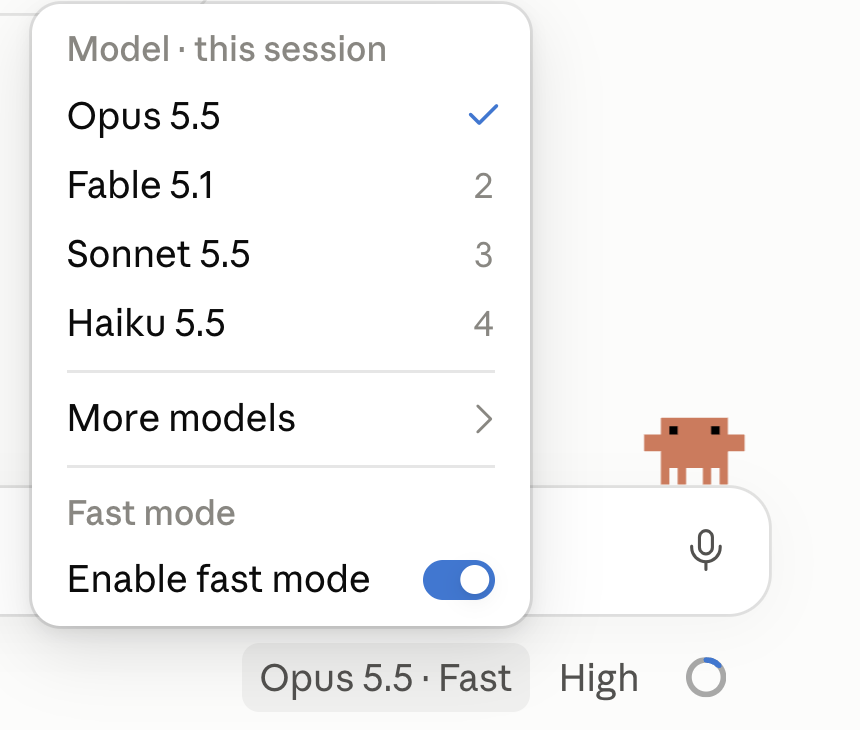
- 빠른 모드: 모델 메뉴의 'Enable fast mode' 스위치로 Opus 5.5를 빠른 모드로 돌리는 화면이 공유됐습니다. 공식 문서 기준 응답이 최대 2.5배 빨라지는 대신 토큰(AI가 글을 세는 단위)당 값이 더 비쌉니다. 구독 플랜이라면 남은 한도와 상관없이, 따로 켜 둔 사용 크레딧(기본 한도를 넘겨 쓰는 유료 충전분)에서 빠집니다.
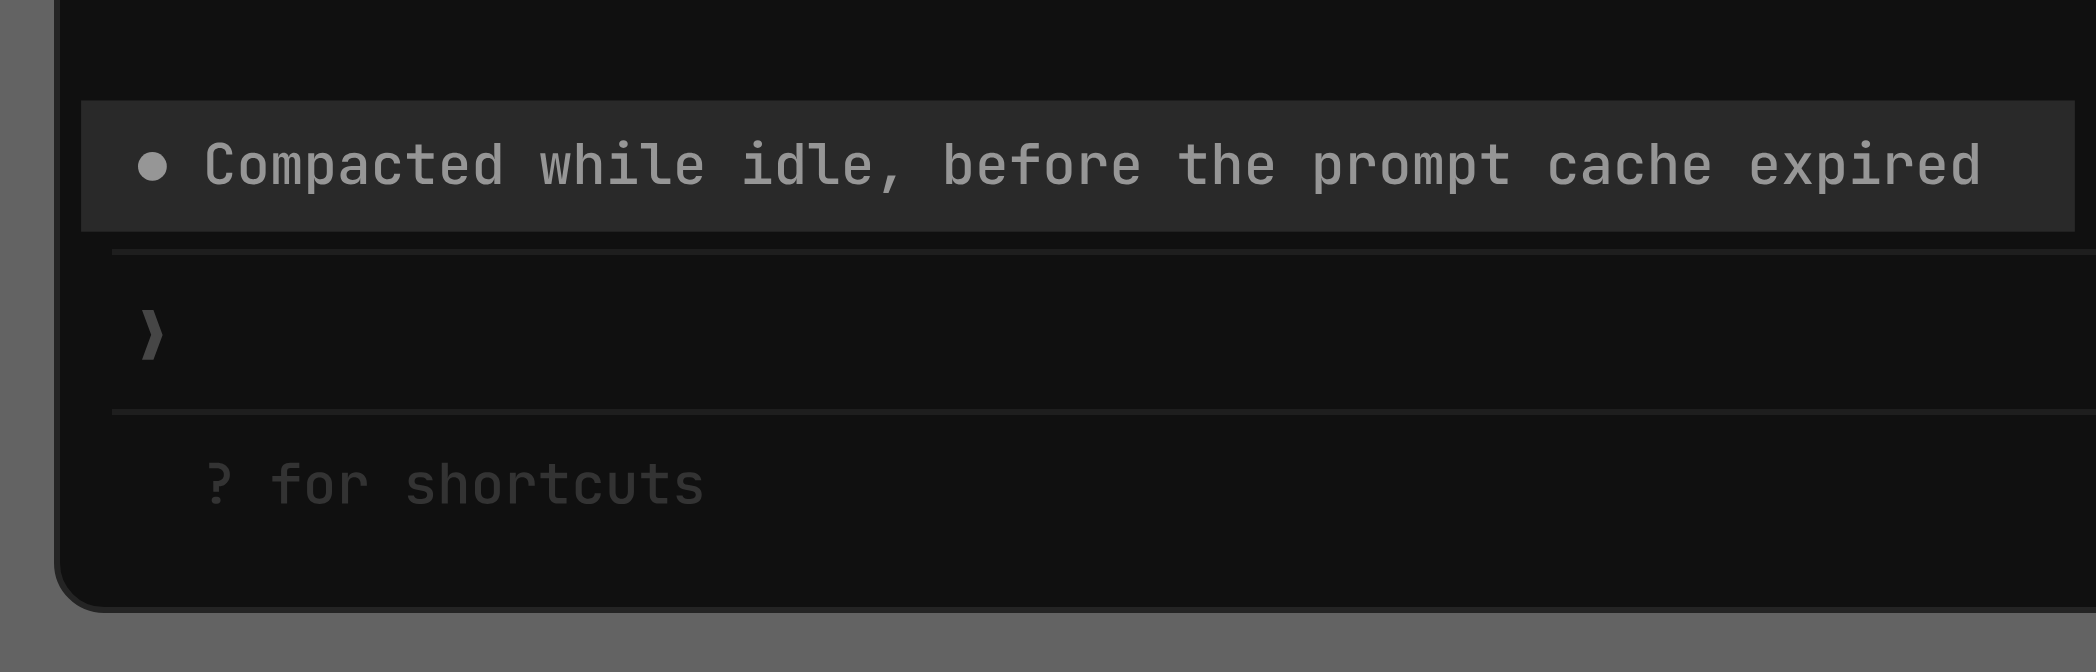
Claude Code를 여러 개 동시에 띄워 일하는 사람에게 앱 화면을 맞춘 개편입니다. /btw 명령을 쓰면 본 작업을 멈추지 않고 곁가지 질문을 별도 탭에서 물을 수 있습니다. 유휴 압축은 사용 한도를 아끼는 장치입니다. 공식 변경 기록(10월 14일, 버전 2.1.299)에 따르면 터미널에서 20만 토큰 넘게 쌓인 대화를 약 54분 그대로 두면 자동으로 압축되고, 원치 않으면 설정에서 끌 수 있습니다. 그전에는 한 시간 넘게 쉬다 돌아오면 캐시가 사라져, 긴 대화 전체를 다시 읽는 값을 치러야 했습니다.
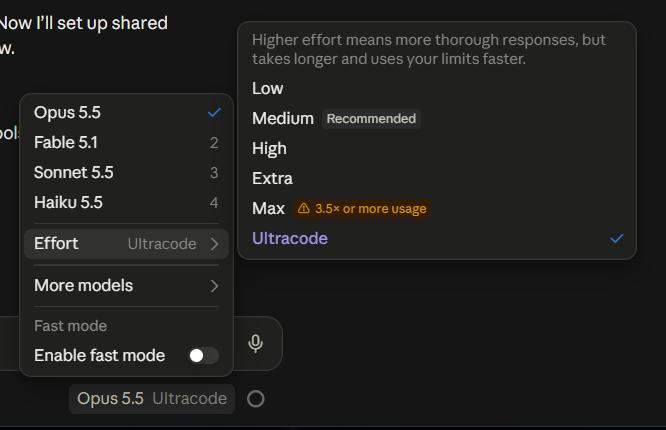
그 밖에: 강도 메뉴 맨 끝의 Ultracode는 공식 문서상 강도 단계가 아니라 별도 설정입니다. 켜 두면 큰 작업에서 Claude가 여러 단계의 작업 흐름을 스스로 짜서 돌립니다. 'Opus가 계획을 짜고 값싼 모델들이 실행한다'는 풀이는 Anthropic이 아닌 제3자 게시물의 설명인데, 북마크가 4,180회였습니다.
시사점: 자리를 비운 사이 긴 대화가 사용량을 갉아먹는 일을 Claude Code가 스스로 줄여 줍니다. 반대로 빠른 모드와 Max 강도는 한도나 크레딧을 빨리 쓰는 쪽이라, 켜기 전에 비용이 어디서 빠지는지 확인하는 편이 좋습니다.
#ClaudeCode#Opus55#사용한도
출처 6🔥 @LexnLin🔥 @morganlinton🔥 @masahirochaen💬 @lydiahallie💬 @kimmonismus🔖 @thedelost
7. Anthropic 3분기 매출 168억 달러…Bloomberg "투자자 설명회서 영업이익·현금흐름 흑자"
- Bloomberg 보도에 따르면 Anthropic은 10월 14일(현지) 잠재 투자자 설명회에서 3분기 매출 168억 달러를 제시했습니다. 8월 보도된 2분기 매출(115억 달러 이상)보다 40% 넘게 많습니다.
- 같은 보도에서 조정 매출총이익률(매출에서 모델을 돌리는 원가를 빼고 남는 비율)은 85%, 조정 영업이익률은 11% 이상이었고 잉여현금흐름(쓰고 남은 현금)도 흑자였습니다.
- '조정' 수치는 주식 보상 같은 비용을 뺀 회사 기준이라 일반 회계 기준의 이익과는 다릅니다.
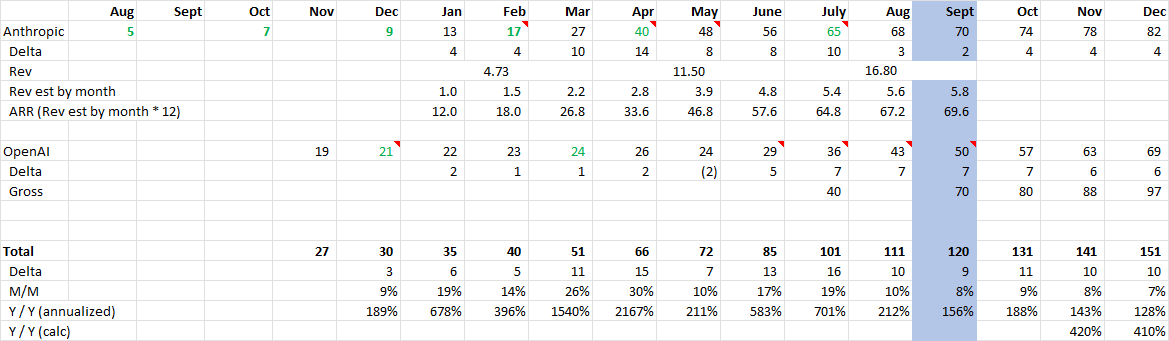
이번 숫자는 Anthropic이 상장(IPO, 주식시장 공개)을 앞두고 잠재 투자자에게 보여 준 3분기 실적입니다. 8월에 알려진 2분기에 이어 조정 기준 흑자가 두 분기 연속 이어졌다는 뜻이기도 합니다. 다만 공개 문서가 아니라 비공개 설명회 내용을 옮긴 보도이고, 매출을 어떤 기준으로 셌는지 같은 세부는 알려지지 않았습니다.
그 밖에: 투자 계정 TechFundies는 직접 만든 추정 표를 근거로 9월 연환산 매출(ARR, 월 매출×12)의 증가폭이 올해 가장 작았다며 성장 둔화를 주장했습니다. 반면 Tech Fund는 8월은 휴가철이었고 9월엔 OpenAI가 새 모델 GPT-6 Astra를 내놓아 사람들이 써 보려고 지출을 옮겼을 뿐이라고 반박했습니다.
시사점: 매출이 한 분기 만에 절반 가까이 늘고 조정 기준 이익까지 났다는 보도는 비싼 최상위 모델도 남는 장사가 될 수 있다는 신호입니다. 월별 성장 속도를 두고는 해석이 갈리므로, 상장 서류가 공개되면 회계 기준 수치로 다시 확인해야 합니다.
#Anthropic#실적#IPO
출처 3💬 @EdLudlow🔥 @TechFundies🚀 @techfund1
8. 🆕 그 밖의 신기능·신제품 — Kling 4.0·Krea 3·Goodfire 해석가능성 연구·Perplexity SPACE·Google Deep Review·Claude로 만든 무료 Office 대안
- Kling 4.0 정식 공개 — 영상 생성 모델 Kling 4.0을 이제 누구나 씁니다. 새 제작 화면 외에 MCP(AI 비서가 외부 도구를 불러 쓰는 연결 규격)와 명령줄로도 부를 수 있고, 4K HDR 출력과 기업용 API는 곧 나올 예정입니다.
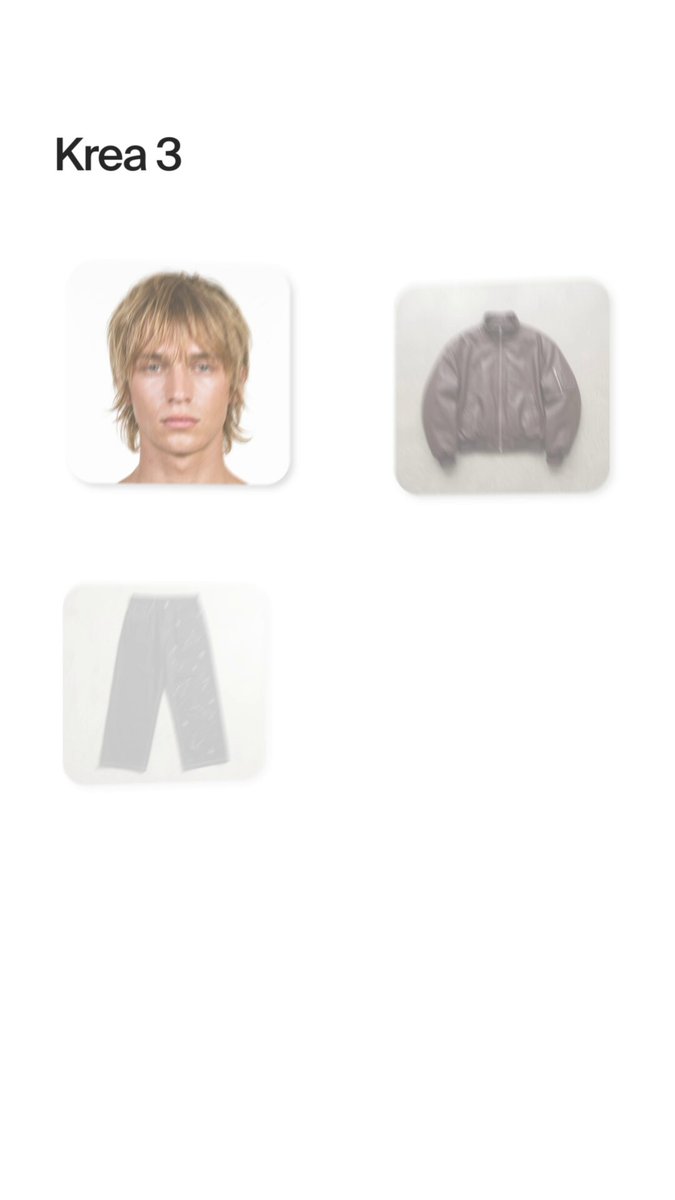
- Krea 3 베타 — 이미지 편집에 맞춘 모델로, 2K 편집을 8초 안에 끝낸다고 합니다. Krea는 품질이 Google Nano Banana Pro와 맞먹는다고 밝혔고, 사용자들은 4배 빠르고 비용은 4분의 1이라고 전했습니다.
- Google Deep Review 전 세계 공개 — 논문·설계 문서·제안서를 내기 전에 허점을 찾아 주는 에이전트입니다. 학회 파일럿에서 원고 1만 5천 편 넘게 검토했고, 주 2회까지 무료입니다.
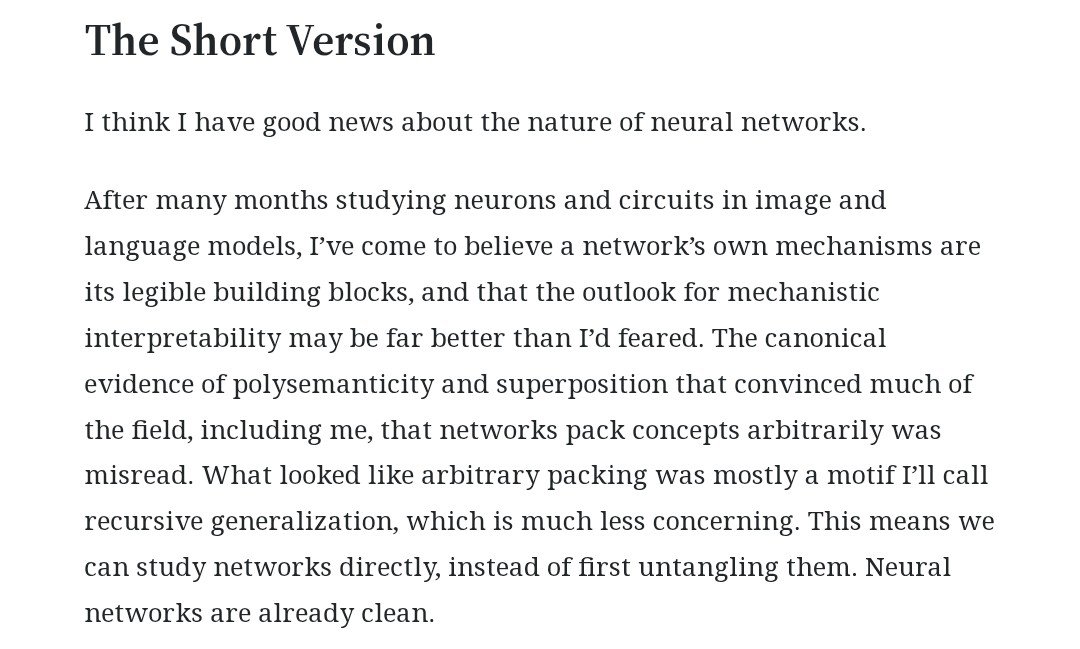
반응이 뜨거웠던 건 제품이 아닌 글 한 편입니다. Goodfire(AI 내부를 들여다보는 해석가능성 연구 회사)의 Nick Cammarata는 OpenAI 시절 '뉴런 하나가 여러 개념을 뒤섞어 담는다'는 초기 연구를 함께 쓴 사람입니다. 그는 몇 달간 이미지·언어 모델을 다시 살펴본 끝에, 그 뒤섞임 대부분이 무작위가 아니라 규칙적인 패턴이었다고 적었습니다. 신경망을 먼저 풀어헤치지 않고도 바로 연구할 수 있다고 봅니다. 아직 연구자 본인의 에세이이고 검증은 이제부터지만, AI 속을 읽을 수 있다는 기대에 Tenobrus는 '올해 본 최고의 소식'이라고 반응했습니다.
그 밖에: Perplexity CEO Aravind Srinivas는 에이전트 Computer를 돌리는 격리 실행 공간(샌드박스) 플랫폼 SPACE를 오픈소스로 공개한다고 밝혔습니다. Tom's Hardware 보도에 따르면 개발자 Brandon Thomas는 Claude로 만든 Word·Excel·PowerPoint 대체 앱 WordCraft·GridCraft·DeckCraft를 GitHub에 무료로 올렸는데, 아직 알파 이전 단계입니다.
시사점: Kling은 사람이 쓰는 화면과 함께 AI 비서가 직접 부르는 통로까지 열었습니다. 다만 Krea의 속도·가격과 Cammarata의 낙관은 아직 회사와 연구자 본인의 주장이니, 외부 검증을 기다려 볼 만합니다.
#Kling4#해석가능성#DeepReview
출처 9🚀 @Kling_ai💬 @egeberkina💬 @synthwavedd🔥 @GoodfireAI🔥 @AndrewCurran_🔥 @tenobrus💬 @AravSrinivas🔥 @NewsFromGoogle🔖 @unusual_whales
오늘의 감정·온도
오늘의 실무 팁 — 쉽게 풀어 쓴 사용법 6가지
1. 결과물을 맡기기 전에 목적부터 다시 묻게 합니다 Claude를 만드는 엔지니어링 리드 Felix Rieseberg는 「How to be more ambitious」에서 보고용 PPT를 만들게 하는 데서 멈추지 말고, 경영진이 논의할 결정 세 가지를 찾게 하거나 더 나은 보고 방식을 설계하게 해 보라고 권했습니다. 한 사용자가 정리한 요약에 따르면 그는 결과를 반드시 바깥에서 검증하고 모델이 스스로 점수를 매기게 두지 말라고 강조했으니, 새 방식은 기존 방식과 나란히 돌려 비교해 보세요.
2. 아이디어는 AI에게 질문을 받으며 다듬습니다 Emil Kowalski는 Matt가 만든 /grill-me처럼 질문을 많이 던지는 스킬(에이전트에게 주는 작업 설명서)이 구체적인 답을 내놓게 만들어 생각을 또렷하게 해 준다며, AI의 가장 좋은 쓰임새 중 하나로 꼽았습니다. 좋아하는 제품이나 창업자 인터뷰를 함께 넣어 내 관점이 담긴 질문 스킬을 만들어 보라는 제안도 덧붙였습니다.
3. 에이전트에게 비밀번호를 채팅으로 붙여 넣지 않습니다 Hermes Agent 소식을 전하는 계정 HermesWatcher에 따르면, 이 에이전트는 로그인 화면을 만나면 가려진 입력창으로 비밀번호를 따로 받아 암호화한 저장소에 두고 웹사이트에 바로 채웁니다. 1Password·Bitwarden 같은 비밀번호 관리 앱의 저장값도 쓸 수 있고 카드 정보를 채우기 전엔 승인을 받는다고 하니, 어떤 에이전트를 쓰든 비밀번호를 대화창에 그대로 적지 않는 습관을 들이세요.
4. 내 전화번호가 올라간 사이트 정리를 맡겨 봅니다 MinimalDuck은 스팸 전화에 지쳐 Grok Bot(SpaceXSI의 AI 에이전트)에게 자기 번호가 올라간 사이트를 찾아 삭제 요청을 넣게 했고, 그 과정을 누구나 쓸 수 있는 무료 스킬로 만들어 공개했습니다. 개인이 만든 스킬이니 에이전트가 어느 사이트에 무엇을 제출하는지 확인하며 쓰세요.
5. 홍보 영상은 랜딩 페이지 주소만 주고 코드로 만들게 합니다 twoclipping이 공유한 프롬프트를 쓰면 Claude가 먼저 랜딩 페이지(제품을 소개하는 첫 화면) 주소와 브랜드 이름·로고를 묻고, 그 페이지 위를 카메라가 훑고 지나가는 14.5초짜리 3D 영상을 만듭니다. 영상 편집 도구 대신 코드로 그려 내는 방식이라 따로 돈을 들이지 않고 해 볼 수 있다고 그는 적었습니다.
6. 따라 만들 땐 공개된 시작 프롬프트부터 읽어 봅니다 Samnang Aing은 스크롤할 때마다 평면도가 3D 집으로 바뀌는 페이지를 Claude Opus 5.5로 만들었고, 이 페이지는 Threads와 LinkedIn에서 하룻밤 사이 6만 회 넘게 조회됐습니다. 그는 만든 과정을 8분짜리 영상으로 정리하며 마법 같은 프롬프트는 없다고 했고 시작 프롬프트와 코드 저장소도 공개했으니, 결과물만 보지 말고 첫 지시가 어떻게 생겼는지부터 살펴보세요.
출처 7🔖 @cgtwts🔖 @sleepy0x13🔥 @emilkowalski🔥 @HermesWatcher💬 @MinimalDuck🔖 @twoclipping🔥 @SammmAing
📦 확인 방식
MAI-Base-2의 수치는 Microsoft AI 기술 블로그에서, Muse Spark Open의 사양과 라이선스는 Hugging Face 모델 카드에서, Gemini 4 Argon의 점수는 ARC Prize 공식 발표에서 가져왔습니다. Anthropic 3분기 실적은 비공개 설명회를 옮긴 Bloomberg 보도이고, 각 회사가 직접 잰 벤치마크와 Krea 3의 속도·가격은 외부 독립 검증 전입니다.
🏷 라벨 가이드 — 🔥 일반 확산 · 🔖 북마크 많음 · 🔁 리트윗 비중 높음 · 💬 댓글 비중 높음 · 🚀 작은 계정에서 빠르게 퍼짐