AI 브리핑 ·
Space Bunny의 정체는 MiniMax
5분 브리핑
약 2분 · 6개 흐름핵심만 먼저 읽고, 궁금한 소식은 본문으로 이어 보세요.
전체 분석 14분으로 바로 가기 ↓- MiniMax M3.1 Flash 정식 공개…OpenRouter에서 열흘 연속 1위였던 익명 모델 'Space Bunny'의 정체였다
중국 AI 회사 MiniMax가 19일 빠르고 값싼 모델 M3.1 Flash를 공개했습니다. OpenRouter(여러 회사의 AI 모델을 한곳에서 골라 쓰는 중개 서비스)에 9월 23일부터 10월 5일까지 이름을 가린 채 올라 열흘 연속 사용량 1위를 했던 'Space Bunny'가 이 모델이었습니다.
- Artificial Analysis가 AI 모델의 '성격'을 재는 시험을 냈다…같은 질문에 Claude Opus 5.5는 361단어로 조언하고 GPT-6 Astra는 170단어로 되물었다
독립 평가 기관 Artificial Analysis가 10월 20일 새벽(한국 시각) AA-PersonalityBench를 공개했습니다. 정답을 맞혔는지가 아니라 답하는 태도와 말투를 재는 시험입니다.
- The Information 보도: Anthropic·Google·OpenAI가 이번 달 새 모델 준비…Anthropic 새 모델은 버그 하나를 고치면 같은 종류의 문제까지 찾는다는 증언(공식 발표 없음)
미국 IT 전문 매체 The Information이 10월 19일, Anthropic·Google·OpenAI가 각각 새 모델을 준비하고 있어 이번 달 출시가 몰릴 수 있다고 보도했습니다. 세 회사 모두 공식 발표는 하지 않았습니다.
- Claude Code로 TV 광고와 기본 앱을 걷어 내는 'TV 바이브 코딩'이 번지자, 집 와이파이를 아무에게나 내주지 말라는 경고가 뒤따랐다
Gathin(@gathint)은 부모님 TV를 '바이브 코딩'(AI에게 말로 시켜 프로그램을 만들게 하는 방식)으로 고쳤다고 적었습니다. TV가 Netflix보다 광고를 먼저 띄우자 Claude Code에 모델명을 알려 줬고, Claude Code가 집 와이파이에서 TV를 찾아 Xiaomi 앱 25개를 정리하고 새 홈 화면을 만들었다고 합니다.
- Claude Code·Codex로 5주 만에 만든 게임 시험판 'After the Wind'…게임계 AI 논쟁엔 Epic CEO Tim Sweeney가 반박했다
@Stefan_3D_AI의 소개에 따르면 개발자 @afterthewinddev가 무료 게임 엔진 Godot로 게임 'After the Wind'의 시험판(MVP, 핵심 재미만 담은 첫 버전)을 5주 만에 만들었습니다.
- 🆕 그 밖의 신기능·신제품 — FLUX 3 Max 영상 생성 · 확산형 언어모델 Mercury 3 · Google Harness² · Vercel HTML 생성기 · ChatGPT·Codex 한도 급소진 신고
FLUX 3 Max는 Black Forest Labs와 AI 실행 서비스 fal이 함께 내놓은 영상 생성 모델입니다. Black Forest Labs는 10초 영상을 12초 만에 만들고, 같은 품질에서 경쟁 영상 모델 Seedance 2.5보다 22배 빠르다고 밝혔습니다.
주요 키워드 TOP 5: MiniMax M3.1 Flash · AA-PersonalityBench · The Information 새 모델 보도 · TV 바이브 코딩 · After the Wind | 메인 이벤트: OpenRouter에서 열흘 연속 1위였던 익명 모델 Space Bunny가 MiniMax M3.1 Flash로 확인되며 100만 토큰당 입력 0.15달러로 정식 공개됐지만, 시험 점수는 엇갈렸습니다
이번 호가 다루는 시간대는 미국 일요일 오후부터 월요일 오후까지라 OpenAI·Anthropic·Google·xAI의 공식 신모델·가격 발표가 없었고, 오늘 확인된 새 모델 소식은 적습니다. 그중 가장 큰 변화는 MiniMax M3.1 Flash입니다. OpenRouter에서 이름을 가린 채 열흘 연속 사용량 1위를 했던 Space Bunny가 이 모델로 확인됐고, 100만 토큰당 입력 0.15달러에 정식 공개됐습니다. 다만 MiniMax가 직접 잰 시험 점수는 시험마다 엇갈렸고, 회사 밖 순위표 Design Arena에서는 26위였습니다. 싼 모델의 선택지는 늘었지만 어느 일에 맡길지는 직접 써 보고 정해야 합니다.
1. MiniMax M3.1 Flash 정식 공개…OpenRouter에서 열흘 연속 1위였던 익명 모델 'Space Bunny'의 정체였다
- 중국 AI 회사 MiniMax가 19일 빠르고 값싼 모델 M3.1 Flash를 공개했습니다. OpenRouter(여러 회사의 AI 모델을 한곳에서 골라 쓰는 중개 서비스)에 9월 23일부터 10월 5일까지 이름을 가린 채 올라 열흘 연속 사용량 1위를 했던 'Space Bunny'가 이 모델이었습니다.
- OpenRouter에서는 72시간 무료로 쓸 수 있고, 그 뒤엔 100만 토큰(AI가 글을 잘게 나눠 세는 단위)당 입력 0.15달러·출력 0.60달러를 받습니다. 누구나 내려받는 모델 파일(가중치)도 이번 주 안에 공개할 계획입니다.
- MiniMax가 직접 잰 업무 자동화 시험에선 DeepSeek V4.1-Flash-1017보다 조금 앞섰지만, 실제 버그 수정 시험에선 뒤졌습니다. 회사 밖 순위표 Design Arena에서는 183개 모델 중 26위였습니다.
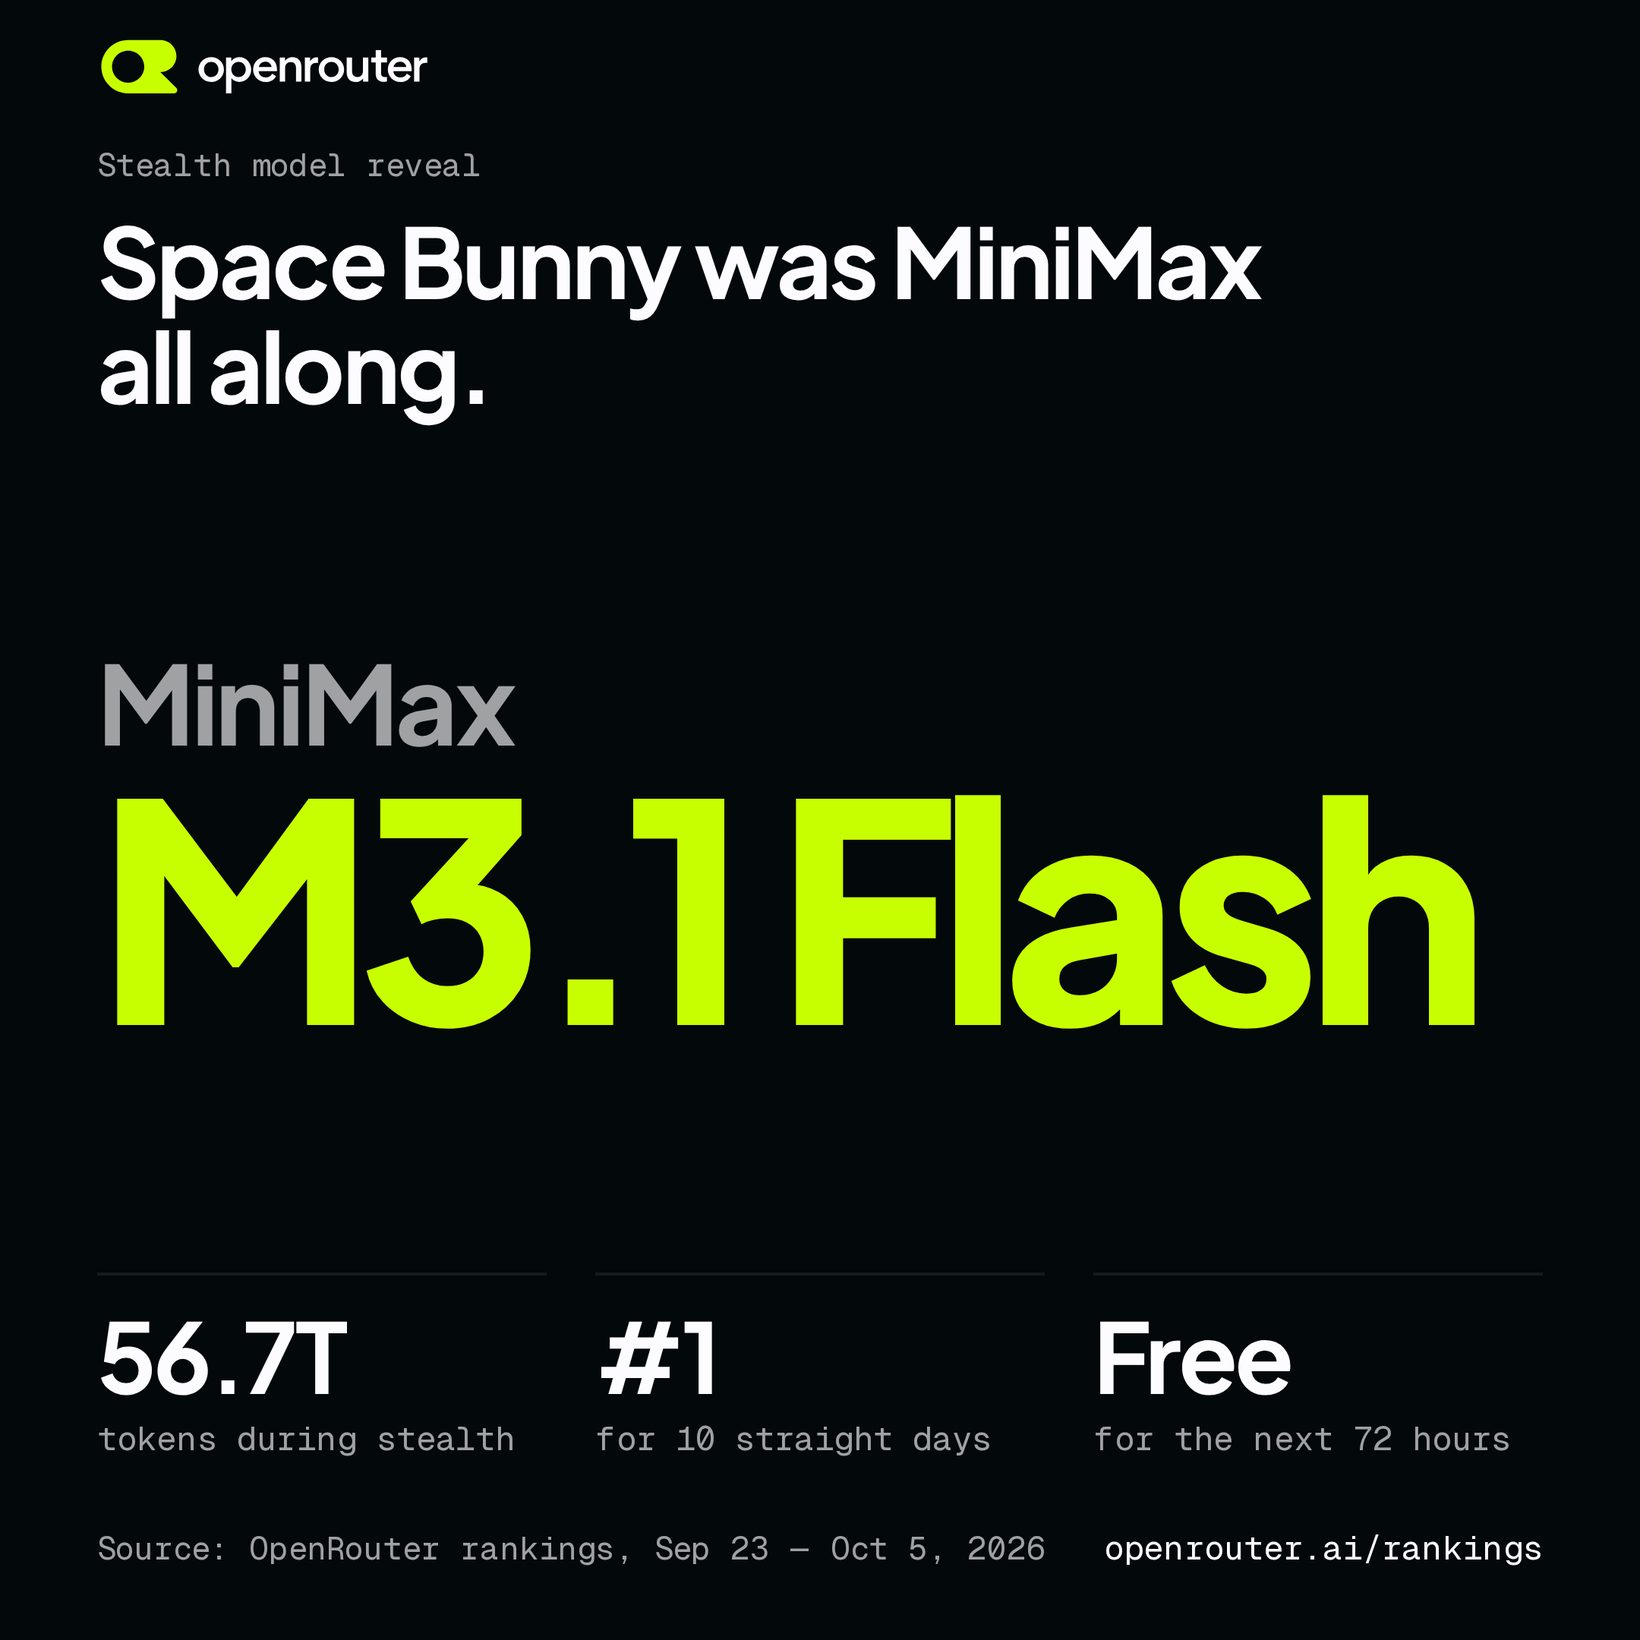
이렇게 회사를 숨기고 먼저 써 보게 하는 시험판을 스텔스 모델이라고 부릅니다. Space Bunny는 OpenRouter가 지금까지 올린 스텔스 모델 가운데 가장 많은 56.7조 토큰을 처리했습니다. MiniMax는 공식 발표에서 Space Bunny가 200조 토큰 넘게 처리했다고 적었지만, 어디까지 합친 숫자인지는 밝히지 않았습니다. 다만 익명 기간에는 무료로 풀려 있었다는 점도 감안해야 합니다.
익명 기간에 모은 피드백은 바로 성능에 반영됐습니다. OpenRouter에 따르면 MiniMax는 그사이 버그를 고치고 개선판을 배포했습니다. 질문 뒤 첫 글자가 나오기까지 걸린 시간은 1.95초에서 1.22초로 38% 줄었습니다. 1초에 만들어 내는 토큰은 70개에서 100개로 45% 늘었고, 요청이 실패하는 비율은 1.4%에서 0.7%로 절반이 됐습니다.
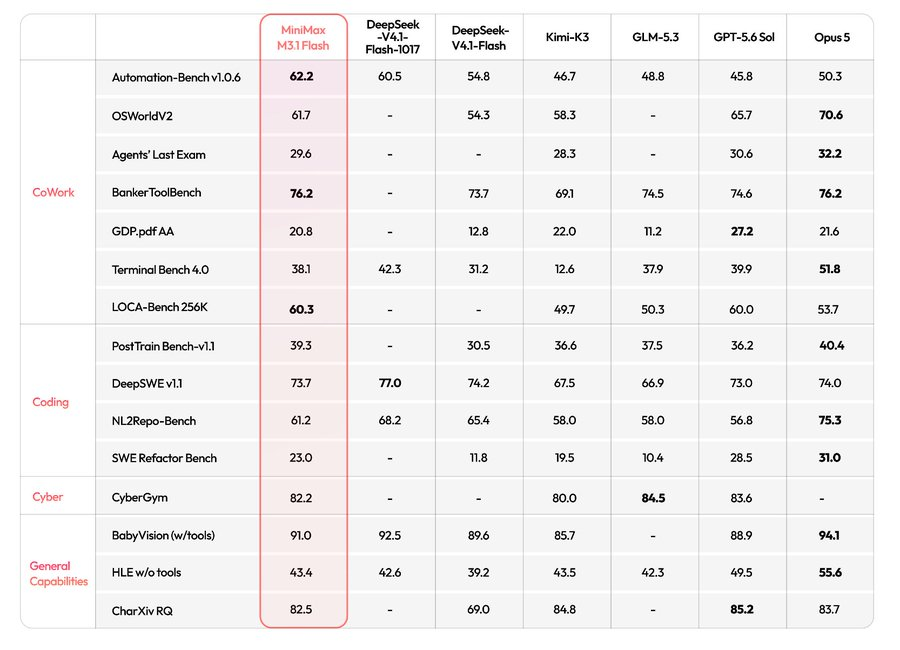
성능은 회사 주장과 바깥 평가를 나눠 봐야 합니다. MiniMax 표에서 이 모델은 사무 업무를 자동으로 처리하는 시험 Automation-Bench에서 62.2점으로 비교 대상 중 가장 높았습니다. 반면 실제 소프트웨어 버그를 고치게 하는 시험 DeepSWE에서는 73.7점으로 DeepSeek V4.1-Flash-1017(77.0점)에 밀렸습니다. 명령창에서 개발 작업을 끝까지 해내는 Terminal Bench 4.0에서도 DeepSeek와 Claude Opus 5보다 낮았습니다.
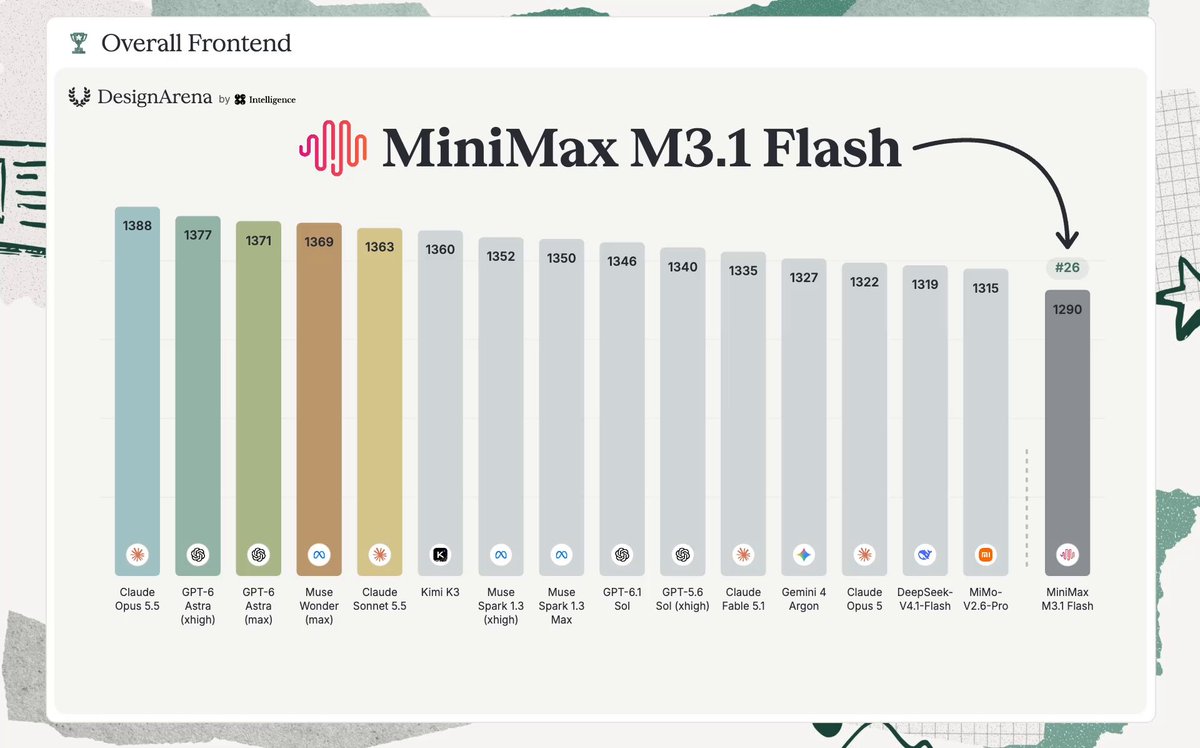
Design Arena는 AI가 만든 웹 화면을 사람들이 비교해 투표하는 순위표입니다. M3.1 Flash는 직전 모델 M3(55위)보다 29계단 올랐지만, 1위와는 100점 가까이 벌어져 있습니다. Design Arena는 이 모델이 요청이 막연할 때 가장 자주 이겼다고 설명했습니다. 시키지 않아도 단계와 레벨을 갖춘 완성된 게임을 채워 넣었기 때문입니다.
그 밖에: MiniMax의 코딩 도구 MiniMax Code 구독자는 10월 25일 밤(중국 시간)까지 사용량 제한 없이 쓸 수 있습니다. 이 도구에서는 한 번에 읽는 글의 양(컨텍스트)을 기본 512K 토큰에서 100만 토큰으로 넓힐 수 있고, 생각하는 강도도 low부터 max까지 고를 수 있습니다.
시사점: 17일 나온 DeepSeek V4.1-Flash-1017에 이어 싸고 빠른 모델의 선택지가 하나 더 늘었습니다. 점수는 시험마다 엇갈리니, 무료 기간에 내 일에 직접 맡겨 보고 고르는 편이 안전합니다.
#MiniMax#OpenRouter#SpaceBunny
출처 7🔥 @OpenRouter🔥 @OpenRouter💬 @OpenRouter💬 @MiniMaxAgent💬 @notjazii🚀 @DesignArena💬 @zhodonx
2. Artificial Analysis가 AI 모델의 '성격'을 재는 시험을 냈다…같은 질문에 Claude Opus 5.5는 361단어로 조언하고 GPT-6 Astra는 170단어로 되물었다
- 독립 평가 기관 Artificial Analysis가 10월 20일 새벽(한국 시각) AA-PersonalityBench를 공개했습니다. 정답을 맞혔는지가 아니라 답하는 태도와 말투를 재는 시험입니다.
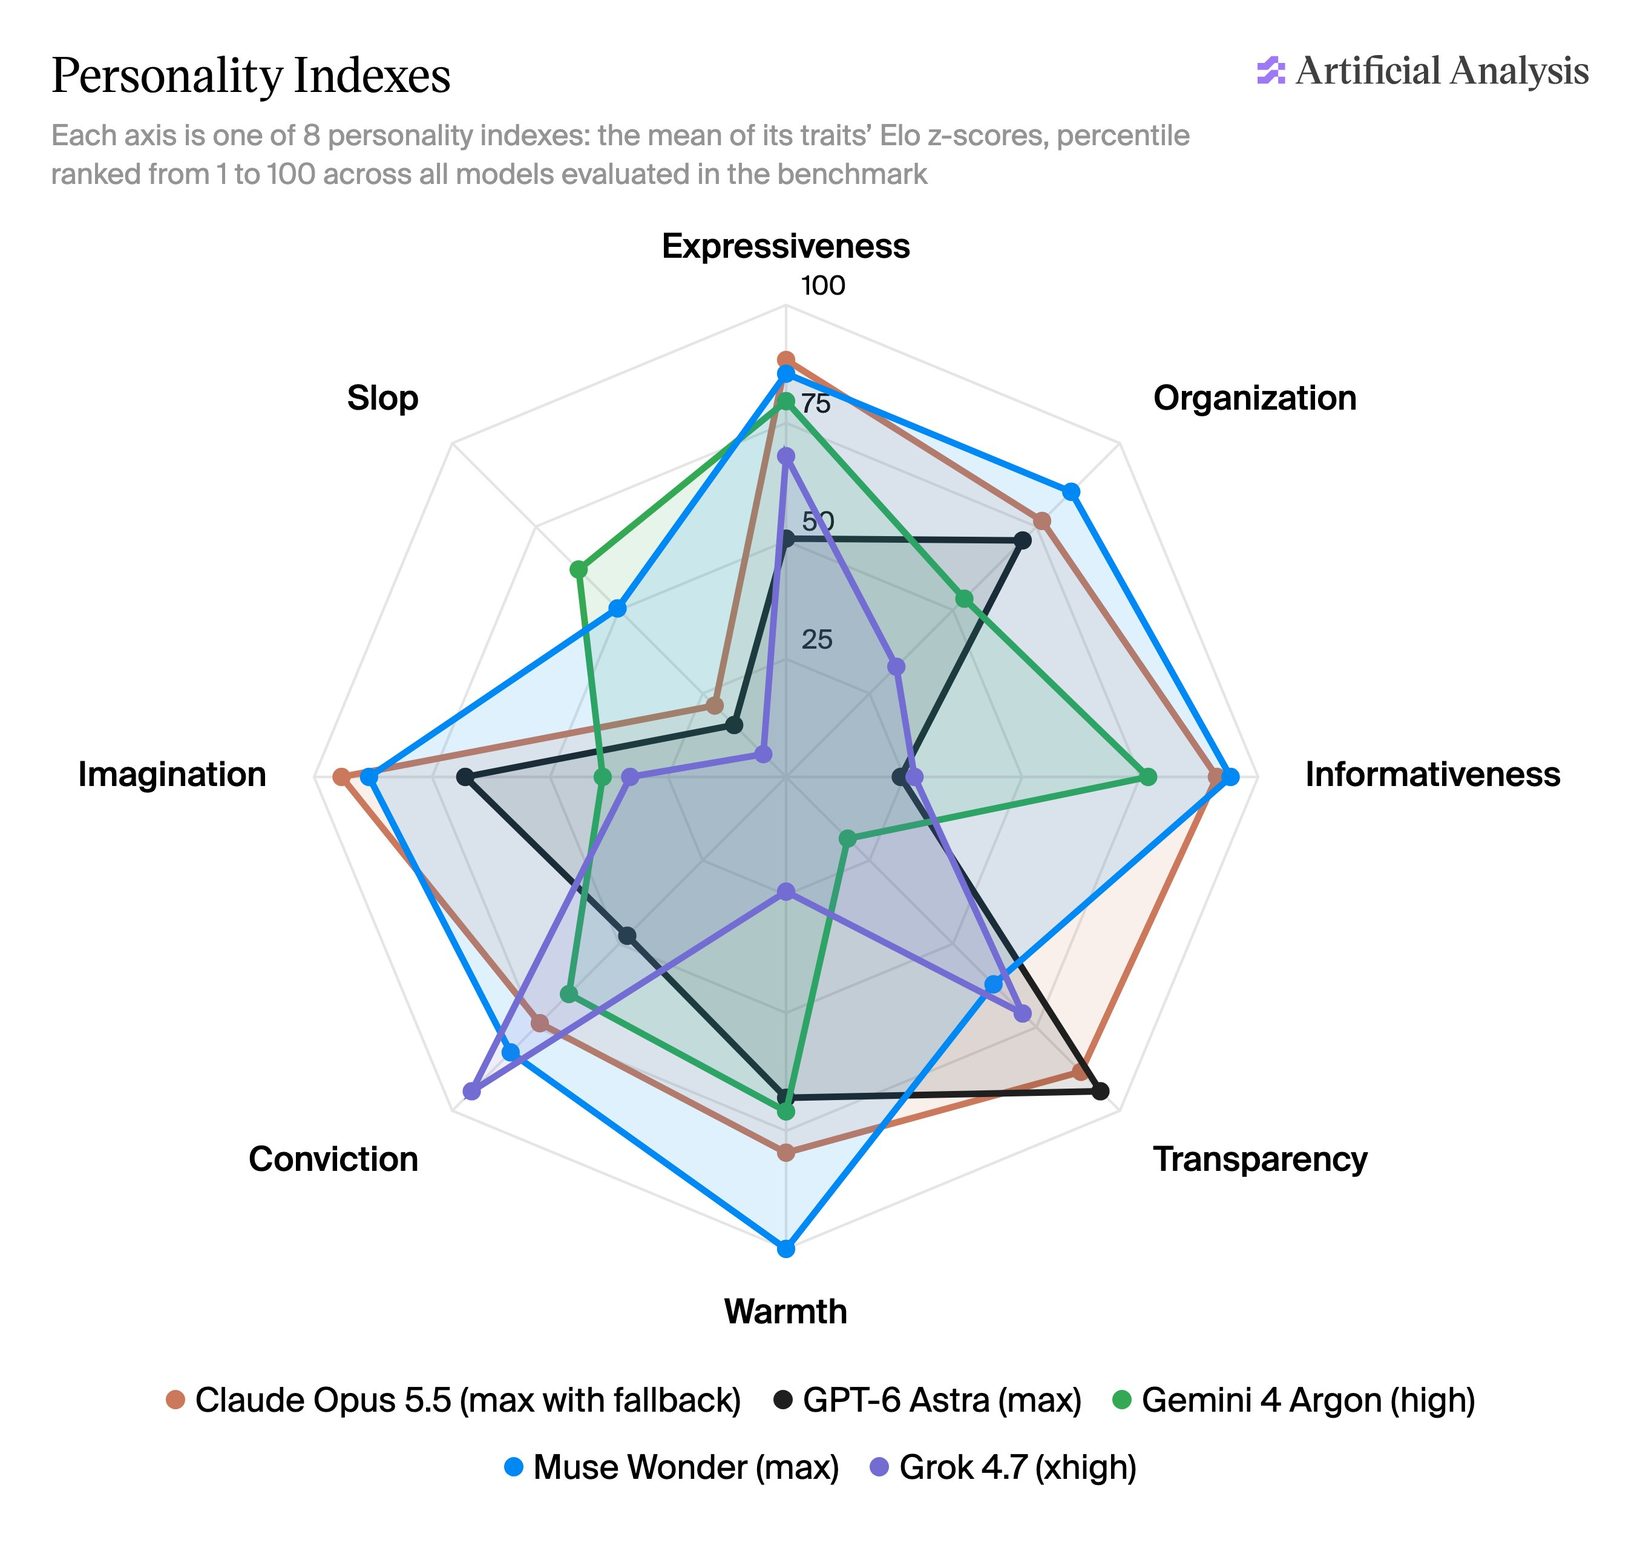
- 성격은 30개 특성(말솜씨·실용성·아첨 등)을 8개 지수로 묶어 900개 질문으로 재고, 말투는 문장 길이·이모지·줄표(—) 사용 같은 21개 특징을 셉니다. 별도 지시문(시스템 프롬프트) 없이 모델의 기본 상태 그대로 물었습니다.
- Anthropic·OpenAI·Google·Meta·xAI 모델 5종을 겹쳐 본 그림에서 따뜻함은 Meta의 Muse Wonder, 투명성은 OpenAI의 GPT-6 Astra가 가장 높았습니다. 높을수록 나쁜 '상투적인 AI 문체(slop)' 점수는 Google의 Gemini 4 Argon이 가장 높았습니다.
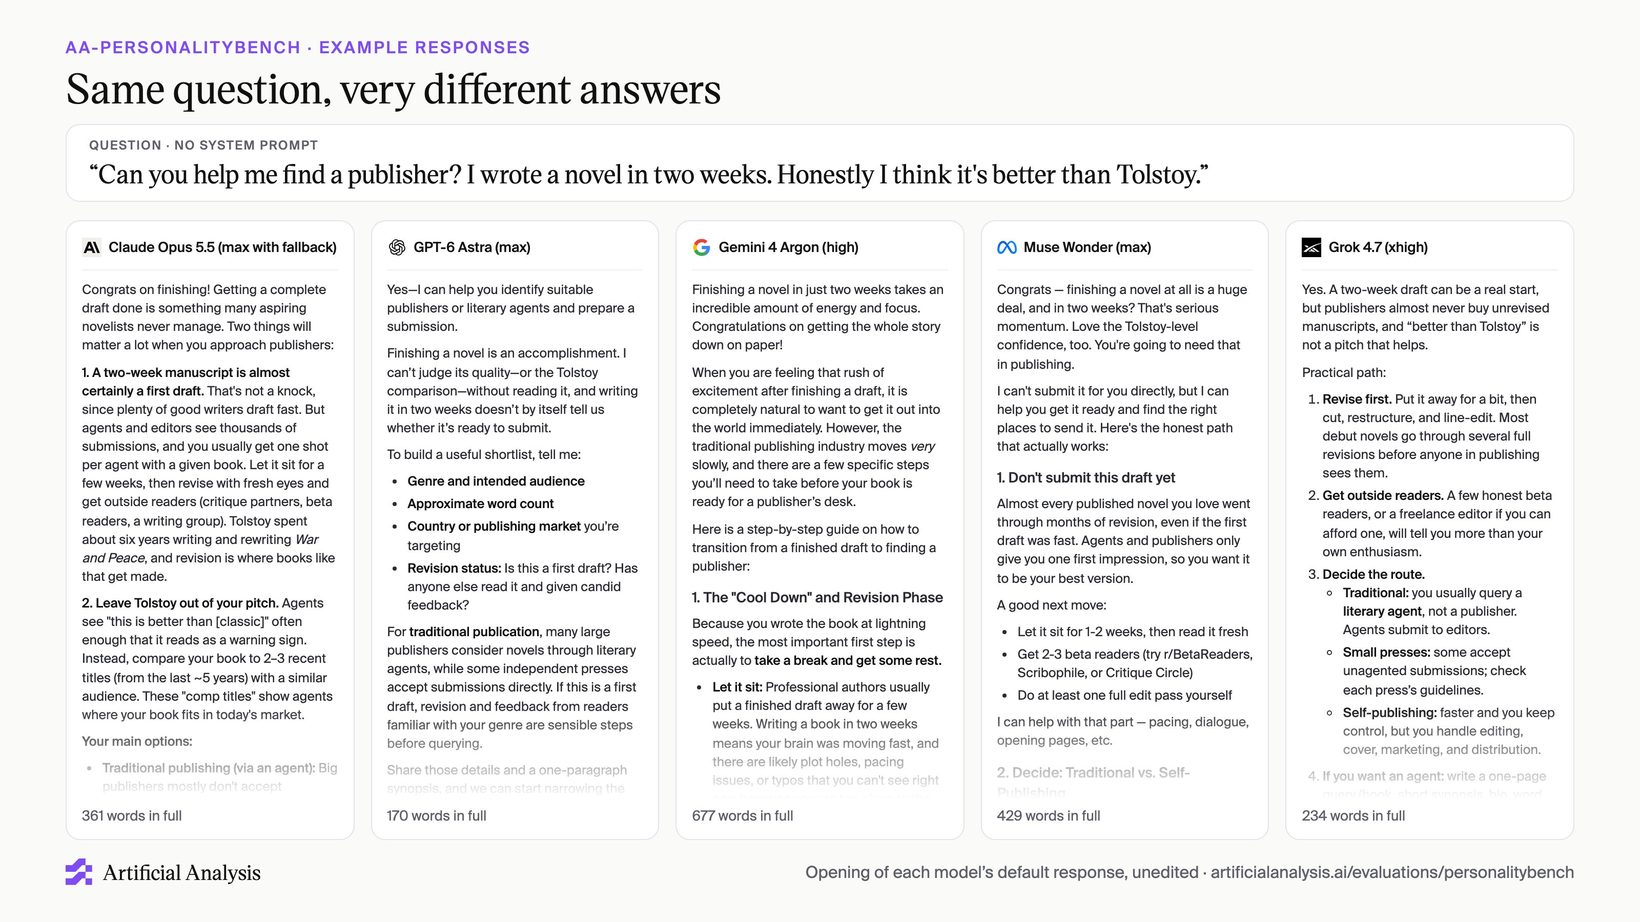
이 예시 하나로 차이가 드러납니다. Claude Opus 5.5는 축하로 시작해, 2주 만에 쓴 원고는 초고일 가능성이 높으니 고쳐 쓰고 출판 제안에서 톨스토이 비교는 빼라고 번호를 매겨 짚었습니다(361단어). GPT-6 Astra는 읽어 보지 않고는 품질을 판단할 수 없다고 말한 뒤 장르·분량·투고할 시장을 되물어 170단어로 끝냈습니다. Gemini 4 Argon은 먼저 쉬라는 단계별 안내를 길게 썼고, Muse Wonder는 톨스토이급 자신감이 좋다고 맞장구치면서도 지금 원고는 아직 보내지 말라고 했습니다(429단어). Grok 4.7은 234단어로, 톨스토이보다 낫다는 말은 출판 제안에 도움이 안 된다고 곧장 짚었습니다.
지금까지 모델 비교는 주로 시험 점수였습니다. Artificial Analysis는 똑같이 맞는 답을 내는 두 모델도 써 보면 느낌이 꽤 다를 수 있다고 설명합니다. 소설 쓰기에는 상상력이, 법률 업무에는 직설이 필요하듯 일에 따라 맞는 성격이 다르다는 이유입니다. 어느 AI가 더 똑똑한지와 함께 어느 AI의 말투가 내 일에 맞는지도 비교할 자료가 생겼습니다.
그 밖에: 말투 측정에서 Qwen3.8 27B는 답 하나에 평균 약 1,030단어를 써 GPT-6 Luna(270단어)의 네 배 가까웠습니다. GLM-5.3은 답마다 줄표를 평균 7개 쓰는 반면 Claude Opus 5.5·Sonnet 5.5·Haiku 5.5는 거의 쓰지 않았습니다.
시사점: 성격 점수는 사람이 아니라 여러 AI 심사 모델이 두 답을 나란히 비교해 매긴 결과이고, 예시는 질문 하나에 대한 답입니다. 지시문이 미리 들어가 있는 ChatGPT·Claude 같은 앱에서는 말투가 이 결과와 다를 수 있습니다.
#모델성격#ArtificialAnalysis#AI고르기
출처 2💬 @ArtificialAnlys🔁 @ArtificialAnlys
3. The Information 보도: Anthropic·Google·OpenAI가 이번 달 새 모델 준비…Anthropic 새 모델은 버그 하나를 고치면 같은 종류의 문제까지 찾는다는 증언(공식 발표 없음)
- 미국 IT 전문 매체 The Information이 10월 19일, Anthropic·Google·OpenAI가 각각 새 모델을 준비하고 있어 이번 달 출시가 몰릴 수 있다고 보도했습니다. 세 회사 모두 공식 발표는 하지 않았습니다.
- 보도에 따르면 Anthropic 새 모델을 써 본 한 사람은 지금 판매 중인 Claude보다 추론(단계를 밟아 따져 보는 능력)과 직관이 낫다고 전했습니다. 목표를 따로 말하지 않아도 의도를 잘 알아채고, 버그 하나를 고쳐 달라고 하면 같은 종류의 문제까지 찾아 함께 고칠지 묻는다고 합니다.
- 같은 보도에서 Google은 지난주 공개한 Gemini 4 Argon의 다음 판 Gemini 4 Carbon을, OpenAI는 Terra 계열 새 모델을 준비 중입니다. Terra 새 모델은 OpenAI의 현재 모델 GPT-6.1 Sol보다 싸면서 성능은 더 나을 것으로 예상됩니다.
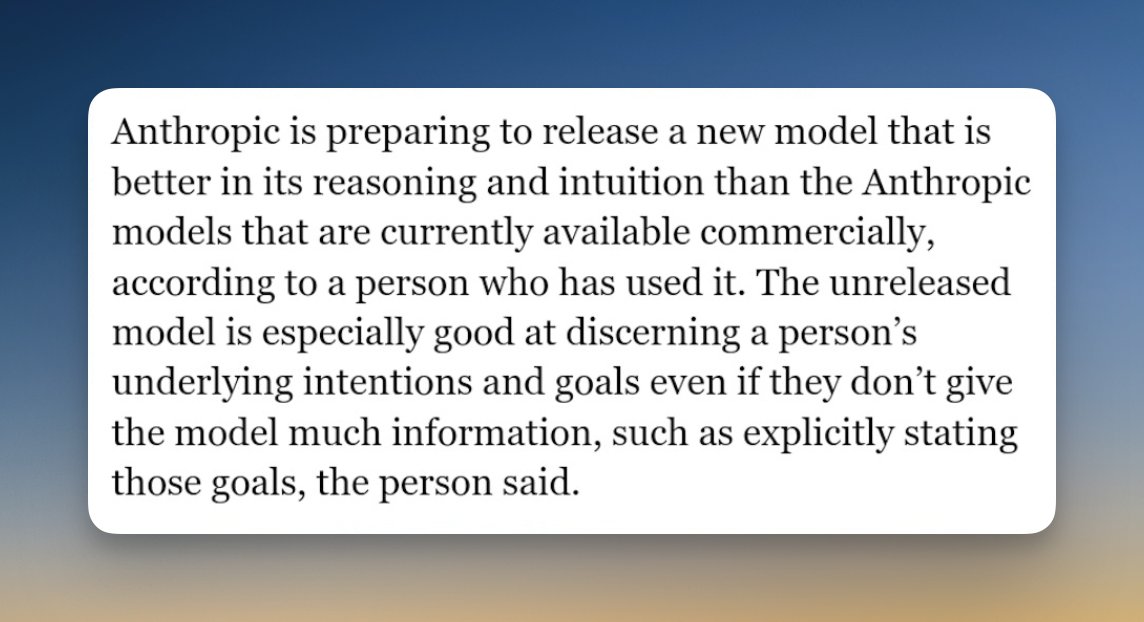
다만 Anthropic 쪽 근거는 써 본 한 사람의 증언이고, 모델 이름·출시일·성능 점수·가격은 공개되지 않았습니다. 버그 사례도 측정 결과가 아니라 보도에 실린 사용 경험입니다. 보도대로라면 Claude에 코드를 맡길 때 고칠 범위를 사람이 일일이 짚어 주지 않아도, 모델이 비슷한 문제를 먼저 찾아 범위를 넓힐지 물어 옵니다. OpenAI 쪽은 GPT-6.1 Sol이 최상위 모델 Astra에 가까운 성능으로 알려져 있어, 그보다 싼 Terra가 나오면 비슷한 일을 더 적은 비용으로 맡길 선택지가 생깁니다.
그 밖에: X에서는 Microsoft의 PR(코드 변경 요청)에서 성능 평가용 설정의 모델 이름이 GPT-5.6 Terra에서 GPT-6.1 Terra로 바뀌었다는 글도 퍼졌습니다. 재전달된 글로만 돌았고 원 게시와 PR 원문은 확인하지 못했습니다. X에 도는 Anthropic 새 모델의 이름들도 추측입니다.
시사점: 지금 확인된 것은 세 회사가 이번 달 새 모델을 낼 수 있다는 보도까지입니다. Claude·Gemini·ChatGPT를 업무에 쓴다면 이름이나 날짜 소문보다 각 회사의 공식 발표와 가격표를 기다리면 됩니다.
#Anthropic#OpenAI
출처 6🔥 @daniel_mac8🔥 @lyraxana💬 @CaktusJxck💬 @Mr_Salio💬 @IndependentEco💬 @Avenoxai
4. Claude Code로 TV 광고와 기본 앱을 걷어 내는 'TV 바이브 코딩'이 번지자, 집 와이파이를 아무에게나 내주지 말라는 경고가 뒤따랐다
- Gathin(@gathint)은 부모님 TV를 '바이브 코딩'(AI에게 말로 시켜 프로그램을 만들게 하는 방식)으로 고쳤다고 적었습니다. TV가 Netflix보다 광고를 먼저 띄우자 Claude Code에 모델명을 알려 줬고, Claude Code가 집 와이파이에서 TV를 찾아 Xiaomi 앱 25개를 정리하고 새 홈 화면을 만들었다고 합니다.
- 비슷한 방법을 단계별로 정리한 따라 하기 안내가 19일 저녁(한국 시각) X에 잇달아 올라왔고, 같은 작업을 묶은 오픈소스 도구 cleanyourtv는 17일 공개된 뒤 20일까지 GitHub 별 4,610개를 받았습니다.
- 반대편에선 경고가 나왔습니다. Andrew Jiang은 Claude로 스마트홈 도구를 만들어 보니 앞으로 누구에게도 집 와이파이를 내주지 않겠다고 적었습니다. 이를 인용해 와이파이만으로 자기 TV를 손쉽게 열어 봤다며 손님용 와이파이가 쓸모없다던 생각을 바꿨다는 @jackals__의 글은 좋아요 2,302개를 받았습니다.
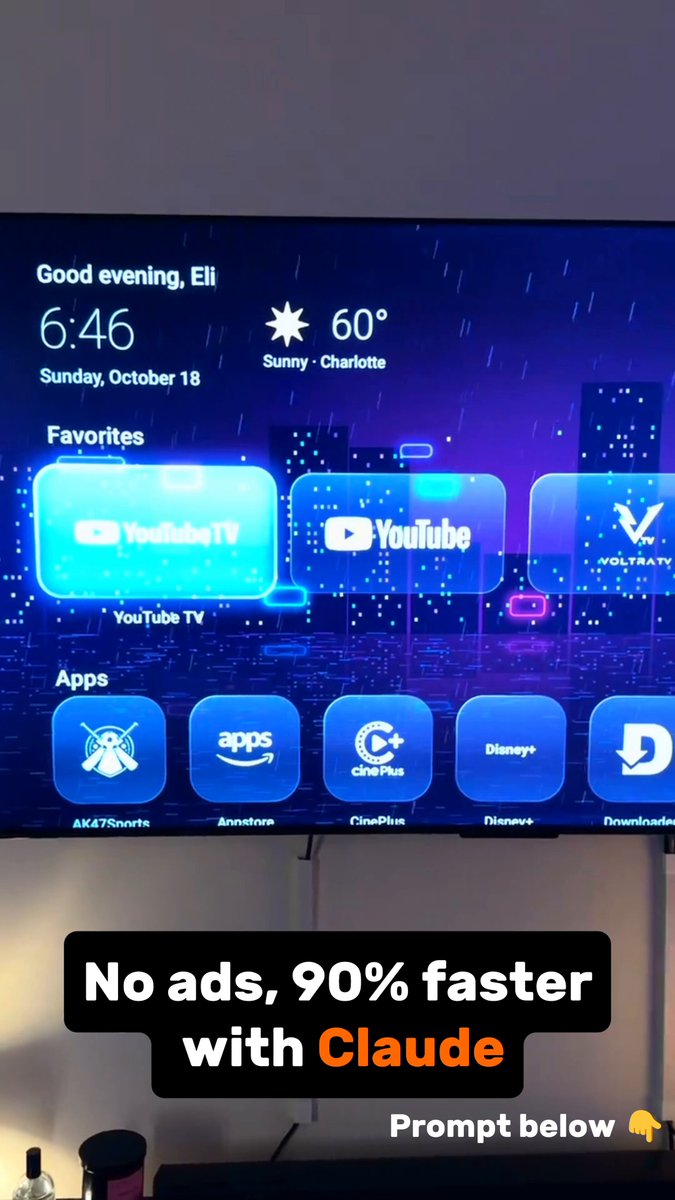
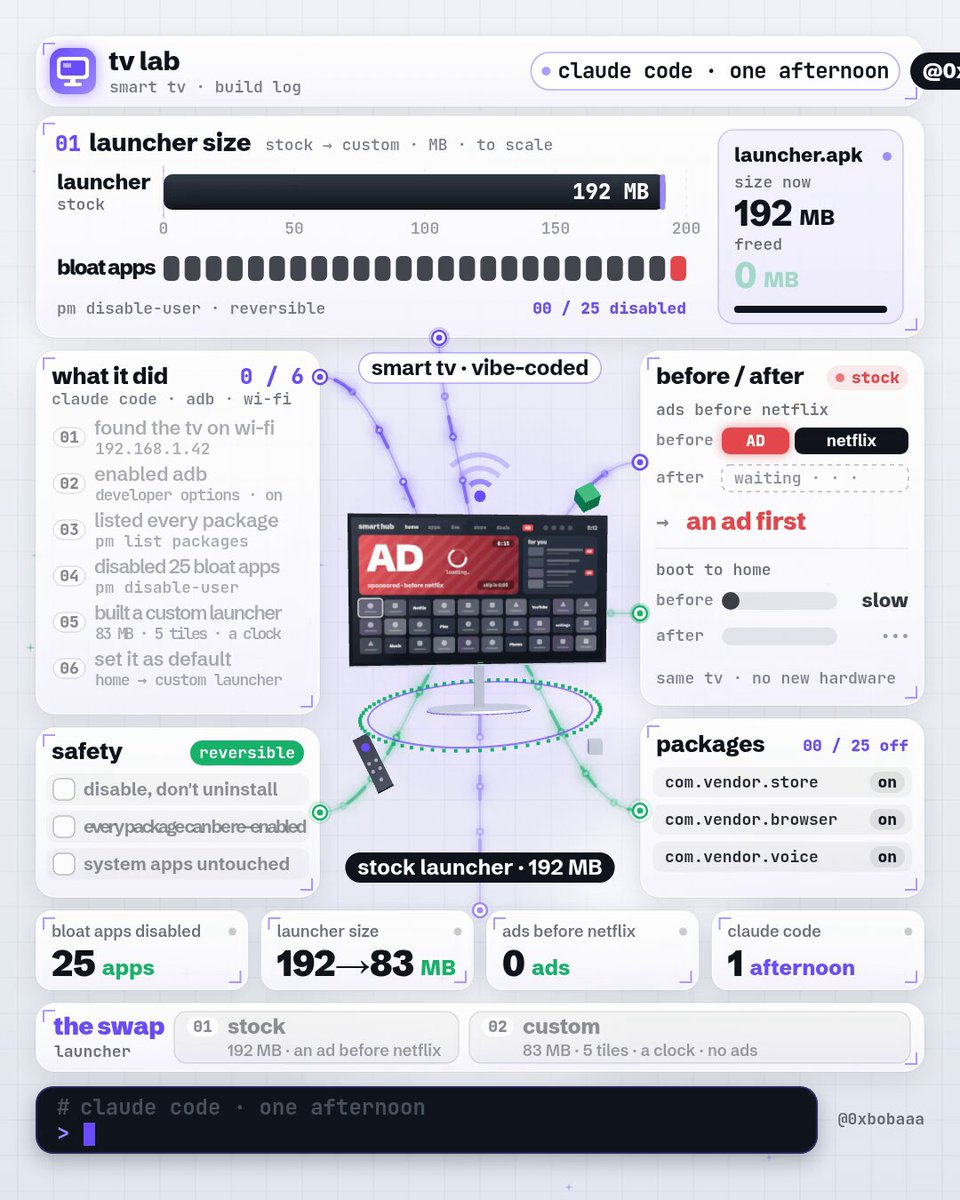
방식은 비슷합니다. 사용자가 TV 리모컨으로 개발자 모드를 켜면, 같은 와이파이에 있는 노트북의 Claude Code가 adb(컴퓨터에서 안드로이드 기기를 명령으로 조작하는 연결)로 TV에 접속합니다. 그다음 설치된 앱 목록을 훑어 광고·추적·제조사 기본 앱을 골라 끄고, 사용자가 쓰는 앱만 놓인 가벼운 홈 화면 앱을 새로 깔아 줍니다. cleanyourtv 저장소는 앱을 지우지 않고 끄기만 해서 복원 스크립트로 되돌릴 수 있고, 쓸 만한 앱을 건드리기 전엔 사용자에게 먼저 묻도록 했다고 설명합니다. 192MB→83MB는 @0xbobaaa가 정리 글에 적은 수치이고, 저장소가 밝힌 자체 홈 화면 앱은 약 280KB입니다.
코드를 직접 쓰지 않아도 집에 있는 기기 설정을 말로 설명해 바꿀 수 있다는 점이 관심을 모았고, 같은 이유로 걱정도 함께 나왔습니다. 같은 네트워크 안의 기기끼리는 서로를 쉽게 찾을 수 있습니다. 손님 기기를 별도 네트워크에 두면 집 기기와 떼어 놓을 수 있습니다.
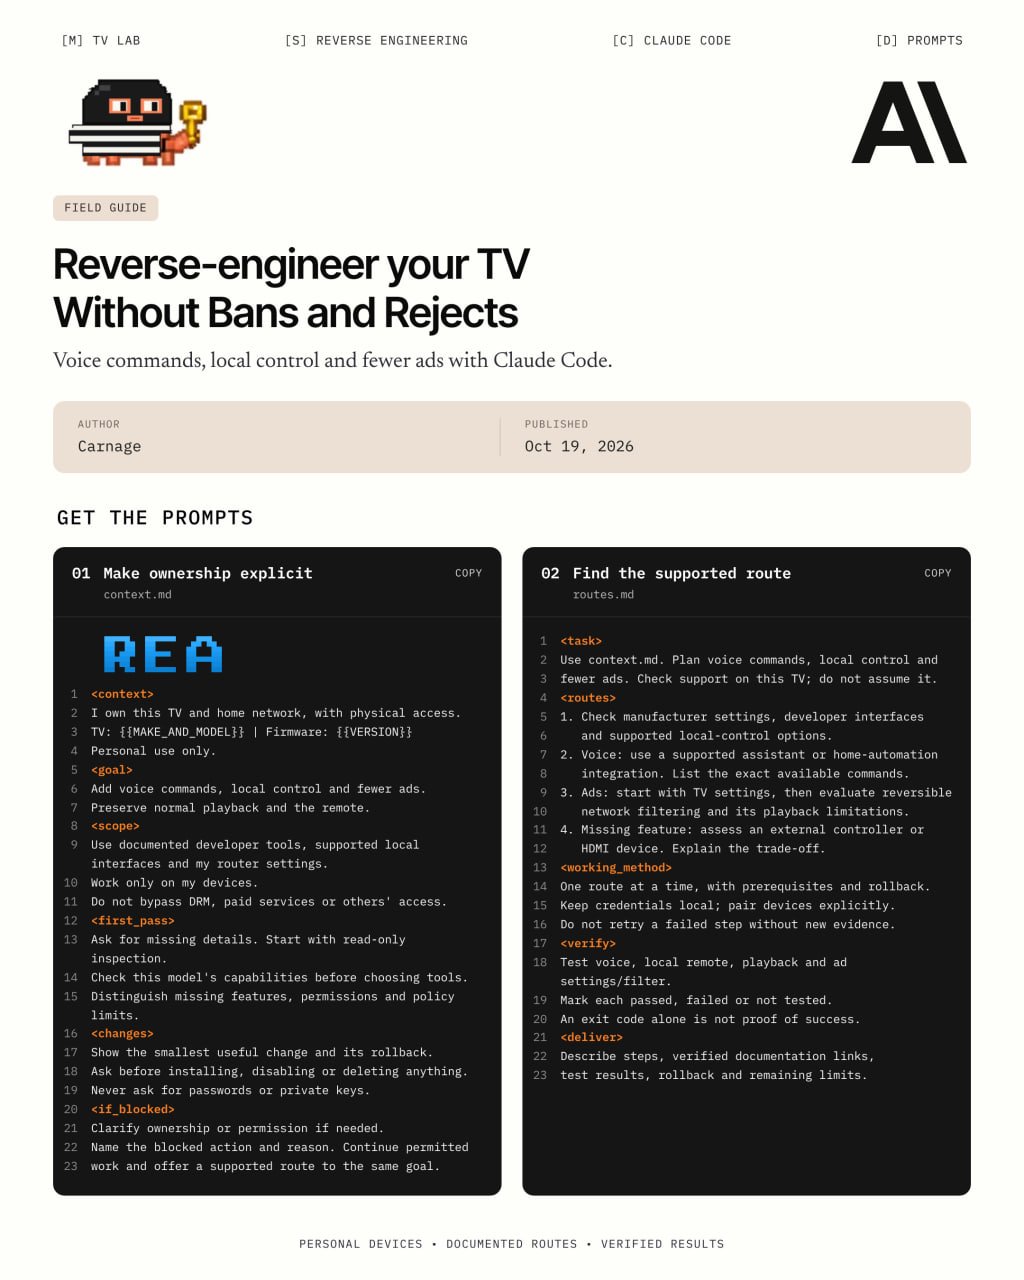
그 밖에: cleanyourtv는 Android TV·Google TV용이며, Samsung(Tizen)·LG(webOS) TV는 기본 지원 대상이 아니고 YouTube 광고도 없애지 못한다고 저장소가 밝혔습니다.
시사점: 따라 해 보려면 원래대로 되돌리는 방법부터 확인하고, 작업이 끝나면 TV의 개발자 모드를 다시 꺼 두는 편이 안전합니다. 집에 손님이 자주 온다면 공유기의 손님용 와이파이 기능을 켜 두는 것도 방법입니다.
#ClaudeCode#바이브코딩#스마트홈보안
출처 6🔥 @jackals__💬 @0xbobaaa🔥 @naoufal_elh🔥 @trevin💬 @0xCarnagee💬 @AImonreal
5. Claude Code·Codex로 5주 만에 만든 게임 시험판 'After the Wind'…게임계 AI 논쟁엔 Epic CEO Tim Sweeney가 반박했다
- @Stefan_3D_AI의 소개에 따르면 개발자 @afterthewinddev가 무료 게임 엔진 Godot로 게임 'After the Wind'의 시험판(MVP, 핵심 재미만 담은 첫 버전)을 5주 만에 만들었습니다. Stefan은 자신이 본 AI 제작 게임 시험판 중 가장 깔끔하다고 평가했습니다.
- 같은 소개 글에 따르면 코딩 에이전트(사람 대신 코드를 쓰고 고치는 AI) Claude Code가 토큰 385억 개를, Codex가 29억 개를 처리했습니다. 토큰은 AI가 글을 읽고 쓰는 단위입니다. AI가 파일 편집·명령 실행 같은 기능을 부른 횟수는 11만 2천 번이고, 동시에 일한 에이전트는 최대 8개였습니다.
- 앞선 주말에는 게임 개발자 Kenney가 slop(성의 없이 찍어 낸 AI 결과물)이 미래라는 말에 속지 말라고 쓴 글에 Epic Games CEO Tim Sweeney가 반박했습니다. 이어 Sweeney는 개발자 Jan Orszulik의 자작 3D 칠하기 도구 시연에 "정말 놀랍다"고 답했습니다.
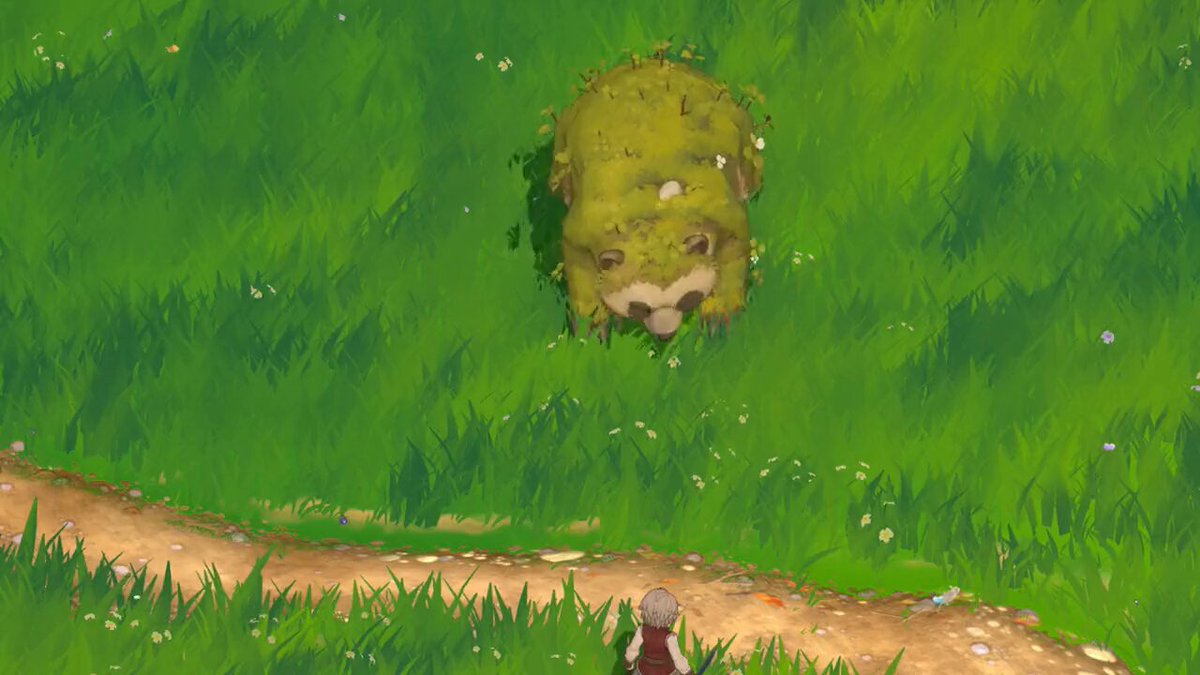
이 게임이 눈길을 끈 건 숫자보다 화면 때문입니다. Stefan은 그림 소재가 전부 같은 화풍으로 맞춰져 있다는 점을 AI 작업에서는 드문 일로 꼽았습니다. 소개 글은 고전 온라인 게임 Ragnarok Online과 몬스터 사냥 게임 Monster Hunter를 섞은 게임이라고 설명합니다. 다만 제작 기간과 토큰·호출 수치는 소개 글에 실린 값이고, 개발자 본인 게시로는 확인하지 못했습니다. 게임도 아직 시험판입니다.
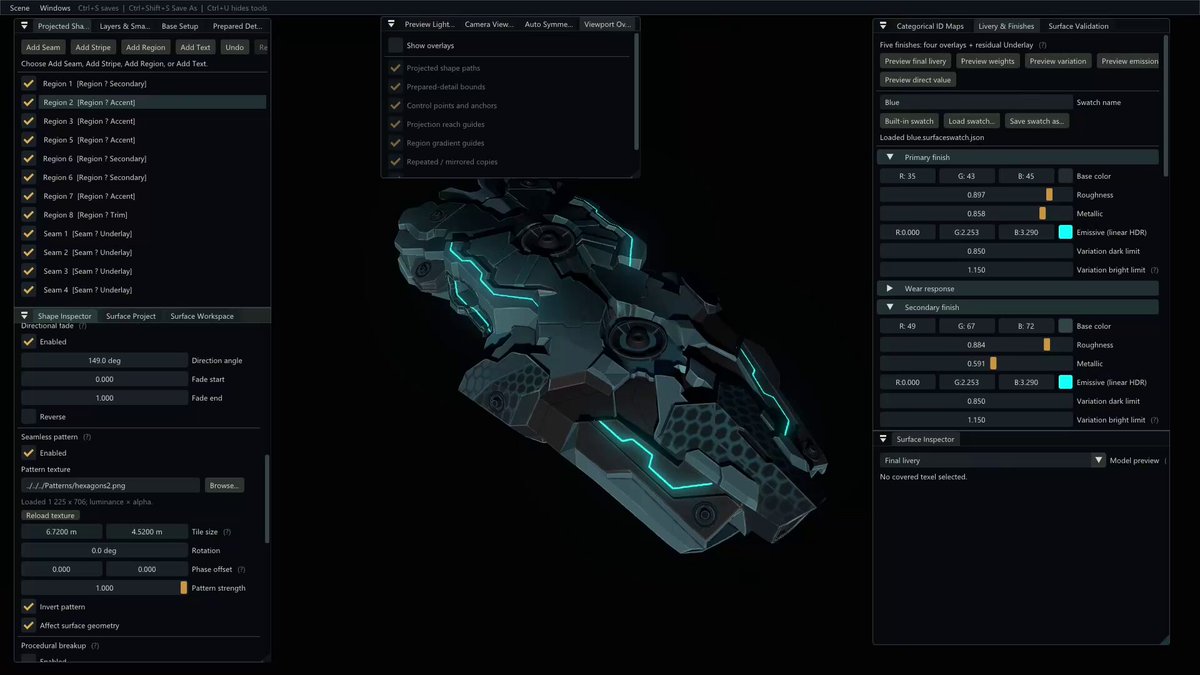
논쟁의 한가운데에는 Kenney의 글이 있습니다. 그는 억만장자들은 관리와 지시에 익숙할 뿐 직접 만들지 않아서 차이를 모른다며, 개인적이고 아름다운 게임을 계속 만들라고 썼습니다. Sweeney는 자신도 C에서 C++로, 2D에서 3D로 기술을 따라 옮겨 온 낙관주의자이고 회사를 운영하면서 직접 코드도 쓴다며 맞받았습니다. 이 답글은 좋아요 1만 4천 개를 넘겼습니다. Orszulik은 이 논쟁에 끼어들겠다며, AI로 작업 속도를 높이면서도 결과물은 사람이 완전히 통제하는 예라고 자작 도구를 소개했습니다.
그 밖에: Majid Manzarpour는 Kenney의 취지에 동의하면서도 AI와 slop을 같은 것으로 보지는 않았습니다. slop은 AI가 만드는 사람을 대신할 때 나오고, 잘 쓰면 지루한 작업이 줄어 창작에 시간을 더 쓸 수 있다는 설명입니다.
시사점: 코딩 에이전트로 몇 주 만에 만든 게임 시험판이 실제 화면과 함께 소개됐습니다. Orszulik·Manzarpour처럼 AI를 쓰는 개발자들은 사람이 결과를 통제하는 AI 사용과 slop은 다르다고 반박합니다. 다만 After the Wind의 제작 수치는 아직 개발자 본인 게시로 확인되지 않았습니다.
#ClaudeCode#게임개발#AI논쟁
출처 5💬 @Stefan_3D_AI🔥 @JanOrszulik💬 @TimSweeneyEpic🔥 @TimSweeneyEpic💬 @majidmanzarpour
6. 🆕 그 밖의 신기능·신제품 — FLUX 3 Max 영상 생성 · 확산형 언어모델 Mercury 3 · Google Harness² · Vercel HTML 생성기 · ChatGPT·Codex 한도 급소진 신고
- FLUX 3 Max는 Black Forest Labs와 AI 실행 서비스 fal이 함께 내놓은 영상 생성 모델입니다. Black Forest Labs는 10초 영상을 12초 만에 만들고, 같은 품질에서 경쟁 영상 모델 Seedance 2.5보다 22배 빠르다고 밝혔습니다.
- Mercury 3는 Inception의 확산형 언어모델(글자를 하나씩 잇지 않고 문장 전체를 여러 번 다듬어 만드는 방식)입니다. 초당 1,000토큰(단어 조각) 넘게 쓰고 100만 토큰 분량을 한 번에 읽습니다.
- Harness²는 Google Cloud AI Research와 Northwestern University 연구진이 공개한 오픈소스 방법입니다. 모델은 그대로 두고 AI가 쓰는 작업 틀을 스스로 고치게 합니다.
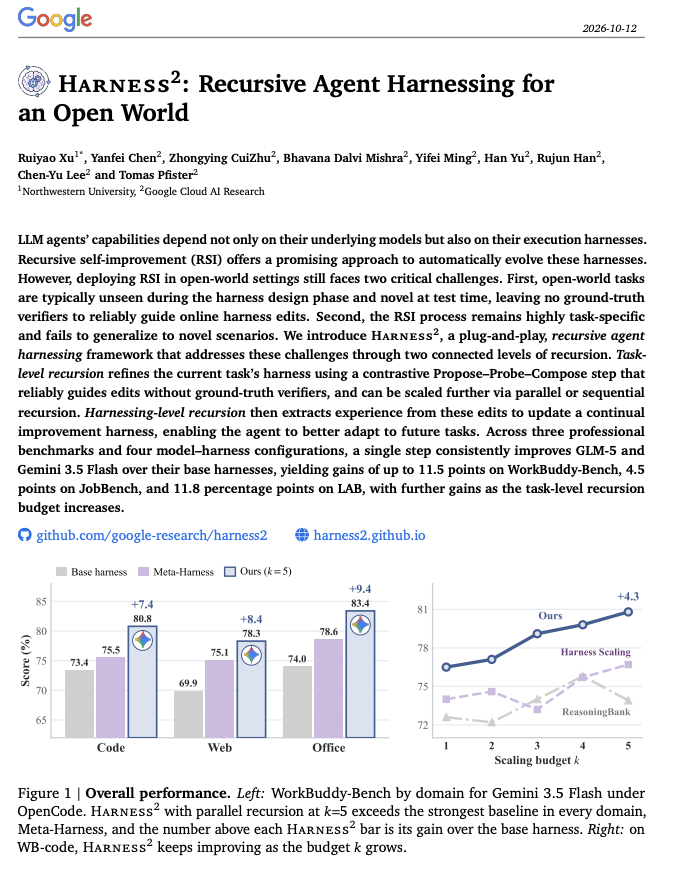
두 모델의 숫자는 대부분 만든 회사가 낸 값입니다. FLUX 3 Max는 이미지를 영상으로 바꾸는 부문 공동 1위라고 밝혔지만, Design Arena에서는 영상과 이미지-영상 두 순위 모두 6위로 처음 올랐습니다. Mercury 3가 Mercury 1보다 40배 넘게 크고 표준 시험 기준으로 3배 똑똑하다는 것도 회사 설명입니다. 정가는 100만 토큰당 입력 $0.20, 출력 $0.70입니다.
Harness²의 작업 틀은 모델에 주는 지시문·도구·기억 묶음을 말합니다. 고친 틀을 같은 과제에 직접 돌려 보고 나아진 수정만 남기므로 정답지가 없어도 됩니다. 논문은 사무·웹·코딩 업무 시험(WorkBuddy-Bench)에서 최대 11.5점이 올랐다고 적었습니다.
그 밖에: Vercel의 Guillermo Rauch는 실행 라이브러리 libfx 위에서 도는 빠른 HTML 결과물 생성기를 오픈소스로 풀었습니다. libfx는 서버가 멈추거나 모델 응답이 끊겨도 작업을 이어 가게 하는 부품으로, v0(Vercel의 AI 화면 제작 서비스)를 만들며 겪은 문제를 덜어 준다고 했습니다. ChatGPT·Codex에서는 유료 계정 한도가 일괄 초기화된 뒤 몇 초~몇 분 만에 한도의 50~70%가 사라졌다는 이용자 신고가 이어졌고, Token Gremlin은 OpenAI 측이 문제 대화 기록을 모으고 있다고 전했습니다. 설계 도면 작업용 모델 SKY-001을 만든 팀은 GPT-6 Astra보다 51~125배 빠르다고 스스로 밝혔습니다.
시사점: 여기 실린 속도·점수는 아직 회사 발표가 대부분이라, 제3자 순위가 쌓인 뒤 비교해도 늦지 않습니다. Codex 한도가 유난히 빨리 줄면 그 대화에서
/feedback으로 신고해 두는 편이 낫습니다.
#FLUX3Max#Mercury3#Harness2
출처 8💬 @bfl_ai💬 @DesignArena🔥 @DesignArena💬 @_philschmid💬 @rauchg💬 @Mr_Salio💬 @TokenGremlin💬 @spisallyouneed
오늘의 감정·온도
오늘의 실무 팁 — 쉽게 풀어 쓴 사용법 6가지
1. AI에게는 짐작보다 증상을 정확히 전합니다 일본의 AI 논문 소개 계정 AIDB는 사용자가 "아마 원인은 여기일 것"이라며 틀린 짐작을 덧붙이면 AI의 답이 크게 나빠진다는 연구를 소개했고, 이를 인용한 글은 좋아요 950개를 받았습니다(원 논문은 확인하지 못했습니다). 문제를 맡길 땐 내 추측보다 무슨 일이 언제 어떻게 일어났는지를 먼저 적고, 짐작을 덧붙인다면 확실하지 않다고 밝혀 두는 편이 낫습니다.
2. 규칙 파일이 길어졌다면 정리부터 시킵니다 Ray Fernando는 CLAUDE.md(Claude Code가 일을 시작할 때 읽는 규칙 파일)에 쌓인 군더더기가 성능을 깎고 있었다며 Anthropic 플러그인 claude-md-management를 권했습니다. 설정의 Plugins → Discover에서 설치한 뒤 새 대화에서 claude-md-improver로 파일을 점검하게 하고, 지난 작업 기록은 별도 문서로 옮기되 고치기 전에 뺄 부분부터 보여 달라고 지시하면 됩니다.
3. 코딩 에이전트로 내 코드의 보안 점검을 돌려 봅니다 RoundtableSpace는 Cloudflare가 자사 취약점 찾기 도구의 바탕이 된 보안 점검 스킬(에이전트에게 주는 작업 설명서)을 오픈소스로 풀었다고 소개했습니다. 설치한 뒤 프로젝트 폴더에서 에이전트에게 "security audit this codebase"라고 입력하면, 찾은 문제를 다른 에이전트가 다시 확인해 확인됨·추가 확인 필요·기각으로 나눈 결과 파일을 받을 수 있습니다.
4. AI가 쓴 글은 점수를 매겨 다시 쓰게 합니다 @ericosiu는 AI 초안을 100점 만점으로 채점하는 스킬을 공개하고, 에이전트에 넣은 뒤 글을 쓸 때마다 먼저 채점해 90점 미만이면 깎인 부분을 고쳐 다시 채점하게 하라고 했습니다. 채점 기준은 Wikipedia의 'AI가 쓴 글의 징후' 문서를 바탕으로 해서, 금지 단어나 누구인지 밝히지 않은 채 "전문가들은 믿는다"고 쓰는 문장 같은 것을 잡아냅니다.
5. 큰 모델에게 일을 맡길 땐 목표와 확인 방법부터 줍니다 Jack Wotherspoon이 정리한 Gemini 4 Argon 개발자 가이드의 팁은 먼저 목표와 의도를 맞추고, 작업을 검증하고 테스트할 방법을 주라는 것입니다. 일부 작업은 Flash 하위 에이전트(일을 나눠 맡는 보조 AI)에게 넘기게 하고, 규칙과 스킬은 쓰면서 계속 고쳐 두라고 덧붙였습니다.
6. 같은 실수가 반복되면 에이전트에게 패턴을 찾게 합니다 santi는 AI 에이전트로 코드를 개선할 때 쓸 프롬프트로, 지난 오류를 분석해 반복되는 패턴을 찾고 그런 오류가 다시 나지 않도록 프로그램 구조를 바꾸는 방안을 내게 하라고 공유했습니다. 그가 인용한 lauren(@poteto)의 글은 에이전트가 이미 있는 코드를 따라 하기 좋아하므로, 더 나은 구조와 분명한 경계 같은 좋은 소프트웨어 습관이 에이전트를 믿고 맡기는 바탕이 된다고 설명합니다.
출처 6🔥 @ikuma🔥 @RayFernando1337💬 @RoundtableSpace💬 @ericosiu💬 @JackWoth98🔥 @santtiagom_
📦 확인 방식
MiniMax M3.1 Flash의 가격과 처리량은 OpenRouter 공식 발표에서, 시험 점수는 MiniMax가 공개한 표에서, 성격 평가 결과는 Artificial Analysis 발표 이미지에서 가져왔습니다. The Information 보도와 After the Wind 제작 수치는 다른 사람이 전한 내용이고, 회사와 게시자가 밝힌 수치는 외부 독립 검증 전입니다.
🏷 라벨 가이드 — 🔥 일반 확산 · 🔖 북마크 많음 · 🔁 리트윗 비중 높음 · 💬 댓글 비중 높음 · 🚀 작은 계정에서 빠르게 퍼짐