오늘의 AI 브리핑 ·
대화창이 규제 문서에서 이름을 얻었다
5분 브리핑
약 2분 · 6개 흐름핵심만 먼저 읽고, 궁금한 소식은 본문으로 이어 보세요.
전체 분석 9분으로 바로 가기 ↓- EU가 ChatGPT를 '초대형 검색엔진'으로 분류했다
유럽연합 집행위원회가 ChatGPT를 초대형 온라인 검색엔진(VLOSE)으로, Reddit과 Roblox를 초대형 온라인 플랫폼으로 디지털서비스법상 지정했습니다. 근거는 이용자 수입니다.
- Claude Max의 "20배"가 소장 표에서 시간 단위로 환산됐다
6월 14일 캘리포니아 북부연방지방법원에 제출된 집단소송 소장이 이번 주말 다시 퍼졌습니다. 원고는 Max 5x·20x 요금제의 배수 표기가 오해를 준다고 주장합니다.
- Thomson Reuters가 Qwen 위에 자기 법률 모델을 올렸다
175년치 법률·세무·회계·뉴스 데이터로 계속 학습시킨 자체 모델 Thomson을 냈습니다. 출발점은 알리바바의 오픈 웨이트 Qwen3.5-397B입니다.
- Muse Code가 베타를 끝내며 한도를 가격표 첫 줄에 적었다
Meta의 코딩 도구 Muse Code가 베타를 끝내고 정식 출시됐습니다. 설치는 명령 한 줄이고, 자기 에이전트를 얹을 수 있는 SDK가 개발자 프리뷰로 함께 나왔습니다.
- Codex가 7주 만에 600만에서 2,500만으로 갔고, 같은 날 멈췄다
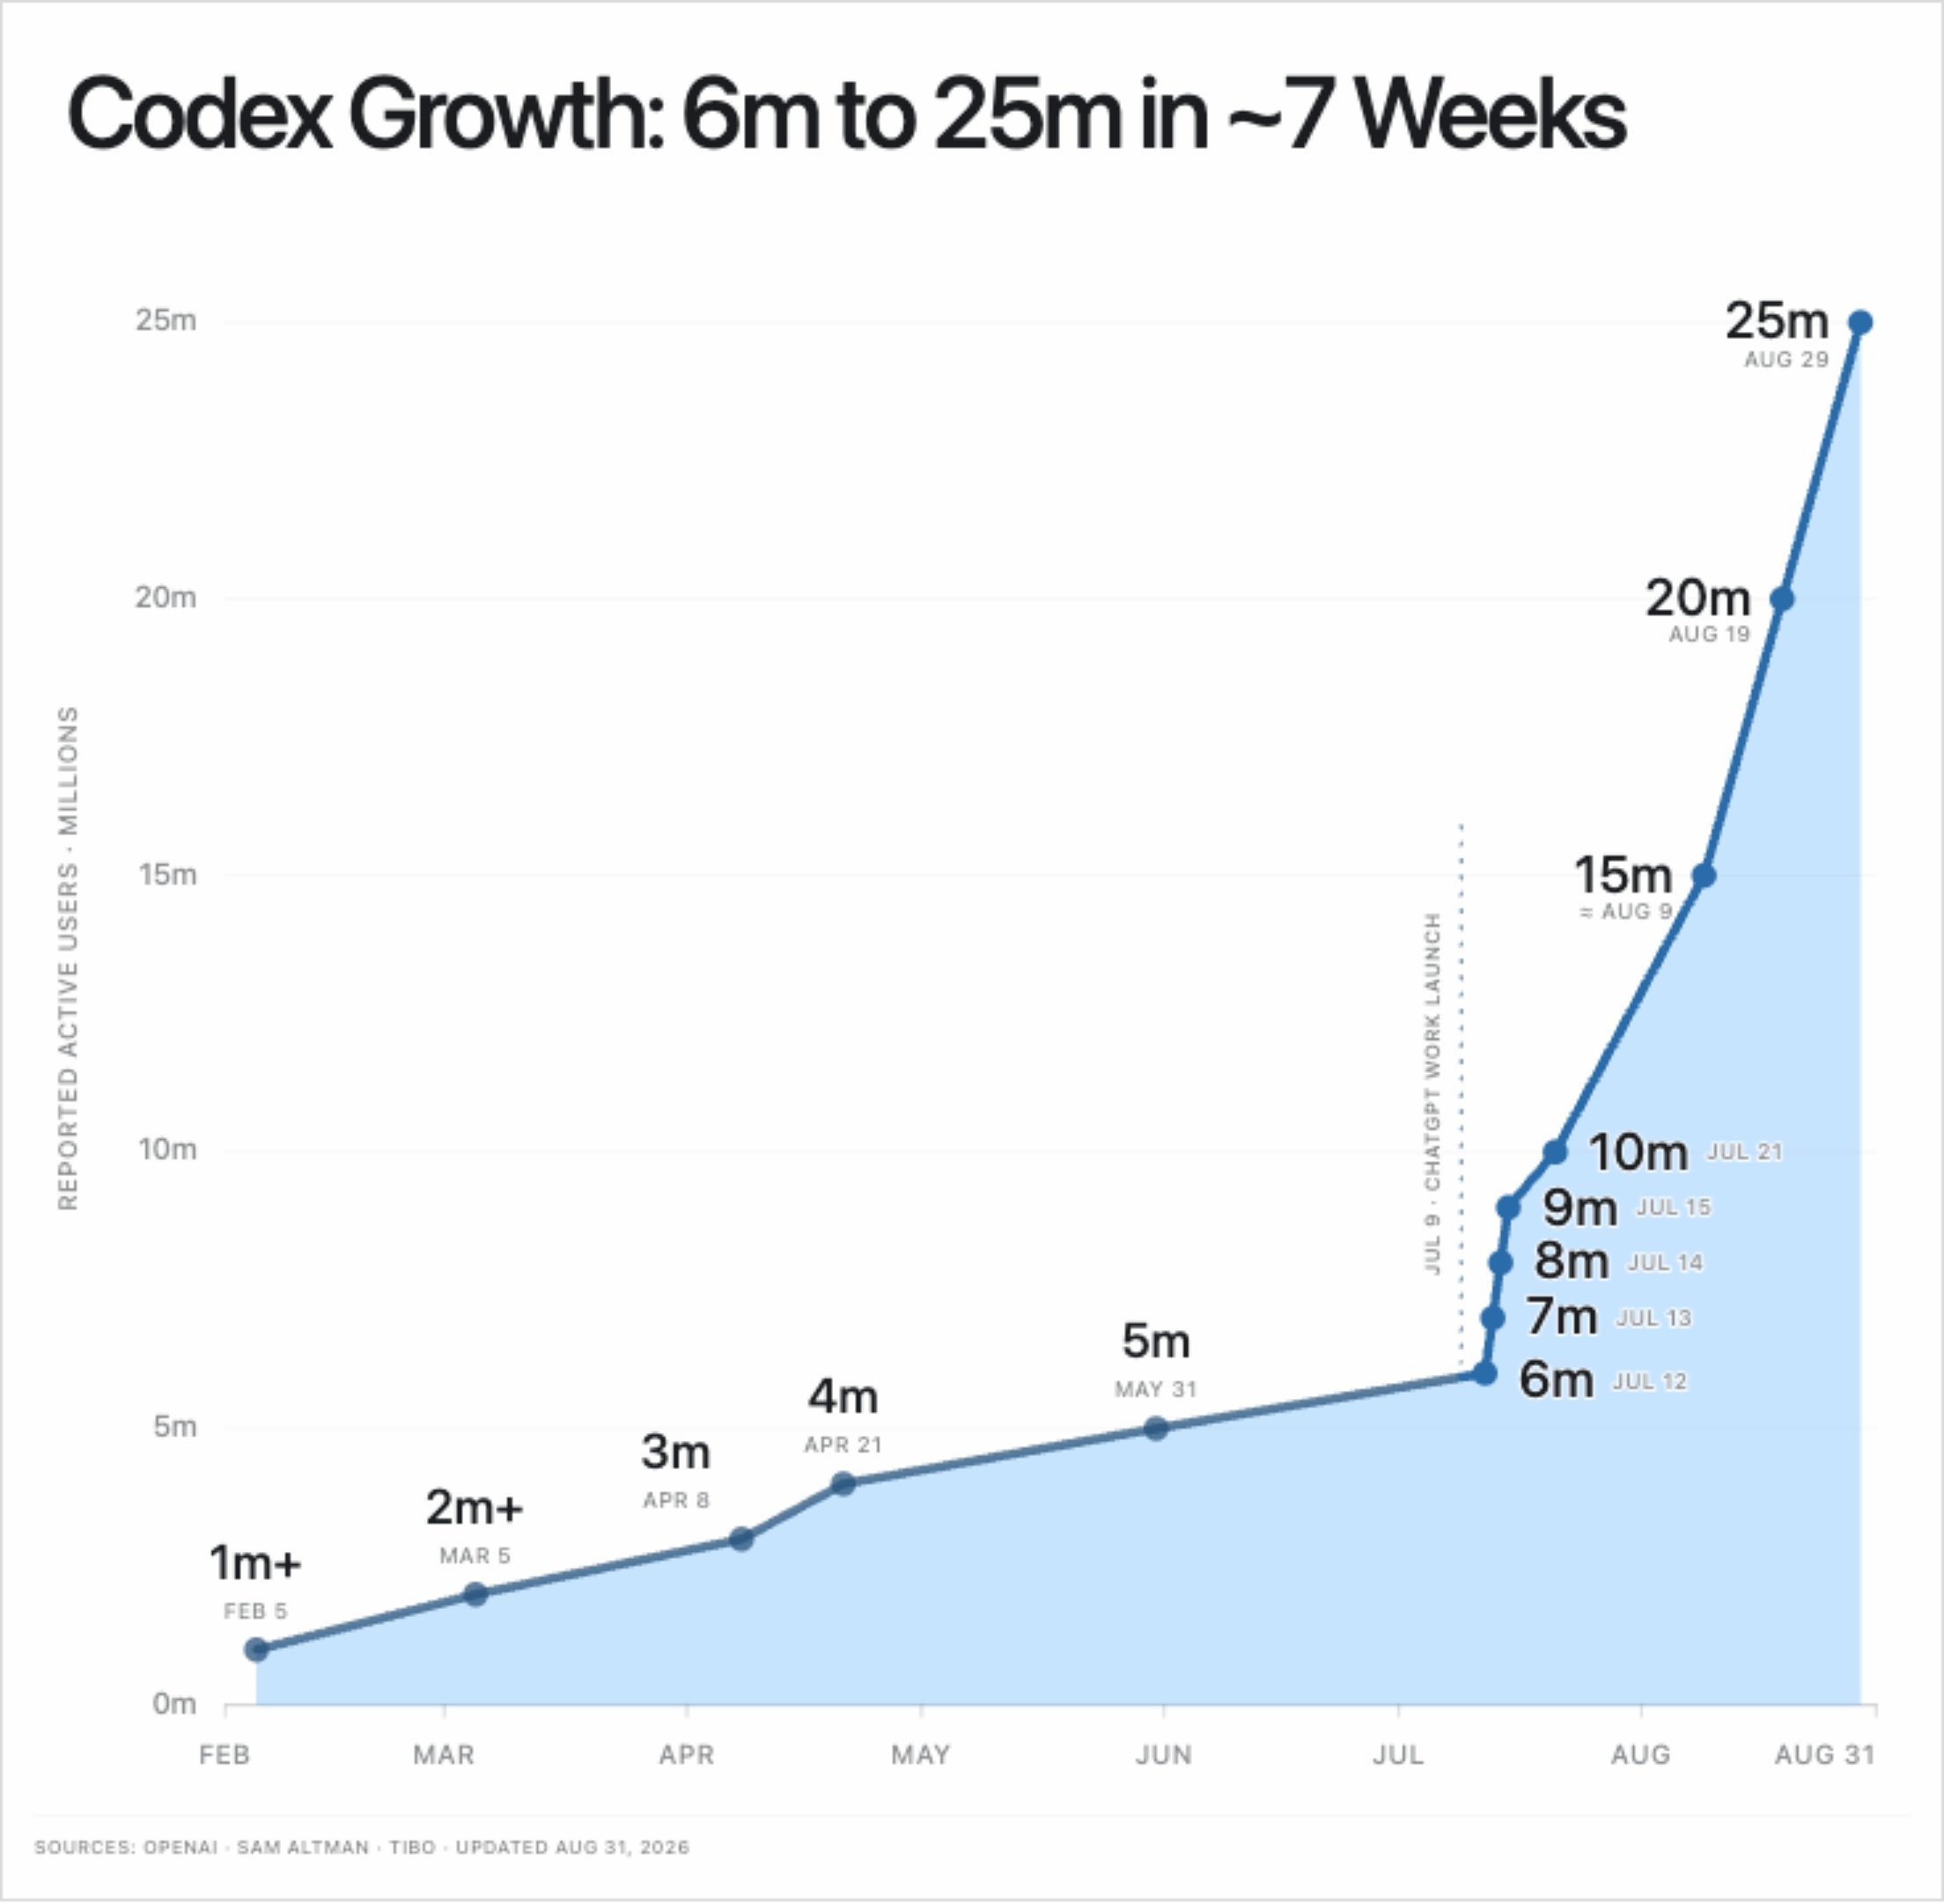
오픈AI의 Tibo Sottiaux가 활성 사용자 2,500만을 알리며 ChatGPT Work와 Codex의 유료 구독 사용량을 전부 리셋했다고 밝혔습니다. 공유된 그래프를 보면 2월 100만에서 5월 500만까지는 완만하다가, 7월 9일 ChatGPT Work 출시 이후 기울기가 꺾입니다.
- 🆕 그 밖의 신기능·신제품
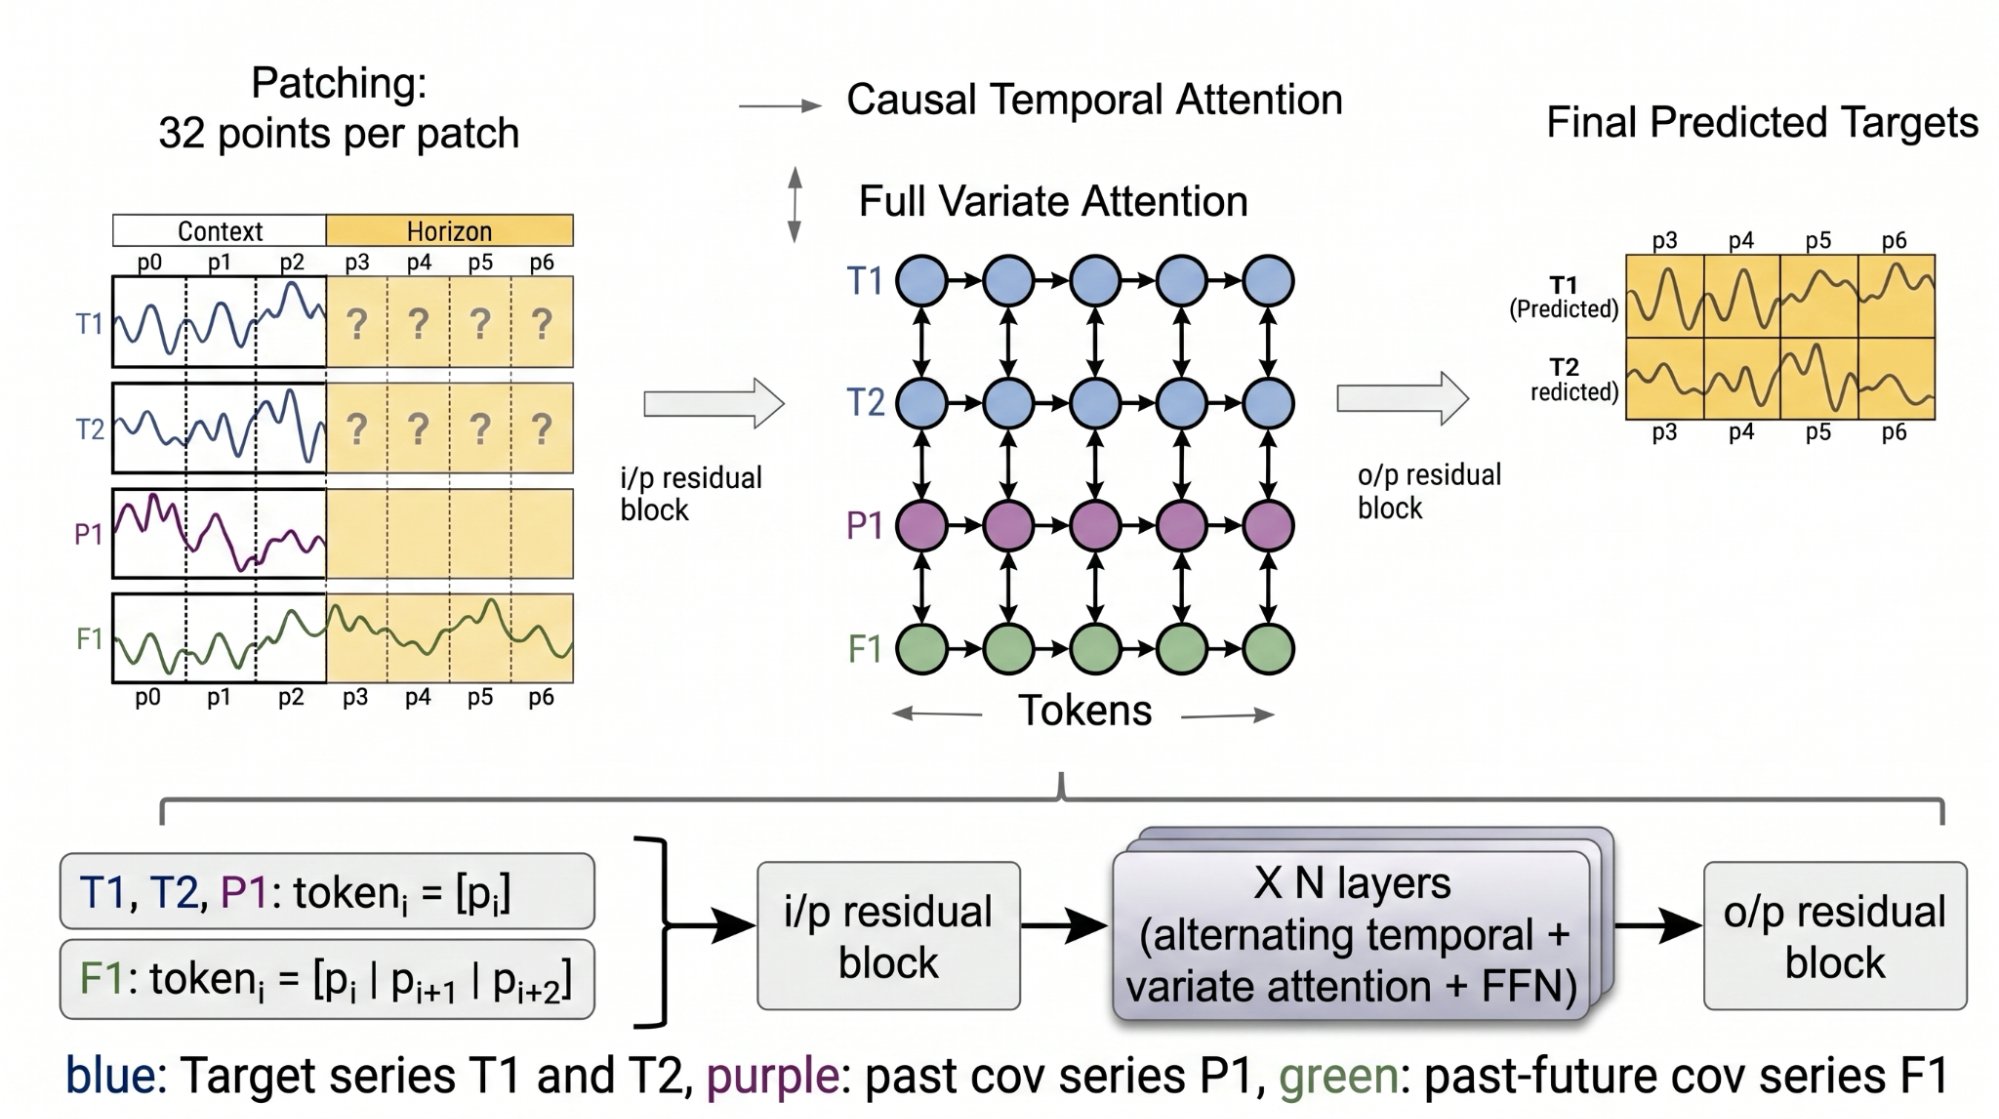
구글 리서치가 시계열 기초 모델 TimesFM-3를 냈습니다. 한 번의 순방향 패스로 여러 계열을 동시에 예측하는 다변량 구조입니다.
주요 키워드 TOP 5: EU 디지털서비스법 · Claude Max 소장 · Thomson Reuters · Muse Code · Codex 2,500만 | 메인 이벤트: 유럽연합이 ChatGPT를 검색엔진으로 분류하면서, 대화창이 규제 문서 위에서 처음으로 이름을 얻었습니다.
오늘 나온 소식들은 서로 다른 회사 이야기인데 같은 문장을 반복합니다 — 한도와 분류가 제품의 일부가 됐다는 것. 유럽은 ChatGPT를 검색엔진으로 분류해 의무를 얹었고, 법원에는 Claude의 "20배"가 실제로 몇 시간인지 따지는 표가 제출됐으며, Meta는 새 코딩 도구를 내면서 5시간 창과 요청 수를 가격표 첫 줄에 적었습니다. 모델이 얼마나 똑똑한가를 겨루던 자리에, 그래서 얼마나 쓸 수 있는가가 올라온 하루였습니다.
1. EU가 ChatGPT를 '초대형 검색엔진'으로 분류했다
- 유럽연합 집행위원회가 ChatGPT를 초대형 온라인 검색엔진(VLOSE)으로, Reddit과 Roblox를 초대형 온라인 플랫폼으로 디지털서비스법상 지정했습니다.
- 근거는 이용자 수입니다. ChatGPT는 3월 31일까지 6개월 평균 EU 월 이용자 1억 5,910만 명, Reddit은 상반기 최대 5,720만, Roblox는 평균 4,660만으로 기준선 4,500만을 넘겼습니다.
- 세 서비스는 12월 말까지 추가 의무를 이행해야 하고, 이로써 가장 엄격한 등급에 들어간 서비스는 28개가 됐습니다.
분류가 왜 중요하냐면, 디지털서비스법의 의무는 서비스가 무엇이라고 불리느냐에 따라 달라지기 때문입니다. 검색엔진으로 지정되면 위험 평가와 외부 감사, 데이터 접근 제공 같은 항목이 따라붙습니다. 그동안 대화형 도구는 규제 문서 안에서 마땅한 자리가 없었는데, 유럽이 먼저 자리를 정해 준 셈입니다. 오픈AI 입장에서는 EU 이용자 규모가 곧 규제 강도가 되는 구조에 처음으로 편입된 것이고요.
지정 근거가 이용자 수라는 점도 짚어 둘 만합니다. 서비스가 스스로 신고한 숫자가 기준선을 넘으면 지정되는 구조라, 성장 자체가 규제 트리거가 됩니다. Reddit이 5,720만, Roblox가 4,660만으로 나란히 걸린 것도 같은 이유입니다.
그 밖에: 유럽이 스스로 만들지 못한 서비스를 규제 대상으로 올리는 데 만족한다는 냉소도 같이 돌았습니다. 지정 이후 넉 달이라는 이행 기간은 연말 시한과 맞물립니다.
시사점: EU에서 도구를 쓰는 팀이라면 연말 이후 ChatGPT 쪽 정책·기록 요구가 늘어날 수 있다는 전제로 계약과 로그 보관을 미리 점검해 두는 편이 낫습니다.
#디지털서비스법 #ChatGPT #EU규제
출처 3💬 @EU_Commission🔥 @eurofounder🔥 @kimmonismus
2. Claude Max의 "20배"가 소장 표에서 시간 단위로 환산됐다
- 6월 14일 캘리포니아 북부연방지방법원에 제출된 집단소송 소장이 이번 주말 다시 퍼졌습니다. 원고는 Max 5x·20x 요금제의 배수 표기가 오해를 준다고 주장합니다.
- 소장 표 1은 앤스로픽이 메일로 안내한 주간 시간을 그대로 옮겼습니다. Sonnet 4 기준 Pro 40~80시간, Max 5x 140~280시간, Max 20x 240~480시간 — Max 20x는 Pro의 6배, Max 5x의 1.7배입니다.
- 두 번째 표는 시간당 단가를 계산합니다. Opus 4 기준 Max 5x가 시간당 0.66~1.55달러인데 Max 20x는 1.16~1.93달러로, 비싼 요금제의 단가가 더 높습니다.
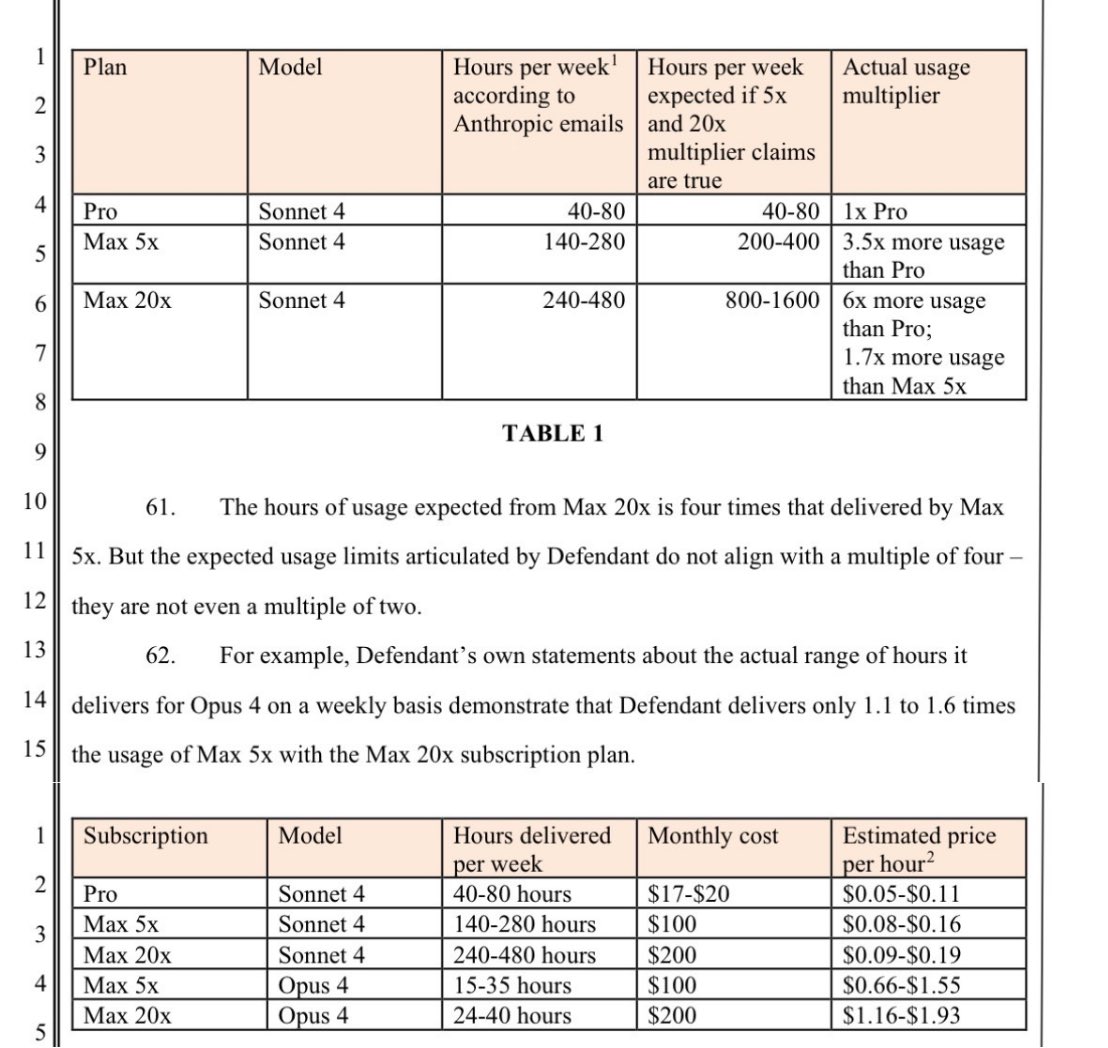
배수가 5시간 창에만 적용되고 주간 한도는 따로 있다는 게 다툼의 핵심입니다. 구매 화면에서 보는 숫자와 실제로 일주일 동안 쓸 수 있는 양이 다른 층위에 있는 셈인데, 소장은 그 두 층위가 구분되지 않은 채 팔렸다고 봅니다. 청구는 캘리포니아 소비자법 위반과 허위광고, 과실에 의한 부실표시, 계약 위반 네 갈래입니다.
소송의 승패와 별개로 이 표가 남긴 건 비교 가능한 단위입니다. 그동안 요금제 논쟁은 체감으로 오갔는데, 시간과 단가로 환산된 표가 공개 문서에 들어가면서 다른 회사 요금제도 같은 자로 재게 됐습니다.
그 밖에: 앤스로픽이 주간 사용량을 17% 줄이면서 "영구 25% 증가"로 설명했다는 지적과, 공식 페이지에서 시간 수치가 사라졌다는 관찰도 함께 돌았습니다. 오픈AI 쪽에서는 Codex의 20배가 주간 한도에 적용된다는 설명이 나왔습니다.
시사점: 코딩 에이전트 요금제를 고를 때는 배수 대신 주간 한도와 그 창의 길이를 물어보는 게 실질적입니다. 같은 배수라도 적용 구간이 다르면 실제로 쓸 수 있는 양이 몇 배씩 벌어집니다.
#Claude #사용량한도 #집단소송
출처 5🔥 @Hesamation🔥 @Ananth7e🔥 @kimmonismus🔥 @IntCyberDigest🔥 @blueemi99
3. Thomson Reuters가 Qwen 위에 자기 법률 모델을 올렸다
- 175년치 법률·세무·회계·뉴스 데이터로 계속 학습시킨 자체 모델 Thomson을 냈습니다. 출발점은 알리바바의 오픈 웨이트 Qwen3.5-397B입니다.
- 2024년 8월에 인수한 케임브리지 스타트업 Safe Sign 팀이 만들었고, 임피리얼 칼리지 런던과 함께 기반 모델을 다듬어 사내에서 Snowdon이라 부릅니다. 약 20개월과 4,000만 달러가 들었습니다.
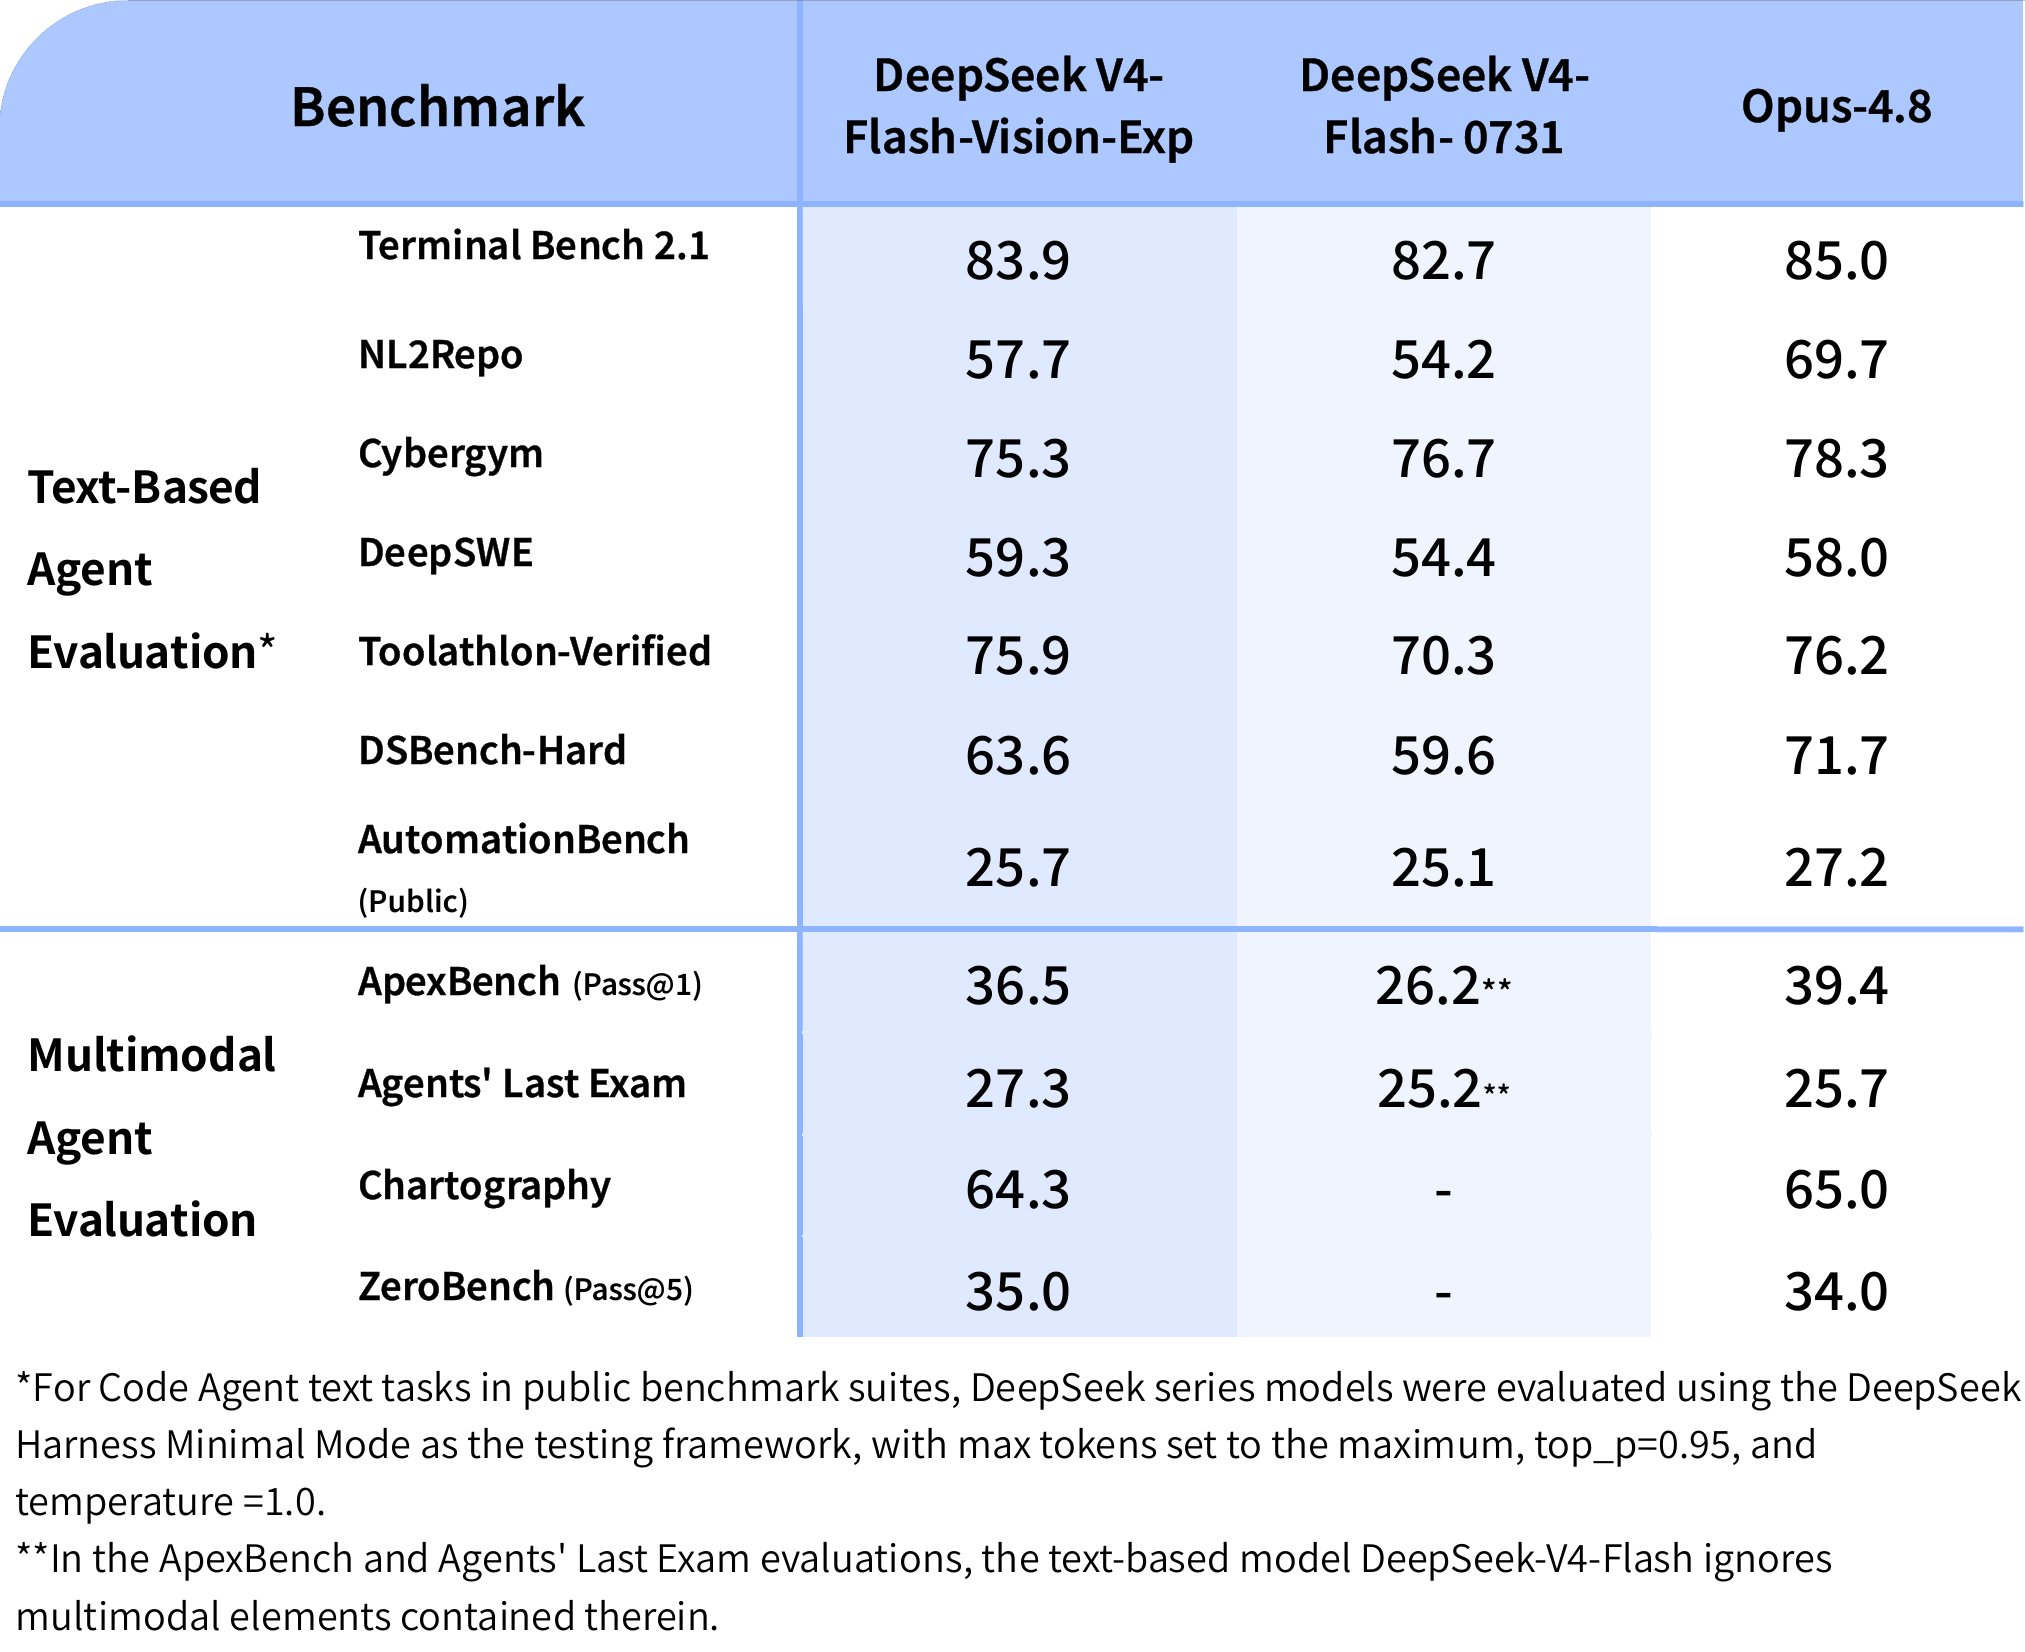
- 자체 벤치마크에서 Claude Opus 4.8과 비슷하고 GPT-5.5·Claude Sonnet 5·Gemini 3.1 Pro보다 앞선다고 밝혔으며, CoCounsel Legal의 문서 분석부터 투입합니다.
서구 기업이 중국산 오픈 웨이트를 기반으로 삼는 게 더 이상 예외가 아니라는 점이 이 발표의 무게입니다. 데이터가 해자인 회사에게 기반 모델은 사와도 되는 부품이 됐고, 4,000만 달러는 프런티어 모델 한 번 훈련에 견주면 작은 값입니다. 법률처럼 정확도 요구가 높은 영역에서 그 조합이 통한다면, 같은 계산을 할 수 있는 산업은 여럿입니다.
다만 자체 벤치마크라는 단서는 남습니다. 비교 대상으로 든 모델들이 모두 경쟁 제품이고 평가 조건은 공개되지 않았습니다. 외부 검증이 나오기 전까지는 성능 주장보다 20개월과 4,000만 달러라는 투입 규모 쪽이 더 단단한 정보입니다.
그 밖에: 같은 날 DeepSeek-V4-Flash-Vision-Exp의 웨이트가 허깅페이스에 올라왔고, GLM-5.3-Flash의 무검열 NVFP4 변종도 공개됐습니다. 둘 다 바로 내려받아 돌릴 수 있는 형태입니다.
시사점: 사내 데이터가 충분한 조직이라면 프런티어 API 구독과 오픈 웨이트 위 계속학습을 같은 표에 놓고 비교할 시점입니다. 비교 항목은 성능이 아니라 데이터 반출 조건과 단가입니다.
#ThomsonReuters #Qwen #오픈웨이트
출처 3🔥 @zachmoskow🔥 @zizhpan🔥 @OrcaRouter
4. Muse Code가 베타를 끝내며 한도를 가격표 첫 줄에 적었다
- Meta의 코딩 도구 Muse Code가 베타를 끝내고 정식 출시됐습니다. 설치는 명령 한 줄이고, 자기 에이전트를 얹을 수 있는 SDK가 개발자 프리뷰로 함께 나왔습니다.
- 요금제는 셋입니다. Everyday 월 5달러, High 15달러, Power 50달러 — 각각 기본, 3배, 10배 사용량으로 표기했습니다.
- 눈에 띄는 건 기본 요금제 설명입니다. 5시간마다 10~50건이라고 창의 길이와 건수를 함께 적었습니다.
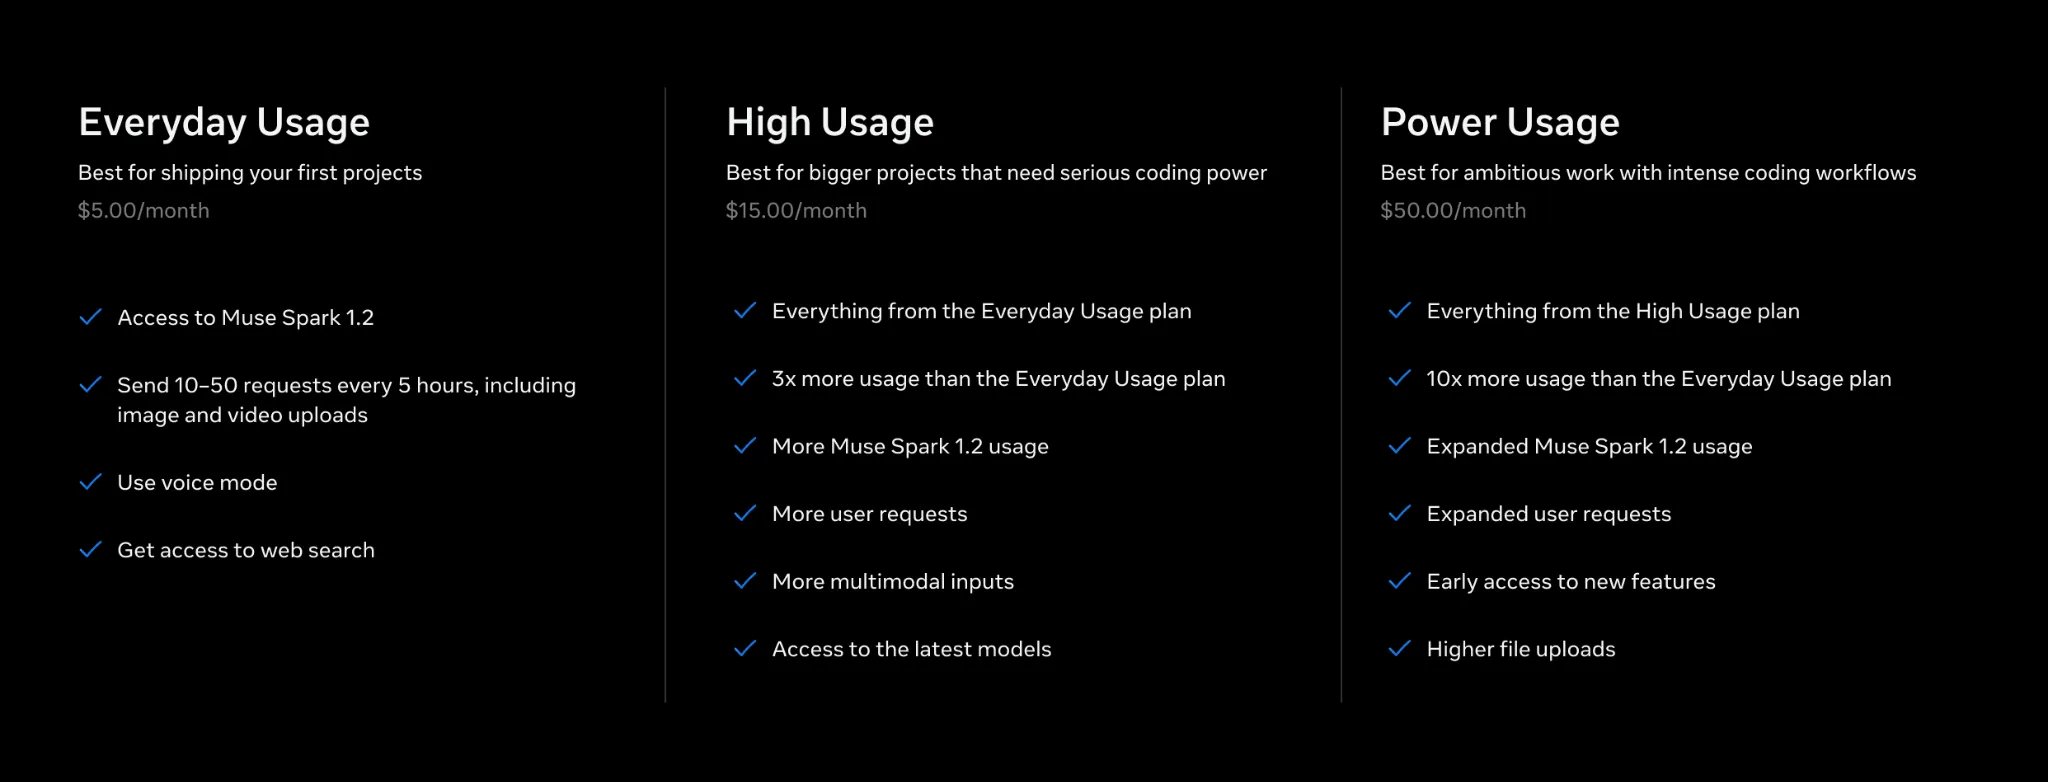
앞 토픽과 나란히 놓으면 대비가 분명합니다. 가격은 5달러에서 50달러로 열 배 오르고 표기도 10배인데, 5시간 창이라는 적용 구간을 첫 칸에 밝혀 뒀습니다. 다만 상위 두 칸은 다시 배수로만 적혀 있어서, 실제로 주간 몇 건인지는 여전히 사용자가 세어 봐야 합니다. 같은 날 법정 서류가 돌던 것을 생각하면 표기 방식 자체가 경쟁 요소가 되어 가는 흐름이 보입니다.
가격 자체도 낮은 편입니다. 최저 요금제가 월 5달러이고 최상위가 50달러인데, 경쟁 도구들이 100~200달러대에서 시작하는 것과 견주면 진입 구간을 아래로 넓힌 셈입니다. SDK를 함께 연 것도 도구가 아니라 기반으로 쓰이길 노린 배치로 읽힙니다.
그 밖에: 에이전트 하네스 쪽도 같이 움직였습니다. OpenClaw 2.0이 공유 캔버스와 멀티플레이어 세션을 들고 나왔고, Nous Research의 Hermes Agent v0.21.0은 에이전트에 이름·얼굴·그룹 채팅을 붙였습니다.
시사점: 도구를 새로 붙일 때 확인할 첫 항목은 모델 이름이 아니라 한도의 단위입니다. 5시간·주간·월간 중 어느 창에 몇 건인지가 실제 작업 속도를 결정합니다.
#MuseCode #에이전트하네스 #요금제
출처 3🔥 @finkd🔖 @steipete🔥 @NousResearch
5. Codex가 7주 만에 600만에서 2,500만으로 갔고, 같은 날 멈췄다
- 오픈AI의 Tibo Sottiaux가 활성 사용자 2,500만을 알리며 ChatGPT Work와 Codex의 유료 구독 사용량을 전부 리셋했다고 밝혔습니다.
- 공유된 그래프를 보면 2월 100만에서 5월 500만까지는 완만하다가, 7월 9일 ChatGPT Work 출시 이후 기울기가 꺾입니다. 7월 12일 600만에서 8월 29일 2,500만까지 약 7주입니다.
- 같은 날 오전 ChatGPT 공식 계정이 ChatGPT Work 장애를 공지했습니다. 수정 중이라는 짧은 사과였습니다.
성장 자체보다 그 뒤에 붙은 두 행동이 이 소식의 내용입니다. 사용량 리셋은 한도에 막힌 사용자를 풀어 주는 조치이고, 장애 공지는 그만큼 부하가 실렸다는 신호입니다. 인력도 같은 방향으로 움직였습니다 — Linear의 Nan Yu가 Codex와 ChatGPT 작업을 위해 합류했고, Kairos 창업자 두 명도 같은 조직으로 들어갔습니다.
그래프에서 눈여겨볼 지점은 2월부터 7월 초까지의 완만한 구간입니다. 여섯 달 동안 100만에서 600만까지 가던 제품이 그다음 7주에 1,900만을 더했습니다. 성장을 만든 게 코딩 도구 자체가 아니라 그 위에 얹힌 작업 환경이었다는 뜻입니다.
그 밖에: Simon Willison은 ChatGPT Work가 일반 ChatGPT와 무엇이 다른지 정리했습니다. 인터넷이 되는 코드 실행 환경, 헤드리스 Chrome, 세션 간 유지되는 파일 시스템, 예약 실행 같은 항목을 꼽았습니다.
시사점: 사용량 리셋이 걸린 지금이 Codex·ChatGPT Work의 한도를 실제 작업으로 재 보기 좋은 시점입니다. 리셋은 일회성이라 다음 주기의 체감은 다시 달라집니다.
#Codex #ChatGPTWork #오픈AI
출처 5🔥 @petergostev💬 @ChatGPT🔖 @simonw🔥 @thenanyu💬 @bamitsmanas
6. 🆕 그 밖의 신기능·신제품
- 구글 리서치가 시계열 기초 모델 TimesFM-3를 냈습니다. 한 번의 순방향 패스로 여러 계열을 동시에 예측하는 다변량 구조입니다.
- Runway가 인터페이스를 코드 없이 프레임 단위로 생성하는 연구 Solaris를 공개했습니다. 조기 접근 신청을 함께 열었습니다.
- FFmpeg에 NVIDIA GPU 프레임 보간이 정식 통합됐습니다. Vulkan 경로로 우회해 3년 묵은 라이선스 문제를 피했습니다.
세 소식의 공통점은 생성 대상이 텍스트 바깥으로 나갔다는 것입니다. 숫자 계열과 화면, 영상 프레임이 각각 모델이 직접 만드는 산출물이 됐습니다. FFmpeg 사례는 조금 다른 교훈인데, 기술은 3년 전에 완성돼 있었고 없었던 건 오픈소스가 정면으로 가져올 수 있는 경로였습니다.
연구 단계와 제품 단계가 같은 주에 섞여 나오는 것도 요즘의 특징입니다. TimesFM-3는 벤치마크와 블로그를 갖춘 발표이고 Solaris는 조기 접근 신청만 받는 연구인데, 타임라인에서는 나란히 놓입니다. 무엇을 지금 쓸 수 있는지는 각자 확인해야 합니다.
그 밖에: 앤스로픽 해커톤 우승자가 Claude Code 환경을 통째로 공개했습니다. 서브에이전트 68개와 스킬 286개를 MIT 라이선스로 열었습니다.
시사점: 예측·대시보드를 다루는 팀이라면 TimesFM-3를 기존 통계 모델과 같은 데이터로 한 번 돌려 보는 게 비용 대비 확인이 빠릅니다. 다변량 입력을 그대로 받는 점이 실무에서 갈리는 지점입니다.
#TimesFM #Runway #FFmpeg
출처 3🔖 @GoogleResearch🔥 @runwayml🚀 @joho_no_todai
📊 감정/온도 분석
💼 오늘의 실무 팁 — 쉽게 풀어 쓴 사용법 6가지
1. 요금제는 배수가 아니라 창의 길이로 비교하세요 "20배"는 대개 5시간짜리 짧은 구간에만 적용되고, 일주일 단위로는 훨씬 작아집니다. 결제 전에 주간 한도를 따로 물어보면 실제 작업량이 계산됩니다.
2. 사용량이 리셋된 주에 한도를 실측해 두세요 오픈AI가 유료 구독 사용량을 초기화했으니 지금이 평소 작업으로 며칠을 버티는지 재 볼 기회입니다. 그 숫자가 다음 요금제 결정의 근거가 됩니다.
3. EU 이용자가 있으면 연말 시한을 캘린더에 넣으세요 지정된 서비스는 12월 말까지 추가 의무를 이행해야 합니다. 회사가 그 서비스를 업무에 쓴다면 약관 변경 공지가 그 무렵 몰려올 수 있습니다.
4. 사내 데이터가 많다면 오픈 웨이트 계속학습을 견적 내 보세요 Thomson Reuters는 4,000만 달러로 자기 분야 모델을 만들었습니다. 규모를 줄여도 구조는 같습니다 — 공개 모델을 받아 자기 데이터로 이어서 학습시키는 방식입니다.
5. 새 코딩 도구는 SDK 유무부터 확인하세요 Muse Code처럼 자기 에이전트를 얹을 수 있으면 도구를 바꿔도 만들어 둔 작업 흐름을 옮길 수 있습니다. 없으면 그 도구 안에서만 쓰는 설정이 됩니다.
6. 시계열 예측은 기초 모델을 후보에 넣으세요 TimesFM-3처럼 여러 계열을 한꺼번에 받는 모델은 계열마다 따로 만들던 기존 방식을 줄여 줍니다. 기존 데이터로 한 번 돌려 비교하면 됩니다.
📦 확인 방식 이용자 수와 지정 요건은 EU 집행위원회 발표를, 사용 시간·단가는 6월 제출 소장의 표를, 훈련비와 기반 모델은 Thomson Reuters 관련 보도를 근거로 삼았습니다. 각 항목은 원 출처를 열어 확인했으나 외부 독립 검증 전입니다.
🏷 라벨 가이드 — 🔥 널리 퍼짐 · 🔖 저장 많음 · 🔁 인용·확산형 · 💬 논쟁형 · 🚀 작은 계정에서 크게 퍼짐