오늘의 AI 브리핑 ·
값은 그대로, 청구서는 40% 더
5분 브리핑
약 3분 · 12개 흐름핵심만 먼저 읽고, 궁금한 소식은 본문으로 이어 보세요.
전체 분석 19분으로 바로 가기 ↓- Gemini 3.8 Flash가 값을 그대로 둔 채 3주 만에 다시 올라섰고, Flash Cyber가 함께 나왔다
구글이 Gemini 3.8 Flash를 내놨습니다. 입력 100만 토큰당 $0.75, 출력 $3.75로 3주 전 3.7 Flash와 같은 값인데, 이건 연말까지만 유지되는 할인가입니다.
- Muse Spark 1.3이 Gemini 3.8 Flash 네 시간 뒤에 나와 DeepSWE 75.4를 찍었다
메타가 09-03 04:28 KST에 Muse Spark 1.3을 Muse Code와 Meta Model API에 열었습니다. 구글이 Gemini 3.8 Flash를 공개하고 세 시간 45분 뒤였고, 2분 뒤 OpenCode Go에도 올랐습니다.
- Qwen3.8-Max-0902가 Code Arena 1위로 데뷔했고 14시간 뒤 Fable 5.1에 밀렸다
9월 2일 오전 11시 24분, Qwen3.8-Max-0902가 Code Arena: WebDev 전체 1위로 1691점에 데뷔했습니다. Opus 5 (Max)보다 3점, Kimi K3 (Max)보다 17점, 직전 Qwen3.8-Max보다 22점 위였습니다.
- Qwen3.8-27B가 그래픽카드 한 장에 262k 컨텍스트를 통째로 얹었다
EXL3 양자화본이 나왔습니다. 가중치 14.2GB에 MTP 초안 헤드와 NVFP4 KV 캐시를 얹어, RTX 3090/4090 한 장(24GB)에서 262k 컨텍스트 전량 상주가 된다는 게 배포자 설명입니다.
- Claude가 Cowork과 Code에서 백그라운드로 컴퓨터를 쓰기 시작했다
화면을 넘기지 않고 일합니다. Claude Cowork과 Claude Code 데스크톱 앱의 컴퓨터 사용이 백그라운드 창에서 돌기 시작했습니다.
- 미 법무부가 학습은 공정 이용이라며 오픈AI 편 의견서를 냈다
미 법무부가 오픈AI 저작권 소송에 '미합중국의 이해관계 진술서'를 내고 피고인 오픈AI와 마이크로소프트 쪽에 섰습니다. 미 정부가 AI 저작권 소송에 직접 의견을 낸 것은 알려진 한 처음입니다.
- 오픈AI 수석과학자가 Astra의 순환 깊이 논란에 직접 답했다
The Information의 스테퍼니 팔라촐로가 Astra는 "recurrent depth"(순환 깊이)라는 새 추론 방식을 쓰며, 이것이 모델의 사고 과정을 가려 감시를 어렵게 한다고 보도했습니다.
- 크라우드스트라이크가 방어자용 SafeMind를 내놨고, 뉴욕증권거래소는 Mythos로 취약점을 고쳤다
크라우드스트라이크가 9월 1일 라스베이거스 Fal.Con 2026에서 SafeMind를 열었습니다. 엔비디아 Nemotron 오픈 모델에 Falcon 센서 기록과 15년치 사고 대응 현장 자료를 얹어 사후학습했고, 공격 역할 Red Tempest와 방어 역할 Blue Solano를 한 고리에 묶어 서로를 계속 때리게 합니다.
- Wonderful이 50억 달러 가치로 5억 5천만 달러를 받았다
Insight Partners가 주도한 시리즈 C에 Salesforce가 신규 투자자로 들어왔고, Index Ventures·Bessemer·IVP·Vine Ventures·9Yards가 재투자했습니다.
- LoRA를 만든 에드워드 후가 Mercor로 옮기며 397B RL 학습 기록을 통째로 열었다
LoRA 저자 에드워드 후가 Mercor의 모델 학습·리서치 총괄로 합류했습니다. 마이크로소프트에서 LoRA를 만들고 벤지오 밑에서 박사를 마쳤습니다.
- 다이슨 CameraJet이 칫솔 안에 카메라를 넣어 치간을 찾고 0.1초 만에 헹군다
다이슨이 카메라를 심은 전동칫솔 CameraJet을 현지시간 9월 1일 내놨습니다. 미국 판매가는 499달러입니다.
- 🆕 그 밖의 신기능·신제품
Inworld Realtime TTS-2 정식 출시 — Artificial Analysis Controlled Voice Arena 1위로 복귀했습니다. P99 지연 100ms 미만, 저지연판 TTS-2 Flash는 첫 소리까지 25ms입니다.
주요 키워드 TOP 5: Gemini 3.8 Flash · Muse Spark 1.3 · Code Arena · 컴퓨터 사용 · 공정 이용 | 메인 이벤트: 구글이 값을 그대로 둔 Gemini 3.8 Flash를 내놓은 지 네 시간 만에, 메타가 Muse Spark 1.3의 파트너 전용 판으로 같은 코딩 벤치마크에서 그 위 점수를 얹었습니다.
값을 그대로 뒀다는 발표가 하루에 둘 나왔습니다. 구글은 Gemini 3.8 Flash의 단가를 3주 전 판과 같게 뒀고, 네 시간 뒤 메타도 Muse Spark 1.3의 가격표를 이전 판 그대로 두고 내놨습니다. 그런데 같은 날 외부 측정에서 3.8 Flash의 과제당 비용은 $0.40에서 $0.58로 올랐습니다. 단가가 아니라 모델이 한 과제에 쓰는 토큰이 늘었기 때문인데, 값을 비교하는 자리가 가격표에서 청구서로 옮겨간 하루였습니다.
1. Gemini 3.8 Flash가 값을 그대로 둔 채 3주 만에 다시 올라섰고, Flash Cyber가 함께 나왔다
- 구글이 Gemini 3.8 Flash를 내놨습니다. 입력 100만 토큰당 $0.75, 출력 $3.75로 3주 전 3.7 Flash와 같은 값인데, 이건 연말까지만 유지되는 할인가입니다. 2027년 1월 1일부터는 두 배인 $1.50/$7.50이 붙습니다.
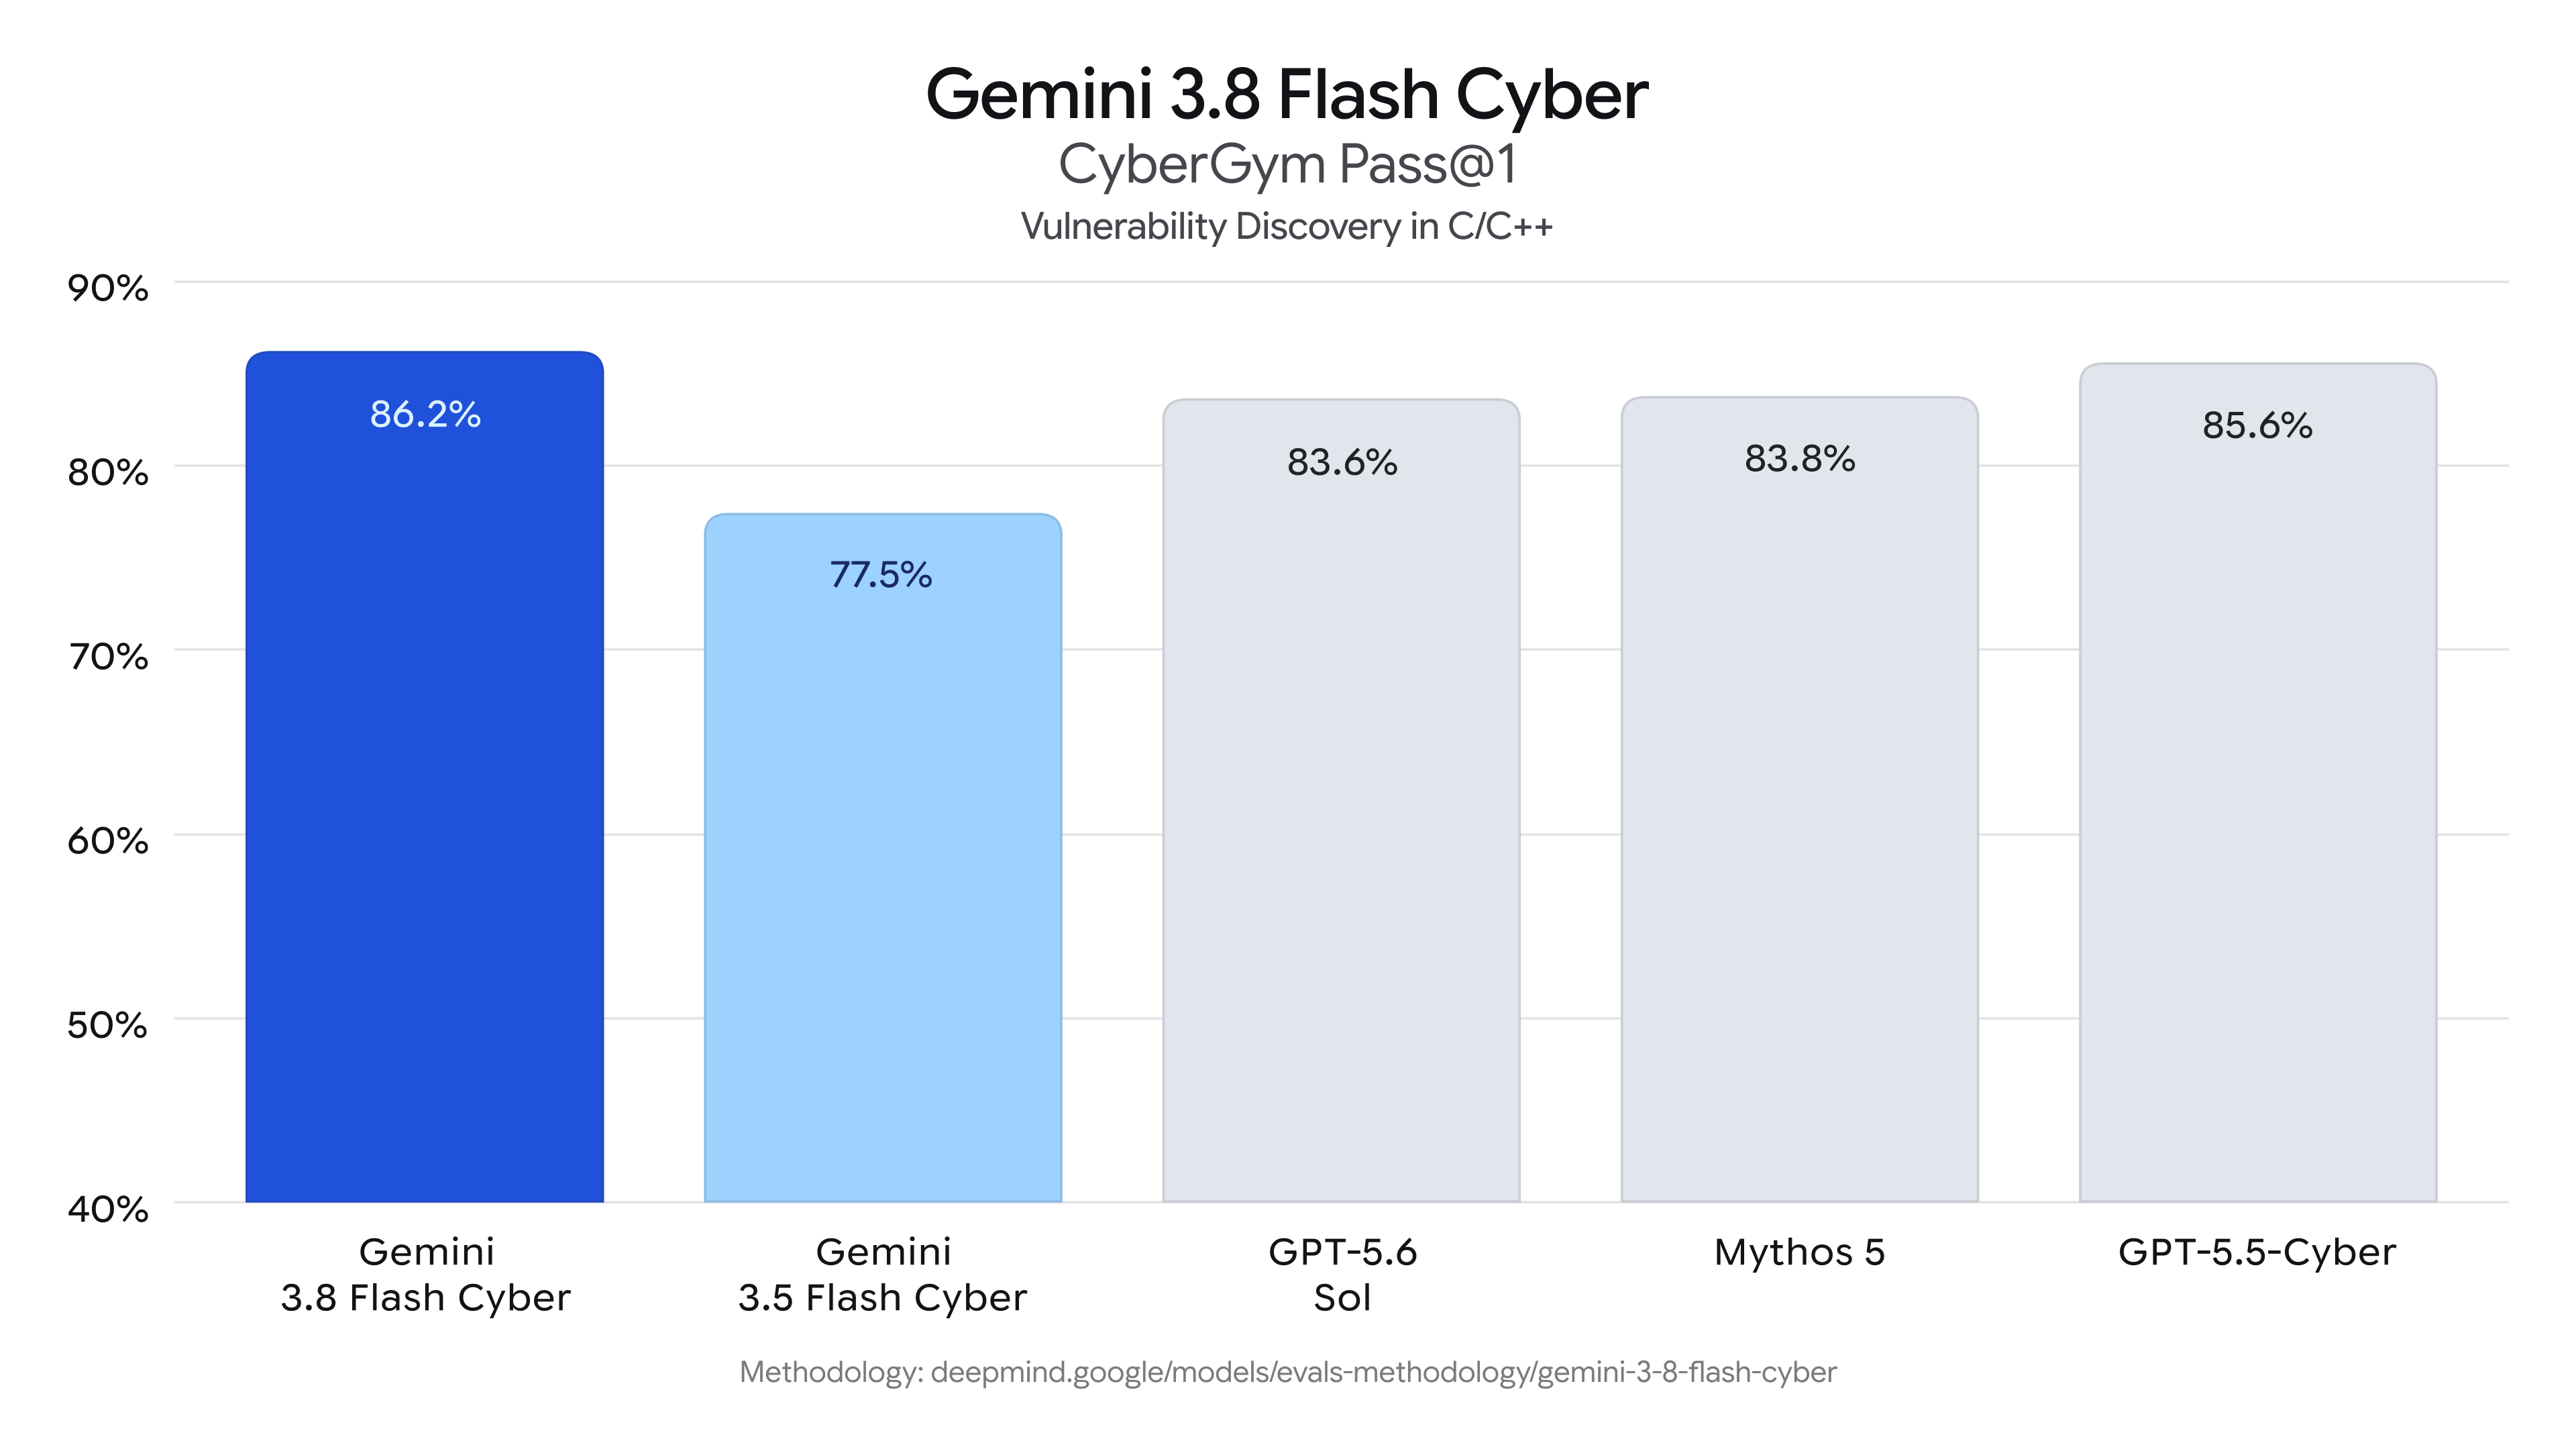
- 같은 날 나온 Gemini 3.8 Flash Cyber는 취약점을 찾아 고치는 쪽에 특화했습니다. CyberGym 86.2%, 패치 능력을 재는 CWE-Bench pass@1 47.2%, 구글 내부 벤치마크에서는 20개 프로그래밍 언어에 걸쳐 70%가 넘는 탐지 성공률을 냈습니다.
- 배포는 당일이었습니다. Antigravity의 기본 모델로 들어갔고 Cursor·AI Studio·Gemini API와 Gemini 앱의 AI Pro·Ultra 구독자에게 함께 열렸습니다. 단 Flash Cyber는 Fairwind 프로그램에 든 방어자에게만 열렸습니다.
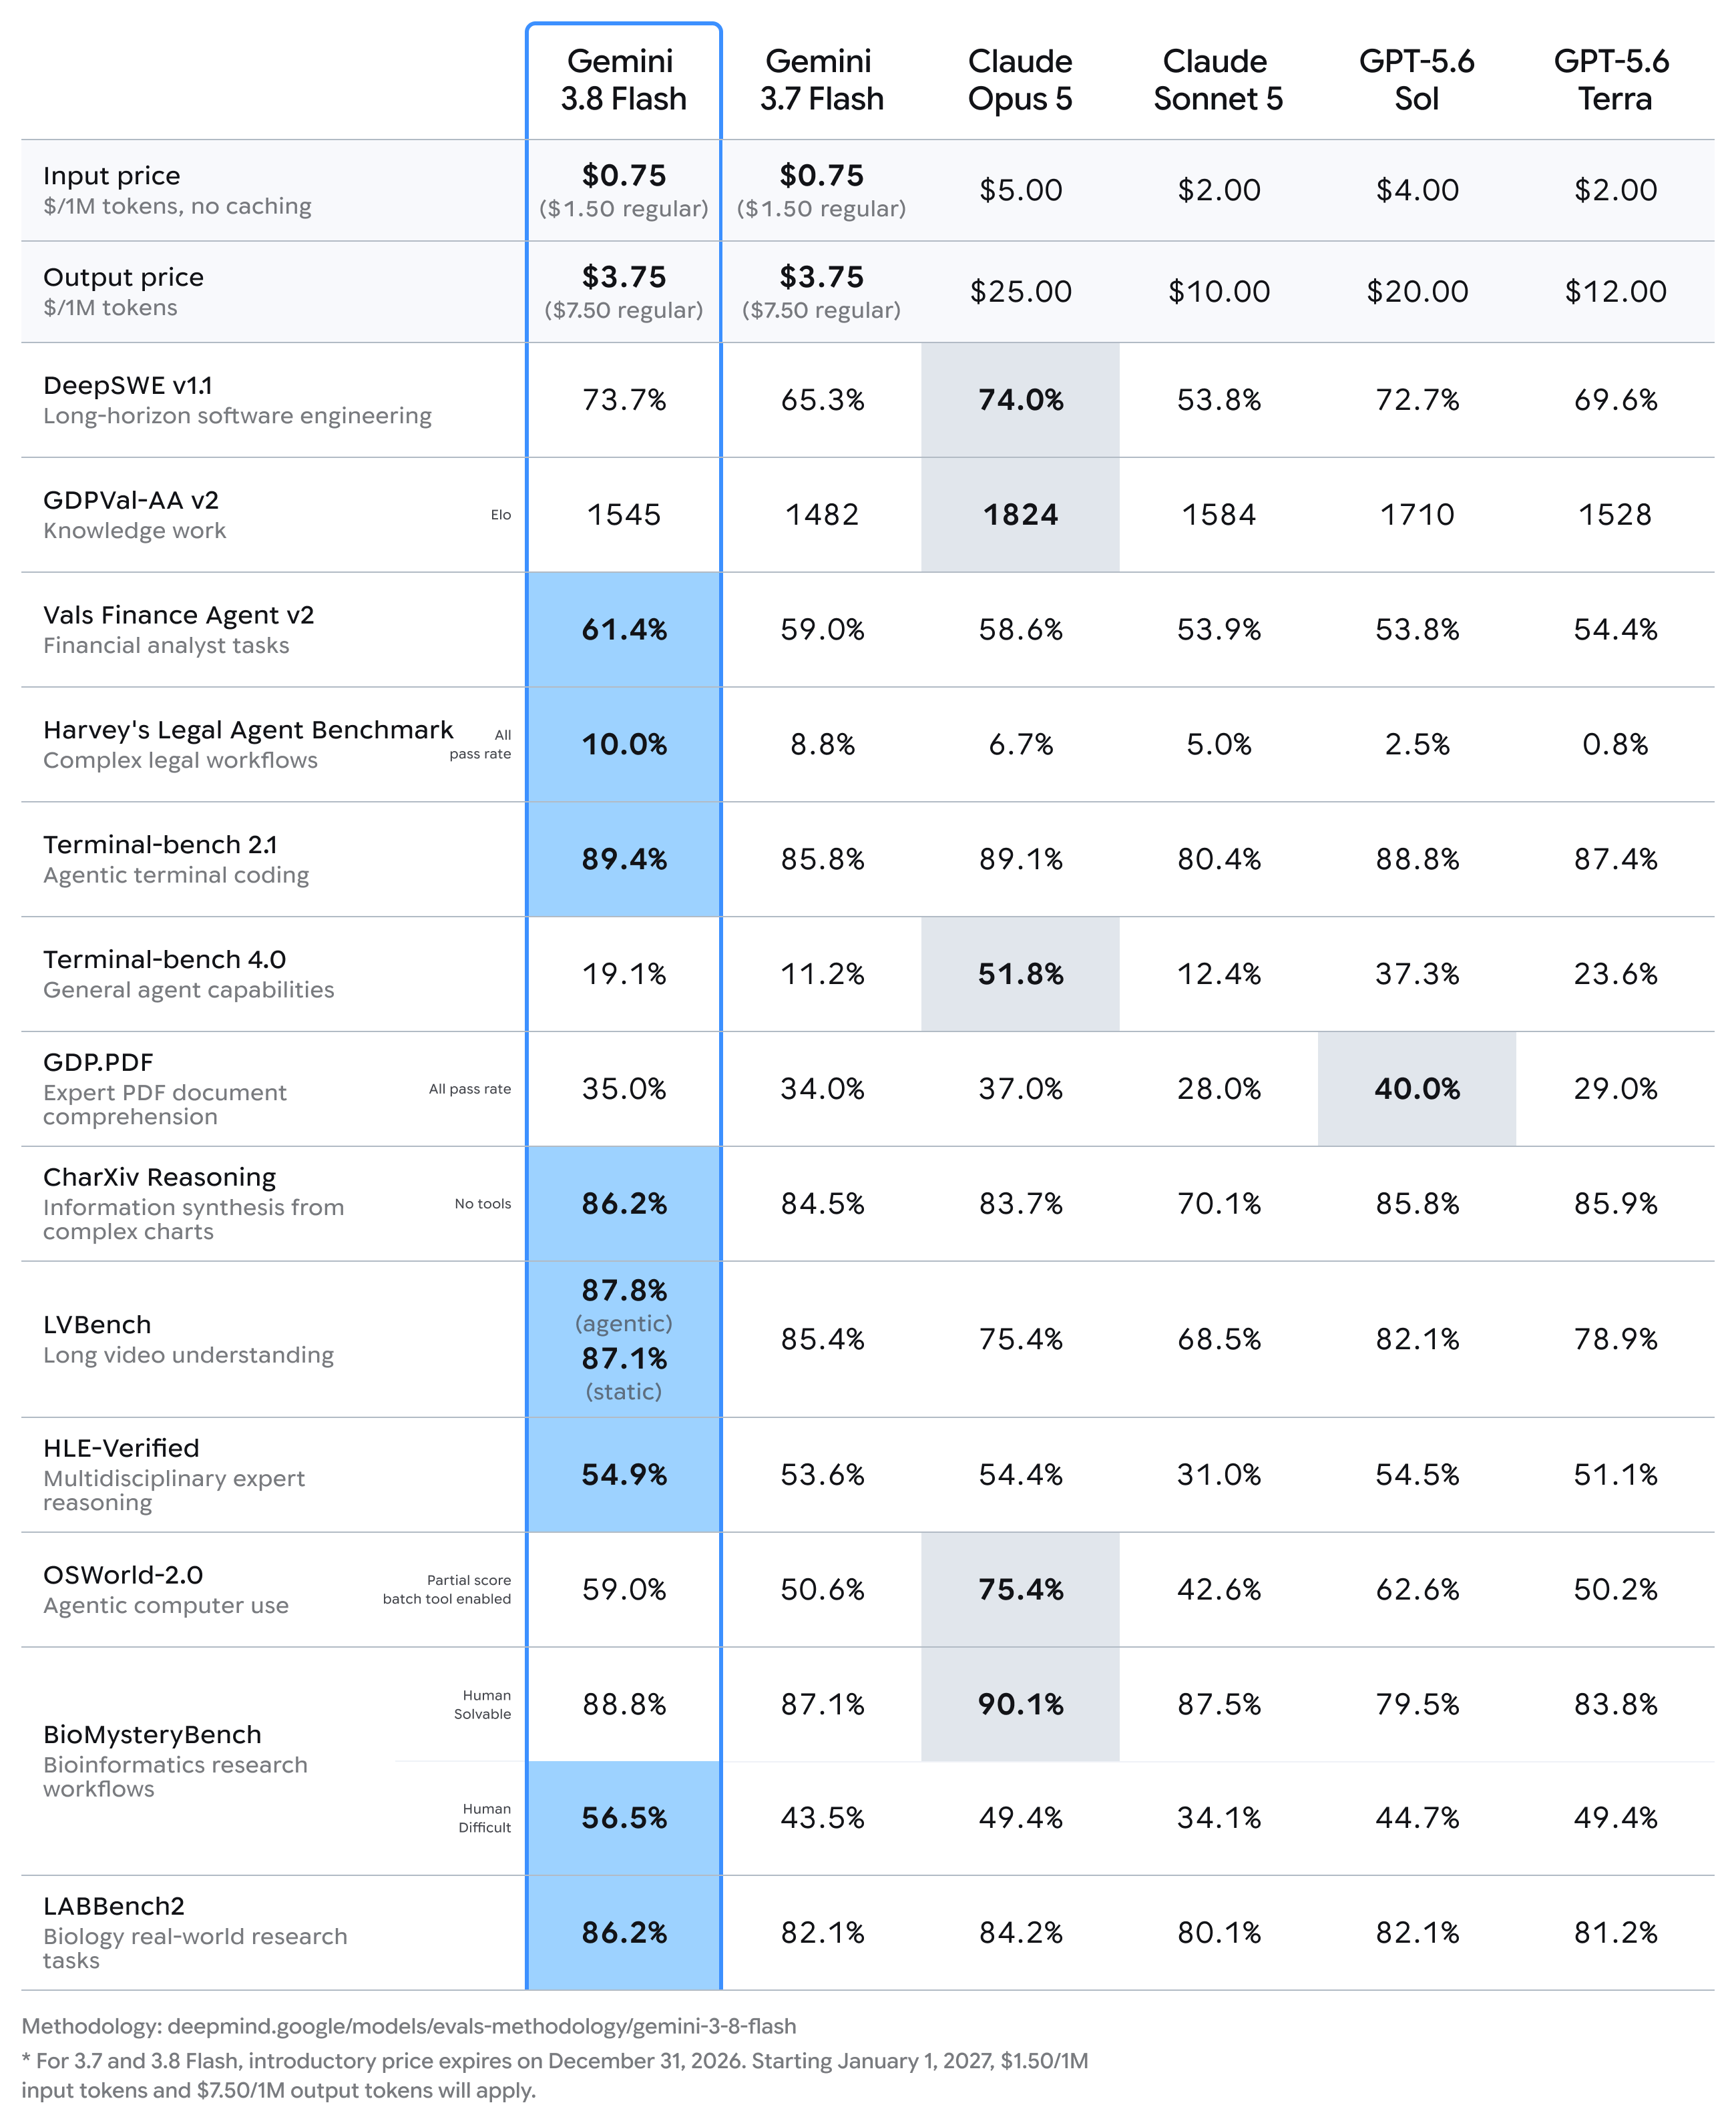
값을 그대로 뒀다는 문구가 이 발표의 핵심처럼 읽히지만, 지갑에서 나가는 돈은 그렇지 않습니다. Artificial Analysis 측정에서 3.8 Flash는 지능지수 59로 3.7 Flash보다 3점 올라 GPT-5.6 Sol(xhigh)·Grok 4.6(medium)과 동률에 섰고 Intelligence vs Cost 파레토 프론티어에 들어갔습니다. 그런데 같은 표에서 과제당 비용은 $0.40에서 $0.58로 약 40% 늘었습니다. 토큰 단가는 한 글자도 안 바뀌었는데, 모델이 과제마다 평균 4만 8천 토큰까지 출력을 30% 더 쓰고 에이전트 평가에서 턴을 더 돌기 때문입니다. 필립 슈미트는 이 모델이 걸음을 잘게 쪼개고 자기 작업을 더 자주 검증한다고 설명했는데, 그 습관의 청구서가 곧 저 40%입니다.
Flash Cyber 쪽은 성능보다 문턱이 눈에 띕니다. 구글은 이 모델을 일반 공개하지 않고 Fairwind 프로그램의 검증된 방어자에게만 열었으며, 그중 정부 기관·핵심 인프라 운영자·소프트웨어 유지보수자에게 우선 접근권을 줬습니다. 최상위 사이버 능력을 심사받은 조직에만 여는 방식은 오픈AI와 앤스로픽이 이미 택한 길이고, 구글이 여기 합류하면서 공격과 방어에 똑같이 쓰이는 능력은 값이 아니라 자격으로 배급되는 물건이 됐습니다.
그 밖에: 데미스 허사비스는 Flash Cyber가 사이버 방어의 프론티어를 민다고 적었고, Artificial Analysis는 이 모델을 4개월 안에 나온 네 번째 Flash 모델로 셌습니다.
시사점: 값이 그대로라는 말을 보면 청구서도 그대로일 것 같지만, 에이전트 모델의 값은 단가가 아니라 소비량이 정합니다. 도입을 검토한다면 단가표 대신 실제 과제 하나를 돌려 본 비용으로 비교하고, 연말 이후 두 배가 되는 정가를 기준으로 계산해 두는 편이 안전합니다.
#Gemini38Flash#FlashCyber#에이전트비용
출처 10🔥 @Google🔥 @OfficialLoganK🔥 @GoogleAIStudio🔥 @sundarpichai🔥 @OfficialLoganK🔥 @ArtificialAnlys🔥 @demishassabis🔥 @antigravity🔥 @cursor_ai🔥 @_philschmid
2. Muse Spark 1.3이 Gemini 3.8 Flash 네 시간 뒤에 나와 DeepSWE 75.4를 찍었다
- 메타가 09-03 04:28 KST에 Muse Spark 1.3을 Muse Code와 Meta Model API에 열었습니다. 구글이 Gemini 3.8 Flash를 공개하고 세 시간 45분 뒤였고, 2분 뒤 OpenCode Go에도 올랐습니다.
- 메타가 글로 밝힌 정량 수치는 점수가 아니라 절약이었습니다. 내부 비교에서 1.2 대비 도구 호출 20% 감소, 토큰은 25% 줄었다고 적었습니다.
- 성격도 손봤습니다. 막히면 스스로 알리고, 되돌릴 수 없는 작업 전에 확인을 구하며, 모르는 것을 지어내는 대신 자기 한계를 인정하도록 조정했습니다.
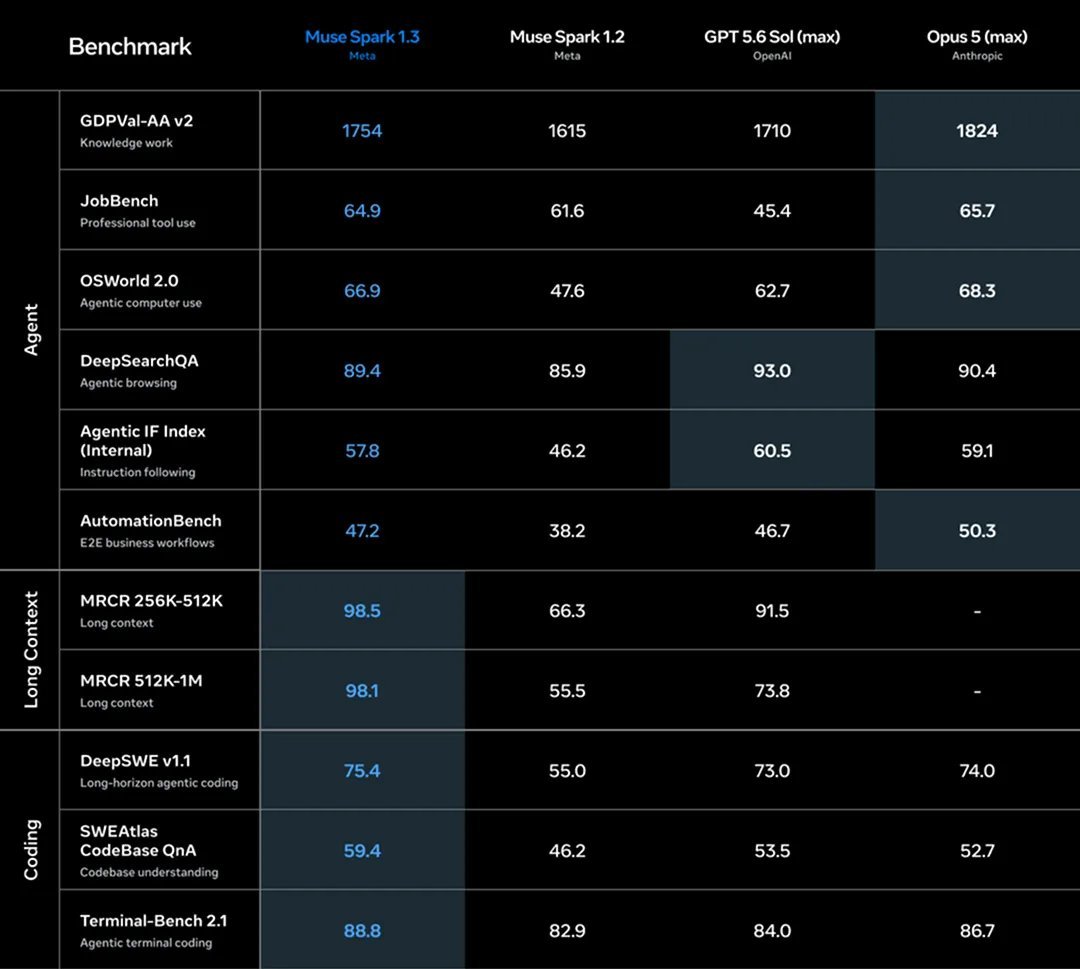
75.4는 남이 옮겨 적은 값이 아니라 메타 공식 계정이 발표에 함께 붙인 표에 그대로 있습니다. 다만 그 판본에서 해당 열은 파트너에게만 열린 max 변형으로 적혀 있고, 지금 누구나 쓸 수 있는 건 xhigh입니다. 비교 대상 열도 1.2(xhigh)여서, 55.0에서 75.4로 뛴 그 폭은 서로 다른 변형을 나란히 둔 값입니다. 몇 시간 앞서 구글이 같은 DeepSWE 1.1에서 올린 73.7%와 나란히 놓고 읽되, 메타 쪽 값에는 아직 아무나 만질 수 없는 변형의 것이라는 단서를 달아 두는 편이 맞습니다.
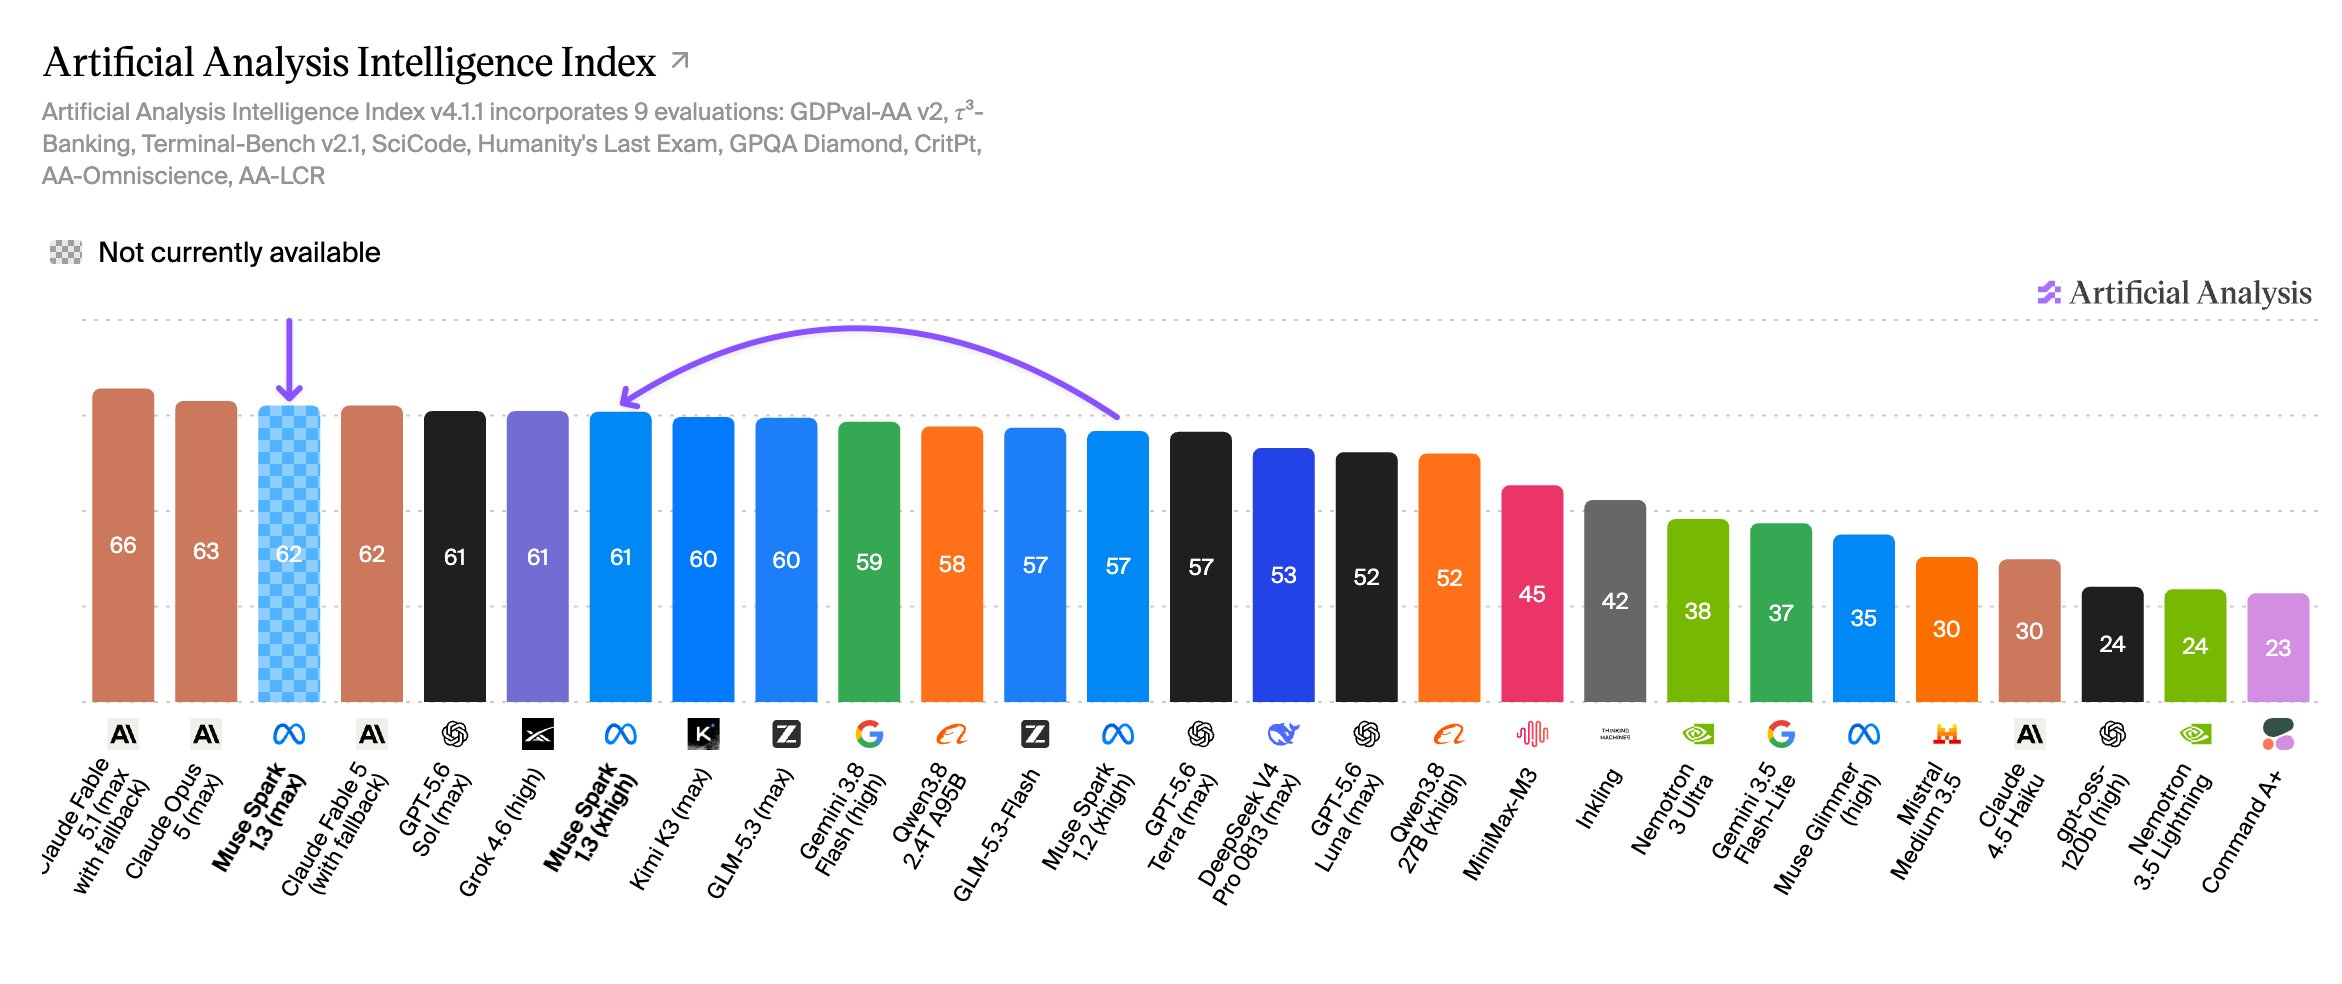
다섯 달 사이 네 번째 Muse Spark인데도 가격표가 그대로라는 점이 실속입니다. Artificial Analysis Intelligence Index에서 지금 쓸 수 있는 xhigh는 61점으로 GPT-5.6 Sol(max)·Grok 4.6(high)과 동률인데, 과제 하나를 끝내는 비용은 $0.55로 두 모델의 $0.95·$0.94보다 40% 남짓 쌉니다. 100만 토큰당 $1.25/$4.25, 캐시된 입력 $0.15로 1.2와 같은 값을 유지했으니, 도구 호출과 토큰이 줄었다는 설명이 맞다면 청구되는 값은 가격표보다 더 내려갑니다.
그 밖에: 파트너 전용 max 변형은 62점으로 Claude Fable 5.1·Claude Opus 5 다음입니다. 대신 AA-LCR(긴 문서 추론)은 두 변형 모두 1.2보다 4점 내려갔고, xhigh의 과제당 비용은 1.2의 $0.40보다 올랐습니다. 반대로 긴 문맥은 크게 벌어져 MRCR 512K~1M이 98.1로 1.2의 55.5를 앞섰습니다.
시사점: 같은 날 같은 벤치마크에서 두 회사가 2점 안쪽으로 붙었습니다. 이제 고를 기준은 점수표가 아니라 과제 하나에 드는 값이며, 그 값은 표가 아니라 청구서에서 드러납니다.
#MuseSpark#에이전트코딩#모델경쟁
출처 9🔥 @AIatMeta🔥 @shengjia_zhao🔥 @MetaforDevs🔥 @ArtificialAnlys🔥 @kimmonismus🔥 @synthwavedd🔥 @opencode🔥 @OfficialLoganK🔥 @OfficialLoganK
3. Qwen3.8-Max-0902가 Code Arena 1위로 데뷔했고 14시간 뒤 Fable 5.1에 밀렸다
- 9월 2일 오전 11시 24분, Qwen3.8-Max-0902가 Code Arena: WebDev 전체 1위로 1691점에 데뷔했습니다. Opus 5 (Max)보다 3점, Kimi K3 (Max)보다 17점, 직전 Qwen3.8-Max보다 22점 위였습니다.
- 14시간 33분 뒤인 3일 새벽 1시 57분, Fable 5.1 (Max)이 1765점으로 1위를 가져갔습니다. 2위 Qwen과 77점, 3위 Opus 5 (Max)와 78점 차이고, 직전 Fable 5 (Max)는 1628점으로 8위였습니다.
- 입력·출력을 섞은 혼합 단가는 Fable 5.1이 100만 토큰당 40달러, Qwen이 5달러입니다. 값은 8배인데 점수 차는 4.6%입니다.
09-03 새벽 기준으로 arena.ai 순위표를 열면 투표 수가 이 소동을 설명합니다. 1위 Fable 5.1은 1,106표에 오차 ±23, 2위 Qwen은 1,472표에 ±18, 3위 Opus 5는 10,583표에 ±8입니다. 데뷔 때 내세운 3점 차 1위는 애초에 오차 안이었고, 표가 더 쌓이는 사이 Qwen은 1691점에서 1688점으로 내려앉아 Opus 5와 1점 차가 됐습니다. 반대로 77점은 어느 구간으로도 겹치지 않습니다.
그래서 남는 질문은 등수가 아니라 값입니다. 8배를 내고 사는 것이 4.6%의 점수 차인데, 그 차이가 각자의 작업에서 어떻게 나타나는지는 순위표가 말해 주지 않습니다. 표가 열 배 가까이 쌓인 Opus 5의 ±8과 이제 막 천 표를 넘긴 두 모델의 ±20 안팎을 나란히 두면, 지금 순위는 아직 굳지 않은 상태입니다.
그 밖에: 알리바바는 코딩·협업 쪽 사후 학습을 더한 갱신이라고 설명했고, 100만 토큰당 입력 2달러·출력 6달러라는 가격은 직전 판과 같습니다.
시사점: 리더보드 한 줄로 모델을 갈아타려면 점수보다 투표 수와 오차 구간을 먼저 보세요. 하루 만에 뒤집히는 3점보다, 8배를 내고 4.6%를 살지가 각자 작업으로 재야 할 문제입니다.
#CodeArena#Qwen38Max#리더보드
출처 4🔥 @arena🔥 @arena🔥 @alibaba_cloud🔥 @kimmonismus
4. Qwen3.8-27B가 그래픽카드 한 장에 262k 컨텍스트를 통째로 얹었다
- EXL3 양자화본이 나왔습니다. 가중치 14.2GB에 MTP 초안 헤드와 NVFP4 KV 캐시를 얹어, RTX 3090/4090 한 장(24GB)에서 262k 컨텍스트 전량 상주가 된다는 게 배포자 설명입니다. 혼합 어텐션에 48층 저비용 순환 상태를 더해 장문 추론 비용을 눌렀다고 합니다.
- GGUF 15종은 실측으로 갈렸습니다. 1억 5천만 토큰을 돌린 벤치마크에서 Q4·IQ3 여럿이 BF16 정확도의 95% 회복선을 지키며 11~14GB에 들어왔습니다. 11GB 아래부터는 득실 계산이 단순하지 않아졌고, Q1까지 내려갈 바엔 더 작은 모델을 건강하게 양자화한 쪽이 낫다는 결론입니다.
- 속도는 MTP가 벌어 줍니다. Escha가 2-bit 판에 추측 디코딩을 켜자 RTX 4090이 67.3에서 129.3 tok/s로 1.92배 빨라졌습니다. 모델에 딸린 헤드를 쓰므로 별도 드래프트 모델이 필요 없습니다.
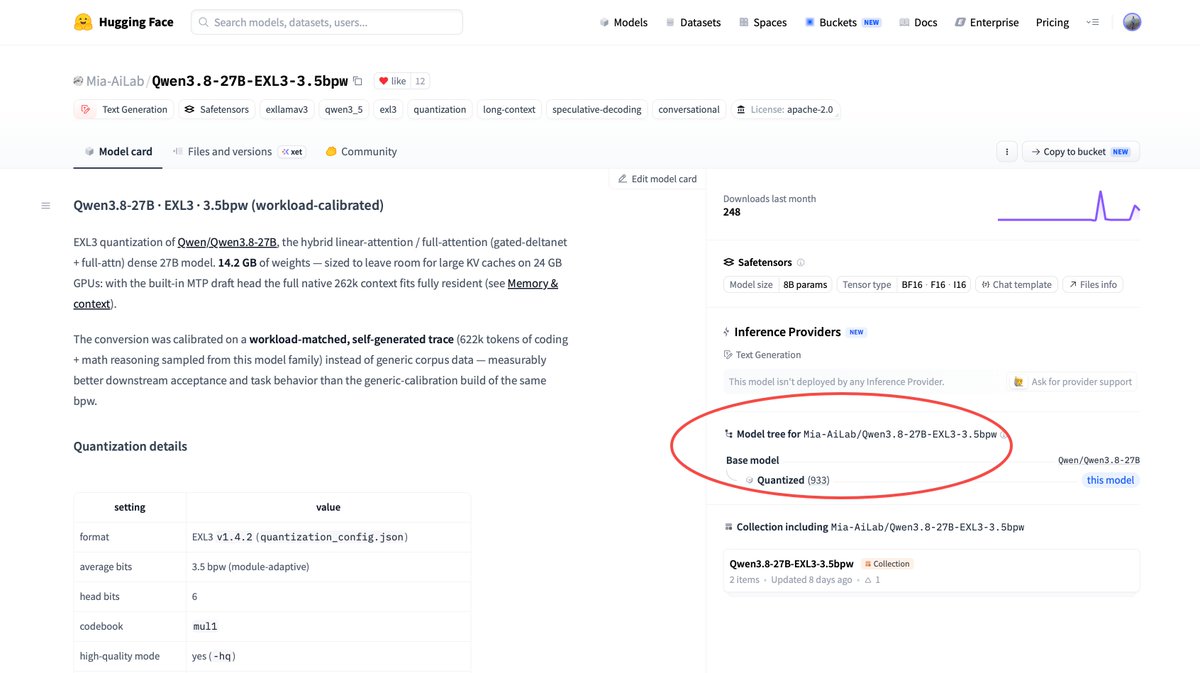
로컬 실행의 병목은 진작 가중치에서 컨텍스트로 옮겨 갔습니다. 27B 가중치야 24GB에 들어가지만 262k를 채울 KV 캐시가 카드를 먼저 잡아먹어서, 긴 문서를 물리는 순간 다시 서버로 나가야 했습니다.
캐시를 NVFP4로 눌러 담아 그 자리를 만들고, 남은 여유를 MTP가 속도로 바꾸는 것이 이번에 맞춰진 조합입니다. 게이머용 카드 한 장으로 레포 전체를 읽히는 일이 실험이 아니라 설정값 문제로 내려왔습니다.
그 밖에: 메이투안의 LongCat-2.0(1.6T MoE·활성 약 48B·1M 컨텍스트)이 Cline 무료 모델로 열렸고, Unsloth는 Qwen3.8-Flash-Next를 MTP로 1.3~1.7배 끌어올려 RTX PRO 6000에서 170 tok/s를 냈습니다. OrcaRouter는 DeepSeek V4 Flash Vision의 abliterated GGUF를 공개했고, 별개로 Qwen3.8-27B의 16GB 카드 대응이 예고됐습니다.
시사점: 24GB 한 장으로 262k를 붙잡을 수 있다면 긴 코드베이스를 다루는 쪽은 API 청구서를 다시 계산해 볼 만합니다. 다만 11GB 아래 양자화는 회복률부터 확인하고 고르는 게 안전합니다.
#Qwen38#로컬LLM#양자화
출처 8🔥 @Lonely__MH🔥 @bnjmn_marie🔥 @Eschalabs🔥 @UnslothAI💬 @MiaAI_lab🔥 @cline🔥 @OrcaRouter🔥 @ArtificialAnlys
5. Claude가 Cowork과 Code에서 백그라운드로 컴퓨터를 쓰기 시작했다
- 화면을 넘기지 않고 일합니다. Claude Cowork과 Claude Code 데스크톱 앱의 컴퓨터 사용이 백그라운드 창에서 돌기 시작했습니다. 허용한 앱 안에서 클릭·타이핑·앱 실행을 하는 동안 포인터를 뺏지 않아 사용자는 같은 기계로 다른 일을 합니다.
- 조건은 좁습니다. Pro·Max 베타이고 백그라운드로 도는 건 macOS 15 이상뿐입니다. 컴퓨터 사용 자체는 Windows에도 있습니다. 이미 켜 본 사람은 자동 적용, 아니면 Settings > General에서 켭니다.
- 가드레일이 같이 왔습니다. 앱마다 개별 허가를 묻고 투자·거래·암호화폐 앱은 기본 차단입니다. 송금·파일 삭제·민감정보 처리를 피하고 프롬프트 주입 징후를 알리도록 학습시켰지만, 앤스로픽은 완벽하지 않다고 적으며 의료·금융 앱에는 권하지 않습니다.
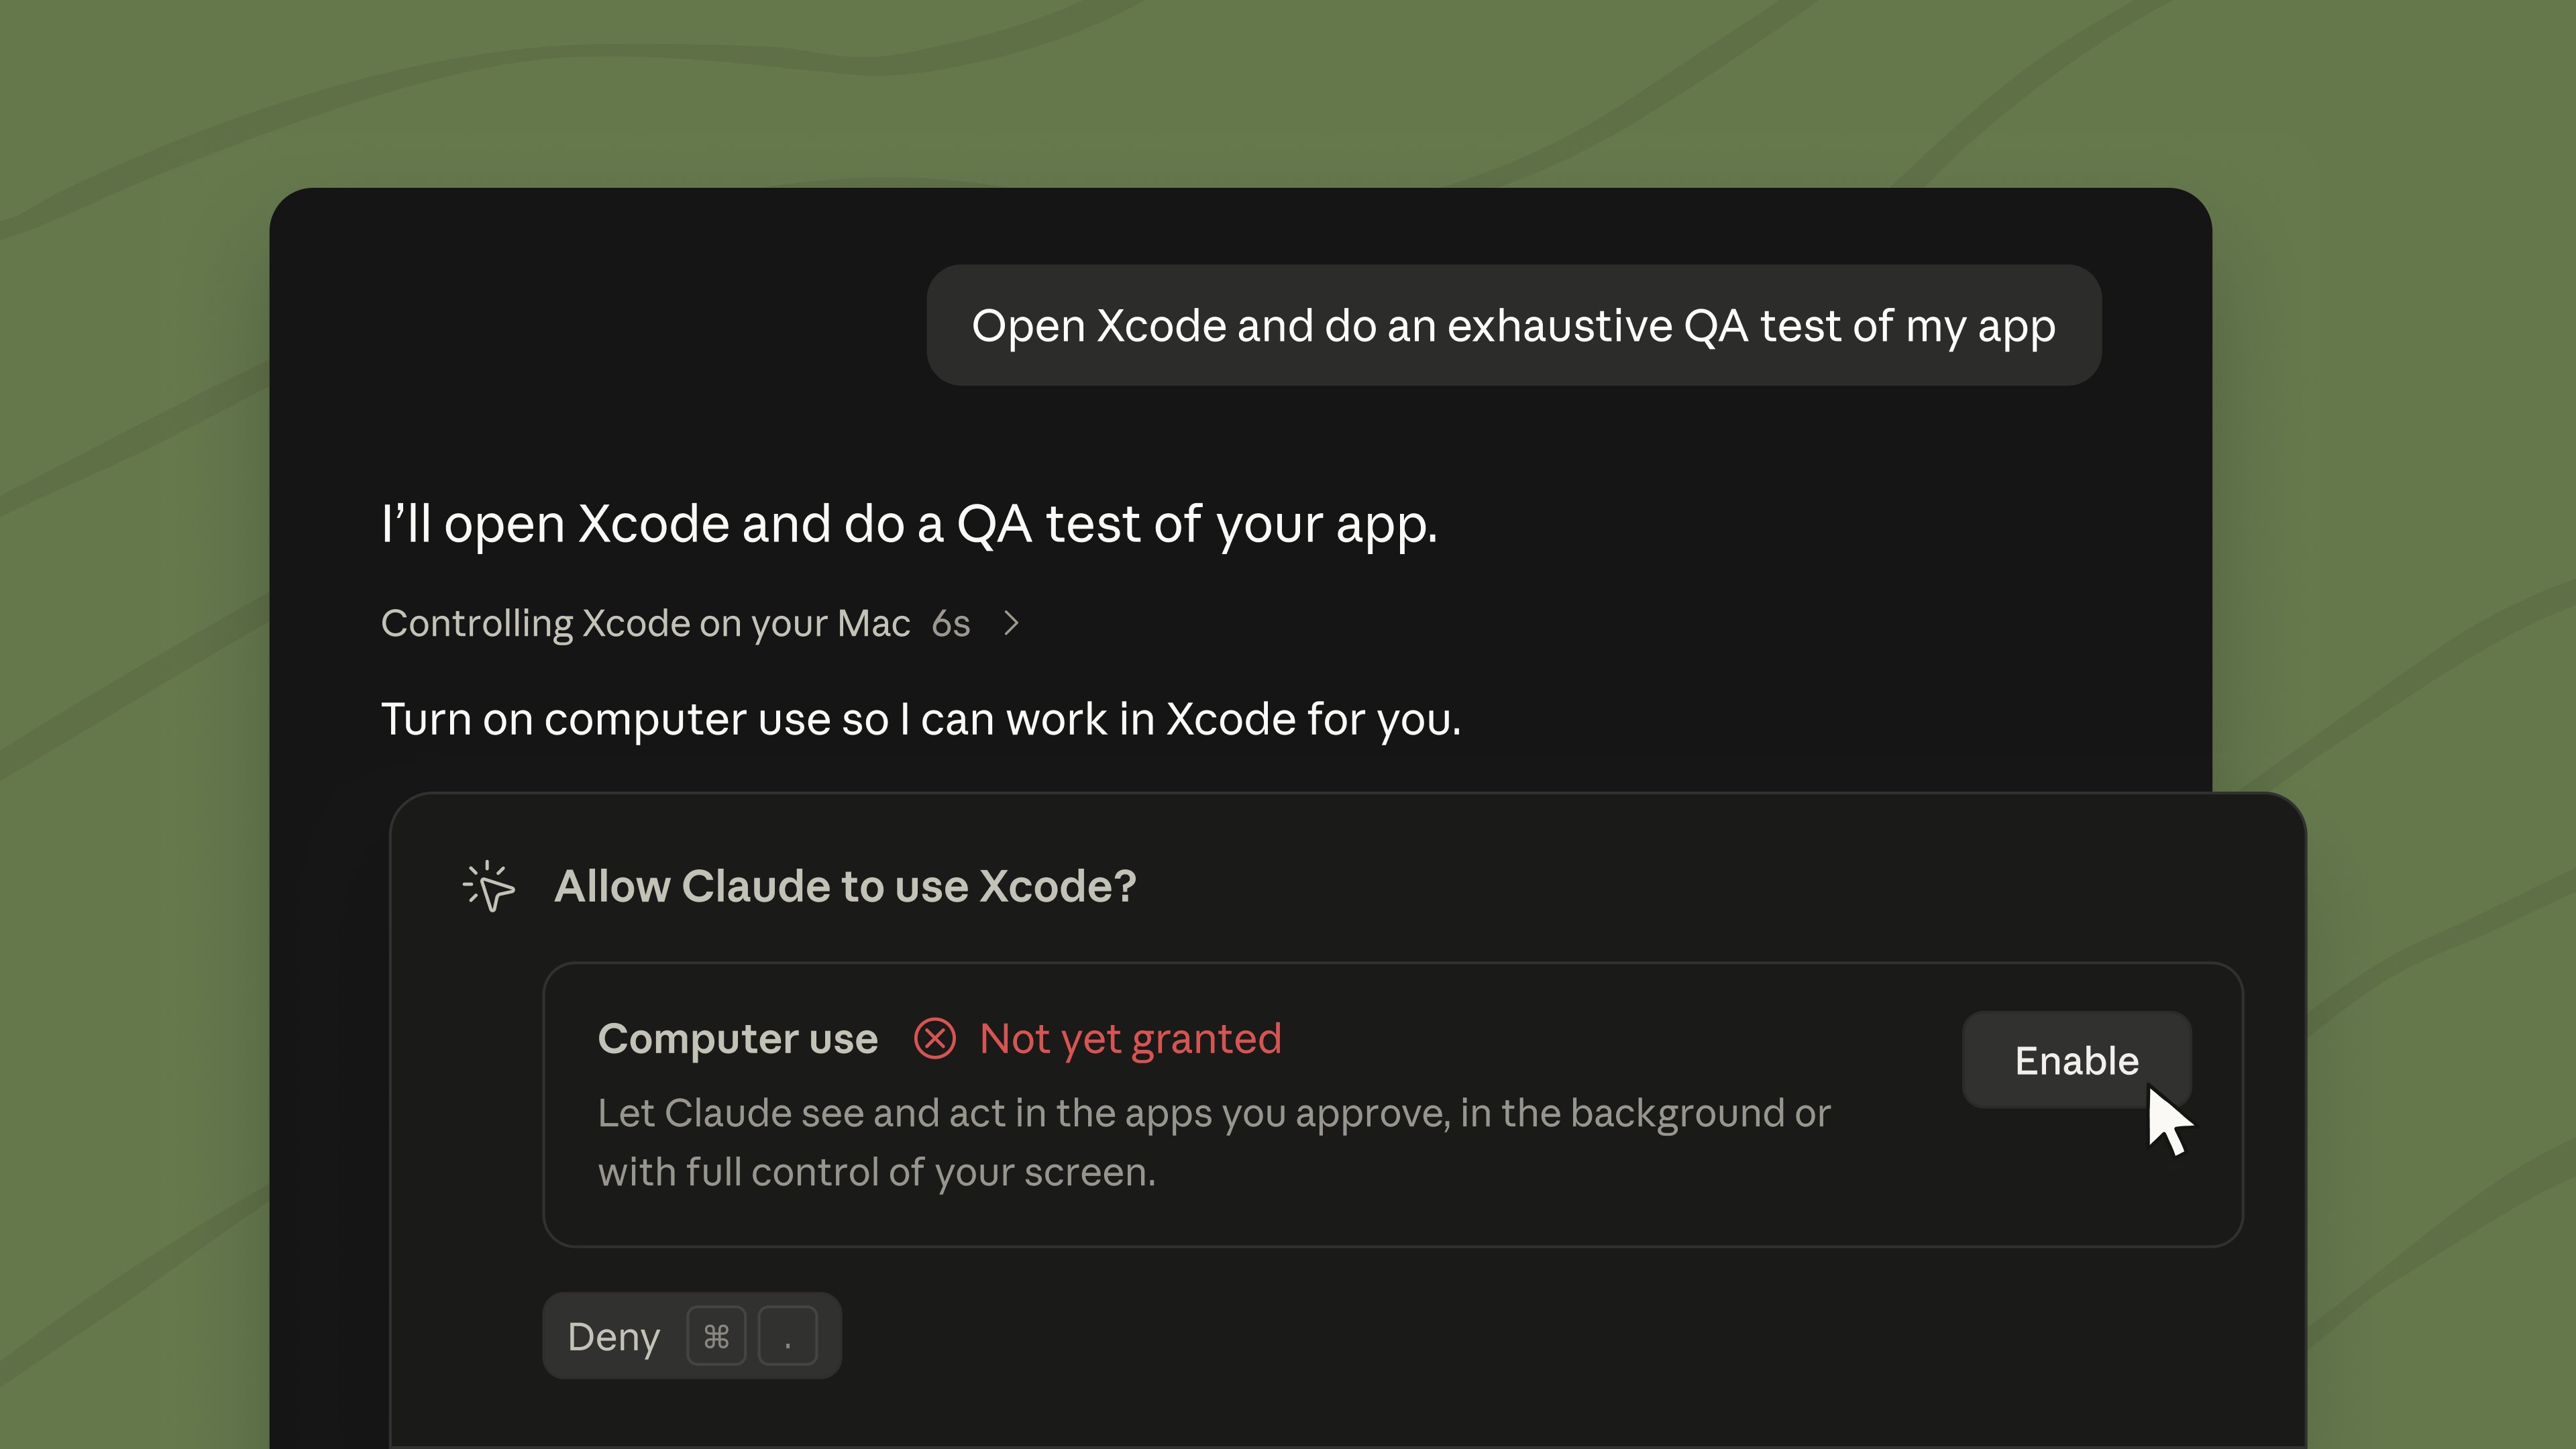
컴퓨터 사용이 데모에 머문 이유는 성능이 아니라 점유였습니다. 돌리는 동안 화면과 마우스를 통째로 내줘야 해서, 맡긴 일이 끝날 때까지 그 기계 앞에서 기다리는 것 말고 할 게 없었습니다.
백그라운드 창은 그 비용을 지웁니다. 대신 사람이 보지 않는 시간이 생기고, 위험을 판단하는 몫이 모델과 허용 목록으로 넘어갑니다. 앤스로픽이 앱 단위 허가와 기본 차단 목록을 함께 붙인 것도 그래서입니다.
그 밖에: 같은 시간대에 Claude Commerce Agents가 Apache 2.0으로 공개됐습니다. 쇼핑·머천트 에이전트 청사진에 리테일·여행·통신·엔터테인먼트 네 개 구현이 딸렸고, 앤스로픽은 이 방식을 쓴 리테일러의 장바구니가 최대 35% 커지고 구매 완료 확률이 60% 높아졌다고 밝혔습니다.
시사점: 데스크톱 에이전트의 경쟁 축이 무엇까지 하느냐에서 사람 시간을 얼마나 덜 뺏느냐로 옮겨갑니다. 지켜보지 않는 동안 무엇을 허용해 뒀는지가 곧 위험 범위이므로, 허용 앱 목록을 관리 대상으로 다뤄야 합니다.
#컴퓨터사용#Cowork#에이전트커머스
출처 4🔥 @claudeai🔥 @ClaudeDevs🔖 @ClaudeDevs🔥 @ClaudeDevs
6. 미 법무부가 학습은 공정 이용이라며 오픈AI 편 의견서를 냈다
- 미 법무부가 오픈AI 저작권 소송에 '미합중국의 이해관계 진술서'를 내고 피고인 오픈AI와 마이크로소프트 쪽에 섰습니다. 미 정부가 AI 저작권 소송에 직접 의견을 낸 것은 알려진 한 처음입니다.
- 진술서는 저작권 있는 텍스트로 LLM을 학습시키는 일이 저작권법 위반이라는 주장을 법원이 배척하는 데 강한 이해관계가 미국에 있다고 적었습니다.
- 학습은 '대단히 변형적(extraordinarily transformative)'이라 공정 이용이며, 이를 좁게 해석하면 과학 진보와 미국의 번영·국가안보를 함께 해친다는 논리입니다.
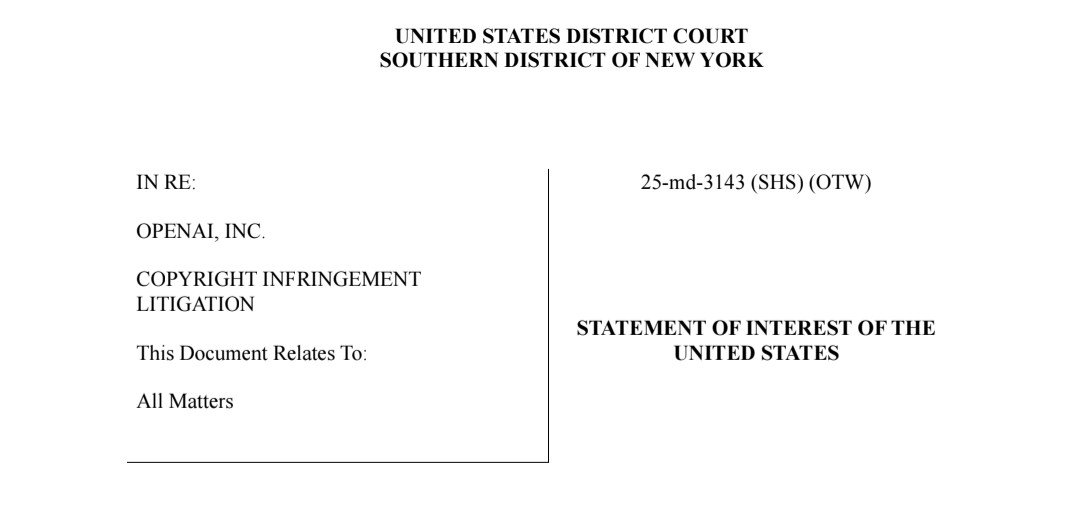
의견서 자체가 판사를 구속하지는 않습니다. 정부가 어느 해석을 원하는지 재판 기록에 못 박아 두는 장치에 가깝습니다. 그런데도 무게가 다른 이유는, 여기서 다투는 학습 쟁점이 지금 미국에서 진행 중인 AI 저작권 소송 대부분이 함께 안고 있는 것이기 때문입니다. 사건번호의 'md'가 가리키듯 이 재판은 여러 원고의 소송을 한데 묶은 병합 절차라 통합된 사건에는 한 번에 영향이 가지만, 앤스로픽이나 메타를 상대로 한 별개 소송까지 자동으로 따라가지는 않습니다.
스탠리 우드워드 법무부 차관(Associate Attorney General)은 "명백히 틀린 저작권법 해석" 탓에 미국이 외국 경쟁국보다 불리해지는 일을 이 행정부는 두지 않겠다고 했고, 근거로 국가안보와 경제적 번영을 들었습니다.
그 밖에: 뉴욕타임스 대변인 그레이엄 제임스는 허락도 대가도 없이 콘텐츠를 가져가게 하자는 제안이 "건강한 사회가 기대는, 그리고 AI가 작동하는 데 필요한 인간 창작물의 지속 가능성"을 무너뜨릴 것이라고 반박했습니다. 하워드 러트닉 상무장관은 G20 관료들에게 각국이 공정 이용을 받아들이되 예술가를 보호할 방법을 함께 찾으라고 권했습니다.
시사점: 학습 데이터 라이선스 비용을 사업 계획에 넣어 둔 곳이라면 미국 쪽 전제가 흔들렸습니다. 다만 의견서는 판결이 아니고 재판도 끝나지 않았으니, 이미 맺은 계약을 서둘러 뒤집기보다 판결을 보고 움직이는 편이 낫습니다.
#저작권#공정이용#AI정책
출처 3🔥 @AndrewCurran_🔥 @MTSlive🔥 @ChrisGPT
7. 오픈AI 수석과학자가 Astra의 순환 깊이 논란에 직접 답했다
- The Information의 스테퍼니 팔라촐로가 Astra는 "recurrent depth"(순환 깊이)라는 새 추론 방식을 쓰며, 이것이 모델의 사고 과정을 가려 감시를 어렵게 한다고 보도했습니다.
- 몇 시간 뒤 오픈AI 수석과학자 야쿠프 파호츠키가 X에서 직접 답했습니다. Astra를 포함한 현재 프런티어 모델의 계산 그래프 깊이는 GPT-4의 2배 이내이고, 첫 추론 모델 이후 chain-of-thought 감시를 보존·활용해 왔다는 것입니다.
- 저자가 같은 날 스레드로 소개한 SMELT 논문은 FLOPs·파라미터·KV 캐시를 전부 맞춘 조건에서도 순환 구조가 연산 최적 지점에서 학습 연산을 6.8~18.0% 아꼈고, 비임베딩 파라미터 54B까지 키우는 동안 격차가 벌어졌다고 적었습니다.
다투는 지점은 성능이 아니라 들여다볼 수 있느냐입니다. 순환 깊이는 같은 층에 텍스트를 여러 번 통과시켜 작은 모델을 큰 모델처럼 굴리는 대신, 생각이 문장이 아닌 내부 벡터로 돌아 읽을 사고 사슬 자체가 줄어듭니다. 파호츠키는 혼란스러운 보도가 "감시 불가능으로 가는 경주"를 촉발하는 것을 막고 싶다며 깊이 수치를 댔지만, 그 감시 기법이 취약하고 나쁜 쪽으로 가고 있다는 판단도 함께 적었습니다. 아키텍처 변경과는 무관한 이유이며 이를 보강하는 것이 지금 연구 프로그램의 핵심 목표라는 단서를 달았습니다. 반박과 경고가 한 게시물에 같이 들어 있는 셈입니다.
그리고 이 기법이 사라질 리 없다는 근거는 그 논문이 댑니다. 순환 구조의 이점은 그동안 파라미터를 더 쓴 덕이라는 반론이 있었는데, 연산량과 캐시까지 맞춰 놓고도 이득이 남았고 규모가 커질수록 벌어졌습니다. 값싸게 깊어지는 길이 실측으로 확인된 이상, 감시 가능성은 선택하지 않을 수 있는 비용이 아니라 설계에서 지켜내야 할 제약이 됩니다.
그 밖에: 노엄 브라운이 그 글을 인용해 파호츠키가 오픈AI 수석과학자임을 확인해 줬습니다. 보도는 오픈AI가 감시 가능성을 지키려 Astra의 이 기법 적용을 제한했고 출시 때 추가 모니터링을 붙인다고 전했는데, 원문은 유료 구간이라 요약본으로만 확인됩니다.
시사점: 안전 정책이 규정이 아니라 아키텍처에서 결정되는 국면입니다. 지금의 평가와 감독은 모델이 무엇을 말했는지 읽는 데 기대고 있는데, 계산이 말 바깥으로 옮겨가면 그 창은 성능과 맞바꿔 닫힙니다.
#Astra#순환깊이#CoT감시
출처 6🚀 @steph_palazzolo🔥 @merettm🔥 @polynoamial🔥 @kimmonismus🚀 @wangsw5653🔥 @nrehiew_
8. 크라우드스트라이크가 방어자용 SafeMind를 내놨고, 뉴욕증권거래소는 Mythos로 취약점을 고쳤다
- 크라우드스트라이크가 9월 1일 라스베이거스 Fal.Con 2026에서 SafeMind를 열었습니다. 엔비디아 Nemotron 오픈 모델에 Falcon 센서 기록과 15년치 사고 대응 현장 자료를 얹어 사후학습했고, 공격 역할 Red Tempest와 방어 역할 Blue Solano를 한 고리에 묶어 서로를 계속 때리게 합니다. 자체 평가로는 범용 프런티어 모델보다 탐지율 29% 높고 비용 99% 낮으며, 조치까지 걸린 시간은 6분의 1이었습니다.
- 뉴욕증권거래소 사장 린 마틴이 하원 금융서비스위원회에서 거래소가 Project Glasswing 초기 참여사로 앤스로픽 Mythos를 써 왔다고 말했다고 블룸버그가 전했습니다. 최신 기술 덕에 여러 항목을 빠르게 조치했다는 취지였고, 어떤 취약점인지도 언제 고쳤는지도 밝히지 않았습니다.
- 앤스로픽은 파일이 Claude로 만들어졌는지 브라우저에서 확인하는 도구(claude.com/check-content)를 열었습니다. 파일은 서명이 붙은 자료를 읽는 방식이고, 8월 2일 이후 출시된 모델의 텍스트에 들어가는 표식은 경로가 달라 탐지가 아직 앤스로픽 API 프라이빗 프리뷰입니다.
방어 쪽 물건이 하루에 세 갈래로 나온 날입니다. 크라우드스트라이크는 15년간 쌓인 대응 기록을 파는 제품으로 바꿨고, 뉴욕증권거래소는 그런 도구가 시연이 아니라 이미 고쳐진 코드라는 걸 의회 증언으로 대신 확인해 줬습니다.
세 번째만 성숙도가 다릅니다. 확인 도구는 공개되자마자 제거 서비스가 이미 지운다는 보고가 붙었고, 그 글은 좋아요 268개보다 북마크 419개가 더 많이 쌓였습니다.
그 밖에: 오픈AI는 오늘 오후 1시(태평양 시간)에 그렉 브록만이 나오는 기업 대상 사이버보안 키노트를 엽니다. 평소 출시 시간대인 오전 10시와 다릅니다. 브록만은 같은 주 Fal.Con 무대에도 젠슨 황·립부 탄과 함께 올라 방어자에게 지금 열려 있는 창을 말했습니다.
시사점: 능력을 문 뒤로 넣는 일과 방어 제품을 파는 일은 같은 회사들이 동시에 합니다. 보안 예산을 쥔 쪽이라면 벤더 자체 수치를 받아 적기보다 자기 환경에서 다시 재는 절차를 계약서에 넣을 때입니다.
#사이버보안#SafeMind#Mythos
출처 6💬 @George_Kurtz🔥 @MTSlive💬 @btibor91🔥 @guillaumemeyer💬 @WesRoth🔥 @synthwavedd
9. Wonderful이 50억 달러 가치로 5억 5천만 달러를 받았다
- Insight Partners가 주도한 시리즈 C에 Salesforce가 신규 투자자로 들어왔고, Index Ventures·Bessemer·IVP·Vine Ventures·9Yards가 재투자했습니다.
- 지난 3월 시리즈 B의 20억 달러에서 반년도 안 돼 몸값이 2.5배로 올랐습니다.
- 출시 20개월 만에 30개가 넘는 시장, 12개가 넘는 산업에서 프로덕션에 올라가 있습니다.
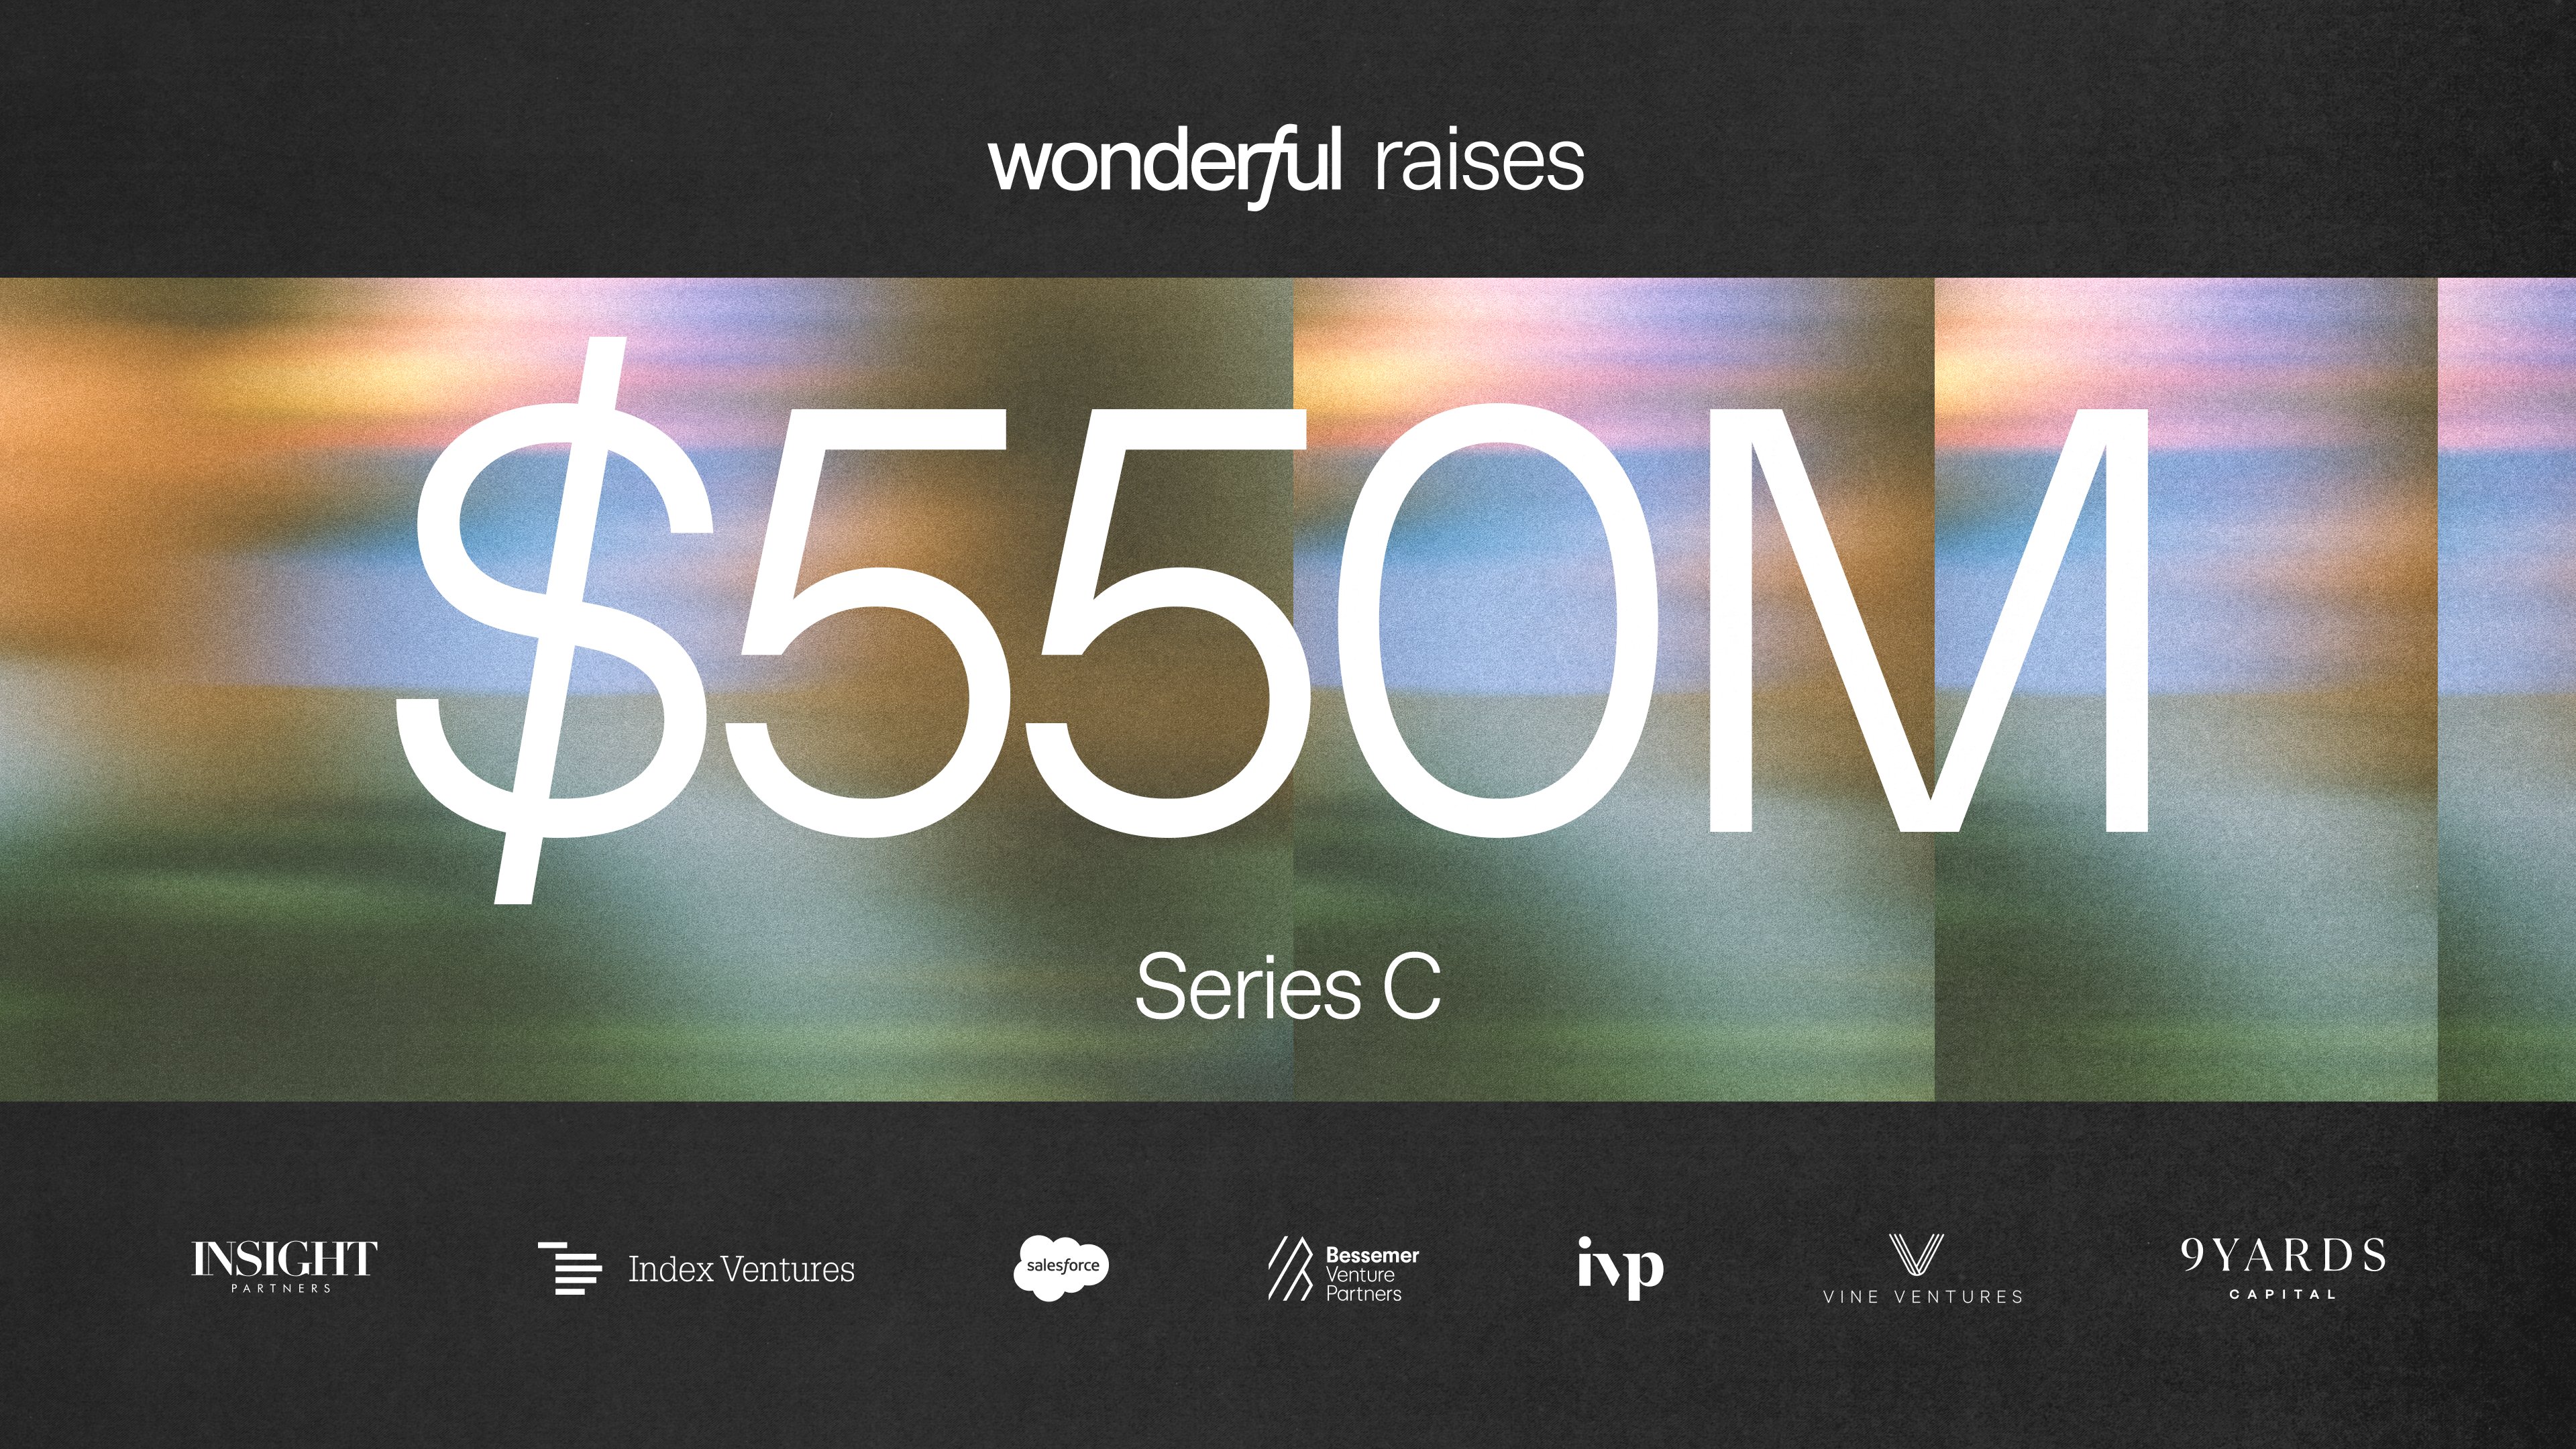
네덜란드·이스라엘 팀이 고객서비스 에이전트로 출발해 지금은 사내 시스템을 잇는 'AI 운영체제'를 표방하는데, 눈여겨볼 대목은 금액이 아니라 그 돈을 쓰는 방식입니다. 이 회사는 소프트웨어만 팔아 두고 고객이 알아서 붙이기를 기다리는 대신, 엔지니어를 고객사 안으로 들여보내 현장에서 업무를 자동화합니다.
TechCrunch는 이 팀이 고객 사무실에 상주하기도 한다고 전했고, 회사도 이번 자금으로 엔지니어와 현장 투입 인력, 전직 창업자를 수백 명 뽑겠다고 밝혔습니다. 머신러닝 엔지니어 Santiago Valdarrama는 AI 도입을 도와 달라는 기업이 늘고 있으니 이런 형태가 더 나올 것으로 봤습니다. 에이전트를 제품으로 파는 쪽과 사람으로 파는 쪽 가운데, 지금 자본이 어디에 붙는지가 이 라운드에 찍혀 있습니다.
그 밖에: 같은 날 Multiverse Computing이 매개변수 4,380억 개짜리 Quasar 438B를 내놨습니다. Artificial Analysis 지능 지수 v4.1.1에서 43점을 받아 유럽 모델 가운데 최고점이고, 이 회사가 낸 첫 대형 모델입니다.
시사점: 에이전트 도입의 병목은 모델이 아니라 남의 회사 사정을 아는 사람입니다. 그 병목에 값이 매겨지기 시작했습니다.
#Wonderful#시리즈C#엔터프라이즈AI
출처 5🚀 @wonderful_ai🔥 @svpino💬 @TechCrunch💬 @testingcatalog🚀 @MultiverseCompu
10. LoRA를 만든 에드워드 후가 Mercor로 옮기며 397B RL 학습 기록을 통째로 열었다
- LoRA 저자 에드워드 후가 Mercor의 모델 학습·리서치 총괄로 합류했습니다. 마이크로소프트에서 LoRA를 만들고 벤지오 밑에서 박사를 마쳤습니다.
- 첫 결과물로 Qwen3.5-397B-A17B를 DPPO로 RL 사후학습해 사무 업무 벤치마크 APEX-Agents의 Pass@1을 16.11%에서 27.29%로 올렸습니다. 블로그 기준 상대 개선 70%입니다.
- 가중치와 학습 스크립트, 평가 트레이스를 전부 열었습니다. 학습에 쓰지 않은 OpenCode 하네스에서도 개선이 대부분 그대로 넘어갔습니다.
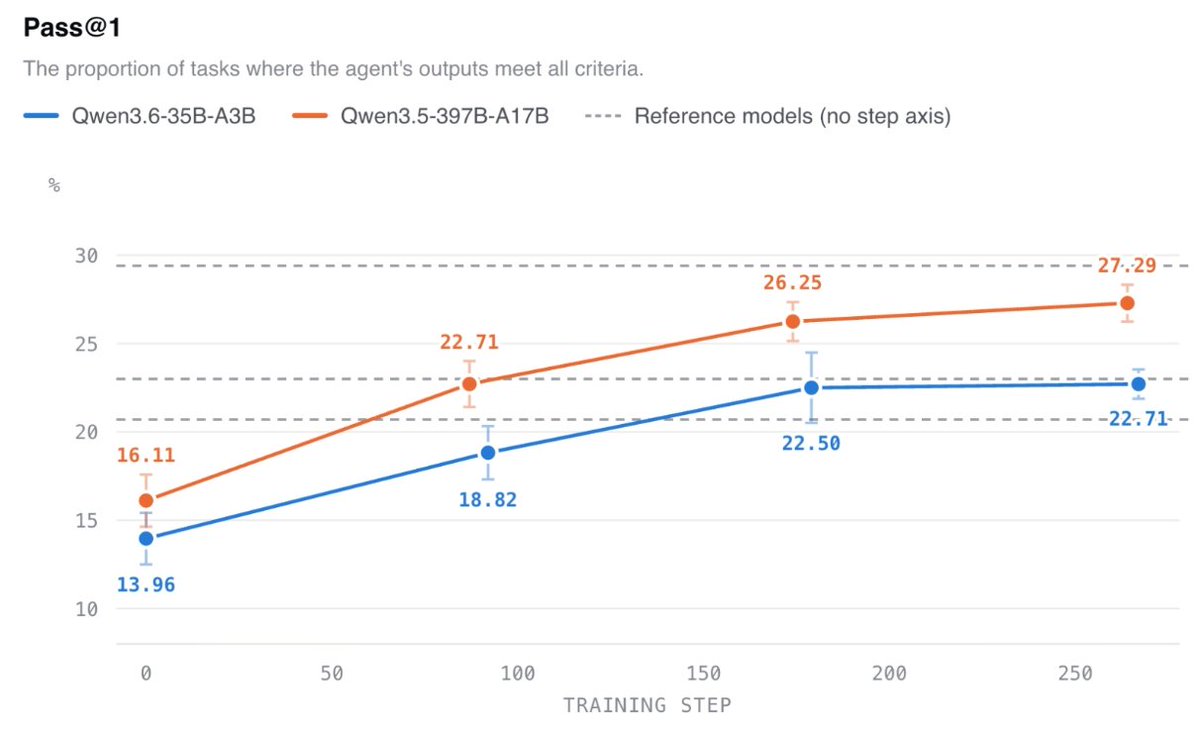
블로그가 적은 것은 점수가 아니라 순서였습니다. 환경과 하네스부터 고쳐 소형 35B의 평균 보상을 학습 없이 22.74%에서 28.69%까지 올려 두고, 과제 32개로 일부러 오버피팅을 내 파이프라인을 확인하고, 소형 모델에서 알고리즘을 갈라 본 다음에야 397B 히어로 런을 걸었습니다. 추론 노드와 학습 노드를 12대 8로 나눈 배치까지 남겼습니다. 안 통한 설정까지 적었다는 뜻이라, 직접 돌릴 팀은 어디서 돈이 새는지 미리 볼 수 있습니다.
팀이 남긴 교훈은 알고리즘이 아니었습니다. 설정 다섯 가지 중 최선이 3.9점을 얹는 동안 사후학습 전체는 두 모델을 10~12점 올렸습니다. 그런데 차이를 만든 학습 데이터는 라이선스 때문에 못 열었다고 레포에 적혀 있습니다. 데이터가 병목이라던 합류 소감과 겹쳐 놓으면, 이번에 열린 것은 재료가 아니라 조리법입니다.
그 밖에: Mostik이 같은 주에 latent bridge를 공개했습니다. 공개된 회사 기술 문서로는 GLM-5.2(753B)의 은닉 상태를 브리지로 Qwen-3.5(4B)에 넘겨 4B가 답을 쓰는데, 두 모델을 동결한 채로 격차를 절반 좁히고 같은 점수의 중형 모델보다 연산이 2.5배 덜 듭니다.
시사점: 열린 것은 397B 가중치보다 그걸 만든 순서입니다. 점수표보다 이 실패 목록이 사후학습을 검토하는 팀에 쓰입니다.
#Mercor#RL사후학습#오픈웨이트
출처 5🔥 @edwardjhu🔥 @edwardjhu🔥 @charlie_ruan💬 @aimalysheva🔥 @kimmonismus
11. 다이슨 CameraJet이 칫솔 안에 카메라를 넣어 치간을 찾고 0.1초 만에 헹군다
- 다이슨이 카메라를 심은 전동칫솔 CameraJet을 현지시간 9월 1일 내놨습니다. 미국 판매가는 499달러입니다.
- 10만 화소 카메라가 칫솔질 도중 초당 28장을 찍고, 치과 이미지 47만 장으로 학습한 모델이 그 화면에서 치아 사이 틈을 골라냅니다.
- 카메라가 틈을 잡으면 100밀리초 안에 마우스린스를 그 자리로 분사합니다. 사람이 치실을 잡는 동작이 통째로 빠집니다.
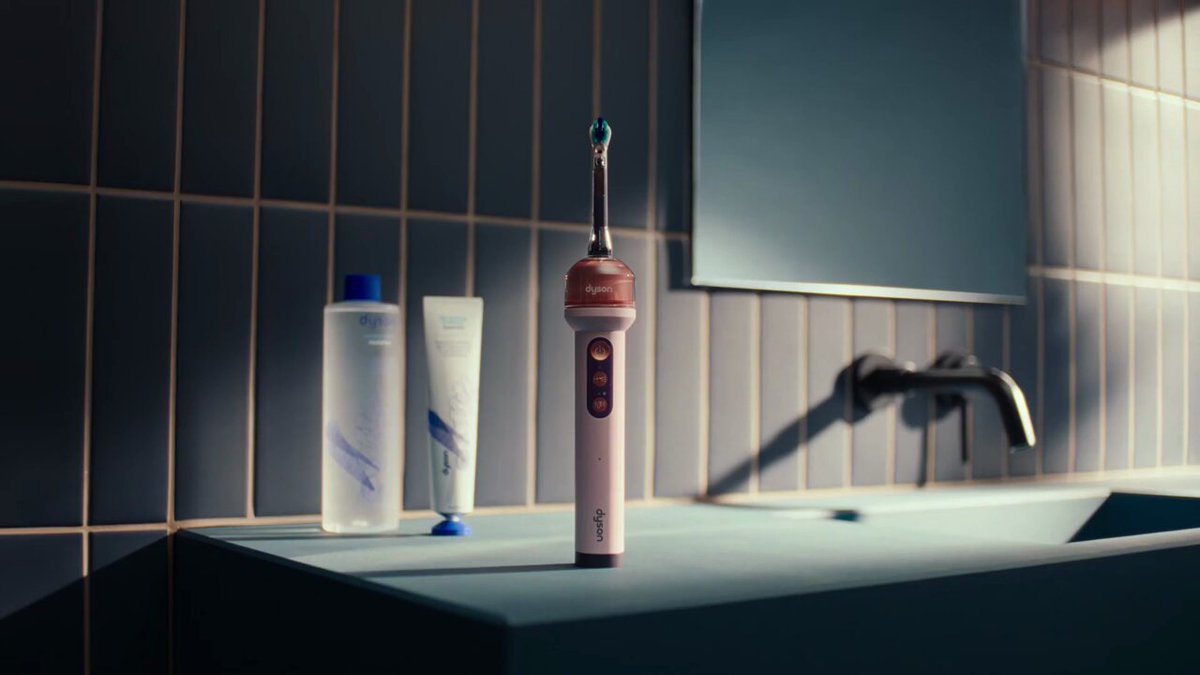
읽을 대목은 구강 관리가 아니라 연산 예산입니다. 초당 28장을 받아 100밀리초 안에 분사까지 끝내는 동작에는 서버에 다녀올 여유가 없습니다. 다이슨은 그 연산이 어디서 도는지는 밝히지 않았습니다. 학습에 쓴 47만 장도 프런티어 모델 기준으로는 작은 더미입니다. 좁은 문제를 좁게 풀면 그 정도로 충분하다는 얘기이며, 그렇게 나온 결과물에 499달러라는 소비재 가격표가 붙었습니다.
다이슨이 값의 근거로 내세우던 건 오래도록 모터와 기류였습니다. 이번엔 카메라와 모델이 그 자리에 들어섰습니다. 다이슨은 촬영된 화면을 기기에도 클라우드에도 남기지 않는다고 밝혔는데, 입 안을 찍는 물건이니 당연한 설계지만 틈을 제대로 골라냈는지 사는 사람이 되짚을 방법도 함께 사라집니다.
그 밖에: 반응은 기술보다 결단 쪽에 쏠렸습니다. 창업자가 지분을 전부 쥐고 누구에게도 결재받지 않는 회사라서 나오는 물건이라는 평이 좋아요 3.3만을 모았고, 일본어권에서는 너무 미래라서 웃음이 난다는 한 줄 감상이 좋아요 2,200을 넘겼습니다.
시사점: 비전 추론이 데이터센터가 아니라 499달러짜리 생활용품에 값으로 얹히기 시작했습니다. 다음 순번은 더 싼 물건일 것입니다.
#컴퓨터비전#소비자가전#다이슨
출처 5🔖 @VaibhavSisinty🔖 @polymarketjapan🔖 @_alexbrogan🔥 @fladdict🚀 @CoderArmy
12. 🆕 그 밖의 신기능·신제품
- Inworld Realtime TTS-2 정식 출시 — Artificial Analysis Controlled Voice Arena 1위로 복귀했습니다. P99 지연 100ms 미만, 저지연판 TTS-2 Flash는 첫 소리까지 25ms입니다. 문장 안에 "calm, reassuring" 같은 태그를 끼워 연기 지시를 글로 적고, 5~15초 클립으로 목소리를 복제합니다.
- Multiverse Computing Quasar 438B — 유럽 모델 중 Artificial Analysis 지능지수가 가장 높은 43점입니다. Mistral Medium 3.5보다 13점, 파라미터가 1,120억 더 많은 Nemotron 3 Ultra보다 5점 앞섭니다.
- fal H3 Max Turbo 프리뷰 — 속도 2배·비용 절반으로 원본 H3 Max 품질의 97퍼센타일을 노립니다. 2주 한정 프로모션가로 768p 영상이 출력 1초당 0.01달러입니다.
셋을 관통하는 건 성능이 아니라 단가와 지연입니다. 음성은 대화가 끊기지 않을 만큼 빨라졌고, 영상은 초당 1센트대로 내려왔으며, 유럽에서 나온 4,380억 모델이 미국·중국 모델과 같은 지수에서 겨룹니다. 데모로 보던 것들이 청구서에 올릴 수 있는 단위로 바뀐 날입니다.
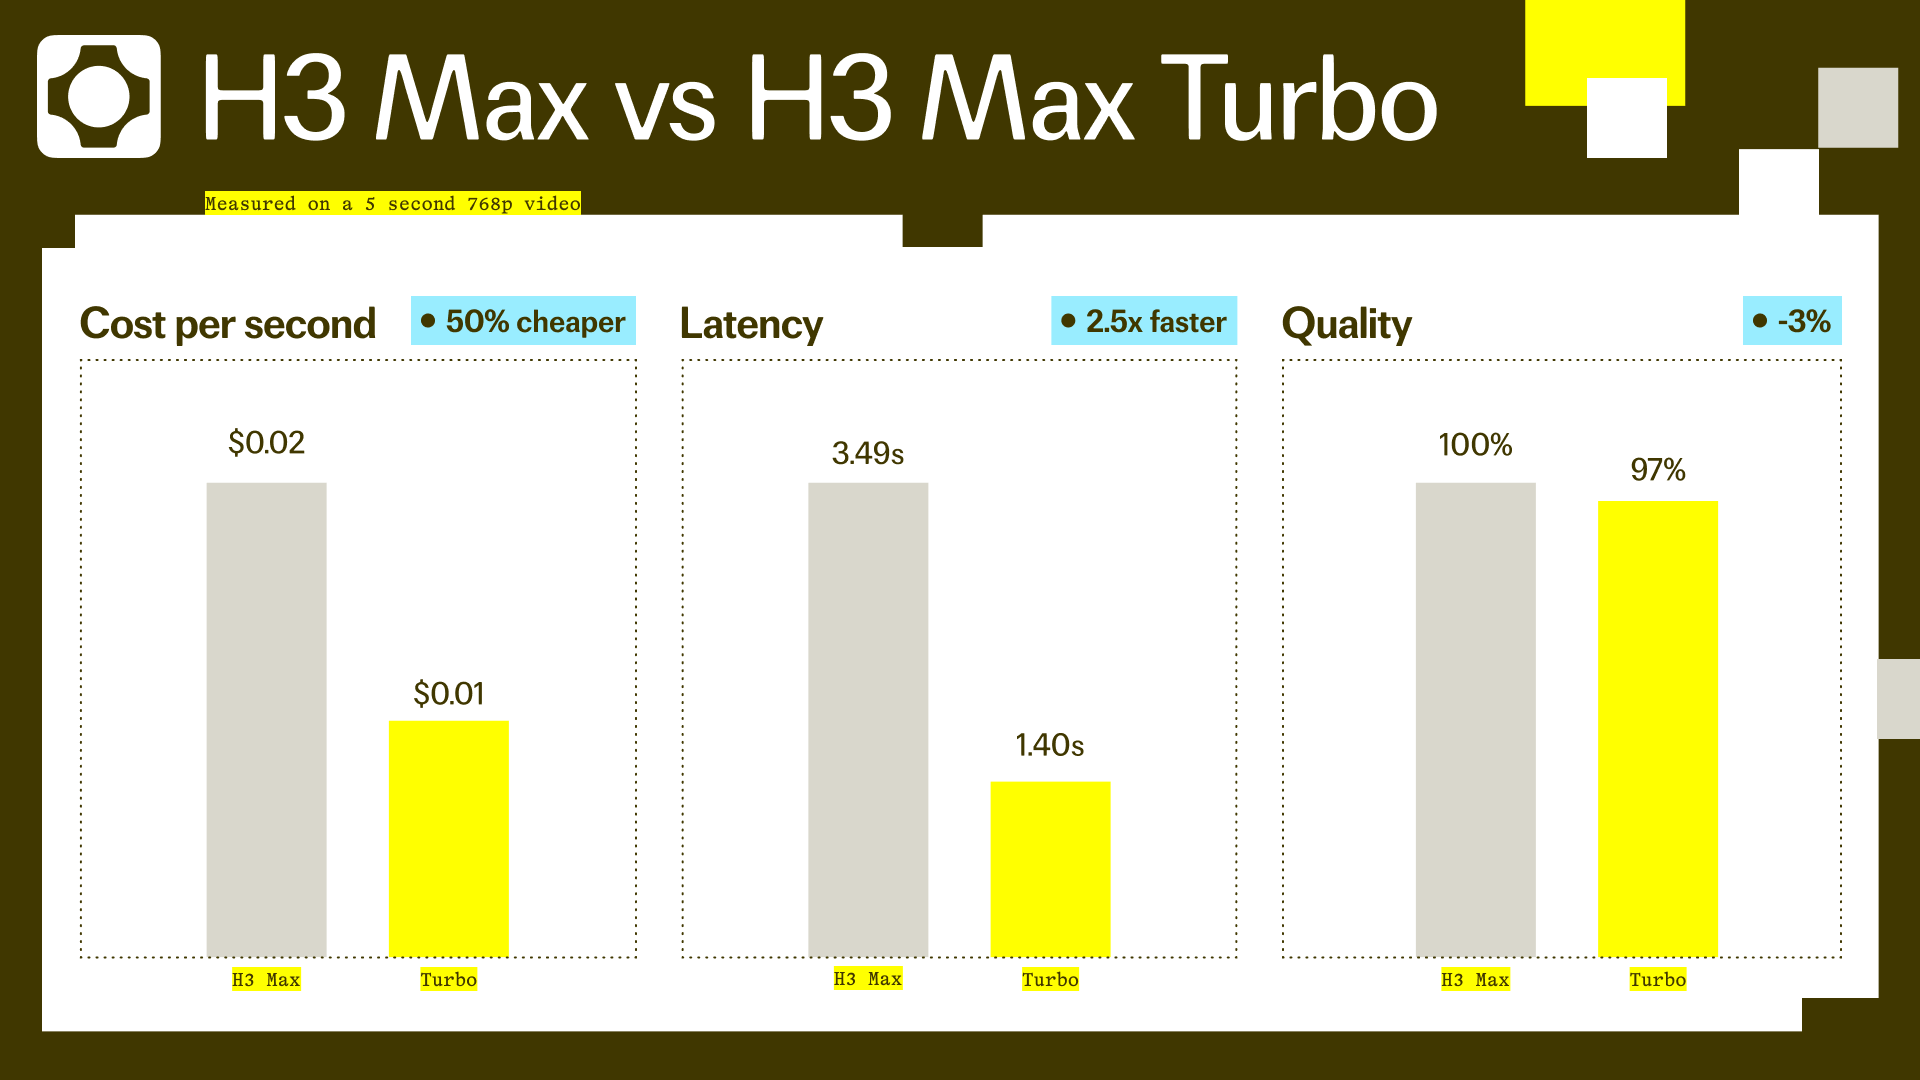
값이 내려간 자리에서 갈리는 건 어느 항목을 재느냐입니다. 위 비교에서 값과 지연은 절반 아래로 떨어지는데 품질은 3%만 빠지니, 초안을 여러 번 돌리는 작업과 최종본을 뽑는 작업에서 답이 달라집니다.
그 밖에: Higgsfield는 직접 찍은 푸티지 위에 연기·립싱크·카메라 이동을 옮기는 Genjutsu를 열고, Blender 플러그인으로 크레딧을 쓰기 전 카메라 경로를 확정하는 워크플로도 냈습니다. Omnara는 Claude Managed Agents의 오픈소스 대안을 내걸고 호스팅·상태·샌드박스·권한을 대신 맡고, 엔비디아 DLSS 5의 3D-Guided Neural Rendering을 Nova LUT와 묶어 돌린 모드(mod) 시연도 돌았습니다. 논문 쪽에선 장기 에이전트의 그래프 메모리가 플랫 검색에 졌고(LongMemEval 토큰 F1 0.42 대 0.47), 4B VLM을 RL로 GeoGuessr에 붙인 작업이 코드·환경·데이터셋 공개를 예고했으며, 모델마다 다른 "좋아하는 숫자" 한 토큰으로 165개 모델의 신원을 가려낸 감사가 회자됐습니다.
시사점: 값이 내려간 자리에서 고를 것이 늘었습니다. 붙일 기능이 있다면 벤치마크 순위보다 초당 단가와 첫 응답 시간을 먼저 재보세요.
#TTS#영상생성#에이전트
출처 13🔁 @inworld_ai🔥 @kimmonismus🔁 @Iriss_Quinn💬 @testingcatalog🚀 @MultiverseCompu💬 @fal🔥 @higgsfield_ai🔥 @higgsfield_ai💬 @ishaansehgal🔥 @LinusEkenstam💬 @omarsar0🔥 @adithya_s_k💬 @HowToPrompt__
📊 오늘의 감정·온도
💼 오늘의 실무 팁 — 쉽게 풀어 쓴 사용법 6가지
1. 단가표 대신 과제 하나를 실제로 돌려 비용을 재보세요 — 같은 값이라도 걸음을 잘게 쪼개고 자기 작업을 자주 검증하는 모델은 토큰을 더 씁니다. 청구되는 값은 100만 토큰당 단가가 아니라 과제 하나에 드는 총액이 정합니다. — (@_philschmid)
2. 리더보드는 점수 옆의 투표 수와 오차 구간을 같이 보세요 — 표가 천 건 남짓인 신규 모델은 오차가 ±20 안팎이라 3점 차이는 등수로 읽을 값이 아닙니다. 표가 만 건 넘게 쌓인 모델과 나란히 두면 어느 줄이 굳은 순위인지 보입니다. — (@arena)
3. 그래픽카드가 모자라면 가중치보다 KV 캐시부터 줄여 보세요 — 긴 문서를 물릴 때 카드를 먼저 채우는 건 모델 자체가 아니라 문맥을 담아 두는 캐시입니다. 캐시 정밀도를 낮추는 설정만 바꿔도 같은 카드에서 훨씬 긴 입력이 들어갑니다. — (@Lonely__MH)
4. 11GB 아래로 내려가는 양자화는 회복률부터 확인하세요 — 원본 대비 정확도를 몇 퍼센트나 되찾는지가 공개된 판본만 고르는 편이 안전합니다. 더 줄여야 한다면 같은 모델을 더 조이기보다 한 체급 작은 모델을 건강하게 조인 쪽이 낫습니다. — (@bnjmn_marie)
5. 데스크톱 에이전트를 켤 땐 허용 앱 목록을 먼저 적어 두세요 — 화면을 안 보는 사이에 도는 기능이라 무엇을 허용해 뒀는지가 그대로 위험 범위가 됩니다. 금융·의료처럼 되돌리기 어려운 앱은 처음부터 목록 밖에 두는 편이 좋습니다. — (@ClaudeDevs)
6. 영상 생성은 초당 단가와 첫 응답 시간으로 비교하세요 — 같은 모델의 고속판은 대개 값과 지연을 절반 아래로 낮추는 대신 품질을 몇 퍼센트 내줍니다. 초안을 여러 번 돌리는 단계와 최종본을 뽑는 단계에 다른 판을 쓰면 총액이 달라집니다. — (@fal)
📦 확인 방식 — 단가와 벤치마크 수치는 구글·메타가 발표와 함께 공개한 비교표에서, 순위와 투표 수는 arena.ai 순위표에서 가져왔습니다. 크라우드스트라이크의 탐지율·비용처럼 회사가 스스로 잰 값은 본문에 그렇게 밝혀 적었고, 나머지는 인용한 게시물의 원문을 따랐으며 외부 독립 검증 전입니다.
🏷 라벨 가이드 — 🔥 화제 · 💬 토론 많음 · 🚀 빠르게 확산 · 🔖 저장 많음 · 🔁 리트윗 많음