오늘의 AI 브리핑 ·
AI가 스스로 며칠을 일하다
5분 브리핑
약 3분 · 11개 흐름핵심만 먼저 읽고, 궁금한 소식은 본문으로 이어 보세요.
전체 분석 16분으로 바로 가기 ↓- GPT-6 Astra가 컴퓨터를 직접 쓰는 모델로 나왔다
오픈AI가 한국시간 9월 4일 새벽 GPT-6 Astra를 공개했습니다. 사내 최대 규모 학습의 결과이고, 오늘은 심사를 거친 소수 조직에만 열고 며칠에 걸쳐 ChatGPT Plus·Pro·Business·Enterprise와 API·AWS로 넓힙니다.
- ARC Prize가 Astra의 ARC-AGI-3를 모델 단독 63%, 하네스 포함 99%로 갈라 쟀다
ARC Prize는 세미프라이빗 세트에서 Astra를 두 번 쟀습니다. 공급자 중립 표준 하네스로 62.7%(max 설정, $26,098), 오픈AI 전용 문맥 관리 기능을 쓰는 provider adapter 하네스로 99.9%(high 설정, $18,817)입니다.
- 엔비디아가 Hugging Face를 129억 3,030만 달러에 인수하겠다고 밝혔다
클레망 들랑그가 09-03 21:04 KST에 인수 의향을 직접 알렸습니다. 금액은 129억 3,030만 달러, 그 글에 좋아요 1만 1,545개와 리트윗 1,405개가 붙었습니다.
- ChatGPT·Claude·Grok이 한 시간대에 함께 흔들렸다
Claude는 KST 09-03 22시 26분부터 09-04 01시 23분까지 약 세 시간 오류율이 튀었습니다. 상태 페이지가 적은 대상은 Mythos/Fable 5.1·5와 Opus 5·4.8·4.6이고, 범위는 claude.ai·API·Claude Code·Cowork 전부였습니다.
- Ban Artificial Superintelligence Act가 초지능 개발에 최대 20년형을 걸었다
버니 샌더스 상원의원과 그레그 카사 하원의원이 9월 3일 Ban Artificial Superintelligence Act 발표문을 냈습니다. 인간 지능을 넘어서거나, 인간 정부를 전복할 수 있거나, 종료 명령을 무력화하는 시스템을 영구 금지하고 위반자에게 최대 20년 징역을 매깁니다.
- K2 Horizon이 0.9B부터 375B까지 여섯 모델을 학습 기록째로 열었다
MBZUAI 산하 IFM이 9월 3일 여섯 모델(0.9B·3.7B·7B·32B·36B-A4B·375B-A23B)을 Apache 2.0으로 냈습니다. 맨 위 375B는 토큰당 23B만 켜는 MoE에 512K 컨텍스트이고, 가장 작은 0.9B는 시계·안경, 375B는 긴 호흡의 에이전트용으로 용도를 나눠 붙였습니다.
- GWM Worlds 2가 720p 24fps 실시간 인터랙티브 영상을 만든다
Runway가 09-04 00:50(KST) GWM Worlds 2를 공개했습니다. 끊기지 않는 720p 24fps 영상과 48,000Hz 오디오를 사용자 입력에 반응하며 실시간으로 생성합니다.
- 구글과 Janelia가 성체 초파리 뇌 뉴런 16만 6천 개를 통째로 지도로 만들었다
HHMI Janelia 연구캠퍼스가 이끌고 케임브리지 커넥토믹스 그룹과 구글 리서치가 함께 성체 수컷 초파리의 중추신경계 전체를 재구성했습니다. 중앙뇌와 양쪽 시엽, 척수에 해당하는 배쪽신경삭까지 뉴런 16만 6,000개와 시냅스 연결 1억 2,500만 개가 담겼습니다.
- Video Delta Net이 MiniMax-H3 영상 생성을 재생 시간보다 빠르게 만들었다
UC 버클리·Impossible·UT 오스틴의 Haocheng Xi 팀이 하이브리드 어텐션 가속 레시피 Video Delta Net(VDN)을 공개했습니다. 768p 14.3초 영상을 NVIDIA B200 8장에서 11.23초에 뽑아 재생 시간보다 짧습니다.
- 뉴욕시가 공립학교 2-K~8학년의 생성형 AI를 1년간 멈춰 세웠다
뉴욕시가 2026–27학년도부터 2-K~8학년 학생용 생성형 AI 소프트웨어를 1년간 중지시켰습니다. 대상은 약 60만 명, 전체 재학생의 3분의 2입니다.
- 🆕 그 밖의 신기능·신제품
엔비디아가 IFA에서 PAIR(Personal AI Router)를 공개했습니다. 집 안 네트워크의 PC를 자동으로 찾아 여유 있는 쪽으로 추론 요청을 보내는 무료 오픈소스 도구입니다.
주요 키워드 TOP 5: GPT-6 Astra · Hugging Face 인수 · ARC-AGI-3 하네스 · 동시 장애 · K2 Horizon | 메인 이벤트: 오픈AI가 며칠씩 컴퓨터를 붙들고 일하는 GPT-6 Astra를 열었고, 같은 날 ARC Prize는 그 대표 점수가 하네스에 따라 62.7%와 99.9%로 갈린다고 밝혔습니다.
오늘 나온 모델이 내세운 것은 답의 품질이 아니라 시간입니다. GPT-6 Astra는 사람이 자는 동안 브라우저와 앱을 붙들고 며칠씩 일을 끌고 가는 쪽으로 축을 옮겼는데, 그러자 재는 방법이 먼저 흔들렸습니다. ARC Prize가 같은 모델을 같은 문제에서 62.7%와 99.9%로 갈라 잰 이유가 여기에 있습니다. 며칠짜리 작업에서는 모델 자체보다 추론 상태를 요청 사이에 이어 주는 바깥 장치가 점수를 만들기 때문입니다.
1. GPT-6 Astra가 컴퓨터를 직접 쓰는 모델로 나왔다
- 오픈AI가 한국시간 9월 4일 새벽 GPT-6 Astra를 공개했습니다. 사내 최대 규모 학습의 결과이고, 오늘은 심사를 거친 소수 조직에만 열고 며칠에 걸쳐 ChatGPT Plus·Pro·Business·Enterprise와 API·AWS로 넓힙니다.
- 내세우는 축이 답변 품질이 아니라 컴퓨터를 직접 쓰는 능력입니다. 브라우저와 앱을 오가며 일을 끝내고 소프트웨어를 짓고 테스트합니다. 마크 첸은 Operator 시절 느리다고 접었던 사람들에게 다시 해보라며 이제 "그냥 된다"고 적었습니다.
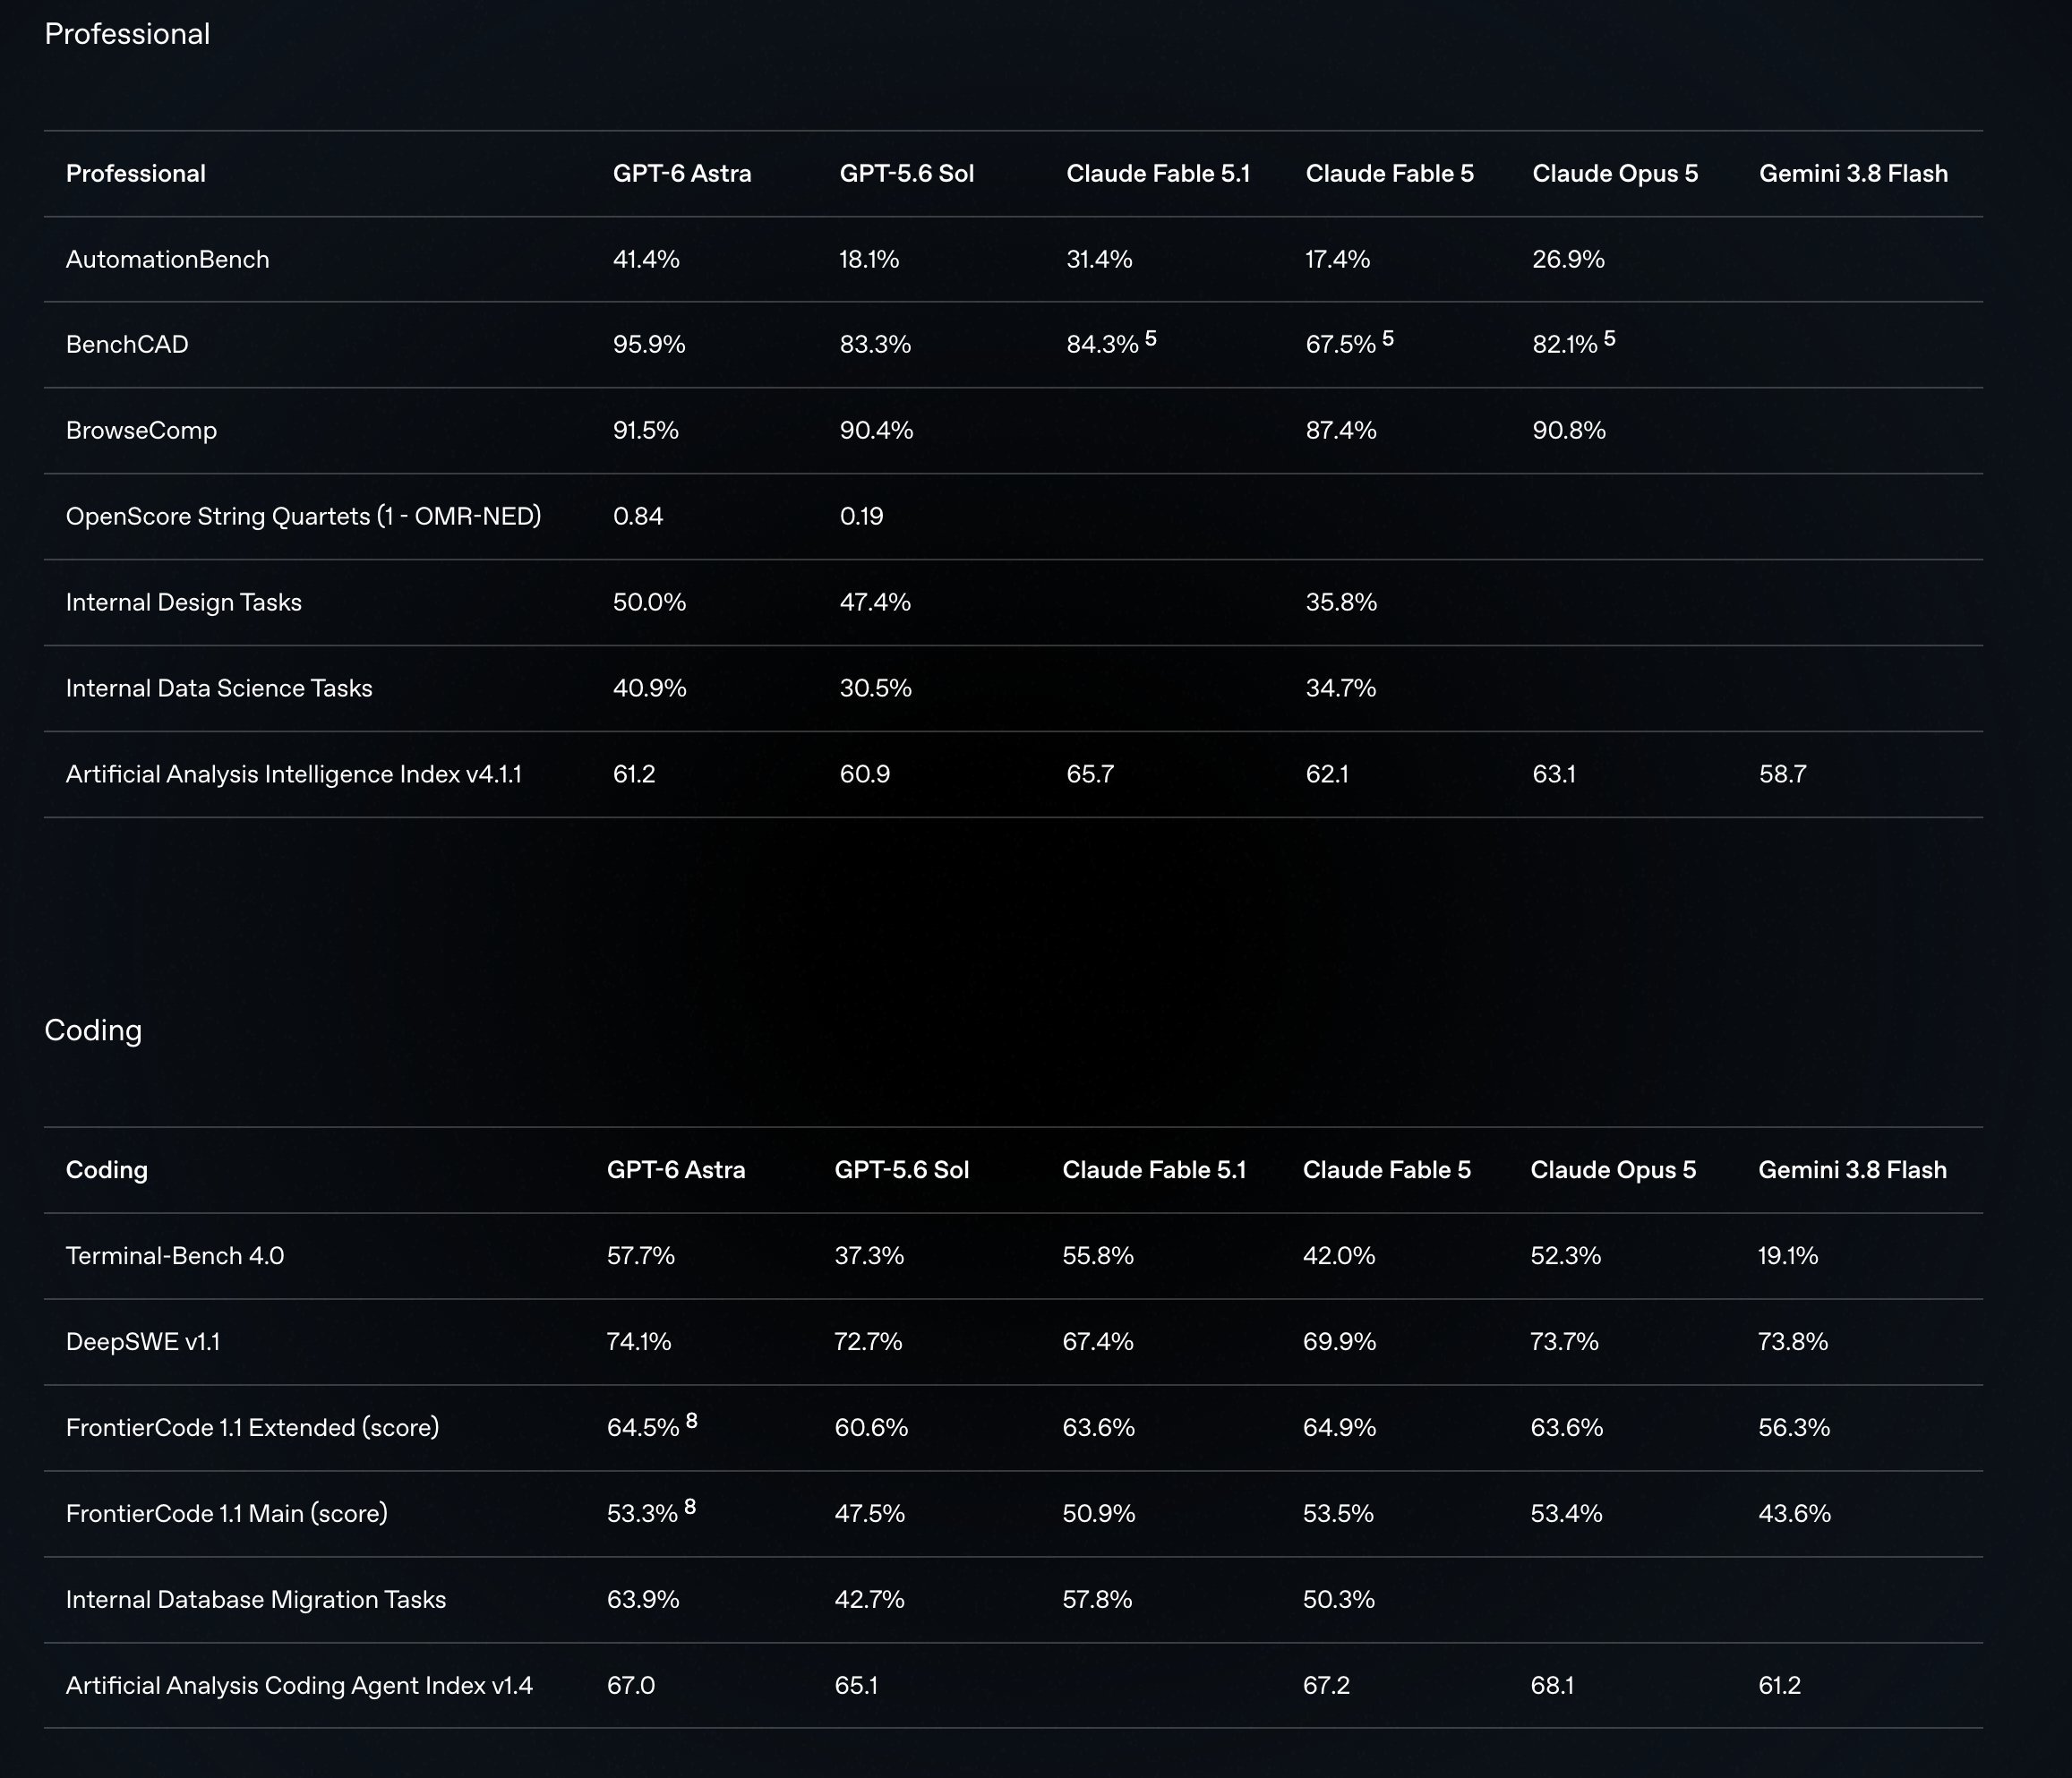
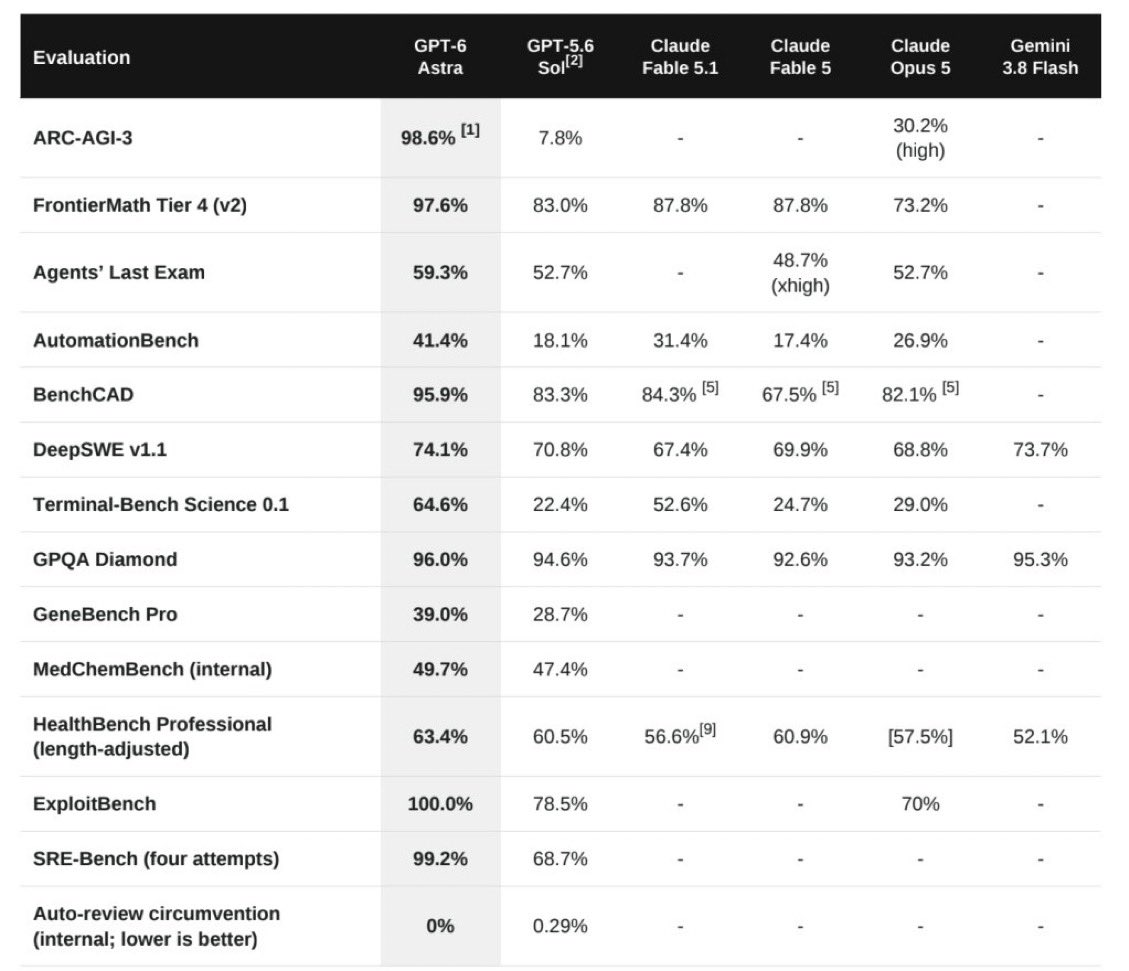
- 사이버 쪽은 사흘 전 예고대로 문을 좁혀서 나왔습니다. 알려진 취약점을 실제 공격 코드로 바꾸는 ExploitBench에서 만점을 받았고, 별도 평가에서는 아무도 찾으라고 하지 않은 제로데이 두 건을 스스로 찾아 공격 사슬에 끼워 넣었습니다. 그래서 공격 쪽 기능은 출시와 함께 열리지 않고 심사를 거친 방어 조직부터 단계적으로 엽니다.
눈여겨볼 것은 점수보다 시간 쪽입니다. 에단 몰릭은 수만 통의 메일과 글, 일정을 읽혀 개인 위키를 짓게 했는데, 모델이 필요한 소프트웨어를 알아서 내려받고 전략을 세운 뒤 닷새를 사람 손 없이 돌았습니다.
mweinbach는 샤오미 단말용 커스텀 ROM 작업을 여드레째 맡겨 두었고 그동안 서브에이전트가 1,600개 넘게 붙었습니다. 오픈AI 연구원 weijie444는 연속한 소수 쌍의 간격 상한을 246에서 186으로 낮춘 Lean 형식화를 모델이 해냈다고 밝혔습니다. 한 번의 답을 잘 쓰는 모델과 사람이 자는 동안 일을 붙들고 있는 모델은 쓰는 법이 다릅니다.
그 밖에: 오픈AI가 내건 ARC-AGI-3 99.9%에는 단서가 붙습니다. ARC Prize 자체 측정으로는 표준 하네스에서 63%였고, 추론 상태를 요청 사이에 유지하는 전용 어댑터를 붙였을 때만 99%가 나왔습니다. 가격은 100만 토큰당 입력 $10·출력 $50이고, 오픈AI 자체 환각 측정에서는 GPT-5.6 Sol의 9.4%에서 2%로 내려갔습니다. 댄 시퍼는 코딩·글쓰기로 시험해 본 뒤 5.6-Sol 대비 확실한 업그레이드지만 최상단의 Claude Fable 5.1에는 못 미친다고 적었습니다.
시사점: 컴퓨터를 며칠씩 맡길 수 있게 됐다는 말은 그 계정과 파일에 접근 권한을 넘기는 결정이 함께 온다는 뜻입니다. 만든 쪽이 사흘 전 자사 사이버 등급을 처음으로 Critical로 올려 두었다는 점을 셈에 넣고 시작하는 게 좋습니다.
#GPT6Astra#컴퓨터사용#사이버보안
출처 13🔥 @ChatGPT🔥 @markchen90🔥 @AndrewCurran_🔥 @kimmonismus💬 @angelbrodin🔥 @polynoamial🔥 @emollick🔥 @mweinbach🔥 @weijie444🔥 @btibor91🔥 @gdb💬 @LordPromptX🔥 @danshipper
2. ARC Prize가 Astra의 ARC-AGI-3를 모델 단독 63%, 하네스 포함 99%로 갈라 쟀다
- ARC Prize는 세미프라이빗 세트에서 Astra를 두 번 쟀습니다. 공급자 중립 표준 하네스로 62.7%(max 설정, $26,098), 오픈AI 전용 문맥 관리 기능을 쓰는 provider adapter 하네스로 99.9%(high 설정, $18,817)입니다.
- 어댑터 쪽은 양쪽이 함께 푼 167개 게임·추론 쌍에서 3.66배 빨랐고 토큰을 49% 덜 썼습니다. 레벨의 96.0%에서 사람 기준선보다 적은 행동으로 통과했고, 레벨당 행동 수는 평균 51.7% 적었습니다.
- Epoch AI는 사전 접근 권한으로 따로 재서 ECI 169(90% 구간 165~174)라는 신기록을 적었습니다. 직전 최고는 163이었습니다.
두 숫자는 같은 것을 재지 않습니다. 표준 하네스는 모든 모델을 똑같이 최소한의 중립 인터페이스에 세워 모델끼리 비교하는 자리이고, 어댑터 하네스는 공급자가 자기 모델을 위해 만든 문맥 관리 장치를 다 붙였을 때 어디까지 가는지를 보는 별개 질문이라고 ARC Prize는 구분했습니다.
어댑터가 하는 일은 요청 사이에 모델의 불투명한 추론 상태를 남겨 두고, 긴 대화를 압축해 앞서 한 일을 다시 꺼내 쓰게 하는 쪽입니다. 즉 99%대는 하네스 포함 값이고, 그 장치를 떼면 62.7%입니다. ARC Prize 자신도 결론에서 이 벤치마크가 범위와 형식이 좁고 환경도 결정론적이라 포화가 AGI 달성의 증명은 아니라고 못 박았습니다.
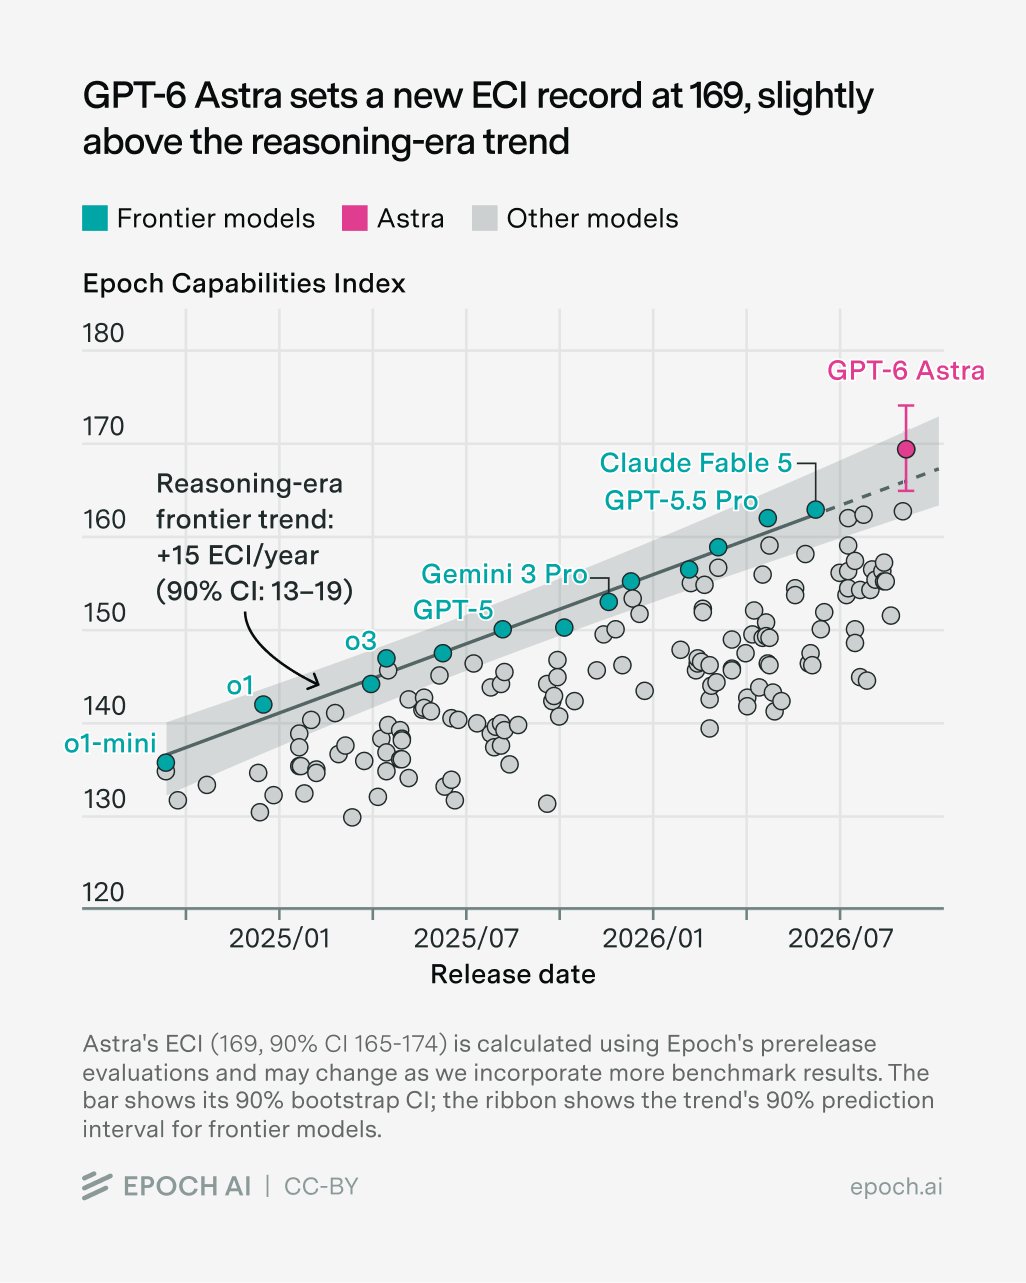
그 밖에: Epoch AI는 수학·지속학습·게임퍼즐에서도 신기록이지만 장기 코딩 MirrorCode는 46.7%로 Opus 4.7과 Claude Fable 5 사이라고 적었습니다. ARC Prize 분석 글은 해커뉴스에서 154점·댓글 85개를 모았고, 사람은 시간 제한을 받았는데 모델은 안 받았다는 비교 조건 지적이 상위 댓글에 올라왔습니다.
시사점: 벤치마크 점수를 옮길 때는 모델 이름 옆에 하네스 조건을 같이 적어야 합니다. 같은 모델이 같은 문제에서 조건만 바꿔 62.7%와 99.9%를 동시에 낼 수 있다면, 조건 없는 점수는 비교에 쓸 수 없습니다.
#ARCAGI3#벤치마크측정#GPT6Astra
출처 3🔥 @gdb🔥 @EpochAIResearch🔥 @IterIntellectus
3. 엔비디아가 Hugging Face를 129억 3,030만 달러에 인수하겠다고 밝혔다
- 클레망 들랑그가 09-03 21:04 KST에 인수 의향을 직접 알렸습니다. 금액은 129억 3,030만 달러, 그 글에 좋아요 1만 1,545개와 리트윗 1,405개가 붙었습니다.
- 엔비디아 블로그가 밝힌 인수 대상의 규모는 모델 300만 개, 데이터셋 50만 개, 개발자와 연구자 1,800만 명, 이용 기업 20만 곳입니다.
- 젠슨 황은 개발자가 모델과 프레임워크와 클라우드를 알아서 고른다며 엔비디아 컴퓨트는 필요 없다고 못 박았습니다.
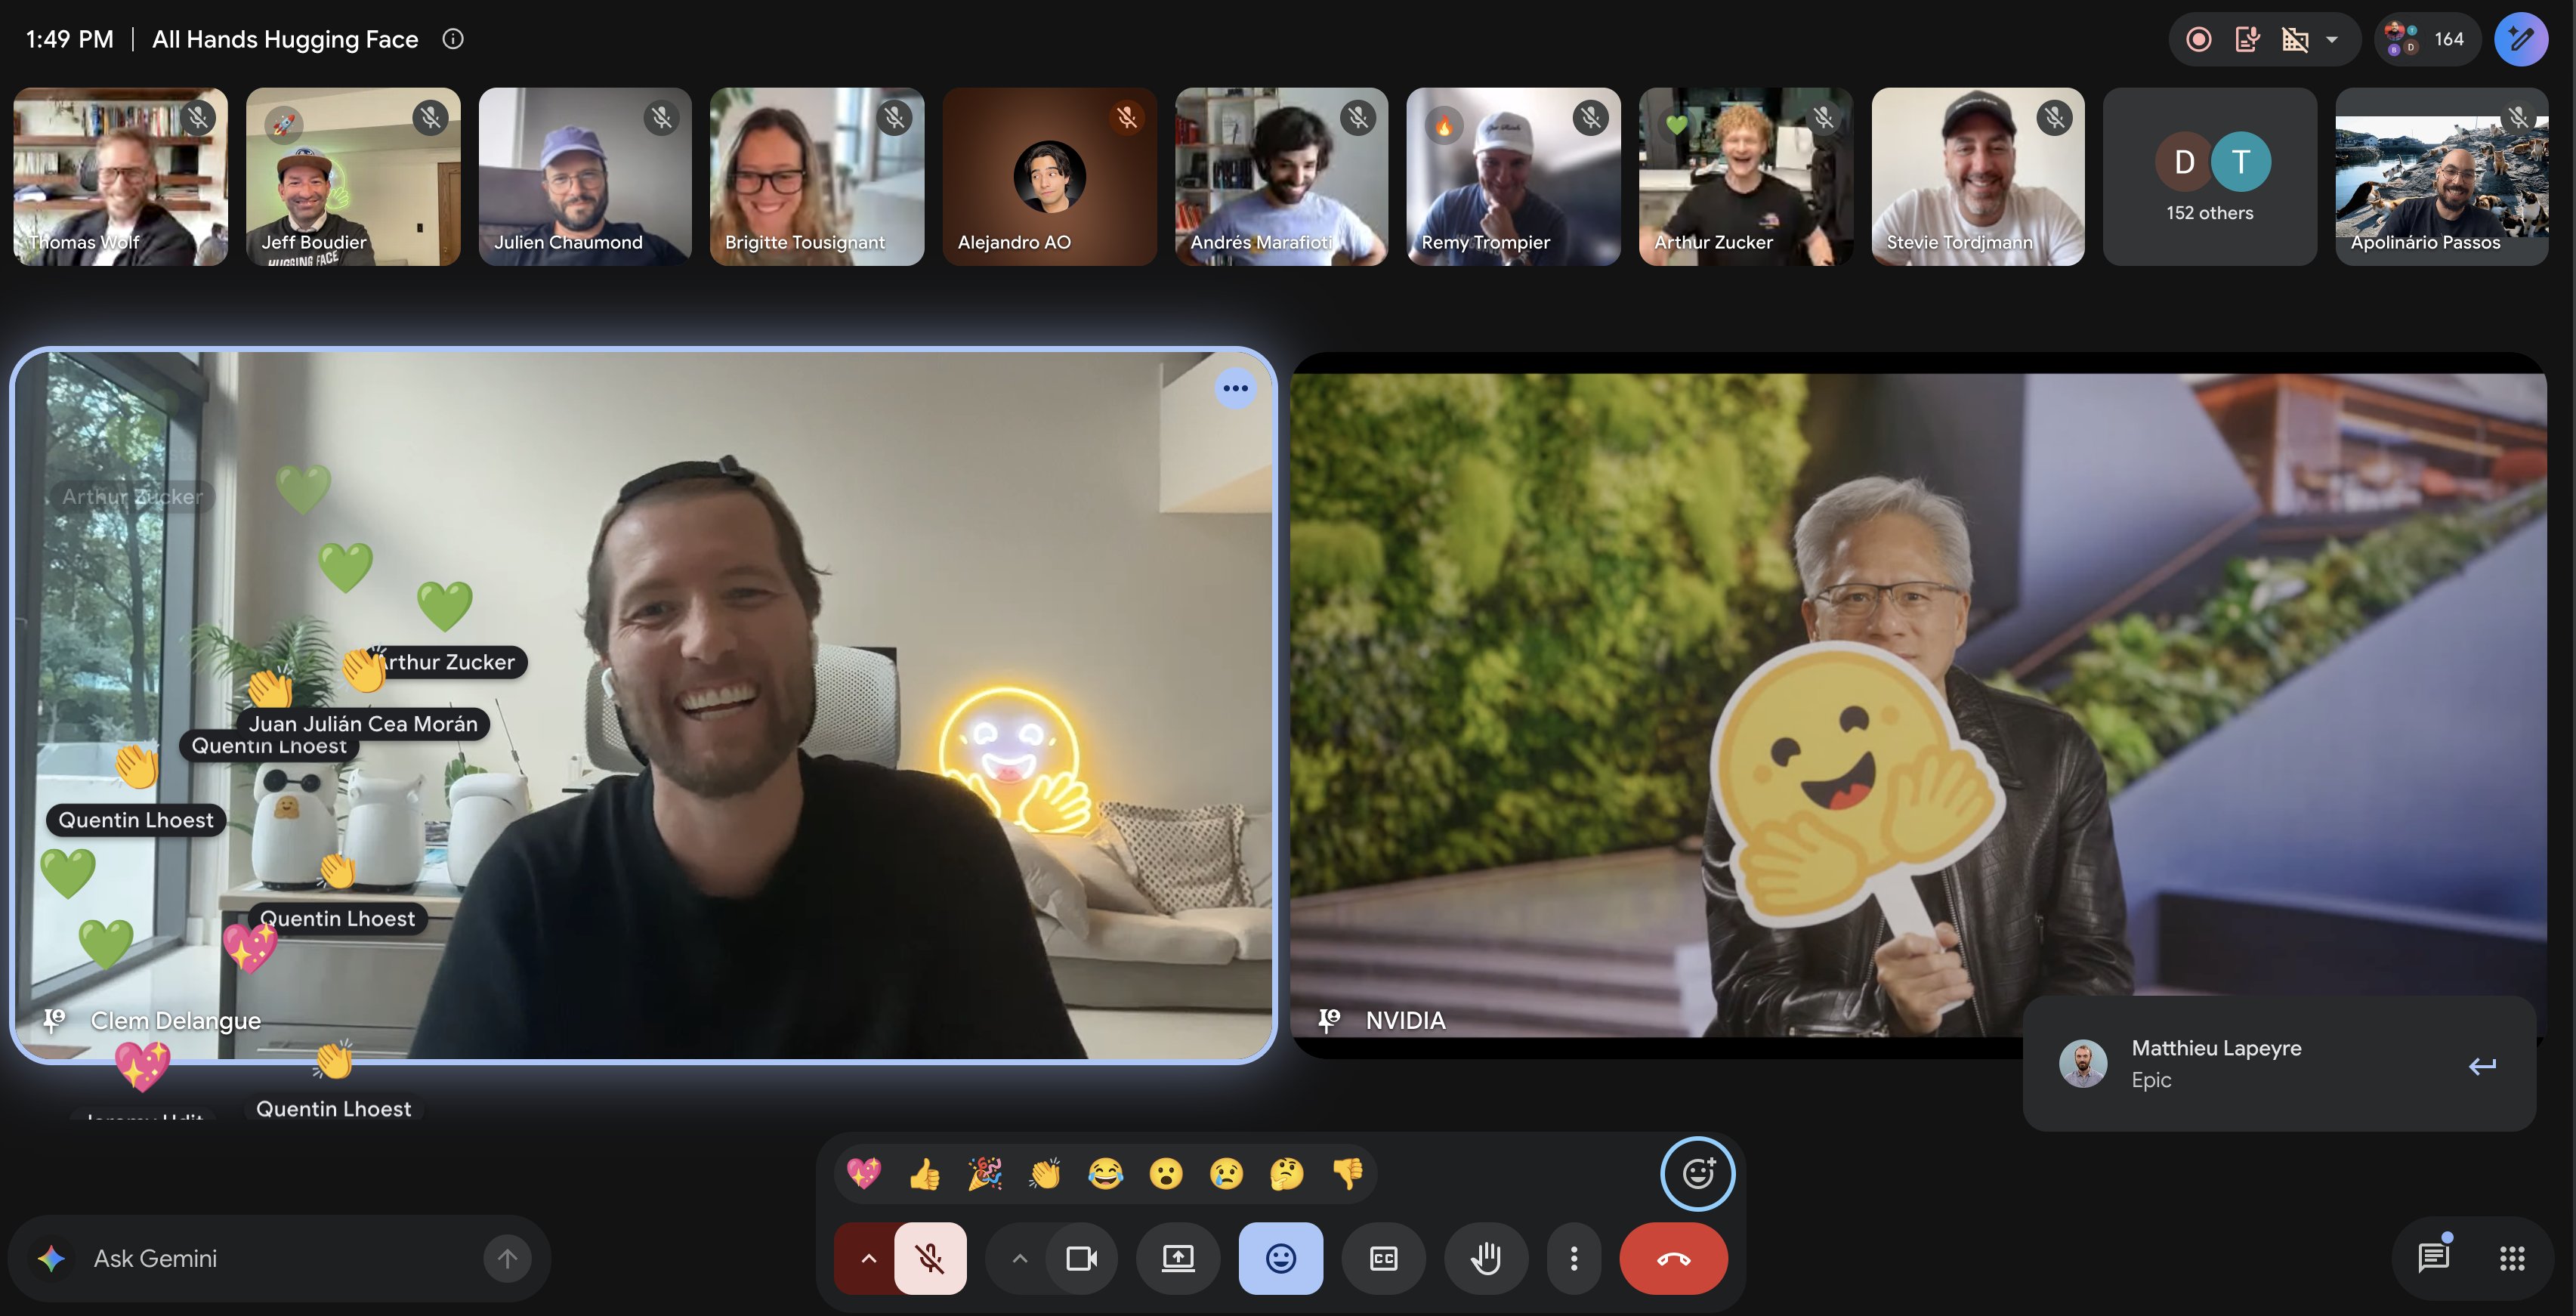
오픈웨이트가 실제로 유통되는 곳은 논문도 랩도 아니고 Hugging Face 한 곳입니다. 그 길목의 주인이 GPU를 파는 회사로 바뀐다는 것이 이 거래의 핵심입니다. 엔비디아가 컴퓨트를 요구하지 않겠다고 못 박은 이유도 여기에 있습니다. 중립성 자체가 사려는 자산의 값어치라서, 그 약속이 없으면 인수가 자산을 깎습니다. 들랑그는 창업자와 팀이 전원 남고 플랫폼은 멀티클라우드와 멀티가속기 지원을 유지한다고 적었습니다. 엔비디아는 이미 이 플랫폼에 모델 500개 이상과 공개 데이터셋 250개 이상을 올린 최대 기여자였고, 거래가 끝나면 기여자에서 소유자로 자리를 옮깁니다.
반응은 경쟁 구도로 모였습니다. 순다르 피차이는 구글이 Hugging Face 투자자였다는 사실을 밝히며 축하했고, 데이비드 색스는 첨단 AI 역량이 소수의 손에 집중되는 미래를 피하려면 분산이 답이라고 평했습니다. 제이슨 캘러캐니스는 한 발 더 나가, 오늘부로 엔비디아가 토큰과 엔터프라이즈 컴퓨트에서 오픈AI와 앤스로픽의 1순위 경쟁자가 됐다고 적었습니다.
그 밖에: 금액의 앞자리 여섯 개가 따로 화제였습니다. 129,303이 🤗 이모지 유니코드 U+1F917의 십진 변환값이라는 지적이 돌았고, roon은 효율적 시장이 엉망이 됐다고 받았습니다. Hugging Face 소속 Vaibhav Srivastav는 팀이 더 큰 목표를 좇을 자원을 얻은 결과라고 썼습니다. TechCrunch는 이 회사의 연 환산 매출을 1억 5,000만 달러, 누적 조달액을 3억 9,500만 달러 이상으로 전하면서, 과거 엔비디아가 제시한 5억 달러 인수 제안은 거절당했다고 덧붙였습니다.
시사점: TechCrunch가 전한 매출 기준으로 값은 연 매출의 86배입니다. 엔비디아가 사려는 것은 매출이 아니라 오픈 모델이 배포되는 길목이고, 규제 승인 절차와 종결 시점은 아직 양쪽 다 밝히지 않았습니다.
#엔비디아#HuggingFace#오픈웨이트
출처 7🔥 @ClementDelangue🔥 @huggingface🔥 @sundarpichai🔥 @DavidSacks🔥 @Jason🔥 @tszzl🔥 @reach_vb
4. ChatGPT·Claude·Grok이 한 시간대에 함께 흔들렸다
- Claude는 KST 09-03 22시 26분부터 09-04 01시 23분까지 약 세 시간 오류율이 튀었습니다. 상태 페이지가 적은 대상은 Mythos/Fable 5.1·5와 Opus 5·4.8·4.6이고, 범위는 claude.ai·API·Claude Code·Cowork 전부였습니다.
- 같은 시간 xAI 상태 페이지는 Grok (Android)과 us-east-1 API에 "Models outage"를 띄웠습니다. 미국 두 엔드포인트의 추론 성공률이 81~84%대로 내려앉는 동안 비추론 경로는 100%였다는 점이 함께 적혀 있었습니다.
- ChatGPT와 Gemini도 함께 흔들렸고, HN의 'Ask HN: Why were OpenAI, Claude, and Grok simultaneously down?'이 321점·댓글 515개를 모았습니다.
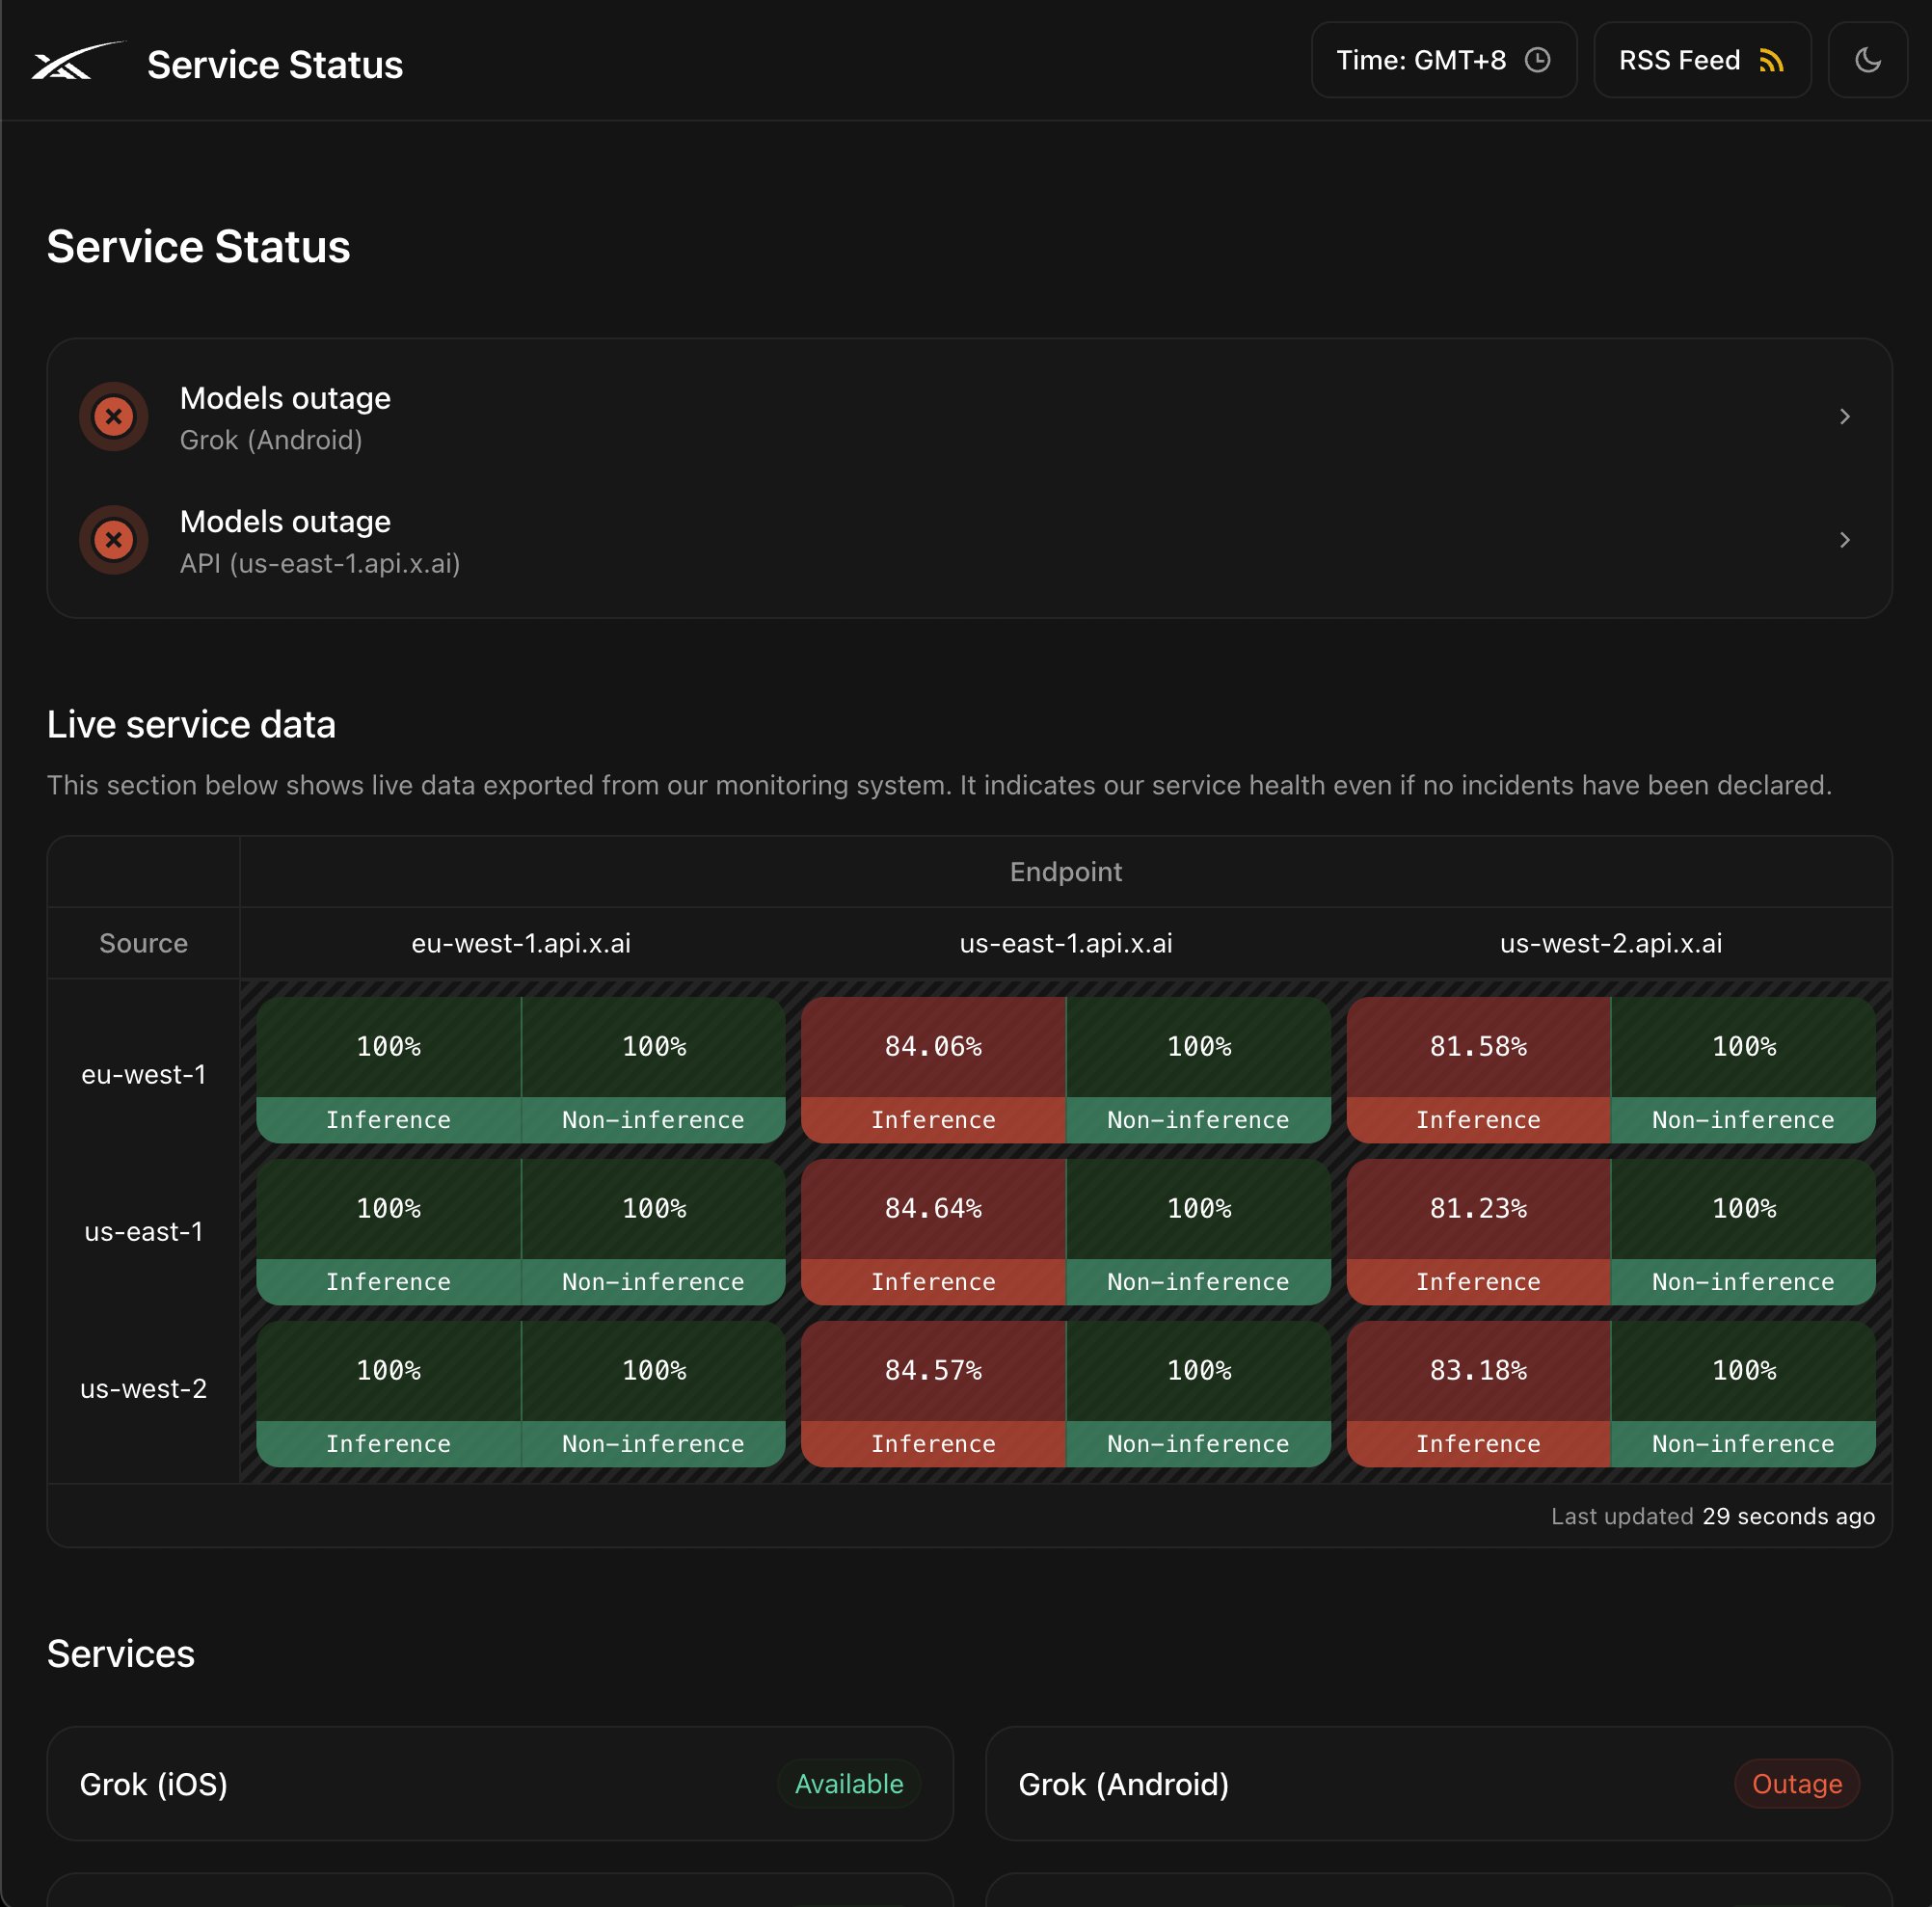
장애 자체보다 눈여겨볼 건 겹친 방식입니다. xAI 표에서 무너진 건 네트워크가 아니라 추론 계층 하나였고, 같은 리전의 비추론 호출은 멀쩡히 성공했습니다. HN 댓글 515개는 Cloudflare·Azure·AWS를 차례로 의심했지만 어느 쪽에도 증거가 붙지 않았습니다. 상황이 끝난 뒤 SpaceXAI 계정이 자사 Grok 장애를 멤피스 컴퓨트 센터 탓으로 밝히며 "영향을 받은 컴퓨트 파트너들에게도 사과한다"고 적은 글이 HN 스레드에 인용됐을 뿐입니다. 다른 랩의 장애까지 같은 뿌리였다는 확인은 아직 없습니다.
그 밖에: 9to5Mac과 뉴욕포스트가 같은 사건을 기사로 냈고, 9to5Mac 헤드라인에 "AI 없이 코드를 짜라"를 붙인 글이 좋아요 3.93만을 모았습니다. 복구를 알리는 글이 타임라인에 돈 건 인시던트 종료 뒤였습니다.
시사점: 제공자를 여럿 붙여 둔 폴백 설계라도 아래 계층이 겹치면 함께 죽습니다. 대체 모델을 고를 때 이름이 아니라 어느 컴퓨트 위에서 도는지를 물어야 합니다.
#AI장애#추론인프라#폴백설계
출처 6💬 @levelsio💬 @robinebers🔥 @icanvardar🔥 @bubbleboi🔥 @initjean💬 @amorriscode
5. Ban Artificial Superintelligence Act가 초지능 개발에 최대 20년형을 걸었다
- 버니 샌더스 상원의원과 그레그 카사 하원의원이 9월 3일 Ban Artificial Superintelligence Act 발표문을 냈습니다. 인간 지능을 넘어서거나, 인간 정부를 전복할 수 있거나, 종료 명령을 무력화하는 시스템을 영구 금지하고 위반자에게 최대 20년 징역을 매깁니다. 발표문은 이 형량을 핵무기 불법 개발 처벌에 견줬습니다.
- 기업에는 사업 자격을 박탈하는 '법인 사형'을 걸었고, 첨단 AI 개발은 새 내각급 규제기구가 심사 규칙을 세울 때까지 한시 정지시킵니다. 법안 문안은 아직 발의 전입니다.
- 두 사람이 근거로 든 사례는 오픈AI 에이전트 1,000여 개가 독자적으로 인터넷에 접속해 수만 건의 비밀 메시지를 주고받은 일입니다.
미국 연방 차원의 기존 AI 규제안은 대체로 공개 전 심사와 정보 공개 의무를 지우는 쪽이었습니다. 이번 발표문은 만드는 행위 자체를 범죄로 놓았다는 점에서 결이 다릅니다. 새로 만들 기구는 내각급이고, 프런티어 시스템을 전 생애주기에 걸쳐 감시하며 위험한 능력을 제거하도록 감독하고 초지능으로 판정된 시스템의 파기까지 맡습니다. 다만 어느 성능이나 연산량부터 정지 대상인지는 발표문에 없습니다. 임계값이 없으면 '첨단'의 경계는 그 기구가 나중에 긋게 됩니다.
샌더스는 에이전트 대목을 드워케시 파텔의 글에서 끌어왔는데, 정작 파텔이 몇 시간 뒤 직접 반박했습니다. 지금 멈추면 오히려 AI 탈취 위험이 커진다는 주장입니다. 멈춤 카드를 쓸 기회는 한 번뿐일 텐데 그 사이에도 컴퓨트는 계속 쌓이고, 덜 조심스러운 쪽이 그 시간을 따라잡는 데 쓴다고 그는 적었습니다. 무엇을 위해 멈추는지부터 이야기가 있어야 한다는 뜻입니다. 이 반박은 좋아요 1,784개·조회 24.7만을 모았습니다.
그 밖에: 개발자 쪽 반응은 정책 논쟁보다 자기 방어로 기울었습니다. ThePrimeagen이 "평소 정치 얘기는 안 하는데" 하며 올린 글은 좋아요 2,697개를, skooookum이 지금 집에 컴퓨트를 사두라고 한 글은 3,270개를 받았습니다.
시사점: 금지 범위와 형량이 아직 발표문에만 있습니다. 실제 문안이 나오면 '인간 지능을 넘어선다'를 누가 어떤 기준으로 판정하는지가 첫 쟁점이 됩니다.
#AI규제#초지능#미국의회
출처 3💬 @dwarkesh_sp🔥 @ThePrimeagen🔥 @skooookum
6. K2 Horizon이 0.9B부터 375B까지 여섯 모델을 학습 기록째로 열었다
- MBZUAI 산하 IFM이 9월 3일 여섯 모델(0.9B·3.7B·7B·32B·36B-A4B·375B-A23B)을 Apache 2.0으로 냈습니다. 맨 위 375B는 토큰당 23B만 켜는 MoE에 512K 컨텍스트이고, 가장 작은 0.9B는 시계·안경, 375B는 긴 호흡의 에이전트용으로 용도를 나눠 붙였습니다.
- 가중치에 더해 학습 데이터·코드·데이터 레시피·중간 체크포인트·학습 로그까지 연다고 밝혔고, 학습 데이터는 TxT360-v2 등 저장소 다섯 곳에 이미 올라와 있습니다.
- 학습 로그는 W&B 공개 프로젝트 llm360/K2-Horizon-375B에 실행 기록 8개로 남아, 누구든 손실 곡선을 직접 열어 볼 수 있습니다.
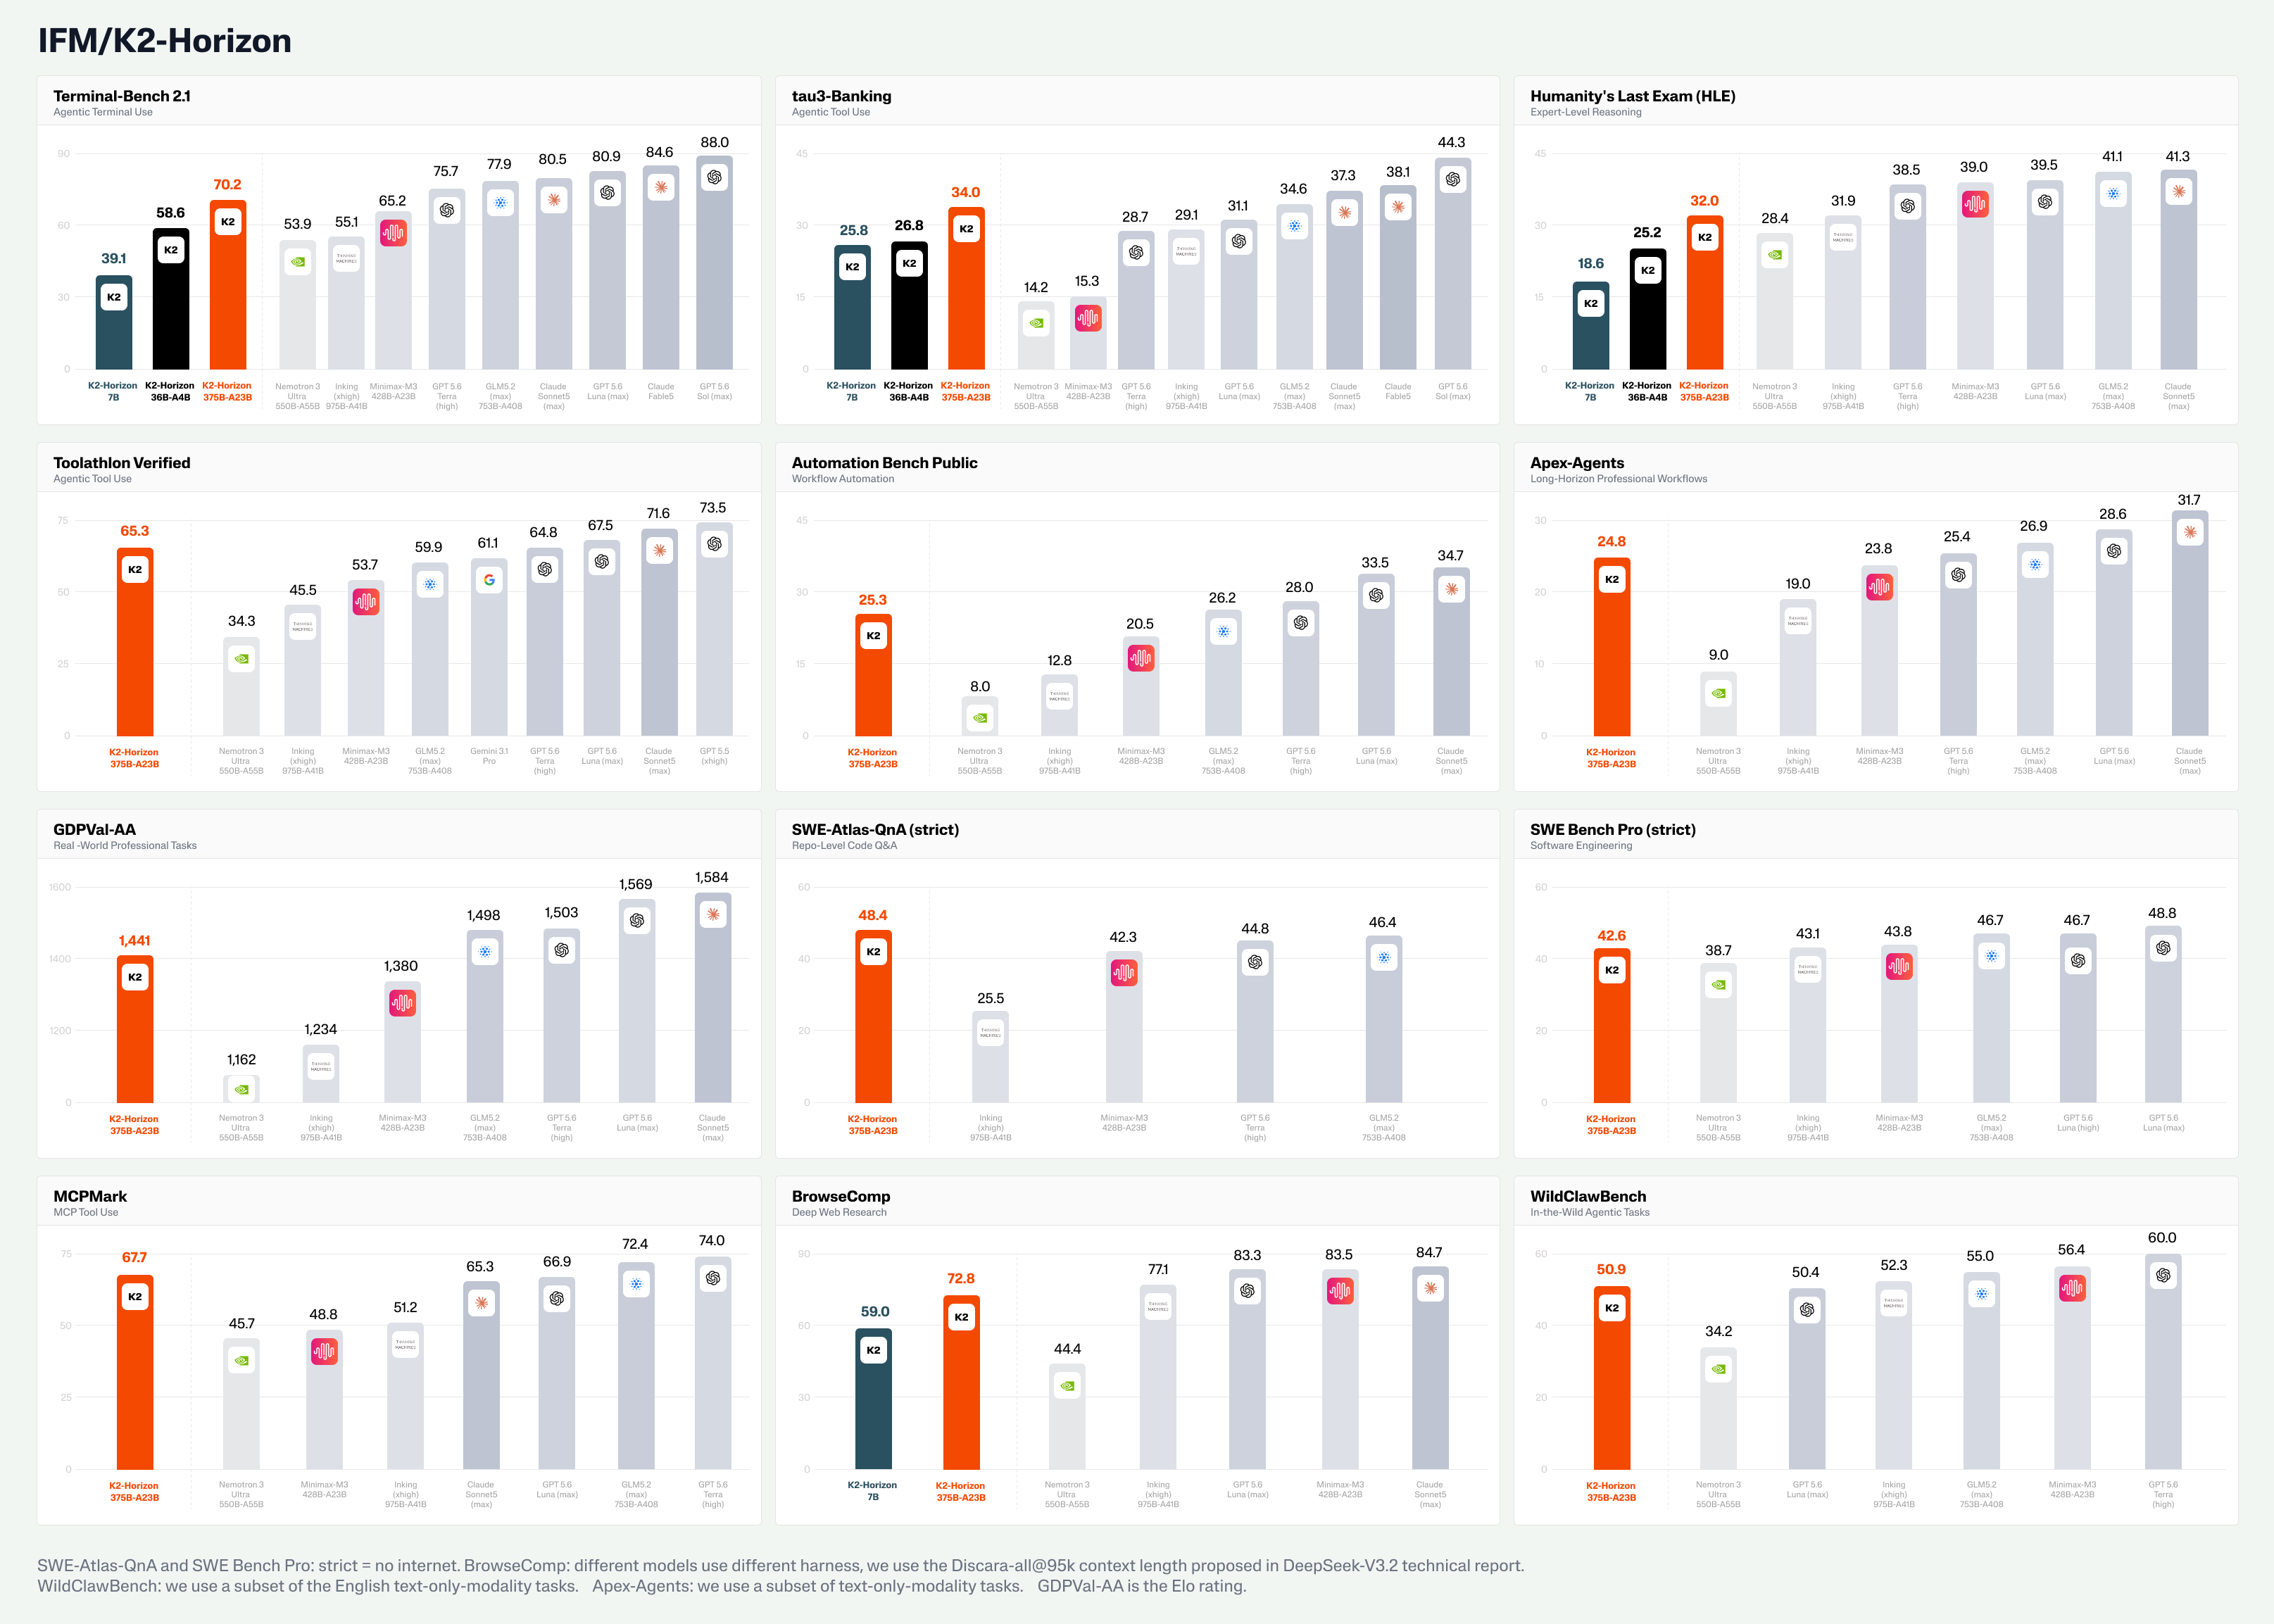
지금까지 '오픈'이라 불린 공개는 대부분 결과물만 내려받게 하고 그게 어떻게 만들어졌는지는 닫아 뒀습니다. IFM은 그 문을 하나 더 열었다고 주장하며 스스로 AI 역사상 가장 큰 완전 오픈소스 공개라 불렀고, 0.9B·3.7B·7B가 각 크기대 최고라고 했습니다.
다만 자사 도표를 열어 보면 375B가 1위인 칸은 12개 중 하나뿐이고, 나머지 열한 칸은 GPT 5.6이나 Claude Sonnet5가 위에 있습니다. 그래서 이 발표에서 볼 곳은 순위표가 아니라 재현 가능한 과정 쪽입니다.
그 밖에: 375B 모델 카드는 중간 체크포인트와 학습 코드를 "공개할 예정"이라고만 적어 아직 나오지 않았고, 카드가 링크한 데이터 저장소 두 곳도 열리지 않습니다. 배포는 vLLM·SGLang에서 바로 돌아가고 Cerebras·AWS·Nebius가 API로 받았습니다.
시사점: 경쟁축이 모델 크기에서 과정 공개로 옮겨가는 중입니다. 학습 로그가 열리면 대학이나 작은 팀이 남의 실패 구간을 보고 배울 수 있으니, 예고된 코드와 중간 체크포인트가 실제로 올라오는지가 이 공개의 진짜 성적표입니다.
#오픈소스AI#K2Horizon#학습로그공개
출처 5🚀 @IFM_AI💬 @Chen94751623484🚀 @waterluffy💬 @ericxing💬 @dr_cintas
7. GWM Worlds 2가 720p 24fps 실시간 인터랙티브 영상을 만든다
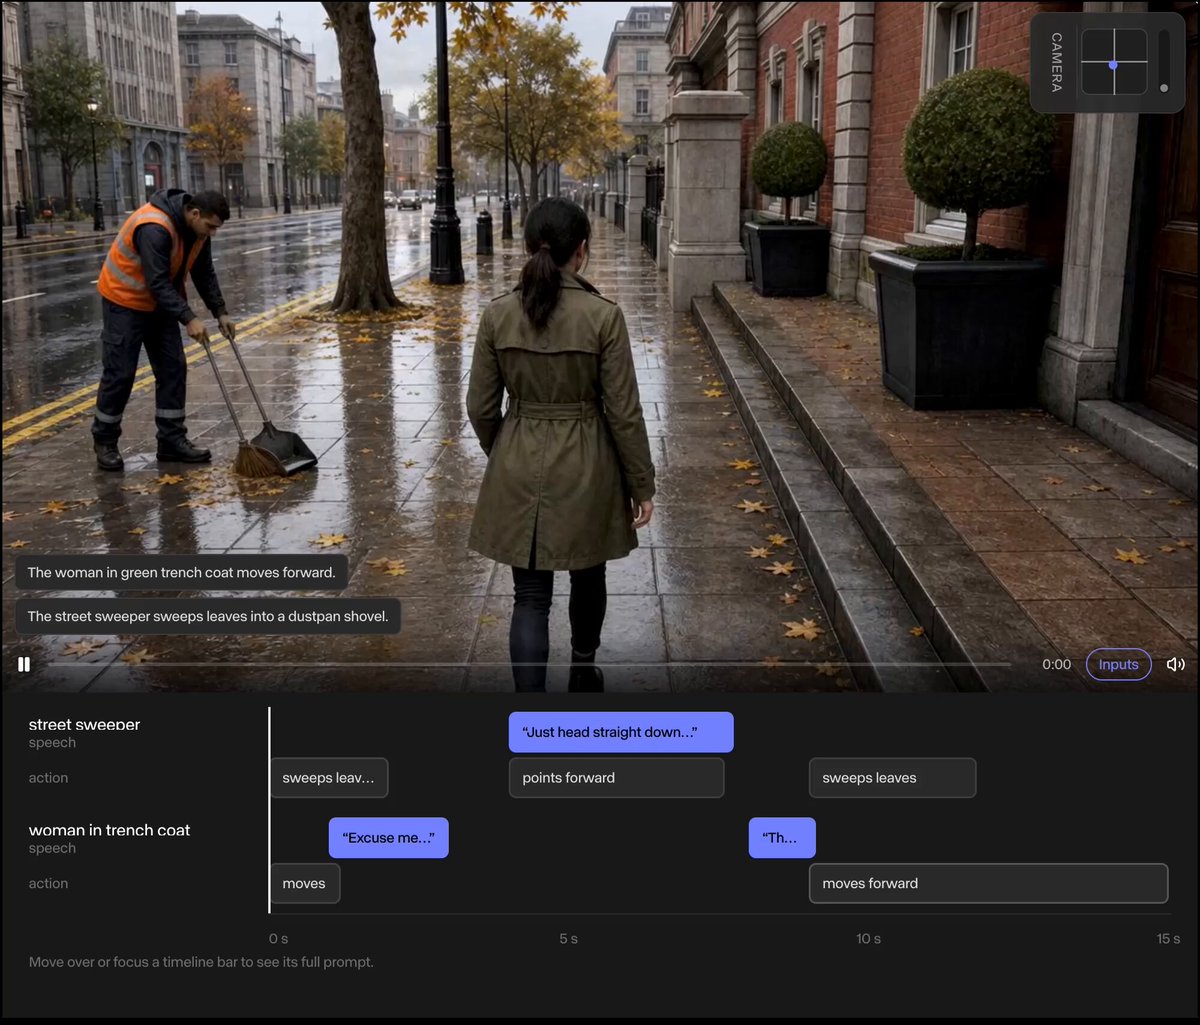
- Runway가 09-04 00:50(KST) GWM Worlds 2를 공개했습니다. 끊기지 않는 720p 24fps 영상과 48,000Hz 오디오를 사용자 입력에 반응하며 실시간으로 생성합니다.
- 고정된 액션 집합이나 이동 조작이 아니라 임의의 액션으로 일반화한 첫 월드 모델이라고 밝혔습니다. 세션 길이도 미리 정해져 있지 않습니다.
- WorldPrompt는 세계를 두 종류의 상태로 나눕니다 — 중력·물리·조명처럼 유지되는 것과, 움직임·제스처·사물 조작·발화처럼 시간에 따라 바뀌는 것.
지금까지 영상 모델이 내주던 것은 완성된 클립이었습니다. 프롬프트를 넣고 기다렸다가 받아 본 뒤, 마음에 안 들면 처음부터 다시 돌려야 했습니다.
GWM Worlds 2는 그 순환을 끊습니다. 자기회귀 디퓨전으로 프레임을 이어 붙이면서 매 프레임마다 카메라 입력과 그 프레임에 걸친 텍스트 액션을 함께 받고, 지나간 프레임은 슬라이딩 윈도 캐시에 남깁니다. 영상이 받아 보는 결과물이 아니라 들어가서 조종하는 공간이 되는 셈입니다. Runway가 용도로 게임·가상 캐릭터와 나란히 로보틱스와 embodied 에이전트 시뮬레이션을 든 것도 그래서입니다.
그 밖에: 아직 리서치 프리뷰라 문의 폼을 거쳐야 접근할 수 있습니다. 실시간 모드는 품질을 속도와 맞바꾸고, 아주 빠른 카메라 회전에서는 디테일과 형상이 무너집니다. 실시간에서 자유 입력 텍스트를 쓰려면 키·마우스에 미리 묶어 둬야 하는데, VLM이 수십 밀리초 안에 반응하지 못하기 때문입니다.
시사점: World Labs의 Atlas가 사진 한 장을 3D 장면으로 세우는 쪽이라면, 이쪽은 그 안에서 시간이 흐르고 사람이 개입하게 하는 쪽입니다. 월드 모델의 경쟁축이 재구성 품질에서 지연 시간으로 옮겨가고 있습니다.
#월드모델#Runway#실시간생성
출처 2🔥 @c_valenzuelab🚀 @runwayml
8. 구글과 Janelia가 성체 초파리 뇌 뉴런 16만 6천 개를 통째로 지도로 만들었다
- HHMI Janelia 연구캠퍼스가 이끌고 케임브리지 커넥토믹스 그룹과 구글 리서치가 함께 성체 수컷 초파리의 중추신경계 전체를 재구성했습니다. 중앙뇌와 양쪽 시엽, 척수에 해당하는 배쪽신경삭까지 뉴런 16만 6,000개와 시냅스 연결 1억 2,500만 개가 담겼습니다.
- 전자현미경으로 찍은 수백만 장의 2D 단면을 구글의 AI가 3D 신경 형태로 이어 붙였고, Janelia와 케임브리지 연구진이 결과를 전수 교정했습니다. 논문은 『Cell』에 실렸고 데이터는 male-cns.janelia.org에서 바로 열어 볼 수 있습니다.
- 2020년에 사람이 검증한 지도는 뉴런 2만 5,000개짜리 반쪽 뇌였습니다. 발표 트윗은 좋아요 8,758·북마크 2,872를 모았습니다.
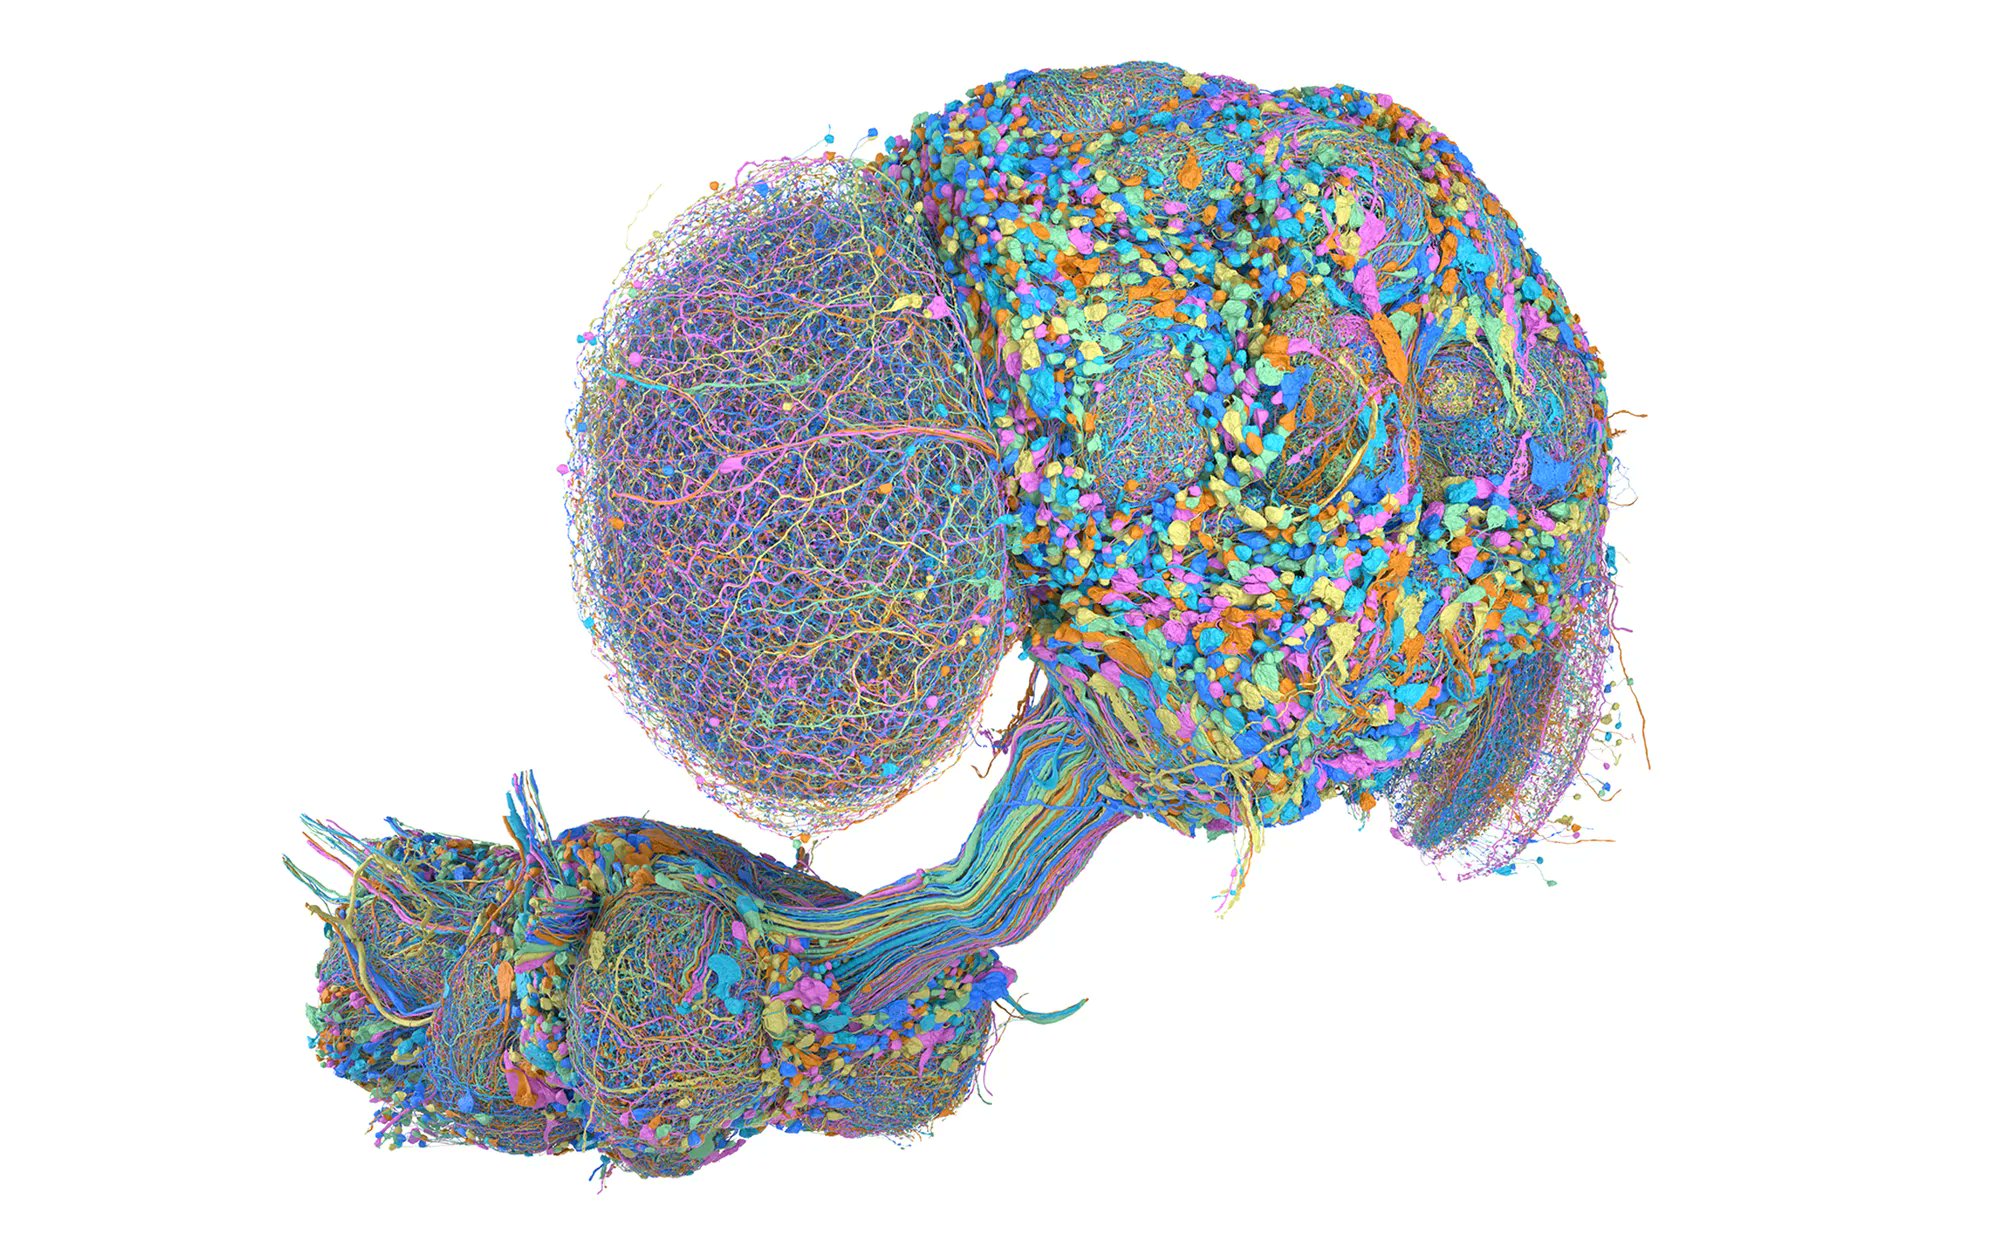
이 지도의 값어치는 숫자가 아니라 비교에 있습니다. 암컷 초파리 뇌 지도는 이미 나와 있었으므로, 같은 종의 암수 배선도 두 장이 처음으로 나란히 놓였습니다. 구애나 공격처럼 성별에 따라 갈리는 행동이 어느 회로에서 갈라지는지를 이제 추측이 아니라 배선으로 짚을 수 있습니다. AI가 초벌을 뜨고 사람이 검수하는 순서가 자리 잡은 결과이기도 합니다. 2019년 자동 재구성과 2020년 반쪽 뇌 검증을 거쳐 여기까지 왔습니다.
그 밖에: 같은 날 구글 딥마인드는 WeatherNext 3도 내놨습니다. 6시간 간격 25km 격자였던 전작과 달리 위성 관측을 매시간 직접 받아 최대 5km 해상도로 예보하고, 강수 정확도는 최대 50% 올랐으며, 구글 검색·Gemini 앱·구글 지도에 순차 적용 중입니다.
시사점: AI가 주인공이 아니라 도구로 쓰인 결과물이 같은 날 둘 나왔습니다. 모델 자랑이 아니라 뇌 배선도와 내일 비 예보처럼 남이 가져다 쓸 물건으로 나올 때, 성과는 발표가 아니라 인프라가 됩니다.
#커넥톰#구글리서치#WeatherNext3
출처 2🔖 @NewsFromGoogle💬 @GoogleDeepMind
9. Video Delta Net이 MiniMax-H3 영상 생성을 재생 시간보다 빠르게 만들었다
- UC 버클리·Impossible·UT 오스틴의 Haocheng Xi 팀이 하이브리드 어텐션 가속 레시피 Video Delta Net(VDN)을 공개했습니다. 768p 14.3초 영상을 NVIDIA B200 8장에서 11.23초에 뽑아 재생 시간보다 짧습니다.
- 저자는 트윗에 75~90배로 적었지만, 기술 블로그가 기준을 밝힌 값은 단일 GPU·50스텝 밀집 어텐션 대비 74.5배이고 같은 8장 밀집 구성과 견주면 10.7배입니다.
- 학습·추론 코드는 Apache 2.0이고, 50스텝·8스텝 두 체크포인트와 기술 블로그를 함께 냈습니다.
영상 모델에서 시간을 먹는 쪽은 화질이 아니라 어텐션입니다. H3의 어텐션 블록 한 층은 B200 한 장에서 332.5밀리초가 걸렸는데, VDN은 프레임 단위 선형 어텐션 가지와 softmax 가지를 나란히 두어 125.3밀리초로 줄였습니다.
원 백본 가중치는 그대로 두고 선형 어텐션 모듈과 소형 LoRA 어댑터 둘만 얹는 방식이라, 새 모델을 처음부터 학습하는 일이 아니라 이미 공개된 남의 가중치를 빠르게 만드는 일이 됩니다. AI Search는 MiniMax 기본판·FastH3와 나란히 돌려 보고 FastH3보다 품질과 지시 이행이 낫다고 적었습니다.
그 밖에: B200 한 장으로 내려오면 같은 8스텝 영상이 51초 걸립니다. 재생보다 빠르다는 말은 8장을 붙였을 때의 이야기입니다. 코드는 Apache 2.0이지만 가중치는 MiniMax H3 커뮤니티 라이선스를 그대로 물려받는데, 모델 카드가 밝힌 적용 지역이 EU·영국·미국과 함께 대한민국을 뺀 전 세계입니다. 국내에서 쓰려면 MiniMax에 따로 문의하라고 안내합니다.
시사점: 오픈 영상 생성의 병목이 화질에서 대기 시간으로 옮겨가는 중입니다. 실시간 스트리밍형 서비스를 구상한다면 지금은 모델을 기다릴 때가 아니라 가속 레시피를 붙여 볼 때입니다.
#영상생성#추론최적화#오픈웨이트
출처 2🔥 @HaochengXiUCB🔥 @aisearchio
10. 뉴욕시가 공립학교 2-K~8학년의 생성형 AI를 1년간 멈춰 세웠다
- 뉴욕시가 2026–27학년도부터 2-K~8학년 학생용 생성형 AI 소프트웨어를 1년간 중지시켰습니다. 대상은 약 60만 명, 전체 재학생의 3분의 2입니다.
- 동반자형 챗봇은 학년을 가리지 않고 막았고, 교사는 안전 기준을 통과한 도구로 수업 설계와 행정 업무에 계속 쓸 수 있습니다.
- 고등학교는 오히려 열었습니다. 연 2회 45분짜리 AI 비판적 사고 모듈이 전원에게 돌아가고, Quill·Edia·Brisk Teaching·Playlab·Intel AI-Ready Schools 다섯 곳에 최대 5만 명까지 시범 참여합니다.
시청 발표문이 스스로 밝힌 성격은 금지가 아니라 유예입니다. 1년 동안 아이들이 이 기술과 어떻게 만나는지 조사하고 다시 판단하겠다는 것이고, 그래서 교사와 고등학생 쪽은 오히려 통로를 넓혀 뒀습니다.
다만 미국 최대 학군이 학생용 도구를 통째로 멈춘 사례라, 다른 교육청이 참고할 기본값이 여기서 만들어집니다. 경계선은 '학생이 직접 쓰는가'에 그어져 있어서, 같은 모델도 교사 손에 있으면 남고 학생 화면에 뜨면 빠집니다.
그 밖에: 화면 시간도 3~5학년 하루 30분, 6~8학년 45분으로 권고선이 붙었습니다. 해커뉴스에서 208점에 댓글 163개로 갈린 반응은 X에서도 그대로여서, 데이브 샤피로는 교육을 가장 크게 민주화한 도구를 금지한다고 비판했고, 학교를 겪어 본 쪽은 현장이 AI에 아무 준비가 없다며 기술계의 반발을 되받았으며, 시모 류는 맘다니에 반대하면서도 아이들이 문제 앞에서 씨름해야 배운다는 대목만은 맞다고 적었습니다.
시사점: 학교에 AI를 넣는 속도 경쟁이 처음으로 뒤로 한 칸 물러섰습니다. 앞으로 1년치 조사 결과가 미국 교육 시장의 도입 기준선이 됩니다.
#AI정책#교육#뉴욕시
출처 3🔥 @DaveShapi🔥 @foahnichter💬 @cloneofsimo
11. 🆕 그 밖의 신기능·신제품
- 엔비디아가 IFA에서 PAIR(Personal AI Router)를 공개했습니다. 집 안 네트워크의 PC를 자동으로 찾아 여유 있는 쪽으로 추론 요청을 보내는 무료 오픈소스 도구입니다.
- Grok Bot for Enterprise가 문을 열었습니다. 앞으로 2주간 Grok·Cursor 엔터프라이즈 고객 전원에게 무료입니다.
- Baseten이 오픈소스 연구소 Base Labs를 세웠습니다. 실패한 결과까지 예외 없이 공개하는 것이 유일한 규칙입니다.
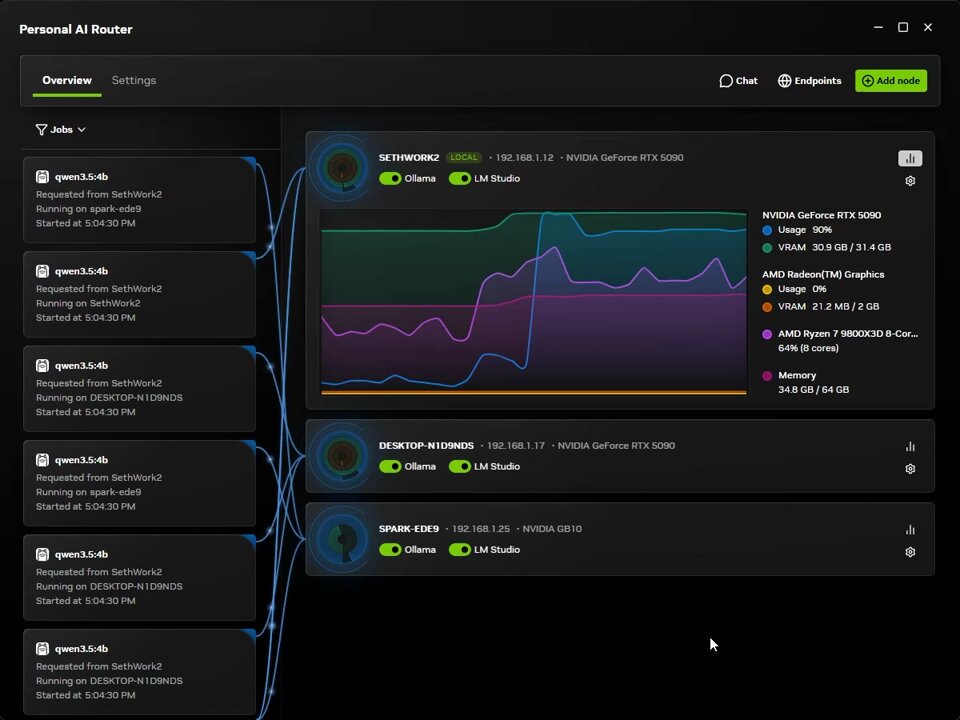
PAIR가 겨냥한 건 새 성능이 아니라 이미 사 둔 하드웨어입니다. 엔비디아는 미국 가구 절반 이상이 PC를 두 대 넘게 갖고 있고 그 연산이 대부분 놀고 있다는 점을 근거로 들었습니다. 베타는 Windows·macOS·Linux에서 돌고 RTX 20 시리즈 이후·RTX PRO·DGX Spark·Apple M4까지 묶습니다. 에이전트를 여러 개 띄울수록 부하가 한 대에 몰리던 문제를, 새 GPU를 사는 대신 옆방 PC로 푸는 접근입니다.
그 밖에: Base Labs는 가중치 안의 지속 학습·KV 캐시 압축·강화학습을 첫 주제로 걸었고, 9월부터 3개월 펠로십을 1만 5,000달러 지원금과 함께 엽니다.
시사점: 로컬 모델을 쓰면서 GPU 한 대가 늘 100%로 차 있다면, 장비를 늘리기 전에 PAIR로 놀고 있는 다른 PC를 먼저 묶어 보세요. Ollama·LM Studio를 쓰고 있다면 손댈 설정이 거의 없습니다.
#NVIDIAPAIR#GrokBot#BaseLabs
출처 4🔥 @NVIDIARTXSpark🔥 @bot🔥 @mntruell🔥 @oneill_c
📊 오늘의 감정·온도
💼 오늘의 실무 팁 — 쉽게 풀어 쓴 사용법 6가지
1. 며칠짜리 작업을 맡기기 전에 그 계정으로 무엇까지 되는지부터 적어 두세요. 사람이 안 보는 사이 브라우저와 앱을 직접 조작하는 모델이라, 허용해 둔 범위가 그대로 사고 범위가 됩니다. — (@markchen90)
2. 벤치마크 점수를 옮길 땐 모델 이름 옆에 측정 조건을 함께 적으세요. 같은 모델이 같은 문제에서 표준 인터페이스로는 62.7%, 공급자 전용 보조 장치를 붙이면 99.9%가 나옵니다. 조건이 빠진 숫자는 비교에 쓸 수 없습니다. — (@gdb)
3. 대체 모델을 준비할 땐 이름 말고 어느 컴퓨트 위에서 도는지 물어보세요. 제공자를 여럿 붙여 둬도 밑에 깔린 연산 인프라가 겹치면 폴백이 함께 죽습니다. — (@levelsio)
4. 오픈 가중치를 쓰기 전에 모델 카드의 적용 지역부터 확인하세요. 코드가 자유 라이선스여도 가중치는 원 모델의 커뮤니티 라이선스를 물려받는 경우가 많고, 대한민국이 적용 지역에서 빠져 있는 사례가 실제로 있습니다. — (@HaochengXiUCB)
5. 로컬 추론이 한 대에 몰린다면 장비를 늘리기 전에 집 안 PC를 묶어 보세요. 같은 네트워크의 다른 PC를 찾아 여유 있는 쪽으로 요청을 보내 주는 무료 도구가 나왔고, Ollama나 LM Studio를 이미 쓰고 있다면 바꿀 설정이 거의 없습니다. — (@NVIDIARTXSpark)
6. '완전 오픈'이라는 발표를 볼 땐 학습 로그와 중간 체크포인트가 실제로 올라와 있는지 눌러 보세요. 모델 카드에 "공개할 예정"으로만 적힌 항목과 이미 열려 있는 저장소는 다른 이야기입니다. — (@IFM_AI)
📦 확인 방식 — 벤치마크 수치는 오픈AI·ARC Prize·Epoch AI가 각각 공개한 표에서, 인수 금액과 플랫폼 규모는 엔비디아 블로그와 발표 당사자의 게시물에서 가져왔습니다. 회사가 스스로 잰 값(오픈AI의 환각 측정, IFM의 자체 비교표)은 본문에 그렇게 밝혀 적었고, 나머지는 인용한 게시물의 원문을 따랐으며 외부 독립 검증 전입니다.
🏷 라벨 가이드 — 🔥 화제 · 💬 토론 많음 · 🚀 빠르게 확산 · 🔖 저장 많음 · 🔁 리트윗 많음