오늘의 AI 브리핑 ·
DeepSeek, 캐시비용 890바이트로
5분 브리핑
약 3분 · 11개 흐름핵심만 먼저 읽고, 궁금한 소식은 본문으로 이어 보세요.
전체 분석 16분으로 바로 가기 ↓- DeepSeek이 V4.1 Flash를 오픈웨이트로 풀며 토큰당 KV 캐시를 890바이트까지 줄였다
정식 공개입니다. DeepSeek이 V4.1 Flash를 App·Web·API에 올리고 가중치도 MIT 라이선스로 함께 풀었습니다.
- OpenAI의 Astra 수학 성과를 두고 수학자들이 미공개 대화가 학습에 쓰였다는 의혹을 제기했다
TU Dresden의 Andreas Thom 교수가 9월 9일 Mastodon에 세 편짜리 글을 올려, OpenAI가 자신과 Gábor Kun의 방법으로 비소픽 군(non-sofic group)을 만들었다고 발표한 직후 OpenAI 연구자들에게 보낸 이메일과 그 답변을 공개했습니다.
- Cognition이 SWE-2를 공개하며 Terminal-Bench 2.1에서 92.8%로 비교 대상 1위에 올랐다
공개된 표에서 SWE-2가 1위인 줄은 Terminal-Bench 2.1 92.8% 하나입니다. FrontierCode 1.1 Main은 50.0%로 Fable 5.1(50.9%)과 GPT-6 Astra(53.3%)에 밀립니다.
- OpenAI가 투자은행·리서치용 ChatGPT for Financial Services를 열었다
OpenAI가 09-11 03:35(KST) 공식 계정에서 세 개의 글을 이어 올려 ChatGPT for Financial Services를 공개했습니다. GPT-6 Astra의 추론에 금융 데이터를 붙인 맞춤형 ChatGPT Work 경험입니다.
- OpenAI가 GPT-Live-1 음성 모델을 분당 5센트로 API에 올렸다
OpenAI가 9월 10일 GPT-Live-1을 API에 공개했습니다. ChatGPT 음성의 자연스러운 대화 왕복을 그대로 앱에 넣는 모델입니다.
- Google Pics가 Workspace에 풀리고 Gemini 앱이 Windows로 나왔다
Google Pics — Nano Banana로 만든 이미지 생성·편집 도구가 Google AI Pro·Ultra 구독자와 대부분의 Workspace 비즈니스 고객에게 배포되고 있습니다. Docs·Slides에 들어가 있고 Drive는 몇 주 뒤, 단독으로는 pics.new에서 열립니다.
- Tencent가 음성 생성·편집 통합 모델 AuK를 오픈소스로 공개했다
Tencent Hunyuan이 음성 파운데이션 모델 AuK를 MIT 라이선스로 공개했습니다. 1.5B 파라미터 하나가 제로샷 TTS, 지시 기반 생성, 말한 내용 편집, 속삭임 변환, 억양 제거, 음색·감정 전환, 잡음 제거, 화자 분리까지 맡습니다.
- CADArena가 AI의 CAD 설계 능력을 재기 시작했다
Normal이 CAD 생성 벤치마크 CADArena를 공개했습니다. 3druck 보도에 따르면 에이전트는 SOLIDWORKS·Onshape·Siemens NX·Autodesk Fusion·build123d 등 엔지니어가 실제로 쓰는 도구의 스크립트 인터페이스로 부품을 만듭니다.
- Meta의 Muse가 앱스토어 무료 2위에 올랐다
Alexandr Wang이 앱스토어 무료 앱 순위 스크린샷을 올렸습니다. 9월 11일 새벽(한국시간) 기준 1위 ChatGPT, 2위 Muse from Meta, 3위 Vinted였습니다.
- Kepler Computing이 7년 스텔스를 끝내고 EUV 없이 메모리 밀도를 올리는 칩 구조를 공개했다
공동창업자 Debo Olaosebikan이 7년 넘는 스텔스를 끝내고 Kepler Computing을 공개했습니다. 투자사 Intel Capital도 같은 시간대에 같은 내용을 확인해 줬습니다.
- 🆕 그 밖의 신기능·신제품
React 19.3 정식판 — View Transitions와 Fragment Refs가 안정화됐고, browser()·Trusted Types 지원과 Server Components의 Context가 들어갔습니다.
주요 키워드 TOP 5: DeepSeek V4.1 Flash · SWE-2 · ChatGPT for Financial Services · GPT-Live-1 · Hunyuan AuK
메인 이벤트: DeepSeek이 V4.1 Flash를 오픈웨이트로 풀며 토큰 하나를 기억하는 비용을 890바이트까지 줄였습니다.
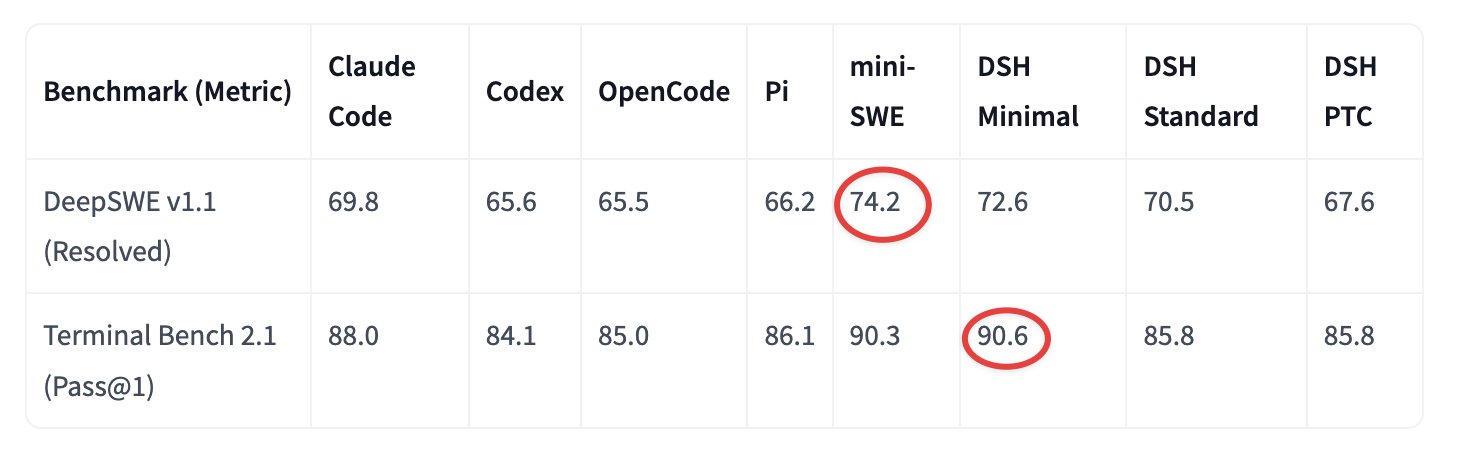
오늘의 중심은 DeepSeek입니다. 토큰 하나를 기억하는 데 드는 KV 캐시를 890바이트까지 줄인 구조 변경이 그대로 가격표로 옮겨졌습니다. 100만 토큰당 $0.30/$1.20이라는 값이 나왔고, Cline은 이를 Opus 5의 약 20분의 1로 계산했습니다. 몇 시간 뒤 Cognition도 SWE-2를 내면서 점수와 함께 롤아웃당 비용 곡선을 내놨습니다. 다만 두 회사가 내세운 1위 점수는 모두 자사 측정값입니다. DeepSeek의 90.6은 자기 하네스의 최소 구성에서 잰 값이고, SWE-2의 92.8%도 같은 자료의 다른 줄에서는 27.3%로 내려갑니다. 값이 내려간 것은 확인된 사실이고, 점수는 각자 자기 코드베이스에서 다시 재 봐야 하는 항목입니다.
1. DeepSeek이 V4.1 Flash를 오픈웨이트로 풀며 토큰당 KV 캐시를 890바이트까지 줄였다
- 정식 공개입니다. DeepSeek이 V4.1 Flash를 App·Web·API에 올리고 가중치도 MIT 라이선스로 함께 풀었습니다. 552B MoE인데 프롬프트를 읽을 때는 8B, 답을 쓸 때는 16B만 켜집니다.
- 토큰 하나를 기억하는 비용이 890바이트입니다. 기술 보고서는 V1의 389,120바이트에서 여기까지 줄였다고 적었습니다. 그사이 V3.2는 48,068바이트, V4-Flash는 3,514바이트였습니다. 45T 토큰으로 학습했고 컨텍스트는 1M, 이미지 이해는 네이티브입니다.
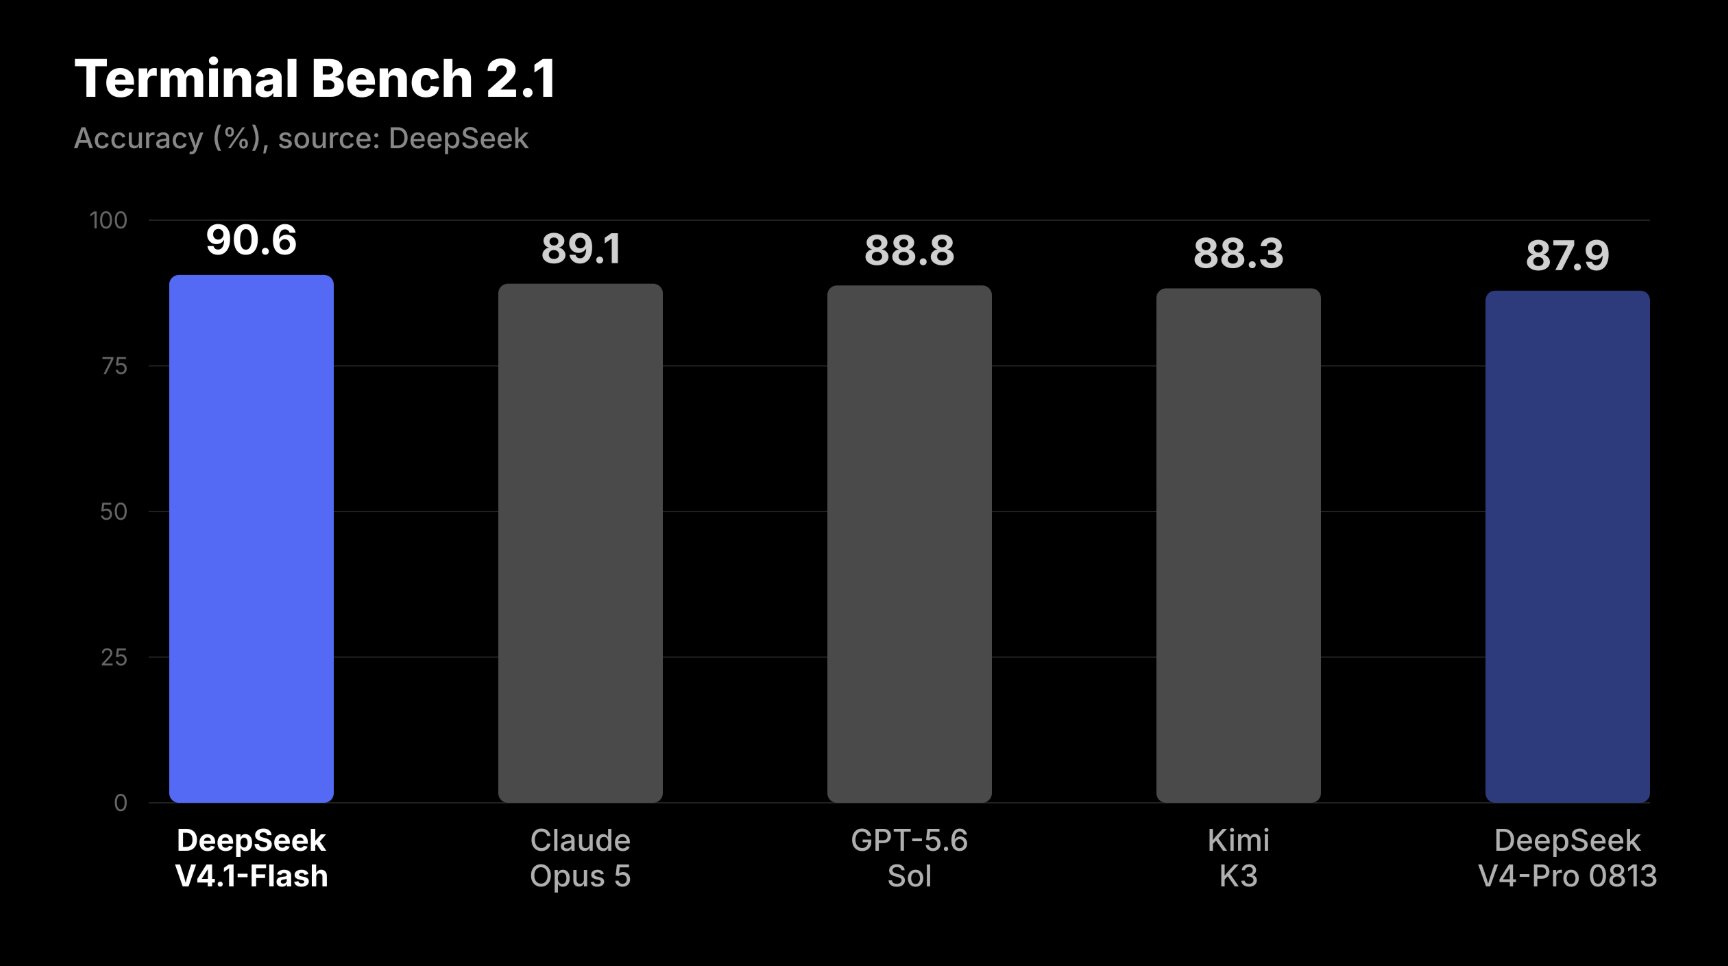
- 가격은 100만 토큰당 $0.30/$1.20입니다. Cline은 이 값을 Opus 5의 약 20분의 1로 계산했습니다. 같은 계산으로는 GPT-5.6 Sol의 17분의 1, Kimi K3의 12분의 1입니다. Terminal Bench 2.1에서도 90.6으로 세 모델을 모두 앞섰다고 덧붙였습니다.
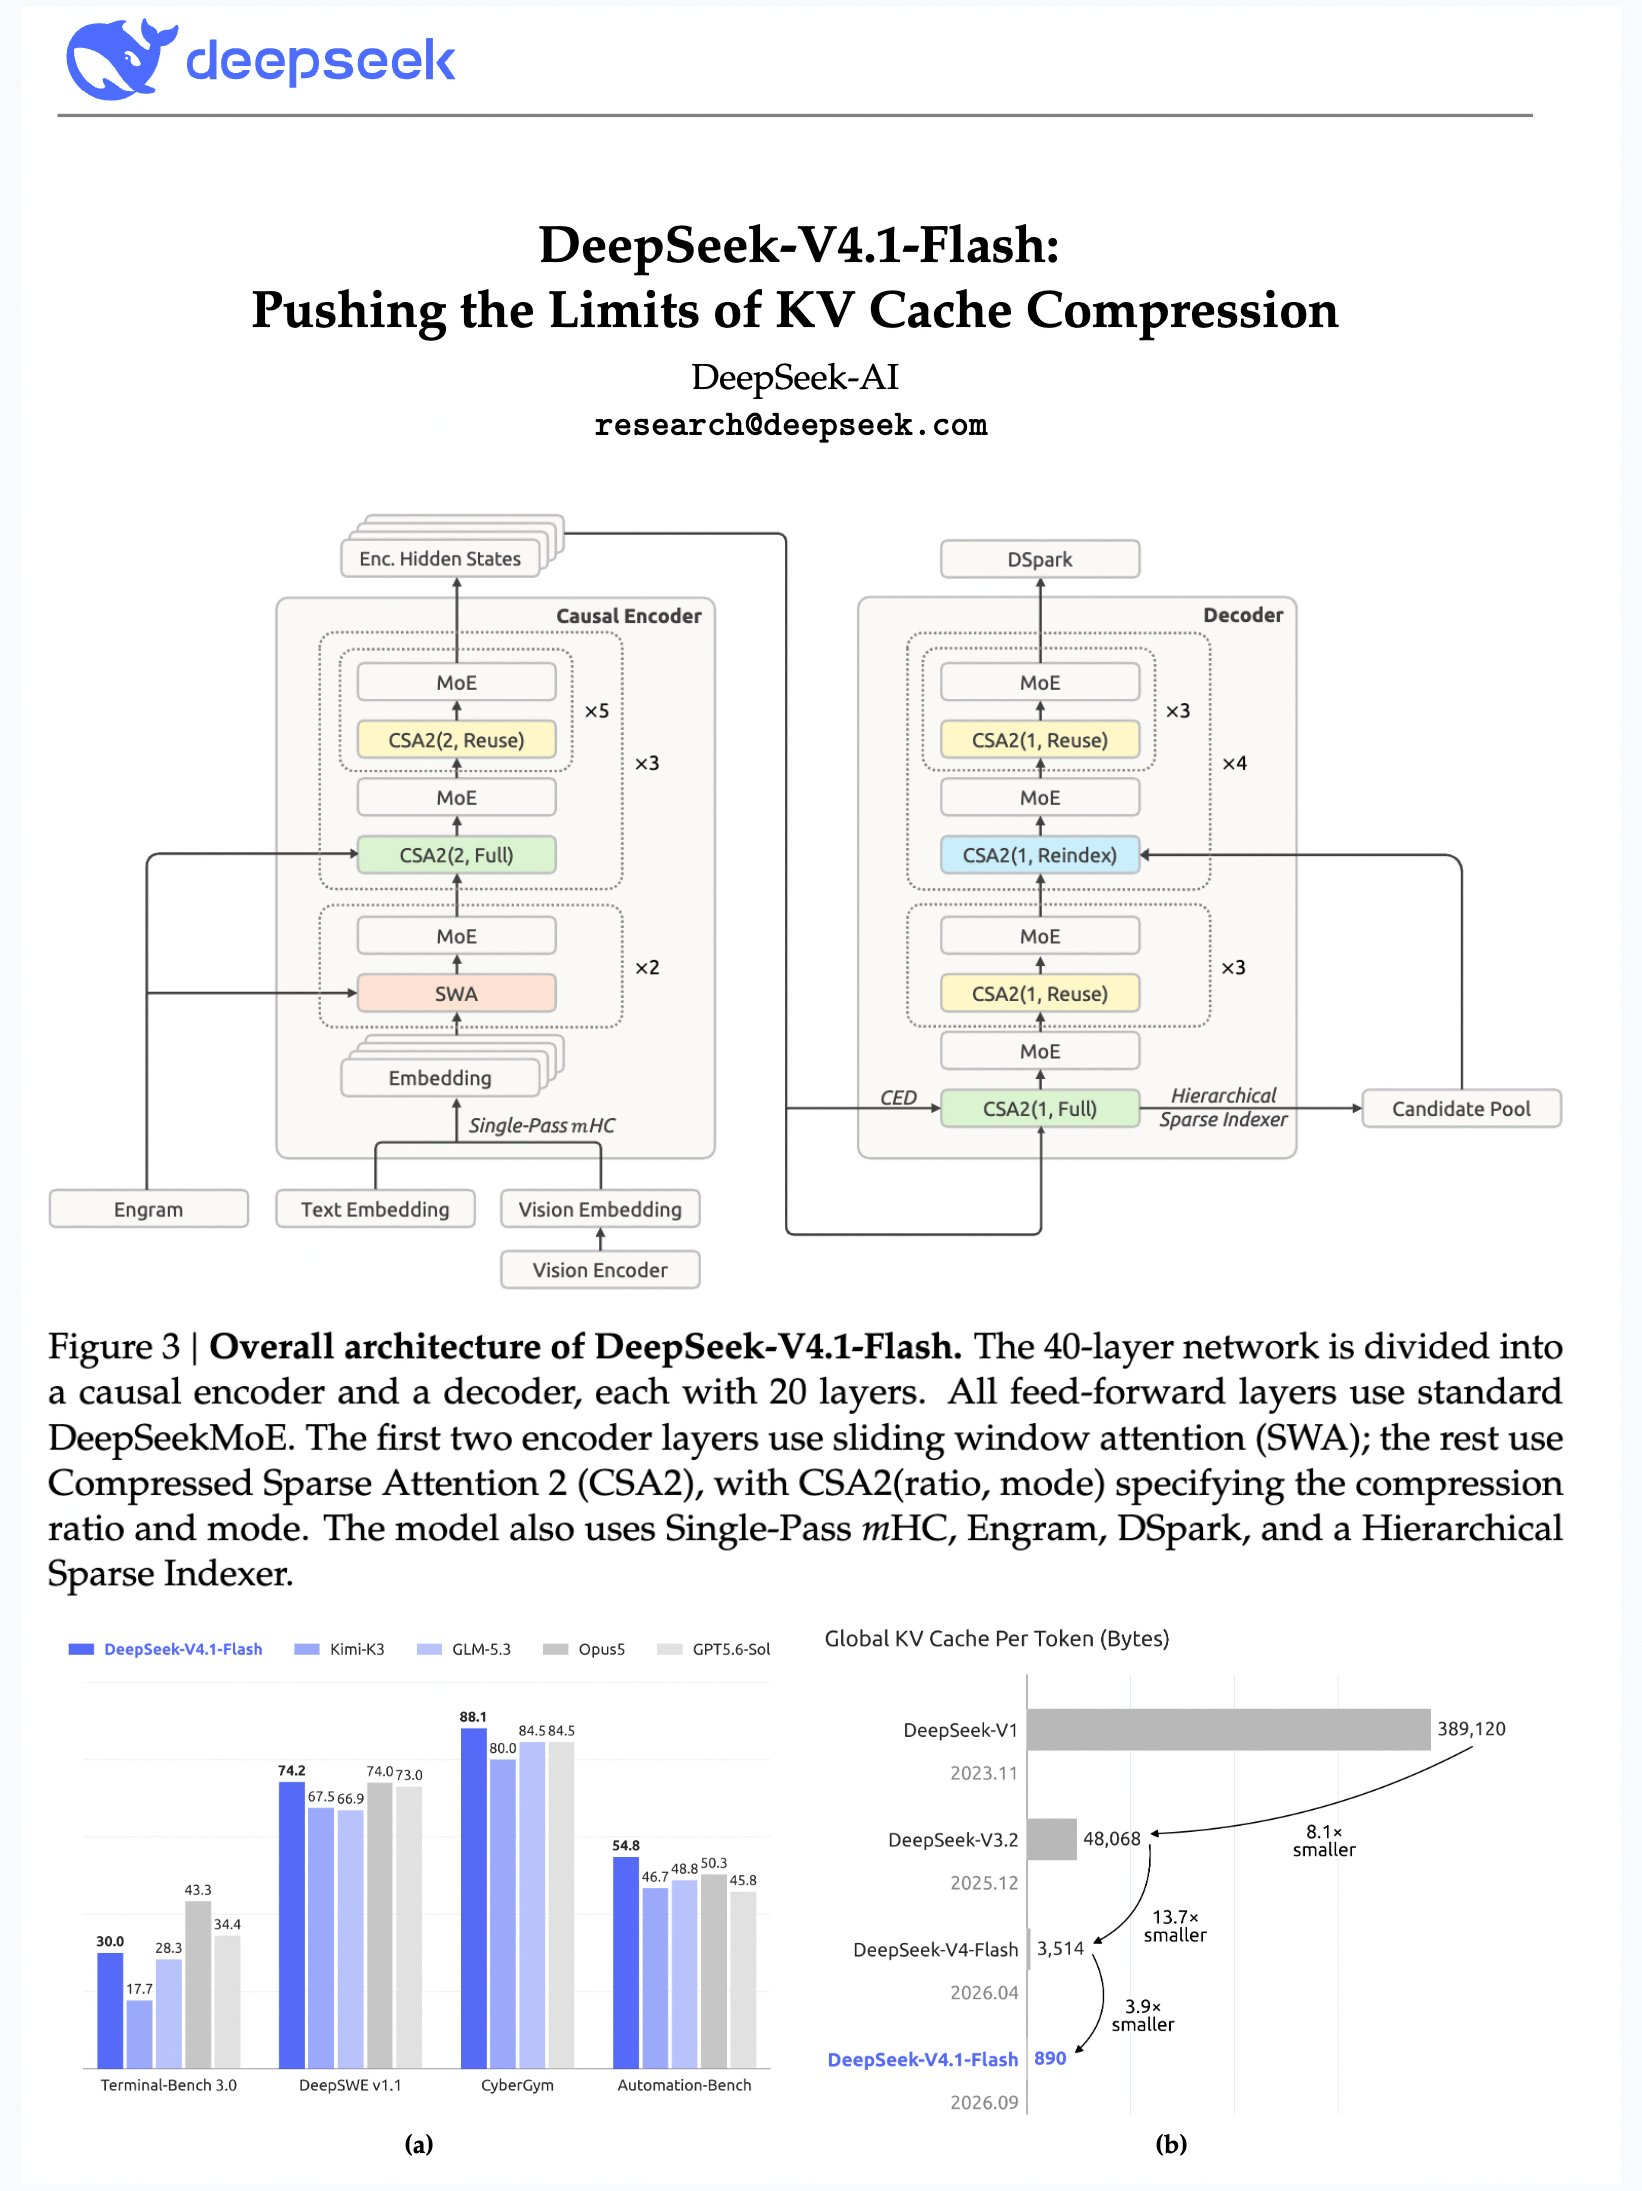
새 구조는 40층을 causal encoder 20층과 decoder 20층으로 나눈 것입니다. 인코더 첫 두 층만 창을 좁혀 보는 SWA를 쓰고 나머지는 CSA2로 KV를 압축하며, 여기에 Engram·DSpark·Hierarchical Sparse Indexer가 붙습니다. vLLM은 첫날부터 NVIDIA와 AMD GPU에서 검증했다고 밝히면서 두 가지를 짚었습니다. Engram은 계산하는 대신 찾아 쓰는 n-gram 기억으로 체크포인트의 4분의 1인 197B 파라미터를 차지하고, 압축한 KV를 실제로 적는 층은 네 개뿐이며 나머지 층은 그것을 공유합니다. OpenCode도 첫날 지원을 붙이고 72시간 동안 사용량을 4배로 열었습니다.
그 밖에: 캐시가 맞은 입력은 100만 토큰당 $0.006까지 내려가고 UTC 기준 비혼잡 시간대에는 표시가의 절반이 붙어, Polymarket은 1센트도 안 되는 값이라고 전했습니다. DeepSeek Harness도 v0.1.5로 같이 갱신됐고, Tim Dettmers는 하루 써 본 뒤 R1만큼 큰 발표라고 적었습니다. 해커뉴스 게시물은 900점을 넘겼습니다.
시사점: 비슷한 점수를 20분의 1 값에 받을 수 있게 됐지만, 90.6은 DeepSeek이 자기 하네스의 최소 구성에서 잰 값입니다. 같은 표에서 Claude Code는 88.0으로 내려갑니다. 지금 쓰는 도구 안에서 직접 재 보고 정하는 편이 안전합니다.
#DeepSeek #오픈웨이트 #KV캐시
출처 9🔥 @zizhpan🔥 @eliebakouch🔥 @cline🔥 @vllm_project🔥 @zainhas🔥 @Tim_Dettmers🔥 @opencode🔥 @Polymarket💬 @tianyi
2. OpenAI의 Astra 수학 성과를 두고 수학자들이 미공개 대화가 학습에 쓰였다는 의혹을 제기했다
- TU Dresden의 Andreas Thom 교수가 9월 9일 Mastodon에 세 편짜리 글을 올려, OpenAI가 자신과 Gábor Kun의 방법으로 비소픽 군(non-sofic group)을 만들었다고 발표한 직후 OpenAI 연구자들에게 보낸 이메일과 그 답변을 공개했습니다. Capraro에 따르면 그 결과는 OpenAI가 Astra로 풀었다고 발표한 열 개 난제 중 하나이고, Thom은 그 문제를 20년간 다뤄 온 이 분야 전문가입니다.
- 그는 두 가지를 나눠 물었습니다. 최근 몇 달간 ChatGPT와 나눈 미공개 논의가 ①학습 데이터에 들어갔는지 ②풀이 과정에서 접근 가능했는지입니다. Mark Sellke의 답변은 "당신의 ChatGPT 대화에 관해서는, 그런 일은 없었다"가 전부였습니다.
- Thom은 이 한 줄이 ②만 답한 것으로 보인다며 "명백히 부정직하다"고 적었습니다. 이 글은 Hacker News에서 416점, 이를 옮긴 Valerio Capraro의 X 게시물은 288점을 받았습니다.
Thom이 문제 삼은 것은 답변의 내용보다 범위입니다. OpenAI는 Tristan Buckmaster·Levent Alpöge 건에서 특정 사용자 데이터에 접근한 적은 없다면서도, 제품 사용에서 파생된 비식별 데이터가 모델 개선에 쓰였을 가능성은 배제할 수 없다고 밝혔습니다. Thom은 자신이 6월 29일에 학습 사용 설정을 껐지만 그 설정은 앞으로 만들 대화에만 적용되며, 그 이전 대화나 이미 뽑아낸 파생물이 어떻게 됐는지는 답하지 않는다고 지적했습니다. 수학 쪽 정황도 함께 적었습니다. 비소픽성 연구에서 Kun과 자신의 접근은 주된 공격선이 아니었고 양자 게임 쪽이 더 유망했는데, 모델이 하필 그 경로를 정확히 짚은 점이 의문이라는 것입니다. 그는 내부 학습 파이프라인을 외부가 역설계할 의무는 없으며, 단정적으로 부인하려면 설정·데이터셋·체크포인트라는 근거를 함께 내놓아야 한다고 요구했습니다.
그 밖에: 같은 날 Hacker News에는 "OpenAI가 학습 허용 설정을 계속 다시 켠다"는 사용자 제보가 411점으로 올랐고, 또 다른 연구자도 비슷한 일을 겪었다고 전한 Bluesky 글이 254점을 받았습니다. The New York Times의 9월 10일 Buckmaster 기사에서 OpenAI는 "Navier-Stokes를 끝낸 이후 또 다른 밀레니엄 문제에서 상당한 진전을 이뤘다"고 밝혔습니다.
시사점: 지금 확인된 사실은 학습 여부가 아니라, 확인할 방법이 사용자 쪽에 없다는 점입니다. 미공개 연구를 챗봇에 넣어 온 연구자라면 학습 사용 설정과 그 적용 시점을 지금 확인해 두는 편이 안전합니다.
#AI윤리 #연구데이터 #OpenAI
출처 3🚀 @ValerioCapraro🚀 @Hesamation🔥 @synthwavedd
3. Cognition이 SWE-2를 공개하며 Terminal-Bench 2.1에서 92.8%로 비교 대상 1위에 올랐다
- 공개된 표에서 SWE-2가 1위인 줄은 Terminal-Bench 2.1 92.8% 하나입니다. FrontierCode 1.1 Main은 50.0%로 Fable 5.1(50.9%)과 GPT-6 Astra(53.3%)에 밀립니다. DeepSWE v1.1은 73.0%로 GPT-6 Astra(74.1%) 다음입니다.
- Cognition은 주요 평가 전반에서 최전선 모델과 대등한 점수를 최대 70% 낮은 비용에 낸다고 밝혔습니다. 블로그가 든 근거는 "Fable 5.1과 1점 차이면서 64% 저렴하다" 한 건입니다.
- SWE-2는 처음부터 훈련한 모델이 아니라 Kimi K3(2.8T 파라미터)를 이어받아 후속 학습한 것이고, Cognition은 강화학습을 조 단위 파라미터 규모로 올린 첫 사례라고 설명합니다.
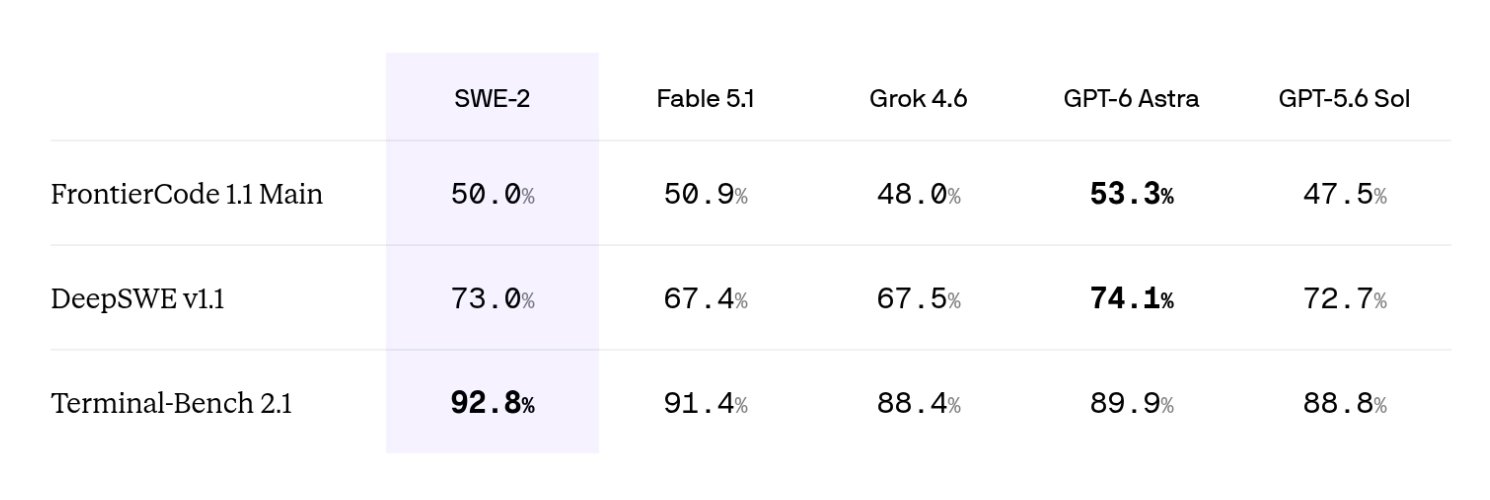
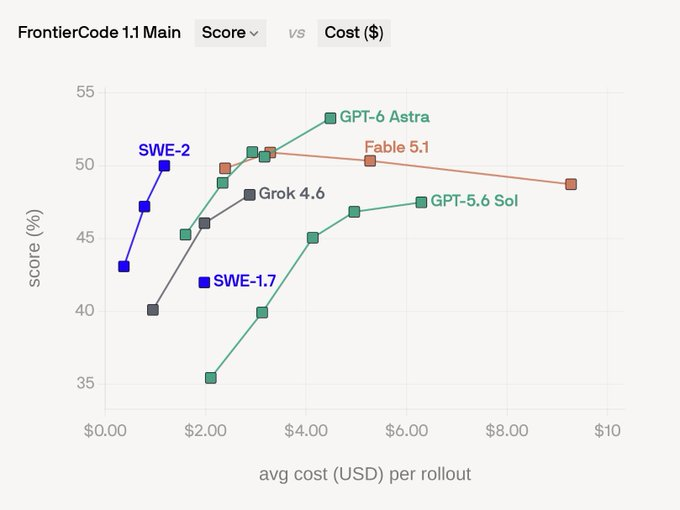
Cognition은 발표에서 성능과 비용 양쪽으로 파레토 곡선을 밀었다고 적었습니다. 회사가 함께 공개한 비용-점수 그래프에서 Fable 5.1은 비용을 $9대까지 늘려도 점수가 51%를 넘지 못하고, 가장 비싼 지점에서는 오히려 48%대로 내려갑니다. 다만 70%는 특정 벤치마크의 측정값이 아니라 여러 평가를 묶은 자사 요약이라 표에서 되짚을 수 없습니다. 약점도 같은 자료에 있습니다. 더 최근 평가인 Terminal-Bench 4에서 SWE-2는 27.3%에 그쳤습니다. 같은 줄에서 Fable 5.1은 55.8%, GPT-6 Astra는 57.9%입니다. 해커뉴스 토론(275점)에서도 92.8%와 27.3%의 간극이 첫 화제였습니다. SWE-2는 Devin Desktop과 CLI에서 먼저 쓸 수 있습니다.
그 밖에: 같은 날 Cognition은 9월 3일에 풀어낸 RSA-260 인수분해의 방법론을 공개했습니다. Devin과 연구자 한 명이 GPU용 격자 체(lattice siever)를 만들어 종전 공개 기록의 10분의 1 비용으로 낮췄고, 이번 계산에는 GPU 4,900일분, 시장가로 약 40만 달러가 들었다고 적었습니다.
시사점: 코딩 모델의 경쟁축이 점수에서 그 점수를 내는 값으로 옮겨가고 있습니다. 다만 벤치마크가 한 세대만 바뀌어도 순위가 뒤집히니, 도입 전에 자기 코드베이스에서 직접 재 보는 편이 안전합니다.
#SWE2 #Cognition #코딩모델
출처 3🔥 @cognition🚀 @omarsar0🔥 @cognition
4. OpenAI가 투자은행·리서치용 ChatGPT for Financial Services를 열었다
- OpenAI가 09-11 03:35(KST) 공식 계정에서 세 개의 글을 이어 올려 ChatGPT for Financial Services를 공개했습니다. GPT-6 Astra의 추론에 금융 데이터를 붙인 맞춤형 ChatGPT Work 경험입니다.
- Daloopa, PitchBook, LSEG News의 데이터셋이 제품 안에 들어 있습니다. 실적 발표 녹취록과 재무제표, 기업 기초 데이터를 별도 계약 없이 쓰게 했습니다.
- 수치와 주장을 특정 단락과 표까지 되짚는 인용 기능을 함께 내세웠습니다. 대상은 투자은행가와 주식 리서치 담당자입니다.
OpenAI는 Morgan Stanley와 Evercore를 디자인 파트너로 두고 이 제품을 만들었다고 밝혔습니다. 겨냥한 작업은 기업 조사와 재무 모델 작성, 고객용 자료 제작처럼 그동안 주니어 뱅커가 맡던 일입니다. 데이터를 OpenAI가 직접 색인해 두는 구조가 인용 기능의 전제입니다. 값이 어느 문서 어느 위치에서 왔는지 붙일 수 있어야 내부 감사와 규제 대응을 통과하기 때문입니다. 인용에 걸린 근거 구절을 미리 보거나 작업하는 중간에 바로 확인하는 화면도 함께 공개했습니다. Nick Turley는 ChatGPT에 애널리스트처럼 조사하고 애널리스트처럼 결론을 뒷받침하는 법을 가르치는 중이라고 설명했습니다.
그 밖에: OpenAI 자체 평가에서 GPT-6 Astra는 미국 재무부 회보 약 89,000쪽을 대상으로 한 133문항 벤치마크 OfficeQA Pro에서 69.9%를 기록했습니다. 같은 평가에서 GPT-5.6 Sol은 60.2%, Claude Fable 5.1은 62.4%였습니다. FactSet과 S&P Global 같은 외부 서비스는 연결해서 씁니다.
시사점: 자격 요건을 갖춘 기관만 쓸 수 있고 가격은 공개되지 않았습니다. 도메인 데이터와 출처 추적을 한 묶음으로 파는 방식이 기업용 AI의 기본 형태로 굳는 중입니다.
#OpenAI #금융AI #출처추적
출처 4🔥 @OpenAI🔥 @OpenAI🔥 @OpenAI🔥 @wallstengine
5. OpenAI가 GPT-Live-1 음성 모델을 분당 5센트로 API에 올렸다
- OpenAI가 9월 10일 GPT-Live-1을 API에 공개했습니다. ChatGPT 음성의 자연스러운 대화 왕복을 그대로 앱에 넣는 모델입니다.
- 말하면서 동시에 듣기 때문에 사용자가 중간에 끊거나 잠깐 멈춰 생각해도 대화가 끊기지 않습니다.
- 음성 세션 요금은 분당 $0.05이고 초 단위로 과금됩니다. 뒤에서 도는 모델과 도구 사용료는 따로 청구됩니다.
구조를 보면 음성과 추론이 갈라져 있습니다. GPT-Live-1은 듣고 말하는 앞단만 맡고, 깊은 추론과 도구 실행은 뒷단으로 넘깁니다. 뒷단은 OpenAI 모델에 맡기거나 직접 운영하는 서버에 연결하는 두 방식 중에서 고를 수 있습니다. 호출은 v1/live/sessions 전용이라 기존 Chat Completions나 Realtime 엔드포인트로는 쓸 수 없습니다. OpenAI는 이 구조로 Full Duplex Bench 점수가 GPT-Realtime-2.1 대비 30%포인트 올랐다고 밝혔습니다. 런치 파트너인 어학 앱 Speak의 Connor Zwick은 학습자가 문장 중간에 멈춰 생각할 때 잘못 끼어드는 일이 약 80% 줄어 순서 주고받기 문제가 사실상 풀렸다고 적었습니다.
그 밖에: 음성과 텍스트만 주고받고 이미지·영상은 입력으로 받지 않습니다. 동시 세션 수는 요금 티어에 따라 25개에서 500개까지이며 무료 등급에는 열리지 않았습니다. OpenAI는 전화망 연동도 함께 열어 식당 예약이나 고객 지원 같은 통화형 에이전트를 만들 수 있다고 밝혔고, 초기 도입처로 Yelp와 Speak, Fin, Cognition을 들었습니다.
시사점: 분당 5센트라는 값보다, 대화 앞단과 추론 뒷단을 갈라 각각 골라 붙일 수 있게 된 쪽이 만드는 사람에게 더 큰 변화입니다.
#GPTLive1 #음성AI #OpenAI
출처 4🔥 @reach_vb🔥 @athyuttamre🔥 @daidaijiayu💬 @connorzwick
6. Google Pics가 Workspace에 풀리고 Gemini 앱이 Windows로 나왔다
- Google Pics — Nano Banana로 만든 이미지 생성·편집 도구가 Google AI Pro·Ultra 구독자와 대부분의 Workspace 비즈니스 고객에게 배포되고 있습니다. Docs·Slides에 들어가 있고 Drive는 몇 주 뒤, 단독으로는 pics.new에서 열립니다.
- Gemini 데스크톱 앱이 현지 시각 9월 10일 Windows 10·11에 전 세계 출시됐습니다. Alt + Space를 누르면 작업하던 창 위에 떠서 초안을 다듬고 긴 문서를 요약하며 이미지·영상을 만듭니다.
- AI Studio 안에서 Gemini API 문서를 바로 읽는 첫 프리뷰가 ai.studio/docs로 열렸습니다.
Pics가 내세우는 것은 처음부터 다시 그리지 않는 편집입니다. Google은 객체 하나만 떼어내 고치는 분리 편집, 이미지 안에 박힌 글자를 바꾸거나 번역하는 기능, 프롬프트 하나로 여러 후보를 받는 기능, 같은 결과물을 동료와 함께 고치는 공유를 들었습니다. 공식 블로그 글은 9월 1일 자이고 배포는 몇 주에 걸쳐 진행 중이라, 이번 주 공식 계정들의 게시물은 그 범위가 넓어졌다는 알림에 가깝습니다.
그 밖에: Windows 앱은 gemini.google/desktop에서 받고 만 18세 이상이어야 하며, 일부 기능은 Google AI 구독이 필요합니다. Google은 Gmail·Drive에서 자료를 끌어와 요약하거나 여러 단계 작업을 Gemini Spark에 넘기는 것도 함께 소개했고, 앱 안의 이미지 생성은 Nano Banana, 영상은 Gemini Omni가 맡는다고 밝혔습니다.
시사점: 세 발표 모두 새 모델이 아니라 배치 위치를 바꾼 것입니다. 문서 편집기, 바탕화면, 개발 콘솔처럼 이미 쓰던 자리에서 Gemini를 부르게 되니, 지금 쓰는 이미지 도구나 브라우저 탭을 대체할지 각자 확인해 보시면 됩니다.
#Google #Workspace #Gemini
출처 5🔥 @Google💬 @GoogleAI💬 @GeminiApp🔥 @testingcatalog🔥 @GoogleAIStudio
7. Tencent가 음성 생성·편집 통합 모델 AuK를 오픈소스로 공개했다
- Tencent Hunyuan이 음성 파운데이션 모델 AuK를 MIT 라이선스로 공개했습니다. 1.5B 파라미터 하나가 제로샷 TTS, 지시 기반 생성, 말한 내용 편집, 속삭임 변환, 억양 제거, 음색·감정 전환, 잡음 제거, 화자 분리까지 맡습니다.
- 입력은 자연어 지시와 참조 음성 두 가지뿐입니다. 기술 보고서 기준 학습에 쓰인 유효 음성은 195만 시간, 지시-오디오 쌍은 30억 3천만 건입니다.
- 4단계 추론만 하는 증류판 AuK-Flash도 함께 나왔습니다. 32단계에 CFG를 켜는 본 모델과 견줘 실제 소요 시간이 약 4.5배 짧다고 회사는 밝혔습니다.
지금까지 TTS와 목소리 복제, 잡음 제거, 화자 분리는 각각 다른 모델을 이어 붙여 쓰는 일이었습니다. AuK는 그 작업들을 지시문 한 줄로 받는 한 모델로 합쳤습니다. Seed-TTS-Eval 제로샷 TTS에서 단어 오류율 2.65%, 화자 유사도 0.795를 기록했고 편집·분리 벤치마크도 보고서에 함께 실렸습니다. 다만 "Qwen3-TTS를 앞선다"는 문장은 공식 발표가 아니라 이를 요약한 제3자 게시물에서 나왔습니다. 공식 계정은 비교 대상을 특정하지 않았습니다. 코드와 가중치는 GitHub과 Hugging Face, ModelScope에 올라가 있고 명령줄과 Gradio 데모, ComfyUI에서 바로 돌려볼 수 있습니다.
그 밖에: Nari Labs는 Qwen3-TTS 1.7B를 자사 추론 엔진에 올려 첫 소리까지 50ms, 100만 자당 $5짜리 엔드포인트를 열었습니다. Cartesia보다 5배 빠르고 ElevenLabs보다 10배 싸다는 수치는 회사 주장이며, 당분간 무료로 열어 뒀습니다.
시사점: 음성 도구를 여러 개 붙여 쓰던 파이프라인은 모델 하나로 줄일 수 있게 됐습니다. 값과 개방성이 같은 날 함께 내려갔으니 상용 TTS를 쓰고 있다면 단가부터 다시 계산해 볼 만합니다.
#음성AI #오픈소스 #TTS
출처 3🔥 @TencentHunyuan🔥 @TeksEdge💬 @_doyeob_
8. CADArena가 AI의 CAD 설계 능력을 재기 시작했다
- Normal이 CAD 생성 벤치마크 CADArena를 공개했습니다. 3druck 보도에 따르면 에이전트는 SOLIDWORKS·Onshape·Siemens NX·Autodesk Fusion·build123d 등 엔지니어가 실제로 쓰는 도구의 스크립트 인터페이스로 부품을 만듭니다.
- 같은 보도 기준으로 채점은 결과물의 STEP 형상을 기준 부품과 대조하고 네이티브 구성 파일도 함께 확인해 0~1 사이의 FrontierCAD Score로 냅니다. 형상 쪽 비중이 더 큽니다.
- Normal이 밝힌 결론은 한 줄입니다. 에이전트는 정확한 형상까지는 만들어 내지만, 유지·수정 가능한 피처 트리를 짜는 데서 막힙니다.
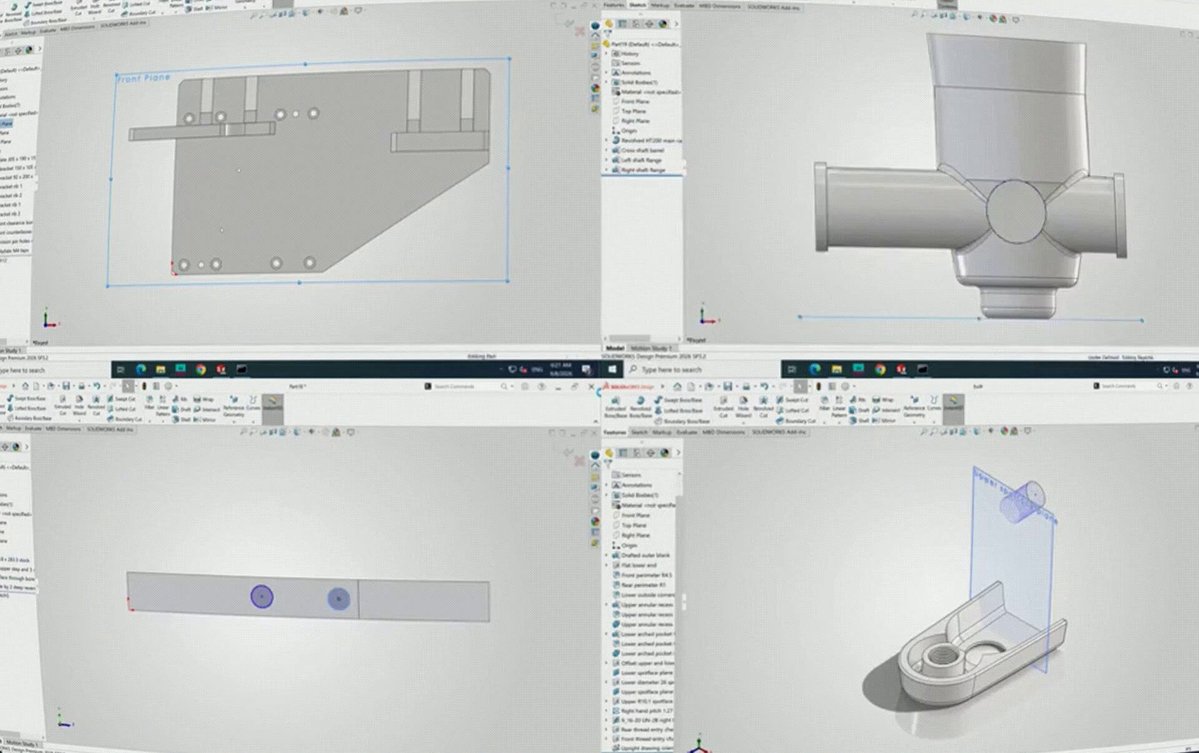
CAD 파일은 완성된 모양이 아니라 그 모양을 만든 순서의 기록입니다. 피처 트리는 스케치와 돌출·회전·필렛이 쌓인 목록이고, 나중에 치수를 하나 바꾸면 그 아래가 전부 다시 계산됩니다. 형상만 맞고 트리가 엉켜 있으면 다음 사람이 두께 1mm를 고치려다 모델을 통째로 다시 그리게 됩니다. CADArena는 결과물이 아니라 그 앞 단계를 채점 대상으로 끌어올려, 겉보기 성공률로는 안 보이던 격차를 수치로 세웠습니다.
그 밖에: 같은 날 Perplexity는 에이전트 RAG의 검색 단계를 재는 벤치마크 Q2D-Web(Query2Doc-Web)과 공개 리더보드를 냈습니다. 웹 문서 1억 9,000만 건과 에이전트가 다시 쓴 질의 69,721개로 구성했고, 사람이 아니라 에이전트가 쓴 질의에서 임베딩 모델이 얼마나 버티는지를 봅니다.
시사점: 두 벤치마크가 같은 지점을 겨냥합니다. 최종 출력이 아니라 사람이 이어받을 수 있는 중간 산출물의 품질입니다. AI 설계 도구를 검토한다면 완성 렌더링 말고 피처 트리를 열어 보십시오.
#CADArena #벤치마크 #에이전트
출처 2🔥 @normalfactoryco🚀 @perplexity_ai
9. Meta의 Muse가 앱스토어 무료 2위에 올랐다
- Alexandr Wang이 앱스토어 무료 앱 순위 스크린샷을 올렸습니다. 9월 11일 새벽(한국시간) 기준 1위 ChatGPT, 2위 Muse from Meta, 3위 Vinted였습니다.
- 하루 전 그가 올린 스크린샷에서 Muse는 3위였습니다. 하루 만에 한 계단 올라갔습니다.
- Meta는 모든 사용자의 Muse 토큰 사용량을 리셋한다고 공지했습니다.
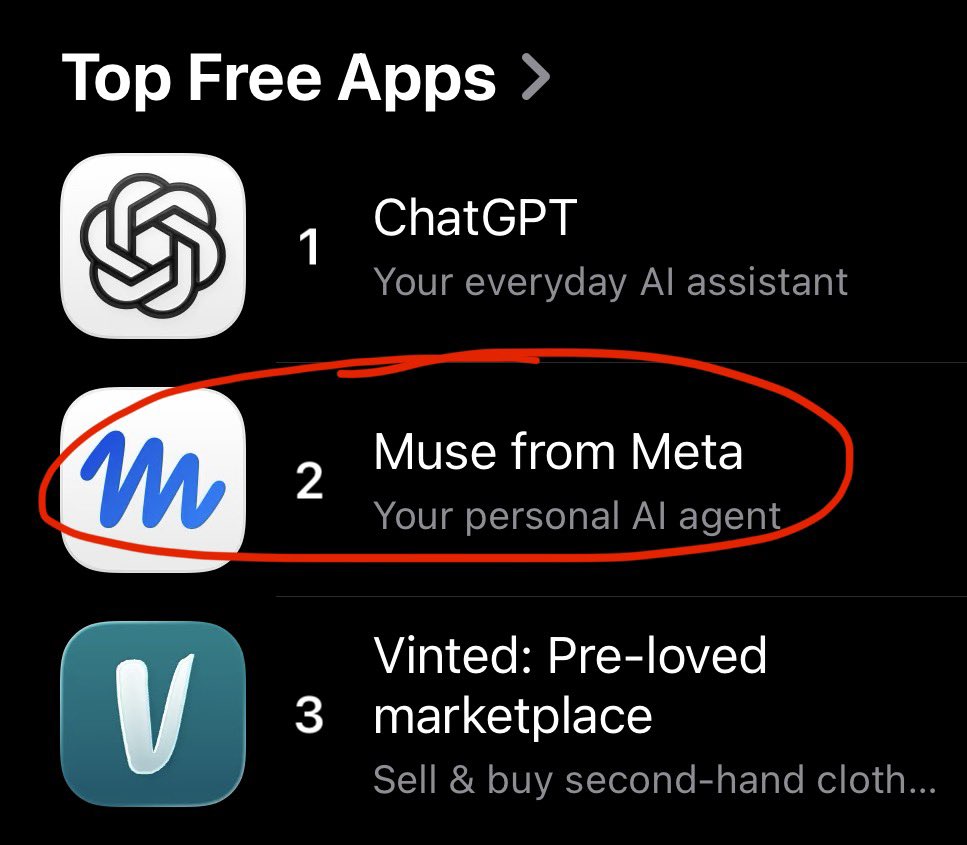
Muse는 Meta가 이번 주에 내놓은 개인 AI 에이전트입니다. Wang은 순위와 함께 사용기도 인용했습니다. 한 이용자가 배우자에게 초록 패딩을 검색해 할인 코드를 찾고 장바구니에 담아 최저가로 결제하는 과정, 레시피를 찾아 Whole Foods 장바구니를 채우는 과정을 보여 줬다는 글이었습니다. Wang은 여기에 AI가 쓸모 있다는 걸 가족에게 납득시키는 용도라고 덧붙였습니다.
토큰 사용량 리셋은 표시가 0으로 돌아간 것을 보고 공지를 못 봤다고 물은 이용자에게 Wang이 직접 확인해 줬습니다. 다만 앱스토어 무료 2위는 내려받은 사람 수가 만드는 순위이고, 얼마나 계속 쓰는지는 아직 확인할 수 없습니다.
그 밖에: TestingCatalog은 Meta가 Muse용 Shared Agents를 개발 중이며 9월 23~24일 Meta Connect에서 공개할 가능성이 크다고 전했습니다. OpenAI DevDay는 엿새 뒤인 29일인데, 거기서 Managed Agents가 나올 것으로 봤습니다. 기업용 에이전트를 만들 인력으로 Meta가 보안 AI 협업 서비스 Stilla와 그 팀을 최근 인수했다는 설명도 함께 붙였습니다.
시사점: 두 회사가 같은 달에 중소사업자용 에이전트를 겨냥한다면, 비교 기준은 모델 점수가 아니라 맡긴 일을 끝내는 비율이 됩니다.
#Meta #Muse #AI에이전트
출처 5💬 @alexandr_wang💬 @alexandr_wang💬 @alexandr_wang💬 @alexandr_wang🔥 @testingcatalog
10. Kepler Computing이 7년 스텔스를 끝내고 EUV 없이 메모리 밀도를 올리는 칩 구조를 공개했다
- 공동창업자 Debo Olaosebikan이 7년 넘는 스텔스를 끝내고 Kepler Computing을 공개했습니다. 투자사 Intel Capital도 같은 시간대에 같은 내용을 확인해 줬습니다.
- 회사가 내세운 것은 EUV 리소그래피에 의존하지 않고 HBM·SRAM 밀도를 높이는 메모리 칩 아키텍처입니다. 3D 적층과 소재 기술로 이미 있는 팹에서 만든다고 설명합니다.
- 회사 발표 기준 누적 조달 4억 6,800만 달러, 자체 300mm 팹 보유, 올해 샘플·내년 양산이 목표입니다.
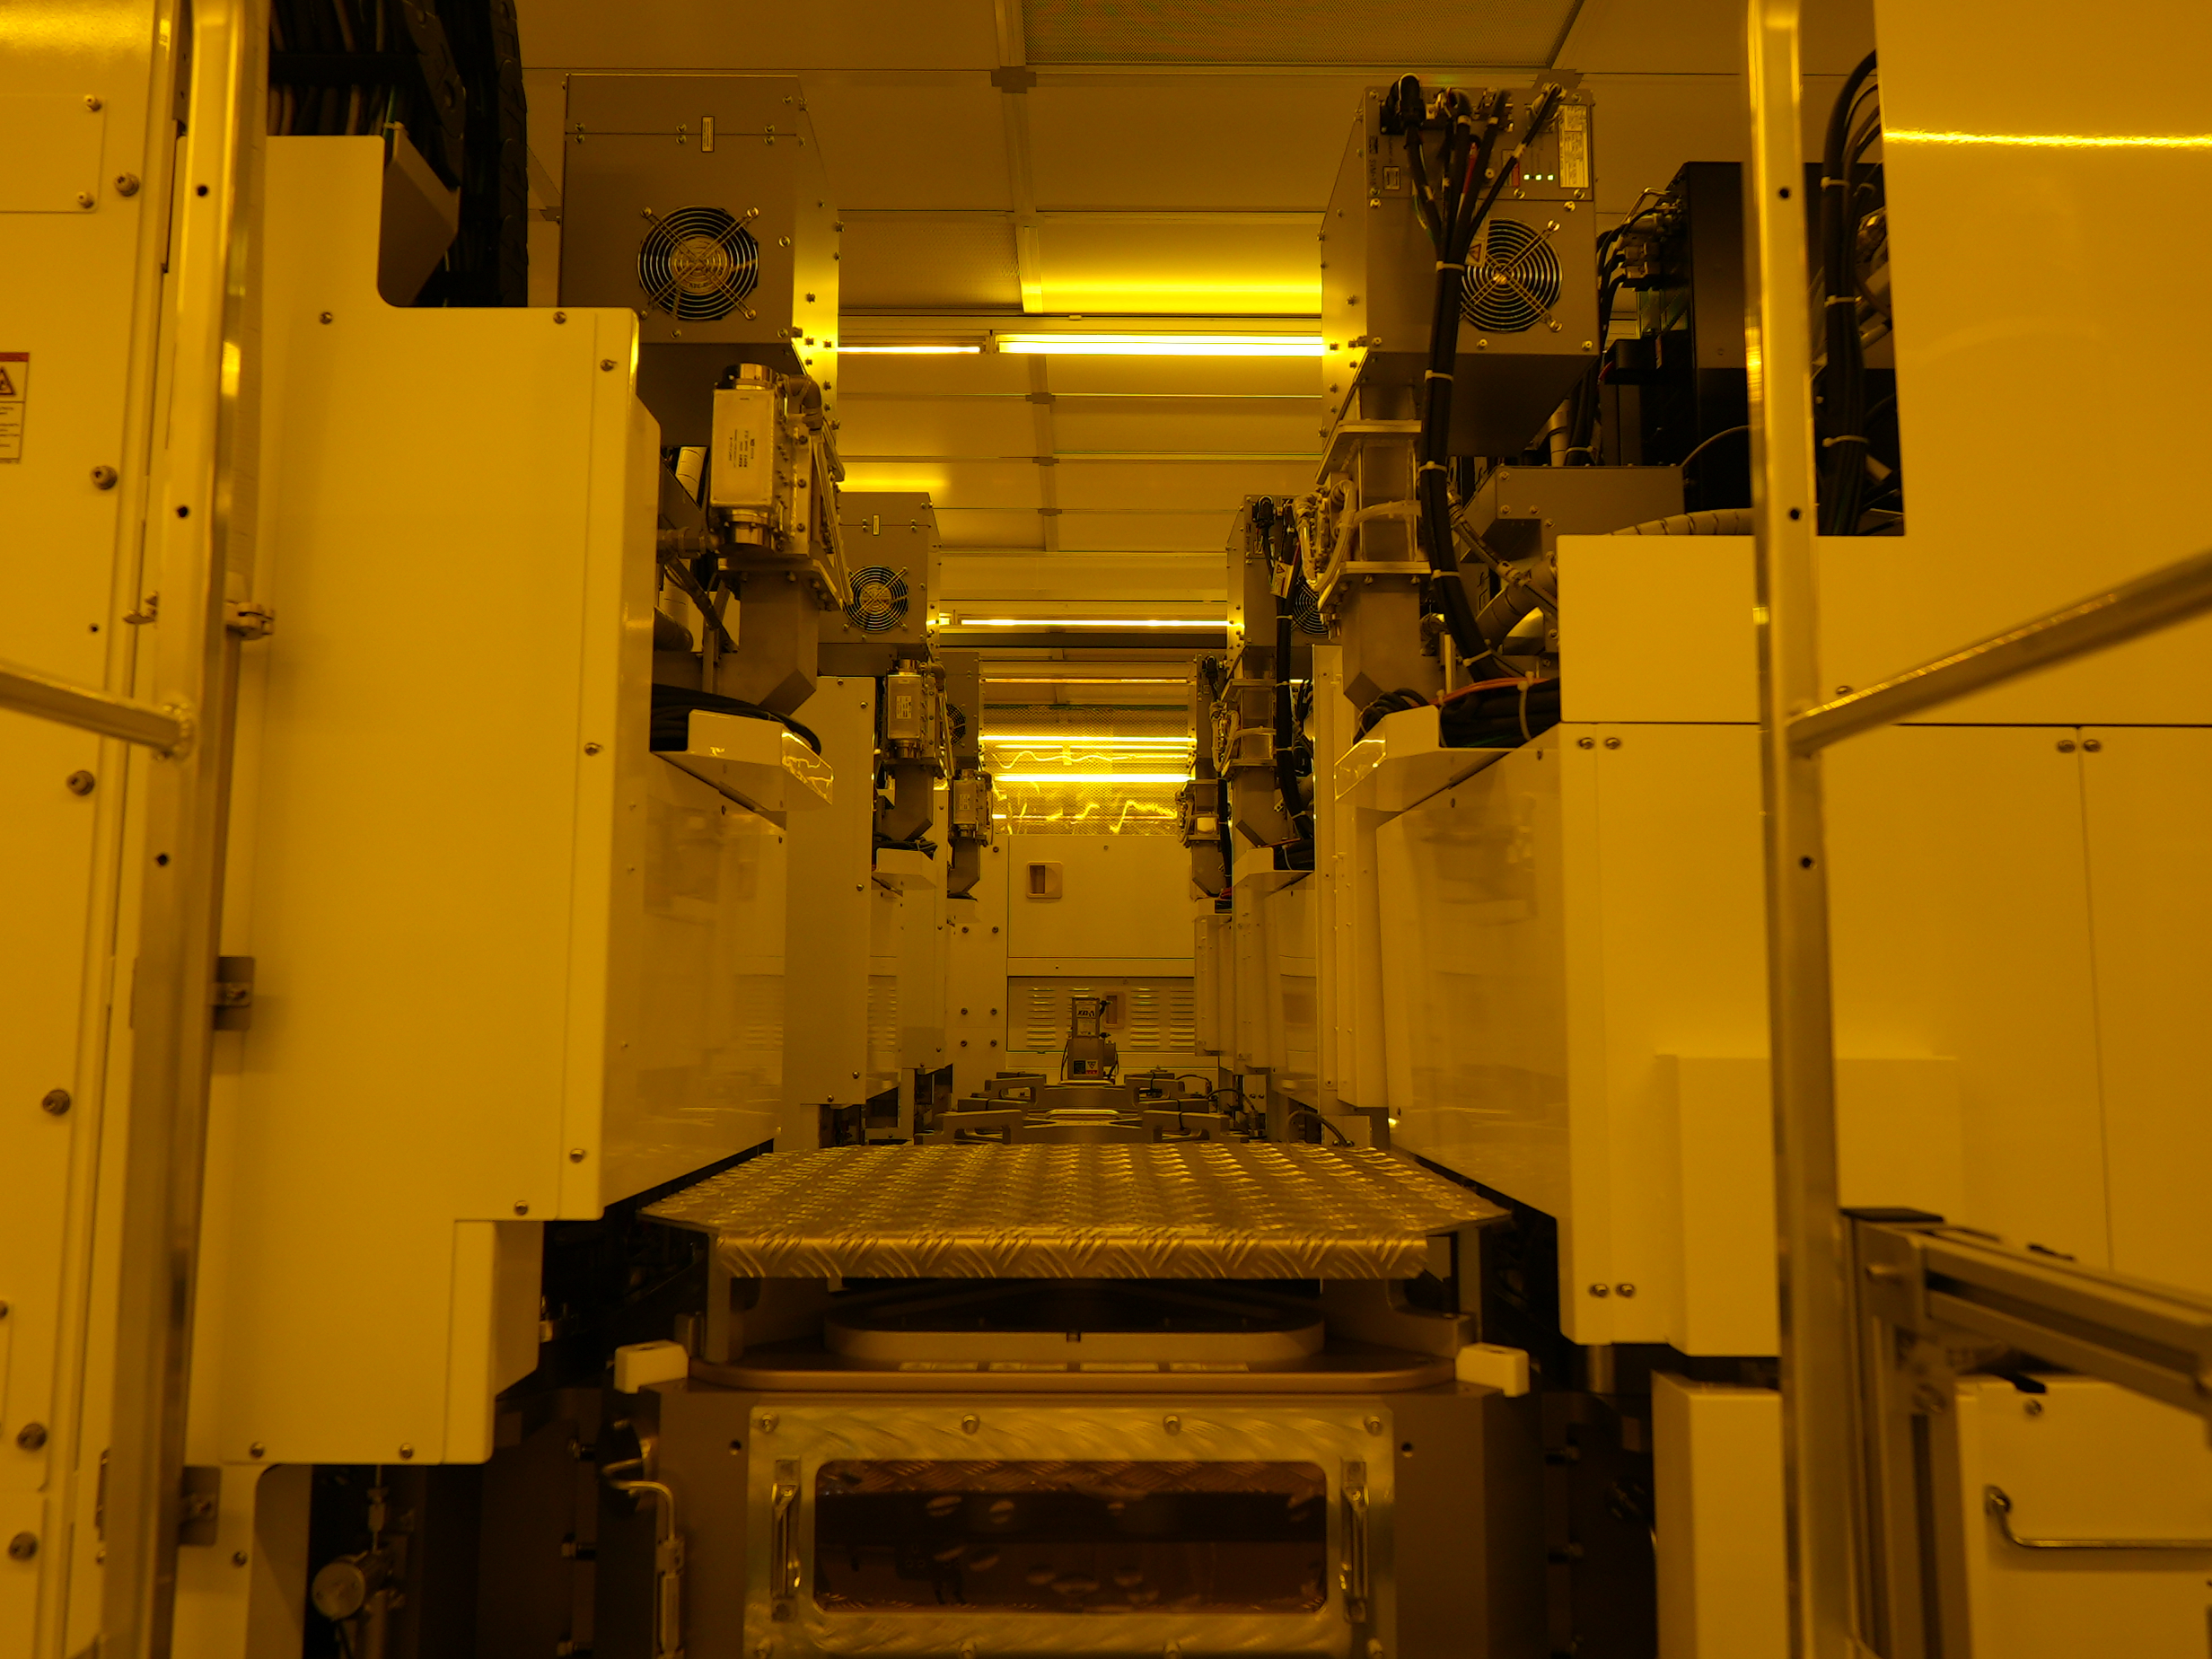
Olaosebikan은 연산이 모자란 이유를 팹 경제학에서 찾습니다. 트랜지스터를 줄이는 지금 방식은 200억~400억 달러짜리 공장과 수년의 건설 기간을 요구하고, 그 위험 때문에 업계 설비 투자는 AI 수요보다 훨씬 느리게 늘어난다는 설명입니다. Kepler는 그 경로를 우회해 SRAM에 근접한 와트당 대역폭을 내면서 용량은 HBM 대비 최대 10배까지 올리겠다고 밝혔습니다. 창업팀은 업계 초기 3D 칩 적층 기술을 공동으로 이끌었고 DRAM 7세대를 양산까지 끌고 간 이력을 근거로 내세웁니다. 다만 지금 공개된 것은 구조와 목표이지 출하된 제품이 아닙니다.
그 밖에: 회사 홈페이지는 최대 2억 4,500만 달러 규모의 미국 정부 지원 대상으로 선정됐다고 적었고, WIRED가 같은 날 상세 기사를 냈습니다.
시사점: AI 가속기의 병목이 연산에서 메모리 대역폭·용량으로 옮겨간 흐름을 정면으로 겨눈 시도입니다. 확인할 지점은 내년 양산 일정과 실제 샘플 성능 두 가지입니다.
#반도체 #메모리 #자본
출처 2💬 @dolaoseb🚀 @intelcapital
11. 🆕 그 밖의 신기능·신제품
- React 19.3 정식판 — View Transitions와 Fragment Refs가 안정화됐고, browser()·Trusted Types 지원과 Server Components의 Context가 들어갔습니다.
- Unity 공식 Codex 플러그인 — Unity 엔지니어가 쓴 스킬로 에디터 실시간 제어, 셰이더·렌더링, 피직스·AI 내비게이션을 다룹니다.
- tldraw flash — 도형을 그린 뒤 녹화를 누르고 드래그로 직접 연기하면 그 움직임이 애니메이션이 됩니다.
React 19.3의 <ViewTransition>은 브라우저 View Transition API를 감싼 컴포넌트로, 요소가 나타나고 사라지고 자리를 옮길 때의 애니메이션을 React가 고릅니다. Unity는 어제 나온 Claude Code용에 이어 Codex용이 올라왔고, 공식 블로그 문서는 아직 Claude Code판뿐입니다.
그 밖에: Krea는 스스로 갱신하는 메모리를 붙인 창작 전용 Krea Agents를, PlanetScale은 Vitess 팀이 만든 Postgres 샤딩 계층 Neki를 내놨습니다. Claude Code 2.1.267은 CLI 변경 53건과 모든 제공자에 effort 상한을 거는 maxEffortLevel을 넣었고, Google Maps Platform은 지도·경로 코드 에이전트 스킬을 냈습니다.
시사점: React 19.3은 새 기능이 전부 선택형이라 올려도 기존 코드가 깨지지 않습니다. 팀으로 Claude Code를 쓴다면 maxEffortLevel을 보세요.
#React #Unity #ClaudeCode
출처 7🔥 @reactjs🔥 @reach_vb🔥 @tldraw💬 @krea_ai🔥 @PlanetScale🔥 @ClaudeCodeLog🔥 @GMapsPlatform
오늘의 감정·온도
오늘 붙은 라벨은 화제를 뜻하는 🔥가 가장 많았습니다. 빠르게 퍼졌다는 뜻의 🚀는 Valerio Capraro의 의혹 제기와 Perplexity·Intel Capital의 발표에, 댓글이 몰렸다는 뜻의 💬는 Alexandr Wang의 앱 순위 게시물에 가장 많이 붙었습니다.
오늘의 실무 팁 — 쉽게 풀어 쓴 사용법 6가지
1. DeepSeek V4.1 Flash로 갈아타기 전에 지금 쓰는 도구 안에서 한 번 재 보세요
90.6이라는 점수는 DeepSeek이 자기 하네스의 최소 구성에서 잰 값이고, 같은 표에서 Claude Code는 88.0으로 내려갑니다. 값이 20분의 1이어도 붙이는 도구가 다르면 결과가 달라집니다. — (@zainhas)
2. DeepSeek API로 큰 배치를 돌린다면 시각을 골라 보세요
캐시가 맞은 입력은 100만 토큰당 $0.006까지 내려가고, UTC 기준 비혼잡 시간대에는 표시가의 절반이 붙습니다. 같은 작업이라도 돌리는 시각만 바꾸면 값이 달라집니다. — (@Polymarket)
3. 미공개 연구를 챗봇에 넣어 왔다면 학습 사용 설정과 그 적용 시점을 확인하세요
학습 사용을 꺼도 그 설정은 앞으로 만들 대화에만 적용됩니다. 언제 껐는지와 그 이전 대화가 어떻게 됐는지는 별개 문제입니다. — (@ValerioCapraro)
4. SWE-2를 검토한다면 Terminal-Bench 2.1 말고 4의 점수도 함께 보세요
같은 자료에서 2.1은 92.8%인데 더 최근 평가인 4는 27.3%입니다. 한 세대만 바뀌어도 순위가 뒤집히니 자기 코드베이스에서 재 보는 편이 안전합니다. — (@cognition)
5. 음성 에이전트를 만든다면 앞단과 뒷단을 나눠 설계하세요
GPT-Live-1은 듣고 말하는 앞단만 맡고 추론과 도구 실행은 뒷단으로 넘깁니다. 뒷단을 직접 운영하는 서버에 붙일 수 있어 모델을 나중에 갈아 끼울 여지가 생깁니다. — (@athyuttamre)
6. 팀으로 Claude Code를 쓴다면 maxEffortLevel을 보세요
2.1.267이 모든 제공자에 effort 상한을 거는 설정을 넣었습니다. 사람마다 다른 설정으로 돌아가던 상태를 한 줄로 맞출 수 있습니다. — (@ClaudeCodeLog)
📦 확인 방식 — 모델 구조와 요금은 DeepSeek 기술 보고서와 API 안내에서, 벤치마크 점수는 DeepSeek·Cognition이 함께 공개한 표와 그래프에서 옮겼습니다. 회사가 스스로 낸 값과 외부 측정값은 본문에서 구분해 적었으며, 외부 독립 검증 전입니다.
🏷 라벨 가이드 — 🔥 화제 · 💬 토론 많음 · 🚀 빠르게 확산 · 🔖 저장 많음 · 🔁 리트윗 많음