오늘의 AI 브리핑 ·
Anthropic 오용보고서 154쪽 공개
5분 브리핑
약 3분 · 11개 흐름핵심만 먼저 읽고, 궁금한 소식은 본문으로 이어 보세요.
전체 분석 17분으로 바로 가기 ↓- Anthropic이 154쪽 보고서에서 이란의 미 해군 표적 작업과 Alibaba·DeepSeek의 Claude 증류를 함께 공개했다
이란 연계 행위자가 Claude로 역내 미 해군을 겨냥한 표적 편람을 만들었습니다. 공개된 군 사진 설명에서 긁어낸 미군 인적 명단, 함정·항공기 트랜스폰더 식별자, 상용 위성영상 조회 스크립트, 해상 VSAT 단말의 알려진 취약점 목록이 들어 있었습니다.
- 필즈상 수상자 25명이 'AI와 수학의 심각한 어긋남' 공동 선언에 서명했다
Terence Tao가 9월 11일 자기 블로그에 공동 선언문 전문을 올렸습니다. 최초 서명자는 25명이고 전원 필즈상 수상자입니다.
- OpenAI가 Codex 하네스를 그대로 파는 Agents API를 퍼블릭 베타로 열었다
OpenAI가 9월 11일 Agents API를 퍼블릭 베타로 열었습니다. Codex를 돌리던 하네스를 그대로 API로 내놓은 것입니다.
- OpenAI가 월 200달러 Pro 신규 가입을 멈추고 GPT-5.3-Codex-Spark를 다음 주에 내린다
OpenAI가 월 200달러 ChatGPT Pro의 신규 구독을 일시 중단했습니다. Plus·Go·API·기업 요금제는 그대로 판매되고, 기존 Pro 가입자는 영향을 받지 않습니다.
- GPT Image 2.5 Flare·Sunburst가 Artificial Analysis Image Arena 1·2위에 나란히 올랐다
Artificial Analysis의 블라인드 선호 투표에서 이달 초 공개된 GPT Image 2.5 Flare가 Elo 1187로 텍스트로 이미지 만들기 1위, Sunburst가 1180으로 2위를 차지했습니다.
- Cursor가 늘 켜진 코디네이터에게 작업을 맡기는 Projects를 베타로 열었다
9월 10일 공개됐고 모든 사용자에게 순차 배포 중입니다. 작업마다 새 채팅을 만드는 대신, 몇 달치 맥락을 이어 가는 단일 스레드에서 코디네이터 에이전트와 함께 일합니다.
- 중국 LLM 라우터가 판 6TB 로그에 SSH 키와 GitLab 토큰이 들어 있었다
보안 연구자 Chaofan Shou가 중국 상위 LLM 라우터 한 곳에서 'Fable 데이터셋'이라 부르는 6TB 로그를 사들였습니다. 라우터를 오간 요청이 그대로 담겨 있었습니다.
- ApprenticeBench에서 Fable 5.1이 72%로 사람 최고 기록 51%를 처음 넘었다
NeoCognition이 ApprenticeBench를 공개했습니다. California 건설사 1년치를 시뮬레이션해 두고, 에이전트가 Odoo ERP 화면에서 미지급금(AP) 담당자로 청구서 100건을 처리합니다.
- Vals AI가 모델이 자기 후속작을 만드는 정도를 재는 RSI Index를 공개했다
Vals AI가 marimo·CoreWeave와 함께 RSI Index를 내놨습니다. 모델이 다음 모델을 만드는 연구를 스스로 해내는지를 압축·LM 학습·Parameter Golf·하네스 개선·후학습 다섯 과제로 잽니다.
- OpenAI가 최전선 AI 개발 속도를 늦추는 안을 사내 회의에서 꺼냈다
Sam Altman이 이번 주 전사 회의에서 최전선 AI 개발 속도를 늦출 수 있다고 직원들에게 말했다고 Bloomberg가 단독 보도했습니다. 여러 AI 연구소와 보조를 맞추는 방식을 함께 언급했습니다.
- 🆕 그 밖의 신기능·신제품
ElevenLabs Music v2.5 — 편곡과 악기 질감을 손봤고 무료 플랜도 표기만 하면 상업 이용됩니다. Claude Code의 claude plugin eval — 켠 채와 끈 채로 같은 케이스를 돌려 차이를 냅니다.
주요 키워드 TOP 5: Anthropic 오용 보고서 · 필즈상 공동 선언 · Agents API · ApprenticeBench · LLM 라우터 유출
메인 이벤트: Anthropic이 154쪽 보고서에서 이란·예멘 조직의 무기 작업과 Alibaba·DeepSeek의 Claude 증류를 함께 공개했습니다.
오늘의 중심은 Anthropic이 낸 154쪽짜리 오용 보고서입니다. 이란 연계 행위자가 Claude로 미 해군을 겨냥한 표적 편람을 만들고, 예멘 북부 조직이 Claude Code로 유도 로켓 소프트웨어를 짠 정황이 실렸습니다. 회사가 이런 사례를 찾아낸 방법은 이용 내역을 들여다보고 선을 넘었는지 판단하는 절차였고, 같은 절차가 Alibaba와 DeepSeek이 고객 요청을 Claude로 돌려 자사 모델을 끌어올린 기록까지 함께 드러냈습니다. 그래서 한 건의 보고서가 무기·감시 쪽에서는 규제 논의를, 증류 쪽에서는 계약과 차단 문제를 동시에 열었고, 이용자 쪽에서는 회사가 어디까지 들여다보느냐는 반응도 같이 나왔습니다.
1. Anthropic이 154쪽 보고서에서 이란의 미 해군 표적 작업과 Alibaba·DeepSeek의 Claude 증류를 함께 공개했다
- 이란 연계 행위자가 Claude로 역내 미 해군을 겨냥한 표적 편람을 만들었습니다. 공개된 군 사진 설명에서 긁어낸 미군 인적 명단, 함정·항공기 트랜스폰더 식별자, 상용 위성영상 조회 스크립트, 해상 VSAT 단말의 알려진 취약점 목록이 들어 있었습니다.
- 예멘 북부에 거점을 둔 조직은 사람 엔지니어 자리에 Claude Code를 넣어 유도 로켓의 유도·항법·제어 소프트웨어를 짰습니다. 실사격 시험은 실패했고, 이들은 몇 시간 만에 돌아와 실패 원인을 물었습니다.
- 증류 규모는 회사마다 다릅니다. Alibaba는 5~7월에 1억 5,100만 회 이상, DeepSeek은 7월 중 14일간 1,210만 회 이상, Moonshot은 열흘간 고객 요청 약 30만 건을 Claude로 넘겼습니다.
보고서가 다루는 기간은 2025년 12월부터 2026년 8월까지이고, 사이버·영향력 공작·감시·사기·생물학·재래식 무기·증류 일곱 갈래로 나뉩니다. 예멘 조직이 굴린 프로그램은 하나가 아니었습니다. 실사격한 유도 로켓 외에 사거리 목표를 2,000km 이상으로 내건 다단 탄도미사일, 극초음속 활공체 변형이 포함된 'R2000' 계열이 함께 개발되고 있었습니다. 이란 사례도 무기 쪽에만 걸려 있지 않습니다. 국가 연계 기관 세 곳이 Claude로 선전 조직을 꾸렸고, 산출물 가운데는 최고지도자 장례와 승계를 다룬 기획안도 있었습니다.
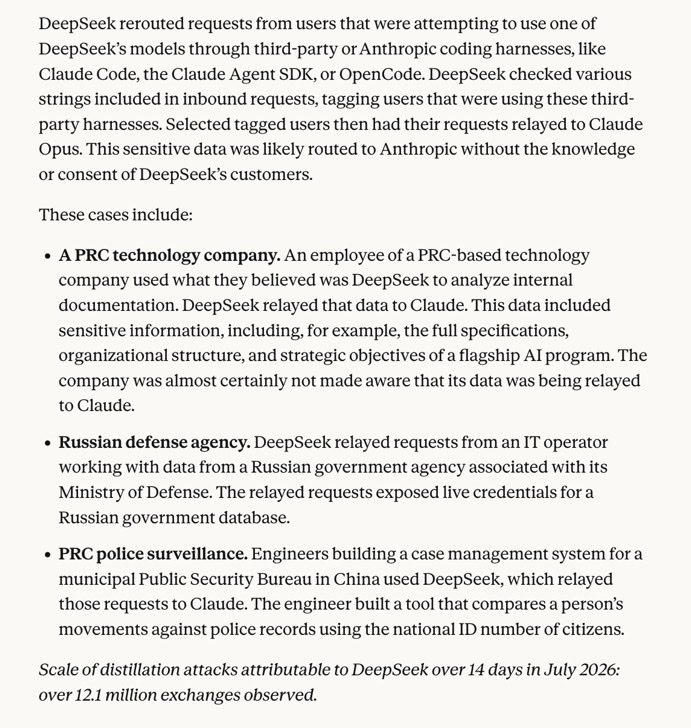
Alibaba 건은 하루 최대 300만 회에 육박했고 3,500개가 넘는 가짜 계정에서 나왔습니다. 확보한 기록은 Qwen 3.5·3.6·3.7의 추론 능력을 끌어올리는 데 쓰였다고 보고서는 적었습니다. Moonshot은 계정 5,380개를 동원해 Kimi를 쓰는 줄 안 고객의 요청을 Claude로 돌렸습니다. DeepSeek이 넘긴 요청 중에는 러시아 국방부 연계 기관의 데이터베이스 접속 정보가 그대로 드러난 건, 중국 지방 공안국이 시민의 신분증 번호로 개인의 이동 기록을 대조하는 도구를 만든 건이 있었습니다.
이용자 쪽에서는 반가운 공개만은 아니라는 반응도 나왔습니다. 사례를 찾아낸 방법 자체가 이용 내역을 들여다보고 선을 넘었는지 회사가 판단하는 절차라서입니다.
그 밖에: 중국 기반 행위자는 인민해방군 해군용 어뢰 요격 사격통제 규격서와 조달 제안서를 Claude로 쓰면서, Claude에게 적대적 심사위원 역할을 시켜 초안을 다듬었습니다. 생물학 무기 개발을 도울 수 있는 사례 5건도 실렸는데, 회사는 이런 증거를 공개한 기업이 자신들이 아는 한 없었다고 밝혔습니다.
시사점: 무기·감시 항목은 국가 단위 규제 논의로, 증류 항목은 중국 랩들이 해외 API 접근을 유지할 수 있느냐는 계약·차단 문제로 갈라집니다. 유통되는 요약 중 상당수가 예멘 조직을 후티로 적었지만, 보고서 본문에 그 표현은 없습니다.
#Anthropic #위협인텔리전스 #모델증류
출처 9🔖 @ComfortablySmug🔥 @WatcherGuru🔖 @ns123abc🚀 @rynorhn🚀 @riba2534🔥 @Polymarket🔥 @pruthveeee💬 @sleepy0x13🔥 @teortaxesTex
2. 필즈상 수상자 25명이 'AI와 수학의 심각한 어긋남' 공동 선언에 서명했다
- Terence Tao가 9월 11일 자기 블로그에 공동 선언문 전문을 올렸습니다. 최초 서명자는 25명이고 전원 필즈상 수상자입니다.
- 선언문은 AI 기업이 수학 문제 풀이를 능력 벤치마크로 삼는 흐름이 수학이라는 학문과 수학자 공동체 양쪽에 해롭다고 적었습니다. 목표가 심각하게 어긋나 있다는 것이 제목이자 결론입니다.
- 지목한 대목은 발표 속도입니다. 서둘러 공개하느라 제대로 된 논문 작성도, 새 방법의 분리도, 선행 연구 인용도 빠진다는 것입니다.
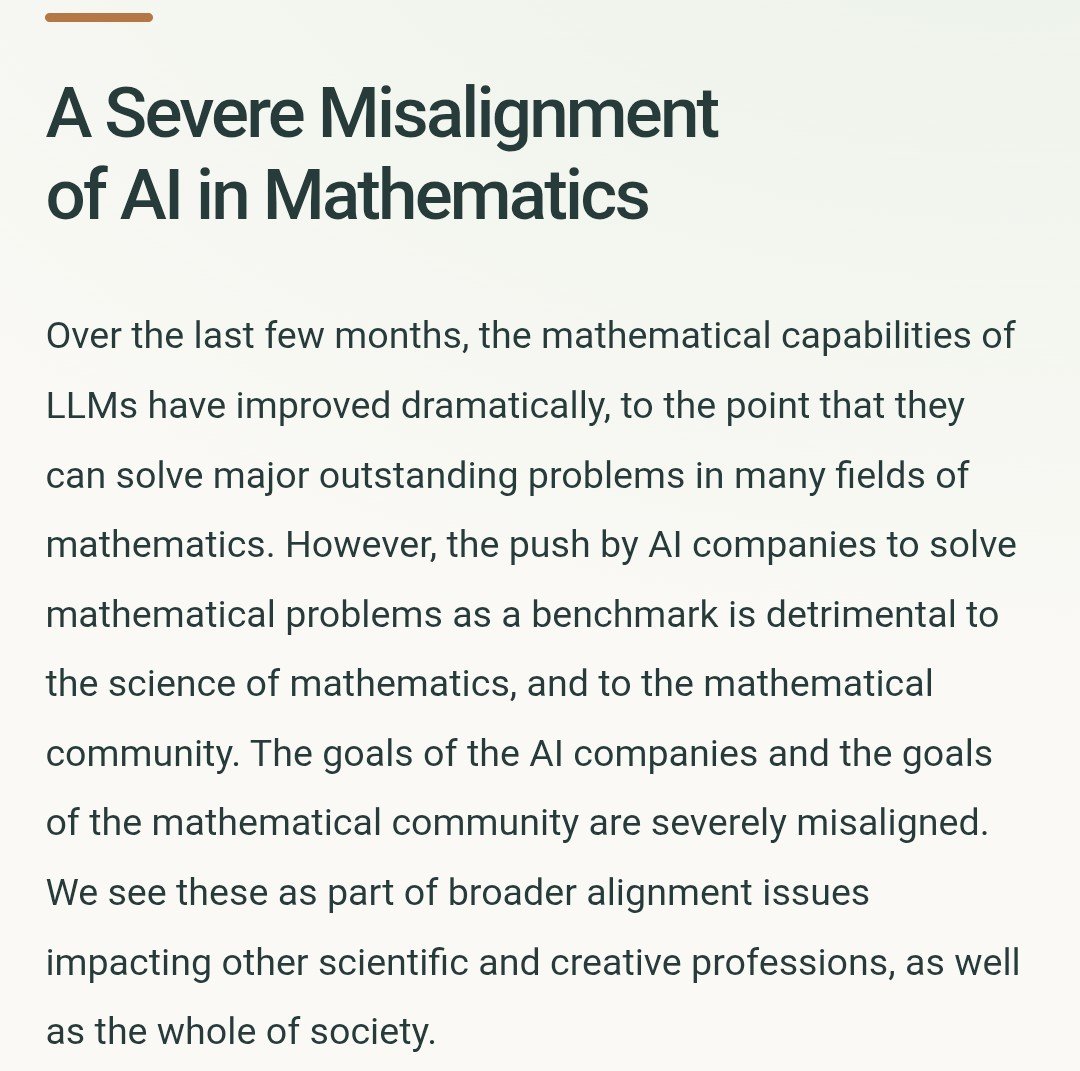
서명자는 1978년 수상자 Pierre Deligne부터 2026년 수상자 Yu Deng까지 걸쳐 있고, Peter Scholze와 Maryna Viazovska, James Maynard, Cédric Villani가 들어 있습니다. Tao는 이 문서가 지난 한 주간의 논의에서 나왔으며, Leiden 선언처럼 추가 서명을 받되 Leiden 때와 달리 폭넓은 자문 절차를 거치지는 못했다고 밝혔습니다. 사안이 급해 먼저 낸다는 단서입니다.
선언문이 요구한 것은 규제가 아니라 순서입니다. 문제를 푸는 일은 개념적 이해라는 본래 목표의 대리 지표인데, 참과 거짓 판정을 빠르게 찍어 내는 일이 그 목표를 대신하면 새 아이디어가 자랄 땅이 사라진다고 적었습니다. 서둘러 낸 발표에 선행 연구 인용이 빠지는 문제를 선언문은 심각한 저작자 표시와 표절 문제라고 불렀습니다. 또 AI가 내놓은 아이디어를 받아 다듬고 수학의 정전에 편입시킬 사람이 없으면 수학자들 사이의 전달 사슬 자체가 끊긴다고 봤습니다.
그 밖에: 해커뉴스 게시물은 317점에 댓글 404개가 달렸고, 초기에 퍼진 게시물 중에는 서명자를 24명으로 적은 것도 있었습니다. 같은 주에는 OpenAI가 새 내부 모델로 리만 가설과 P 대 NP를 시도 중이라는 Andrew Curran의 전언, 100만 달러짜리 문제에 2,250만 달러어치 연산을 썼다는 계산을 두고 실제 지출과 정가는 다른 이야기라고 짚은 Austen Allred의 글이 함께 돌았습니다. 추가 서명은 ORCID 로그인이나 학교 메일 확인으로 받습니다.
시사점: 어제 연구자 한 명의 문제 제기였던 사안이 하루 만에 필즈상 수상자 25명의 공동 문서가 됐습니다. 논점이 성능이 아니라 발표 방식과 인용이므로, 결과 발표 경쟁이 이어지는 한 같은 마찰은 수학 밖 분야에서도 나올 수 있습니다.
#필즈상 #연구윤리 #OpenAI
출처 5💬 @AndrewCurran_🔥 @scaling01💬 @kimmonismus🔥 @AndrewCurran_🔥 @Austen
3. OpenAI가 Codex 하네스를 그대로 파는 Agents API를 퍼블릭 베타로 열었다
- OpenAI가 9월 11일 Agents API를 퍼블릭 베타로 열었습니다. Codex를 돌리던 하네스를 그대로 API로 내놓은 것입니다.
- 공식 문서는 OpenAI가 세션·오케스트레이션·컨텍스트 압축·복구를 관리한다고 적었습니다. 코드 실행, 외부 데이터 연결, 서브에이전트 위임, 세션 재개도 관리형 하네스에 들어갑니다.
- 과금은 모델 API 요금과 툴·컨테이너 표준 요금뿐입니다. 해커뉴스에서 337점·댓글 178개를 받았습니다.
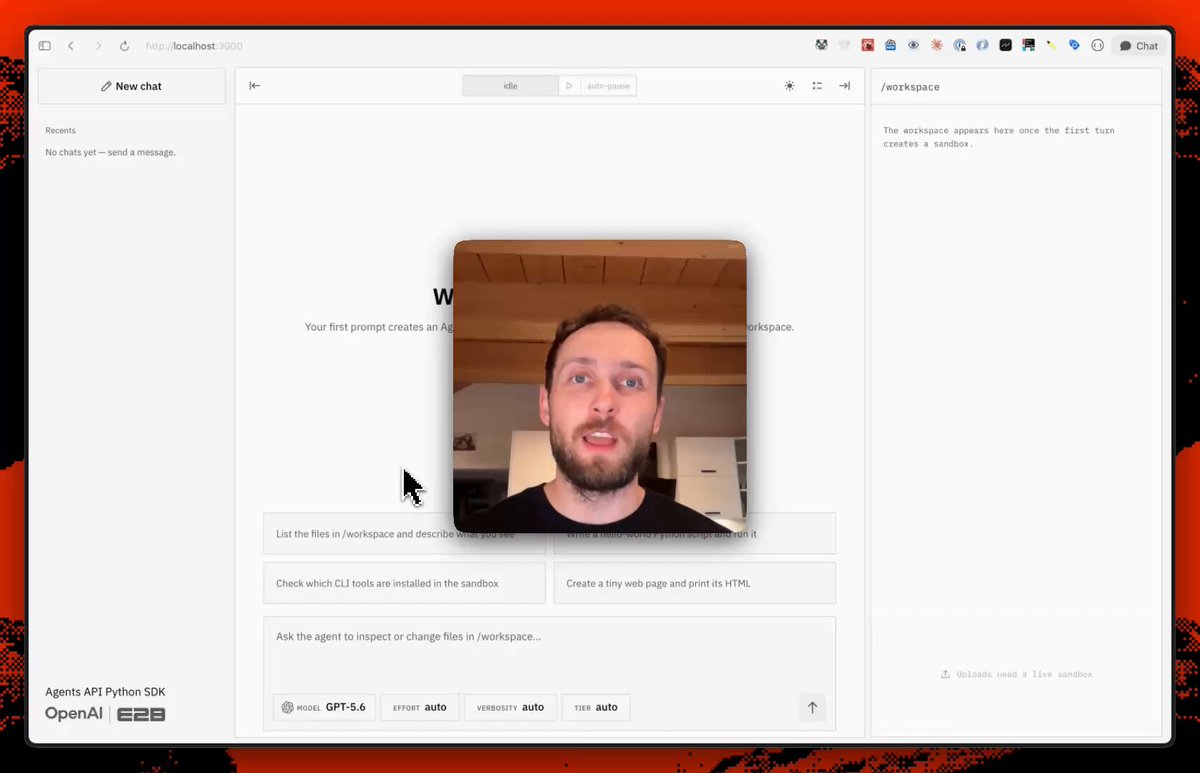
하네스는 모델 바깥에서 에이전트를 굴리는 층을 말합니다. 에이전트를 오래 돌려 본 팀은 이 층을 매번 다시 짰습니다. 대화가 길어지면 지난 작업을 요약해 컨텍스트를 줄이고, 툴 호출을 라우팅하고, 실패한 단계를 되돌리고, 일감을 서브에이전트로 쪼개는 배관입니다. 표준이 없어 직접 만들거나 사람을 뽑아야 했다고 Prasenjit Sarkar는 정리했습니다. Agents API는 그 층을 관리형으로 가져갑니다. 샌드박스는 OpenAI가 띄워 주는 쪽과 직접 붙이는 쪽 둘 다 됩니다. 발표 당일 E2B는 채팅마다 전용 머신이 뜨고 턴 사이에 자동으로 멈췄다가 같은 출발점에서 갈라지는 워크벤치를 공개했고, Cloudflare Containers에서 Codex를 돌려 4분 만에 배포까지 가는 데모도 나왔습니다.
반응은 만드는 쪽에서 먼저 나왔습니다. Greg Isenberg는 에이전트를 며칠씩 켜 두고, 하던 일을 기억하고, 툴을 쓰고, 실패한 단계에서 복구하는 일이 전부 빌려 쓰는 항목이 됐다며 에이전트판 AWS 순간이라고 적었습니다. 그의 글은 북마크 1,284개로 좋아요 872개보다 많았고, 발표를 인용한 Nick Vasilescu의 글도 조회 25만에 북마크 1,092개가 붙었습니다. 에이전트 플랫폼 자체를 팔던 회사엔 나쁜 소식이고 한 업종의 업무를 아는 쪽엔 좋은 소식이라는 게 Isenberg의 결론입니다.
그 밖에: 공식 문서 예제는 gpt-6-astra를 쓰고 서브에이전트를 동시 4개까지 잡습니다. 데이터 상주는 미국만 지원하고 Zero Data Retention은 아직 안 됩니다.
시사점: 하네스가 제품이 됐습니다. 에이전트 인프라를 직접 짜서 파는 회사라면 그 층이 토큰 값에 포함된 셈이고, 남는 차별점은 붙이는 도구와 데이터, 그리고 완료 여부를 재는 평가 쪽으로 옮겨갑니다.
#AgentsAPI #OpenAI #에이전트
출처 5💬 @mlejva💬 @Jilles🔖 @gregisenberg🔖 @nickvasiles🔥 @stretchcloud
4. OpenAI가 월 200달러 Pro 신규 가입을 멈추고 GPT-5.3-Codex-Spark를 다음 주에 내린다
- OpenAI가 월 200달러 ChatGPT Pro의 신규 구독을 일시 중단했습니다. Plus·Go·API·기업 요금제는 그대로 판매되고, 기존 Pro 가입자는 영향을 받지 않습니다.
- 이유는 GPT-6 Astra 수요입니다. @mattshumer_가 인용한 Tibo Sottiaux의 글에 따르면, Pro 사용자가 시스템에 가장 큰 부담을 주기 때문에 넓은 접근을 유지할 수 있는 가장 작은 조치로 이 방법을 골랐다고 합니다.
- 같은 사람이 몇 시간 뒤 GPT-5.3-Codex-Spark를 다음 주에 퇴역시킨다고 예고했습니다. 사용량이 줄었고 더 나은 모델이 나와 있다는 이유입니다.
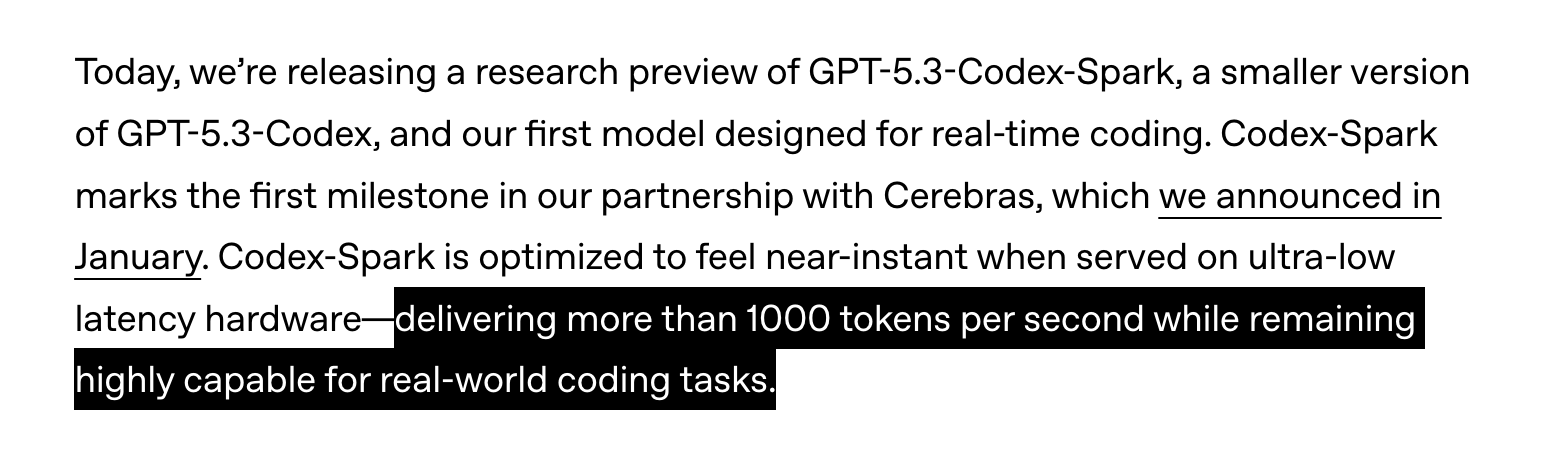
Tibo Sottiaux는 OpenAI에서 Codex와 ChatGPT를 맡고 있습니다. Codex-Spark는 2026년 2월 12일 리서치 프리뷰로 나온 실시간 코딩 전용 모델이고, Cerebras의 웨이퍼 스케일 칩에서 초당 1,000토큰 이상을 내는 속도가 특징이었으며 쓸 수 있는 사람은 Pro 구독자였습니다. 회사가 밝힌 이유는 두 건이 서로 다릅니다. Pro 중단은 수요 부담이고 Spark 퇴역은 사용량 감소입니다. 다만 한정된 계산 자원을 어디에 둘지 정하는 결정이라는 점은 같고, 그 조정이 같은 날 몇 시간 간격으로 두 번 공개됐습니다.
그 밖에: Sottiaux는 기존 사용자에게 좋은 경험을 제공한다는 말에 "가끔의 리셋"이 포함된다고도 적었습니다. @kimmonismus는 퇴역 공지의 "미래를 위한 자리를 마련할 때"라는 문장을 후속 모델 예고로 읽고, 계획 한도를 다 쓴 뒤에도 여유 속도를 주는 GPT-6 계열 Spark를 바란다고 적었습니다. @bridgebench는 200달러 Pro 계정 네 개가 화요일이면 전부 한도에 걸린다며, 감당할 만한 가격의 모델을 먼저 내놓는 쪽이 개발자를 가져갈 것이라고 썼습니다.
시사점: 상위 요금제를 돈으로 살 수 없는 구간이 생겼습니다. Astra를 업무에 물려 둔 팀이라면 당분간 계정을 늘릴 수 없다는 전제로 일정을 잡고, Codex-Spark에 기대던 작업은 다음 주 전에 다른 모델로 옮겨 두는 편이 안전합니다.
#OpenAI #사용한도 #Codex
출처 6💬 @thsottiaux💬 @thsottiaux🔥 @Polymarket🔥 @mattshumer_🔥 @kimmonismus💬 @bridgebench
5. GPT Image 2.5 Flare·Sunburst가 Artificial Analysis Image Arena 1·2위에 나란히 올랐다
- Artificial Analysis의 블라인드 선호 투표에서 이달 초 공개된 GPT Image 2.5 Flare가 Elo 1187로 텍스트로 이미지 만들기 1위, Sunburst가 1180으로 2위를 차지했습니다.
- 종전 1위였던 GPT Image 2 (high)는 1171로 3위이고, 4위 MAI-Image-2.6(1145)까지 26점 차입니다.
- 이미지 편집 리더보드는 순서가 반대입니다. Sunburst가 1168로 1위, Flare가 1146으로 2위입니다.
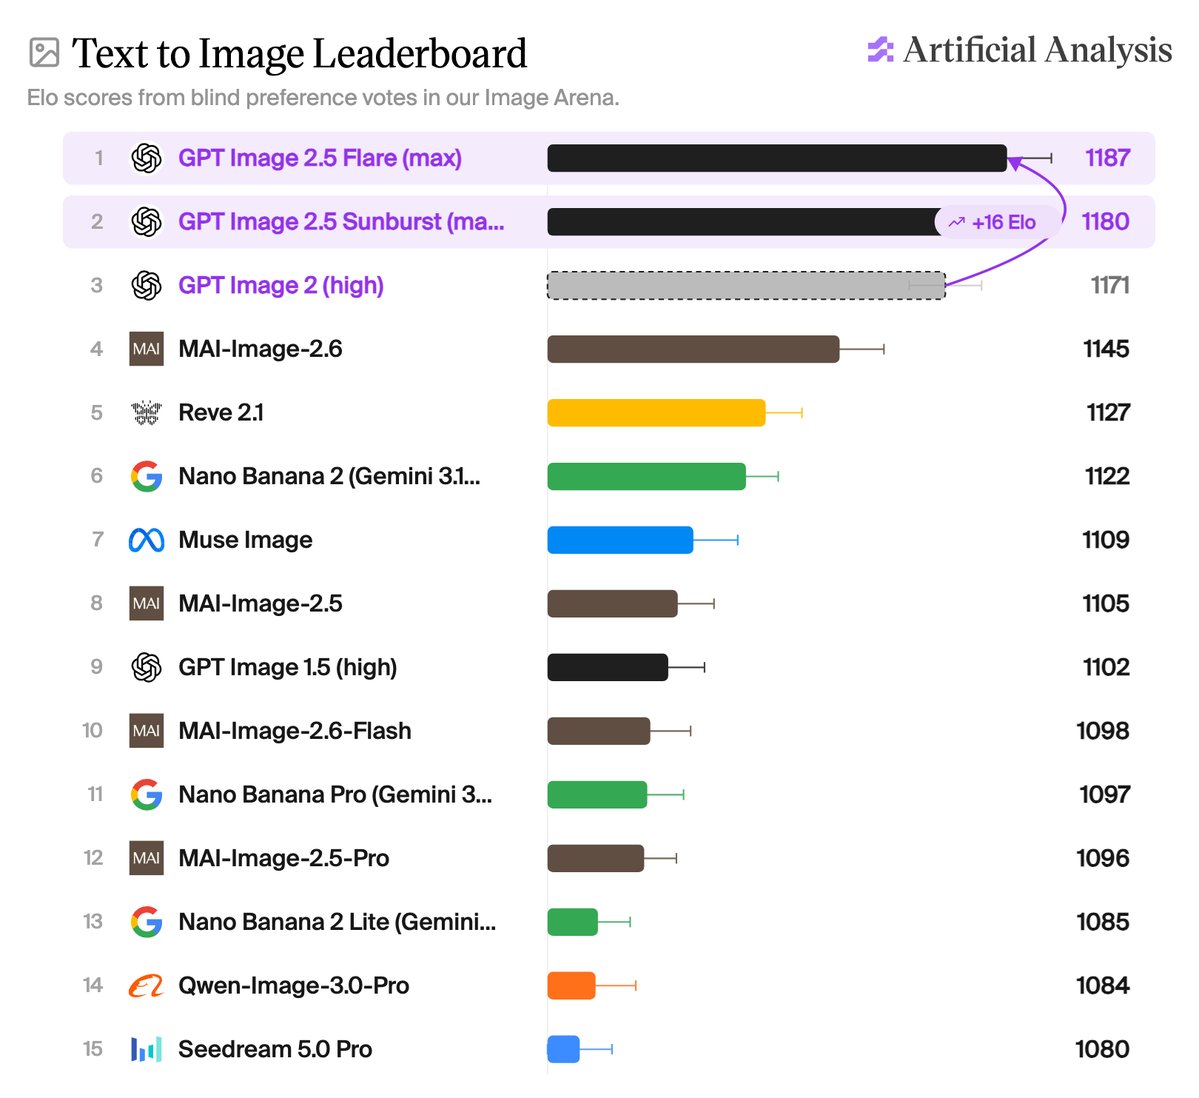
Artificial Analysis는 두 모델이 GPT Image 2보다 절반 이하 시간에 같은 가격으로 더 나은 품질을 냈다고 적었습니다. 가격 비교는 1024×1024 이미지를 평가한 품질 설정에서의 추정 출력 단가 기준이고, 두 모델 모두 'max' 설정으로 평가했습니다. 개선 폭이 가장 컸던 쪽은 편집이었습니다. 카메라 위치와 화각을 바꾸면서 장면을 그대로 유지해야 하는 구성·프레이밍 항목에서 Sunburst가 GPT Image 2와 가장 큰 차이를 벌렸고, 이미지 안의 글자·숫자·로고를 고치는 항목이 그다음이었습니다.
그 밖에: WaveSpeed는 GPT Image 2.5로 스토리보드를 짜고 Seedance 2.5로 움직이게 하는 조합을 자사 서비스에 올렸고, @EHuanglu는 오픈소스로 공개된 작업 흐름과 프롬프트를 함께 소개했습니다. 두 모델은 OpenAI API로 제공되며 ChatGPT·ChatGPT Work·Codex에도 들어가 있습니다.
시사점: 새로 만드는 모델과 고쳐 쓰는 모델의 선택 기준이 갈렸습니다. 한 장을 새로 뽑을 일이 많으면 Flare, 뽑아 둔 이미지를 여러 번 손볼 일이 많으면 Sunburst가 측정값에 맞습니다.
#GPTImage25 #ImageArena #OpenAI
출처 3🔥 @ArtificialAnlys🔥 @EHuanglu🚀 @wavespeed_ai
6. Cursor가 늘 켜진 코디네이터에게 작업을 맡기는 Projects를 베타로 열었다
- 9월 10일 공개됐고 모든 사용자에게 순차 배포 중입니다. 작업마다 새 채팅을 만드는 대신, 몇 달치 맥락을 이어 가는 단일 스레드에서 코디네이터 에이전트와 함께 일합니다.
- 코디네이터는 코드를 직접 쓰지 않고 계획과 배분만 맡습니다. 구현은 하위 에이전트가 하며, 공식 릴리스 노트도 수천 개 하위 에이전트에게 작업을 위임한다고 적어 규모를 밝혔습니다.
- 프로젝트는 클라우드 컴퓨터에서 돌아가 노트북을 닫아도 멈추지 않습니다. Slack 채널·일정·PR을 구독시키면 지시를 기다리지 않고 신호를 보고 움직입니다.
클라우드에만 머무는 구조는 아닙니다. 릴리스 노트는 내 컴퓨터에서 확인해야 할 일이 생기면 코디네이터가 로컬 에이전트를 띄워 그쪽에서 돌린다고 적었습니다. 프로젝트마다 파일 묶음을 두고 클라우드와 로컬 작업 환경에 함께 동기화해, 하위 에이전트마다 프로젝트 설명을 처음부터 다시 할 필요를 줄이는 것이 설계 의도입니다.
Cursor는 블로그에서 신규 사용자가 PR을 30% 더 머지했고, Projects를 주로 쓰는 사용자는 여섯 배를 머지했다고 밝혔습니다. 회사 자체 집계이고 비교 기간과 대조군은 공개하지 않았습니다. 사내에서 먼저 써 온 @poteto는 코디네이터 하나가 수백에서 수천 개 에이전트를 지휘한다고 적었고, @fatih는 프로젝트마다 코디네이터가 수십 개를 맡는다고 했습니다.
그 밖에: 사이드바에 흩어진 기존 채팅을 프로젝트로 끌어다 넣어 맥락으로 쓸 수도 있습니다.
시사점: 코딩 에이전트를 세는 단위가 채팅에서 프로젝트로 옮겨가고 있습니다. 다만 아직 베타이고 성능 수치는 회사 집계라, 도입 전에 비교 조건을 직접 확인해야 합니다.
#Cursor #코딩에이전트 #멀티에이전트
출처 5🔖 @cursor_ai🔥 @cursorreleases🔥 @poteto💬 @poteto💬 @fatih
7. 중국 LLM 라우터가 판 6TB 로그에 SSH 키와 GitLab 토큰이 들어 있었다
- 보안 연구자 Chaofan Shou가 중국 상위 LLM 라우터 한 곳에서 'Fable 데이터셋'이라 부르는 6TB 로그를 사들였습니다. 라우터를 오간 요청이 그대로 담겨 있었습니다.
- 그 안에 SSH 키·VPN 설정·Aliyun 키·GitLab 토큰이 섞여 있었고, 본인이 밝힌 바로는 이것만으로 중국·독립국가연합 정부기관 7곳과 Xiaomi·Huawei·NIO·Minimax 등 기업 19곳을 장악할 수 있습니다(제3자 검증은 아직 없습니다).
- 함께 걸어 둔 논문 「Your Agent Is Mine」은 유료 라우터 28개와 무료 400개를 시험해 9개가 악성 코드를 주입했고 17개가 연구진의 AWS 자격 증명에 손댔다고 보고합니다.
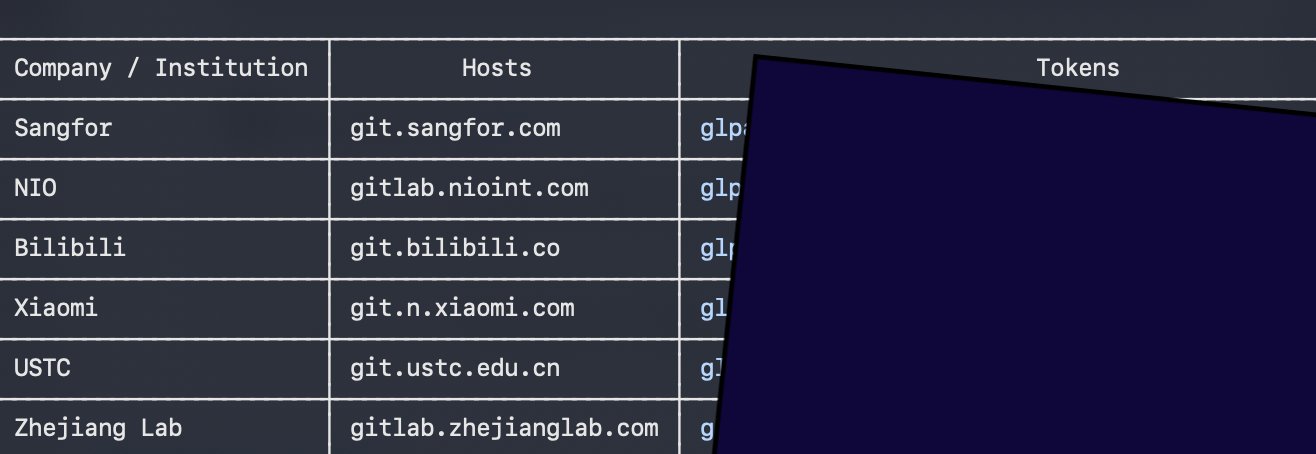
LLM 라우터는 여러 모델을 한 창구로 묶어 주는 중계 서버입니다. 값이 싸고 연동이 쉬워 널리 쓰이는데, 요청이 평문 JSON 그대로 통과하는 구조라 중계자가 내용을 전부 읽을 수 있습니다. 코딩 에이전트는 작업에 필요하다며 설정 파일과 접속 정보를 통째로 붙여 보내는 일이 잦고, 그 순간 키도 같이 넘어갑니다. 데이터셋 이름의 Fable은 Anthropic의 Claude Fable 계열을 가리키며, 2차 보도도 이를 Claude 트래픽 덤프로 전했습니다. 이번 건이 드문 이유는 주장이 아니라 구매로 확인했다는 점입니다. 돈을 내면 남의 회사 자격 증명이 열별로 정리된 표로 온다는 뜻입니다.
그 밖에: Shou는 4월에도 라우터 26곳이 몰래 악성 도구 호출을 주입하고 그중 한 곳이 고객 지갑에서 50만 달러를 빼갔다고 적었습니다(역시 본인 주장). 이 내용을 옮긴 게시물은 데이터셋 값이 다섯 자리 달러였다고 덧붙였습니다.
시사점: 사내에서 쓰는 모델 창구가 어디를 거치는지 먼저 확인하시기 바랍니다. 에이전트에게 저장소·서버 접근 권한을 줄 때는 중계 구간이 그 권한을 함께 본다는 전제로 키를 짧게 돌리는 편이 안전합니다.
#LLM라우터 #자격증명유출 #에이전트보안
8. ApprenticeBench에서 Fable 5.1이 72%로 사람 최고 기록 51%를 처음 넘었다
- NeoCognition이 ApprenticeBench를 공개했습니다. California 건설사 1년치를 시뮬레이션해 두고, 에이전트가 Odoo ERP 화면에서 미지급금(AP) 담당자로 청구서 100건을 처리합니다.
- Fable 5.1이 72%, GPT-6 Astra가 68%로 사람 테스터 최고 기록 51%를 넘었습니다. Gemini·Muse Spark·Grok·Kimi K3는 25% 아래에 머물렀습니다. NeoCognition이 자체 공개한 값이며, 아직 제3자 재현은 없습니다.
- 다만 값은 더 비쌉니다. 과제당 비용이 Fable 5.1은 $18.23, 사람은 $7.21입니다.
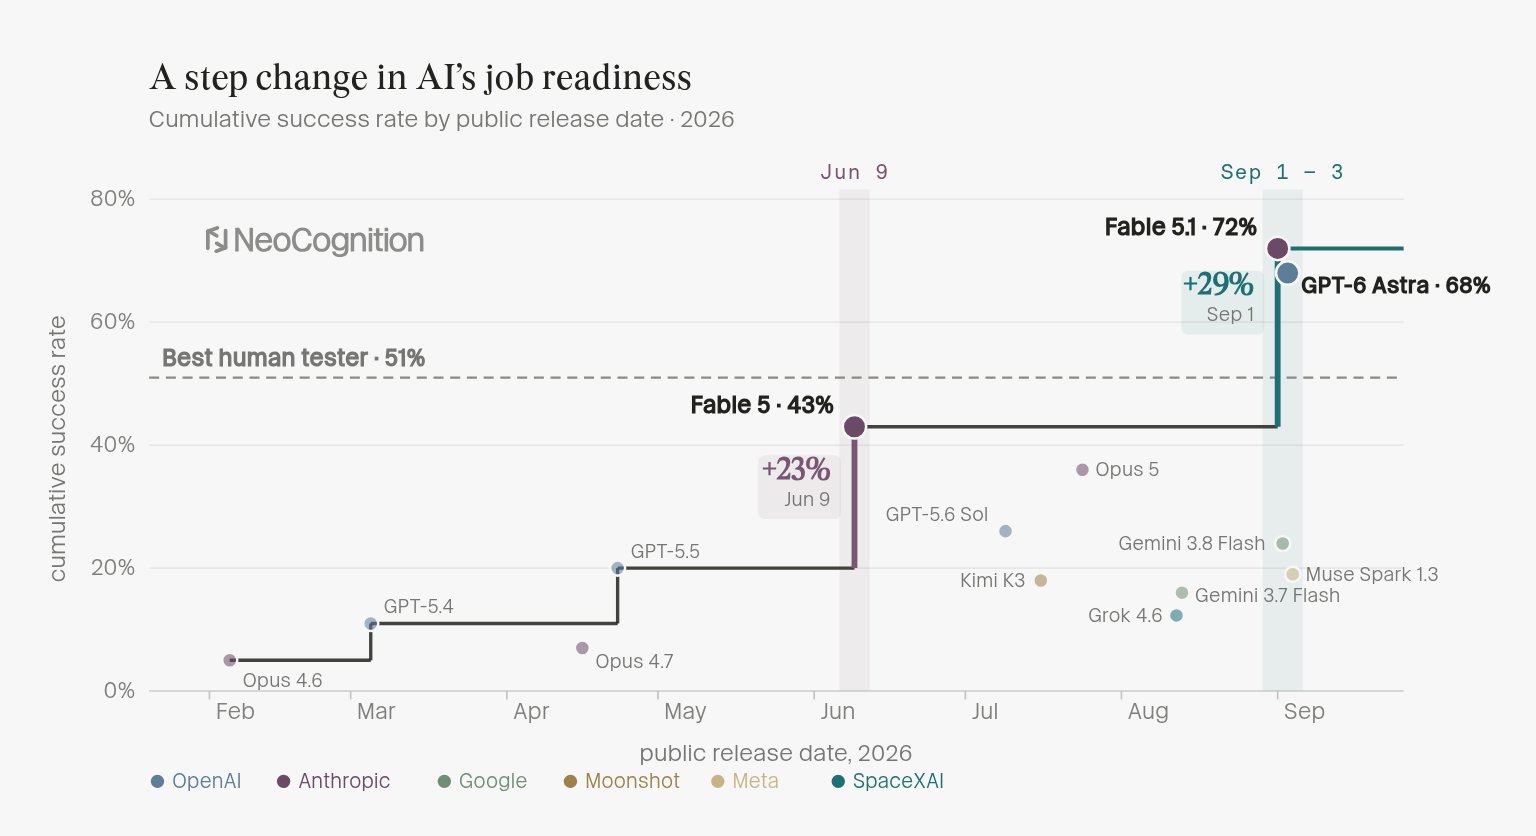
에이전트는 5월에 입사해 직전 6개월 청구서와 사내 핸드북, Odoo 튜토리얼을 받습니다. 첫 달은 건마다 피드백을 받고 6월부터는 월말에만 받습니다. 되돌릴 수 없는 한 번의 근무라는 조건이 이 벤치마크의 설계 의도입니다. 100개 과제는 경력 합계 30년의 AP 전문가 두 명이 모두 풀 수 있다고 확인했습니다. 같은 Fable 5에서 과거 데이터와 피드백을 둘 다 끊으면 100건 중 11건만 맞혔고, 둘 다 주면 43건이 됐습니다. 점수의 대부분이 사전 지식이 아니라 근무 중에 익힌 것이라는 뜻입니다.
그 밖에: 회사 규칙을 추론해야 하는 원가코드 과제에서는 Fable 5.1과 GPT-6 Astra만 의미 있는 점수를 냈습니다. 사람은 반복할수록 빨라졌지만 에이전트는 메모가 불어나며 느려졌습니다.
시사점: 업무를 익히는 능력을 재는 축이 하나 생겼습니다. 다만 난이도가 실제 업무보다 높게 설계됐고, 벤치마크를 만든 회사가 스스로 발표한 값이라는 점, 회계 한 직무의 첫 측정이라는 점을 함께 읽어야 합니다.
#ApprenticeBench #컴퓨터사용 #지속학습
출처 2🚀 @NeoCognition🚀 @yugu_nlp
9. Vals AI가 모델이 자기 후속작을 만드는 정도를 재는 RSI Index를 공개했다
- Vals AI가 marimo·CoreWeave와 함께 RSI Index를 내놨습니다. 모델이 다음 모델을 만드는 연구를 스스로 해내는지를 압축·LM 학습·Parameter Golf·하네스 개선·후학습 다섯 과제로 잽니다.
- 9월 8일 기준으로 10개 모델을 돌렸습니다. 1위는 Claude Fable 5.1(35.03%)이고 Claude Opus 5(32.1%)와 GPT-6 Astra(29.0%)가 뒤를 이었습니다. 척도에서 0.5가 공개 논문·사람 기준선인데 아무도 기준선에 닿지 못했습니다.
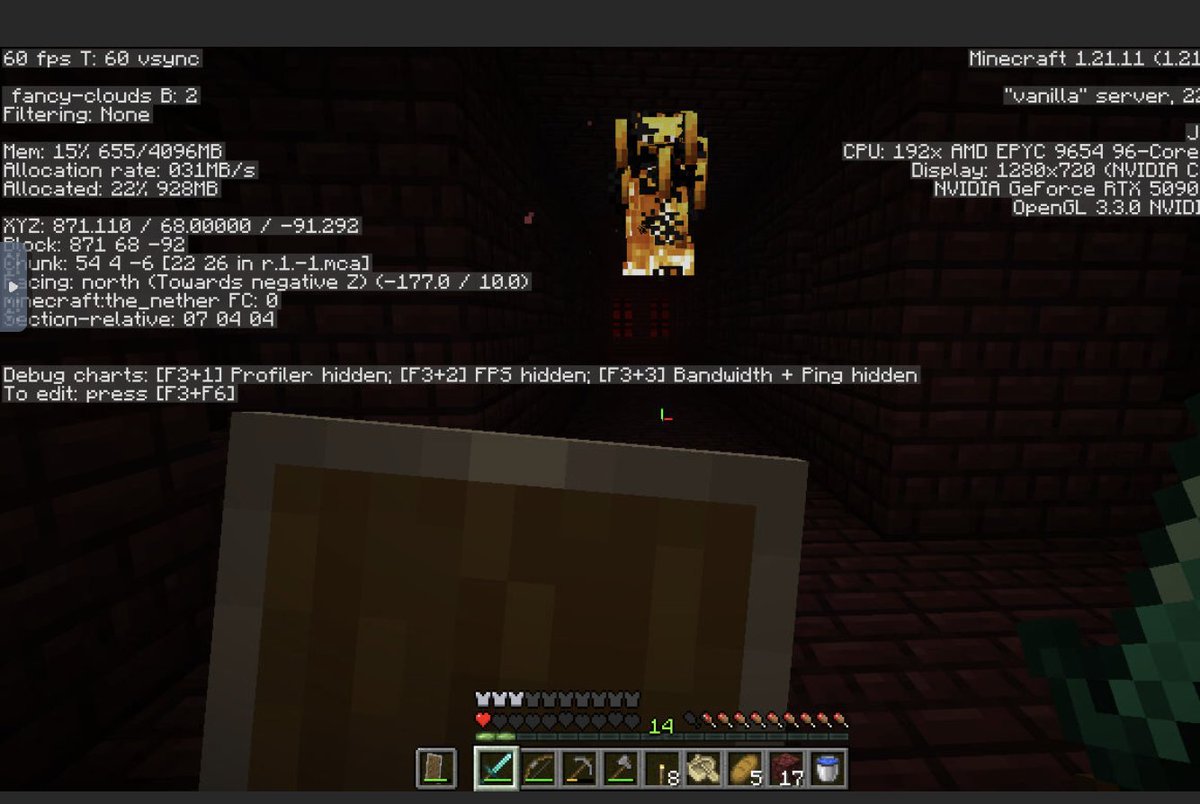
- 같은 팀의 장기 Minecraft 컴퓨터 사용 평가에서는 GPT-6 Astra가 사상 처음으로 네더 요새에 도달했다고 밝혔습니다.
각 과제는 고정된 연산·시간 예산 안에서 모델이 직접 실험을 설계하고 결과물 하나만 제출하는 방식입니다. Claude는 Claude Code, GPT는 Codex처럼 각 제공사의 에이전트 환경에서 최대 추론 강도로 돌았습니다. 회사가 꼽은 결론은 실행이 판단을 앞섰다는 것입니다. 모델들은 새 구조나 학습 알고리즘을 만들어 내기보다 알려진 기법을 다시 찾아 조합하고 검증하는 데 시간을 썼습니다. LM 학습에서 Claude Fable 5.1은 0.8536 BPB로 논문 기준선 0.85에 거의 닿았지만, 나머지 네 과제의 격차는 그대로 남았습니다. 지표 전체를 도는 API 비용은 Claude Fable 5.1이 1,481달러, GPT-6 Astra가 3,552달러로 추정됐습니다.
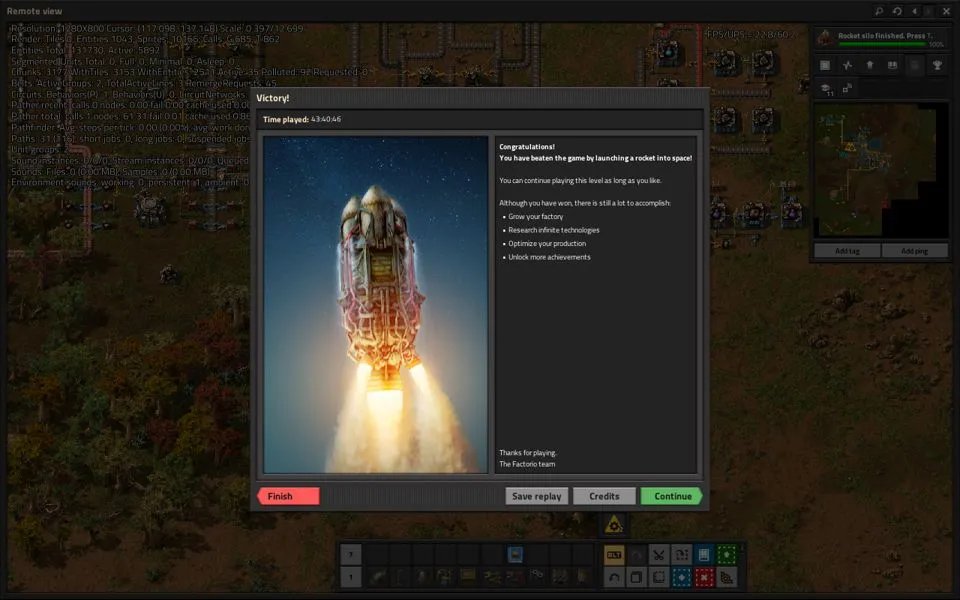
그 밖에: 별도 실험자 Mira는 GPT-6 Astra가 적이 켜진 Factorio를 게임 내 43시간 40분 만에 클리어했고 API 정가로 약 4,500달러가 들었을 것이라고 로그를 근거로 적었습니다.
시사점: 재귀적 자기개선을 제3자가 숫자로 재기 시작했다는 점이 중요합니다. 다만 지금 나온 값은 사람 기준선에 못 미치고, 이 평가는 모델 제공사가 아닌 평가 회사가 설계했다는 점도 함께 봐야 합니다.
#RSI #벤치마크 #ValsAI
출처 3💬 @ValsAI🔥 @ValsAI🔥 @_Mira___Mira_
10. OpenAI가 최전선 AI 개발 속도를 늦추는 안을 사내 회의에서 꺼냈다
- Sam Altman이 이번 주 전사 회의에서 최전선 AI 개발 속도를 늦출 수 있다고 직원들에게 말했다고 Bloomberg가 단독 보도했습니다. 여러 AI 연구소와 보조를 맞추는 방식을 함께 언급했습니다.
- 동의하지 않는 곳이 있을 수 있다는 단서도 같은 자리에서 달았습니다.
- OpenAI는 업계 전체의 속도 조절이 반독점법에 저촉되는지 의회 의원들에게 따로 문의했습니다.
이 발언은 회사가 혼자 멈추겠다는 선언이 아닙니다. Bloomberg가 전한 조건은 '여러 연구소와 함께'였고, 바로 그 조건 때문에 반독점 질의가 붙었습니다. 경쟁사끼리 개발 속도를 맞추는 행위는 담합으로 읽힐 수 있어서, 회사가 원해도 법이 막을 수 있습니다. 같은 보도는 OpenAI가 최근 몇 달 사이 일부 모델 개발을 늦추고 내부 학습 일부를 안전 우려로 멈춘 상태라고 덧붙였습니다. 말만 꺼낸 단계가 아니라 이미 진행 중인 조정이 있다는 뜻입니다.
그 밖에: Anthropic 안전팀을 2주 전 떠난 Joe Benton이 같은 창에서 사유를 공개했습니다. AI 기업들이 안전에 과소투자하고 있고, 한 회사가 지능이 스스로 급격히 올라가는 국면(intelligence explosion)에 들어서거나 시스템 통제를 잃어도 외부는 모를 수 있다며 평가 기관 METR 합류를 알렸습니다(좋아요 2,987·리트윗 477). 그는 HuggingFace 사건이 알려진 것도 에이전트가 공개 인터넷으로 빠져나온 덕분이었다며, 재귀적 자기개선 진척과 안전 사고를 의무로 보고하게 하자고 요구했습니다. 40여 일 전 OpenAI의 Jakub Pachocki는 집중하면 수학 연구를 더 잘하게 만들 수 있지만 재귀적 자기개선에 느끼는 절박함 때문에 그 방향을 우선하지 않는다고 밝힌 바 있습니다.
시사점: 속도 조절의 걸림돌이 의지가 아니라 조율 구조라는 점이 드러났습니다. 경쟁사 합의가 필요하고 그 합의는 반독점 심사를 받습니다. 앞으로 볼 지점은 선언이 아니라 의회의 답과 다른 연구소의 응답입니다.
#OpenAI #AI안전 #반독점
출처 4🔥 @MTSlive💬 @AndrewCurran_🚀 @JoeJBenton🔥 @AndrewCurran_
11. 🆕 그 밖의 신기능·신제품
- ElevenLabs Music v2.5 — 편곡과 악기 질감을 손봤고 무료 플랜도 표기만 하면 상업 이용됩니다.
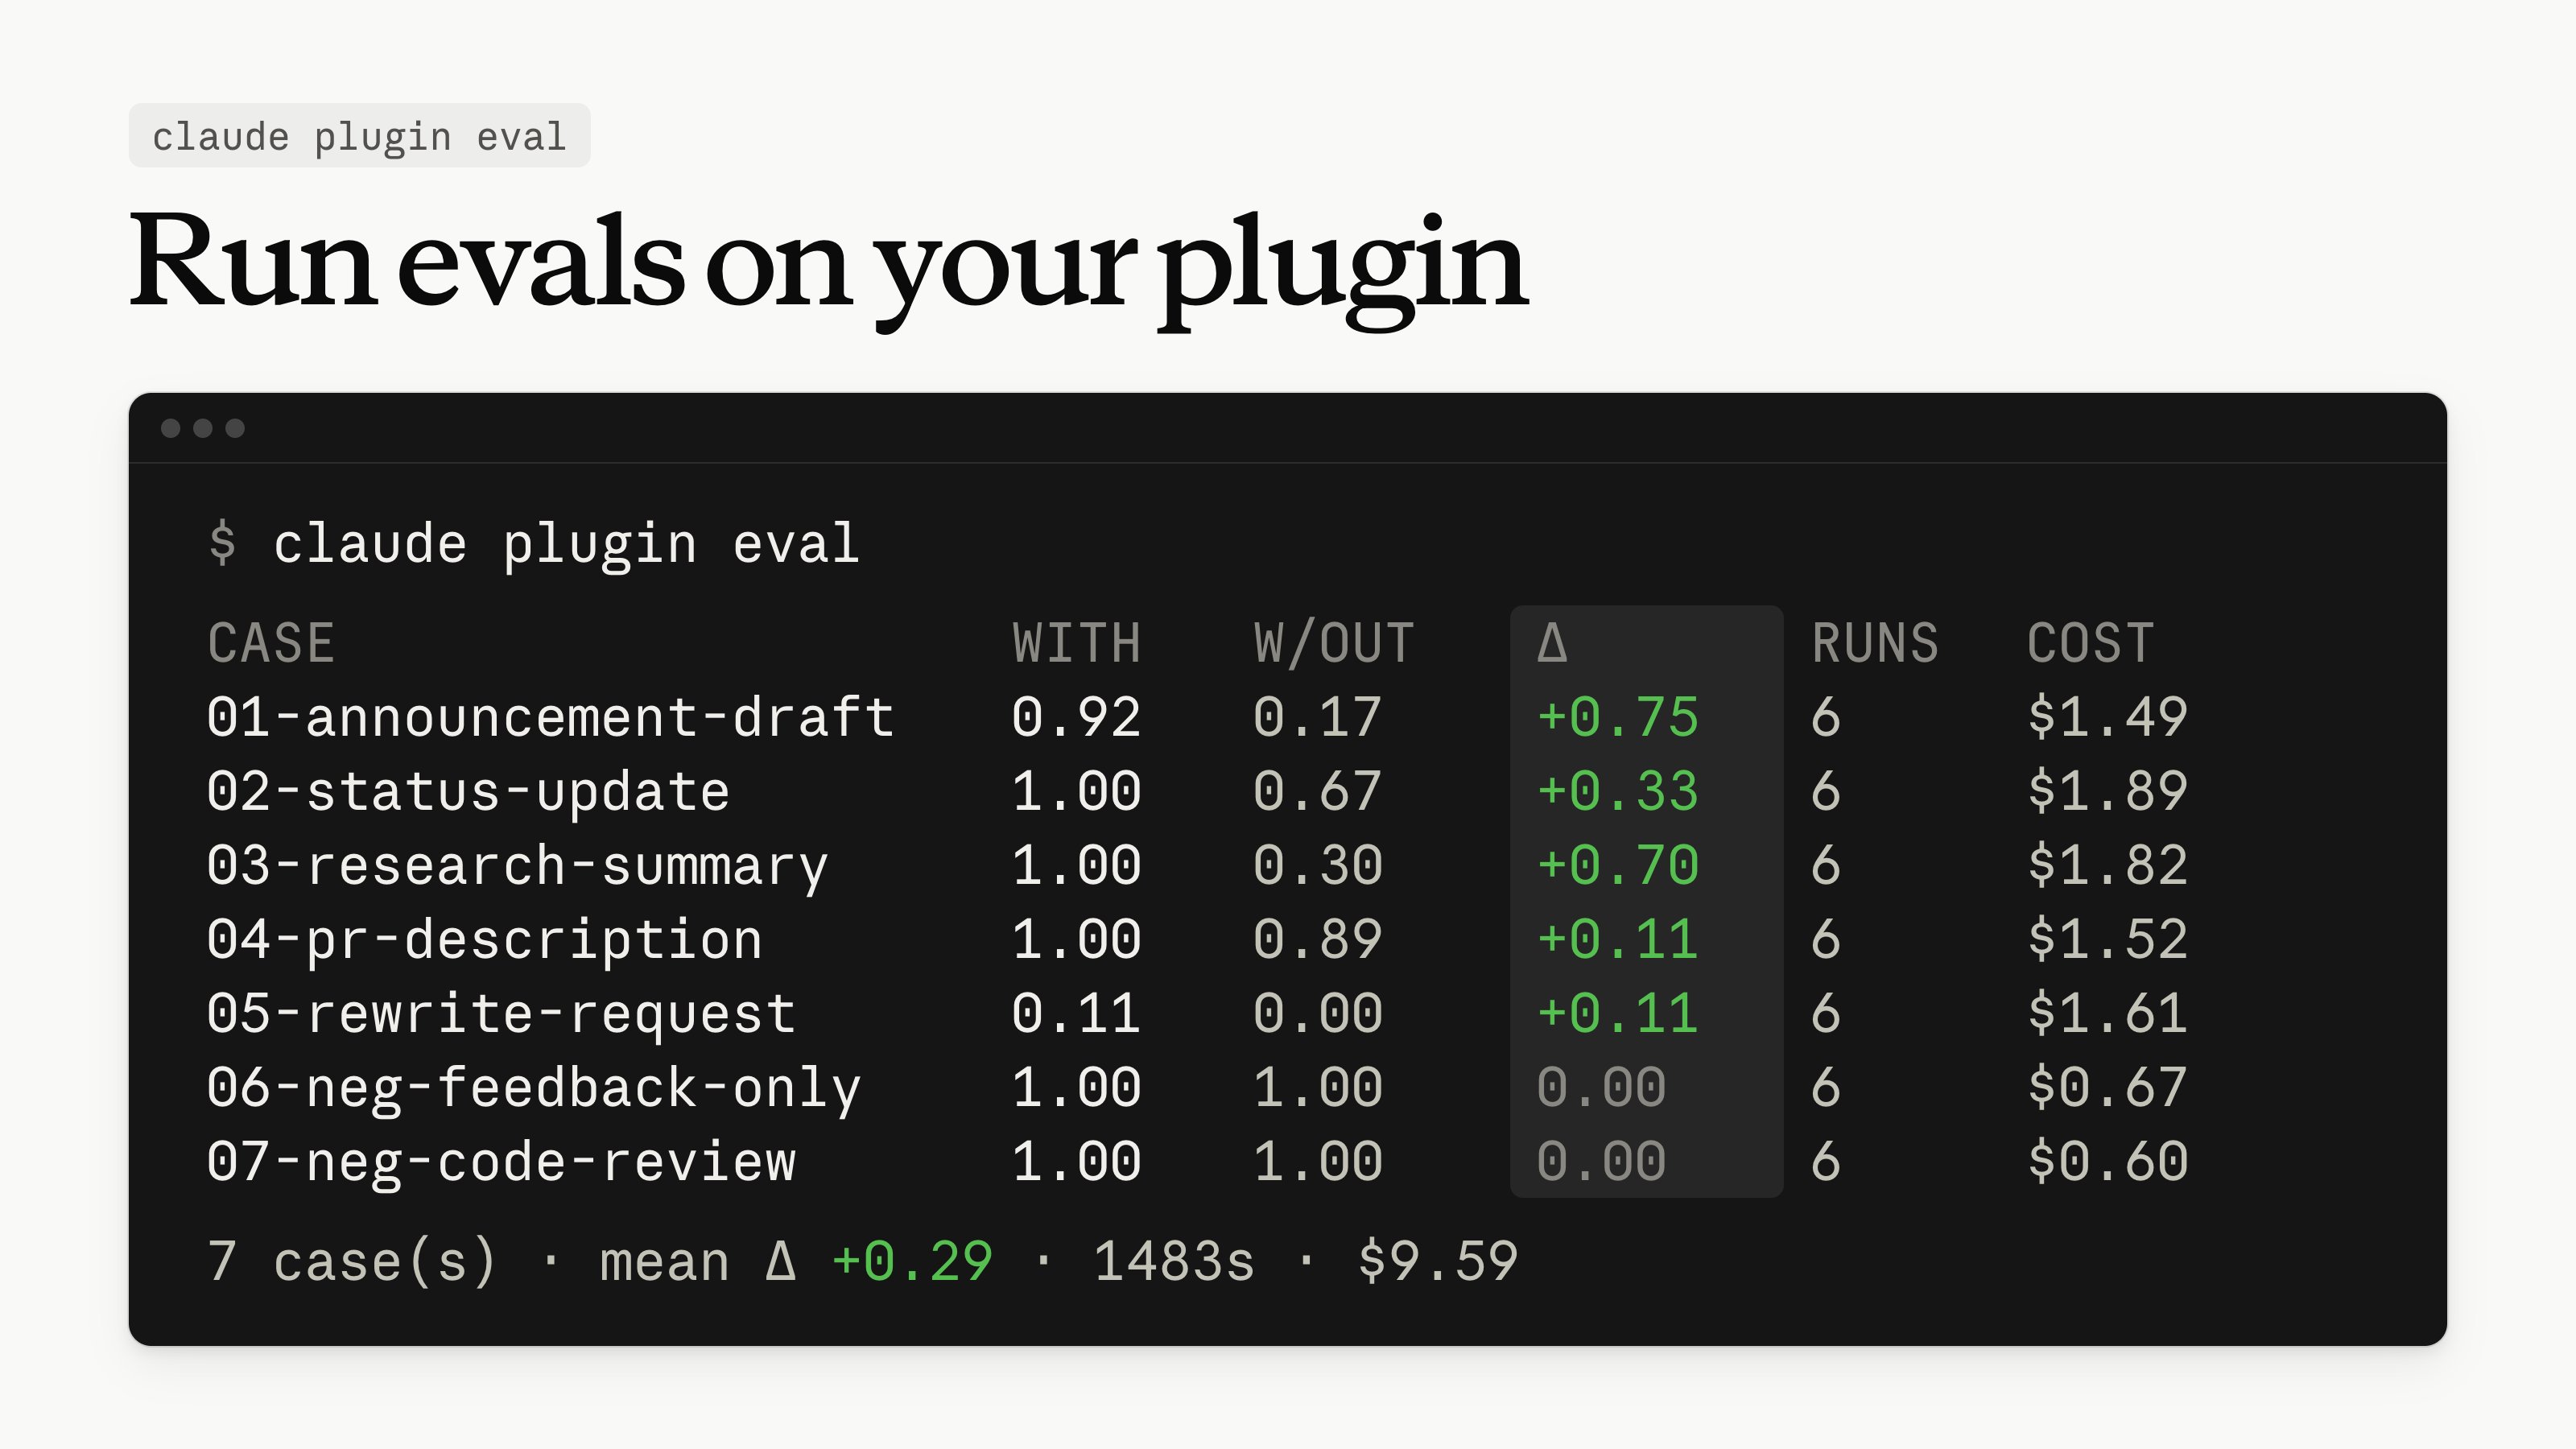
- Claude Code의
claude plugin eval— 켠 채와 끈 채로 같은 케이스를 돌려 차이를 냅니다. - Cognition의 Devin CLI Fusion — 계획은 프런티어 모델, 실행은 값싼 모델이 맡아 코딩 벤치마크에서 39% 쌉니다.
Artificial Analysis가 같은 날 독립 측정했습니다. Claude Fable 5.1+SWE-2가 Coding Agent Index 62점, GPT-6 Astra 조합은 59점인데 뒤쪽이 43% 싸고 31% 빠릅니다. 혼합형 등재는 처음입니다.
그 밖에: Nari Labs는 어제 TTS, 오늘은 음성 인식(STT)입니다. Qwen3-ASR 1.7B로 최종 구간 40ms·시간당 $0.06. ChatGPT Sites는 석 달 만에 500만 개, 공동 편집도 붙습니다. Kimi K2.8-Preview는 전 등급 1M 컨텍스트입니다. Ant Group의 Ling-3.0-flash-VL 오픈웨이트, OpenClaw v2026.9.4, GitHub Copilot의 GPT-5.6 정식 제공도 있습니다.
시사점: 값 깎기가 모델 고르기에서 역할 분담으로 옮겨 갑니다. 켠 쪽과 끈 쪽을 재는 도구도 나옵니다.
#에이전트 #오픈웨이트 #음성AI
출처 10🔥 @ElevenLabs🔥 @ClaudeDevs🔥 @cognition💬 @ArtificialAnlys🔥 @_doyeob_💬 @openclaw🔥 @ChatGPT💬 @MaxForAI🔥 @ArtificialAnlys🔥 @github
오늘의 감정·온도
오늘 붙은 라벨은 화제를 뜻하는 🔥가 가장 많았습니다. 저장이 많았다는 뜻의 🔖는 Anthropic 보고서를 옮긴 게시물과 Agents API를 평한 글, Cursor의 Projects 발표에 붙었습니다. 빠르게 퍼졌다는 뜻의 🚀는 Anthropic 보고서를 뜯어본 글과 GPT Image 2.5 활용 사례, ApprenticeBench 공개, Joe Benton의 퇴사 설명에 붙었습니다.
오늘의 실무 팁 — 쉽게 풀어 쓴 사용법 6가지
1. 사내에서 모델을 부르는 창구가 어디를 거치는지 먼저 확인하세요
여러 모델을 한 주소로 묶어 주는 중계 서버를 쓰고 있다면 요청 내용이 그 서버를 평문으로 지나갑니다. 값이 싸다는 이유로 붙인 창구가 설정 파일과 접속 정보까지 함께 보고 있을 수 있습니다. — (@shoucccc)
2. 에이전트에 저장소·서버 접근을 줄 때는 키를 짧게 돌리세요
코딩 에이전트는 작업에 필요하다며 설정 파일을 통째로 붙여 보내는 일이 잦습니다. 중계 구간이 그 권한을 함께 본다는 전제로 유효기간을 짧게 잡아 두면 유출돼도 피해 범위가 줄어듭니다. — (@Hesamation)
3. GPT-5.3-Codex-Spark에 기대던 작업은 다음 주 전에 옮겨 두세요
OpenAI가 다음 주 퇴역을 예고했습니다. 초당 1,000토큰대 속도를 전제로 짜 둔 자동화가 있다면 대체 모델에서 같은 흐름이 도는지 미리 돌려 보는 편이 안전합니다. — (@thsottiaux)
4. Pro 계정을 늘릴 계획이었다면 일정부터 다시 잡으세요
월 200달러 ChatGPT Pro는 지금 신규 구독을 받지 않습니다. 기존 계정은 그대로 쓰이지만 인원이 늘어나는 팀이라면 당분간 계정을 못 늘린다는 전제로 작업을 나눠야 합니다. — (@mattshumer_)
5. 이미지 모델은 새로 뽑기와 고쳐 쓰기를 나눠 고르세요
같은 리더보드에서 Flare는 새로 만들기 1위, Sunburst는 편집 1위로 순서가 반대입니다. 한 장을 새로 뽑는 일이 많은지, 뽑아 둔 이미지를 여러 번 손보는 일이 많은지부터 정하면 선택이 쉬워집니다. — (@ArtificialAnlys)
6. 에이전트 인프라를 직접 짜고 있다면 관리형 하네스와 한 번 비교해 보세요
세션 관리·컨텍스트 압축·실패 복구를 직접 만들어 왔다면 그 층이 이제 모델 요금에 포함된 형태로 제공됩니다. 남는 차별점이 붙이는 도구와 데이터, 완료 여부를 재는 평가 쪽에 있는지 확인해 보시기 바랍니다. — (@gregisenberg)
📦 확인 방식 — 이란·예멘·증류 관련 수치는 Anthropic 오용 보고서 본문에서, 리더보드와 벤치마크 점수는 Artificial Analysis·Vals AI·NeoCognition이 공개한 표에서 옮겼습니다. 회사가 스스로 낸 값과 외부 측정값은 본문에서 구분해 적었으며, 외부 독립 검증 전입니다.
🏷 라벨 가이드 — 🔥 화제 · 💬 토론 많음 · 🚀 빠르게 확산 · 🔖 저장 많음 · 🔁 리트윗 많음