오늘의 AI 브리핑 ·
Claude 에이전트가 새 효소를 찾았다
5분 브리핑
약 3분 · 10개 흐름핵심만 먼저 읽고, 궁금한 소식은 본문으로 이어 보세요.
전체 분석 14분으로 바로 가기 ↓- Anthropic이 사내 생물학 실험실의 첫 발견을 공개했다 — Claude 에이전트 950개가 21시간 만에 새 효소 무리를 찾았다
Anthropic이 2026년 봄 Bay Area에 차린 자체 생물학 실험실의 첫 성과를 공개했습니다. Claude 에이전트 약 950개가 21시간 동안 DNA 데이터베이스를 뒤져 토큰 2억 1천만 개를 쓴 끝에, 한 에이전트가 아무도 기록한 적 없는 효소 묶음을 찾아냈습니다.
- Bernie Sanders와 Greg Casar가 초지능 금지 법안을 냈다 — AI 전담 연방 부처 신설도 함께 담았다
Bernie Sanders 상원의원과 Greg Casar 하원의원이 9월 23일 Ban Artificial Superintelligence Act(초지능 금지법)를 발의했습니다. 발의 단계이고 통과 여부는 아직 정해지지 않았습니다.
- Gemini 3.8 Flash TTS가 나왔다 — 준비된 목소리 2,000개 이상에 100개 넘는 언어로 읽는다
Google DeepMind가 9월 23일 Gemini 3.8 Flash TTS(글을 사람 목소리로 읽어 주는 모델)와 대량·저비용 작업용 Gemini 3.8 Flash-Lite TTS를 함께 공개했습니다.
- Qwen Intelligence가 나왔다 — 스마트폰 앱을 대신 눌러 일을 끝내는 에이전트 3종
Alibaba가 Qwen Intelligence를 공개했습니다. 어제 예고가 돌던 차세대 모델 Qwen4와는 다른 별개 제품으로, 스마트폰 제조사가 자사 기기에 통째로 얹는 물건입니다.
- Claude Marketplace가 열렸다 — 커넥터·에이전트·구축 파트너를 한곳에서 고른다
Anthropic이 현지 시각 9월 23일 Claude Marketplace를 열었습니다. 그동안 따로 흩어져 있던 세 종류를 검색창 하나 아래로 모은 것입니다.
- Epoch AI 측정: 같은 성능을 내는 비용이 2023년 이후 분기마다 47%씩 떨어졌다
AI 통계를 다루는 연구기관 Epoch AI가 9월 22일 보고서 「The plunging price of thought」를 냈습니다. 같은 성적을 내는 데 드는 비용이 2023년 이후 분기마다 47% 떨어졌다는 측정입니다.
- Bug Hunt Bench 실측: GPT-6 Sol은 값이 가장 쌌지만 심어 둔 버그 105개 중 29.3개만 고쳤다
Bug Hunt Bench는 제품 관리자용 뉴스레터를 쓰는 Paweł Huryn 한 사람이 운영하는 개인 벤치마크입니다. 실제 저장소 두 곳에 버그 105개를 몰래 심어 두고 모델에게 찾아 고치게 시키며, 같은 조건으로 여러 번 돌린 평균이라 점수가 29.3처럼 소수로 나옵니다.
- CAIS가 Humanity's Last Exam 정제판 HLE-Diamond를 내놨다 — 오류를 1년간 걸러 낸 시험에서 GPT-6 Astra가 60.6%로 가장 높았다
Center for AI Safety(AI 위험을 연구하는 비영리 기관)와 Scale AI가 9월 23일 HLE-Diamond를 공개했습니다. 전문가들이 출제한 초고난도 시험 Humanity's Last Exam 2,500문제에서 1년간 오류를 걸러 내고 1,000문제만 남긴 정제판입니다.
- Forecasting Research Institute가 4년치 AI 예측을 채점했다 — 능력은 예상보다 빨리 왔고 확산 예측은 양쪽으로 엇갈렸다
예측의 정확도를 연구하는 비영리 기관 Forecasting Research Institute(금)가 2022년 중반부터 2026년 8월까지 자사 조사에서 모은 AI 예측을 9월 23일 중간 채점해 공개했습니다.
- 🆕 그 밖의 신기능·신제품
OpenAI가 GPT-6 API의 프롬프트 캐싱(같은 지시문을 반복해 보낼 때 앞부분을 재사용하는 기능)을 손봤습니다. 기본 적중률을 올려 재사용된 입력에 최대 90% 할인이 붙고, 적중률을 보는 대시보드가 생겼습니다.
주요 키워드 TOP 5: Anthropic ART · 초지능 금지법 · Gemini 3.8 Flash TTS · Qwen Intelligence · AI 비용 하락 | 메인 이벤트: Anthropic의 사내 생물학 실험실에서 Claude 에이전트 950개가 21시간 만에 기록에 없던 효소 무리를 찾아냈습니다.
오늘은 AI의 실력을 어떻게 재는지에 대한 소식이 유난히 많았습니다. Center for AI Safety는 자기가 낸 초고난도 시험에서 1년에 걸쳐 결함 문제를 걷어낸 정제판을 공개했는데 그러자 순위표 1위가 바뀌었고, Epoch AI는 같은 점수를 내는 데 드는 값이 2023년 이후 분기마다 47%씩 떨어졌다고 쟀으며, Forecasting Research Institute는 4년치 AI 예측을 채점해 능력은 예상보다 빨리 왔고 확산 예측은 양쪽으로 엇갈렸다고 정리했습니다. 그 사이 Anthropic은 점수표가 아니라 자사 실험실 기록을 내놨습니다. Claude 에이전트 950개가 21시간 동안 DNA 데이터베이스를 뒤져 아무도 기록한 적 없는 효소 무리를 찾아냈고, 회사는 그것이 무슨 일을 하는지는 아직 모른다고 함께 적었습니다.
1. Anthropic이 사내 생물학 실험실의 첫 발견을 공개했다 — Claude 에이전트 950개가 21시간 만에 새 효소 무리를 찾았다
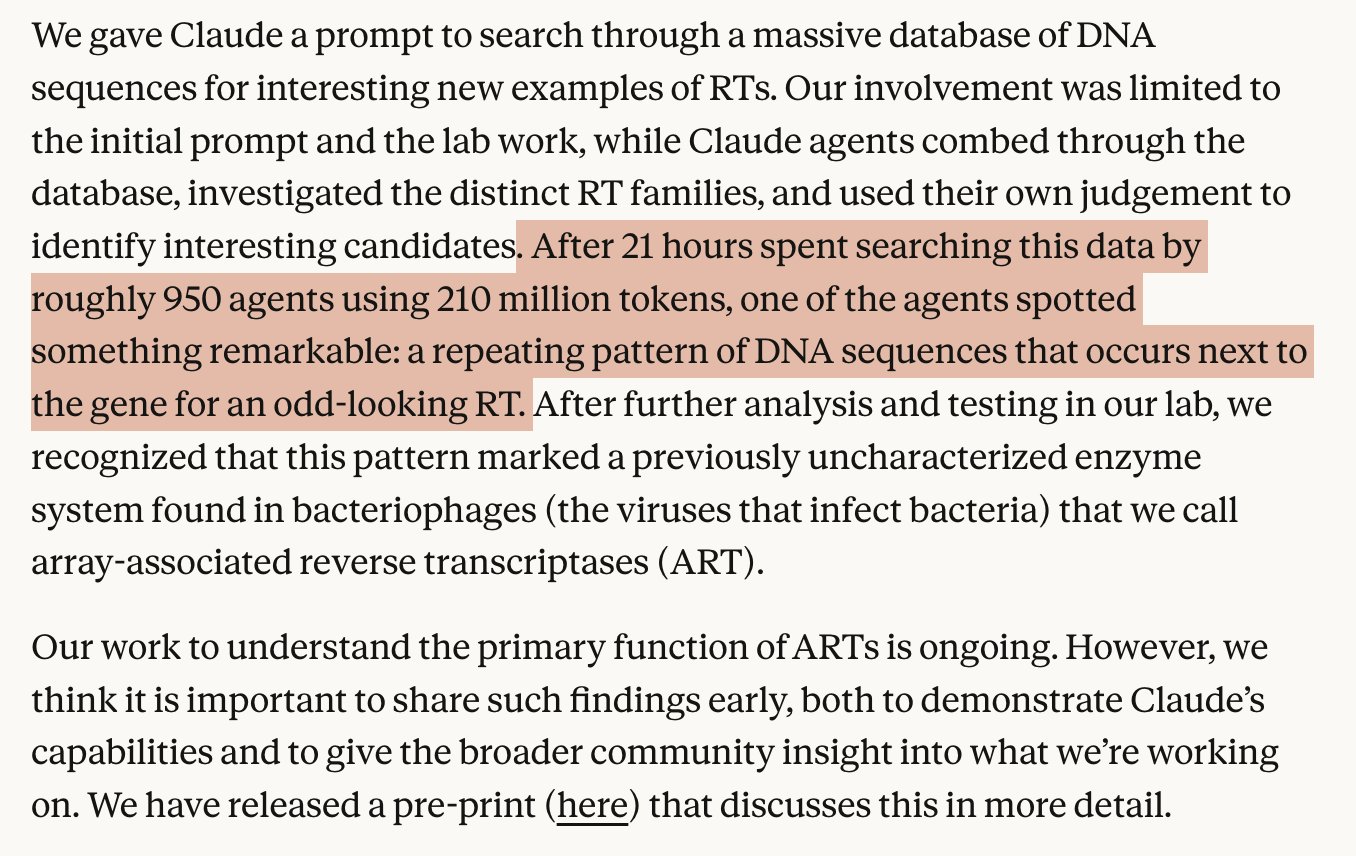
- Anthropic이 2026년 봄 Bay Area에 차린 자체 생물학 실험실의 첫 성과를 공개했습니다. Claude 에이전트 약 950개가 21시간 동안 DNA 데이터베이스를 뒤져 토큰 2억 1천만 개를 쓴 끝에, 한 에이전트가 아무도 기록한 적 없는 효소 묶음을 찾아냈습니다.
- 찾은 것은 파지(세균을 감염시키는 바이러스) 안에 숨어 있던 구조입니다. 역전사효소(RNA를 DNA로 거꾸로 베껴 쓰는 효소)의 유전자 옆에 똑같은 DNA 조각이 일정 간격으로 줄줄이 반복되는 배열이 붙어 있었고, 이 생김새가 유전자 가위 CRISPR와 닮았습니다. Anthropic은 이 묶음을 ART라고 이름 붙였습니다.
- 사람이 한 일은 처음 지시문 한 번과 실험실 검증뿐입니다. 후보를 모으고 추리는 과정은 에이전트가 스스로 판단해 진행했습니다.
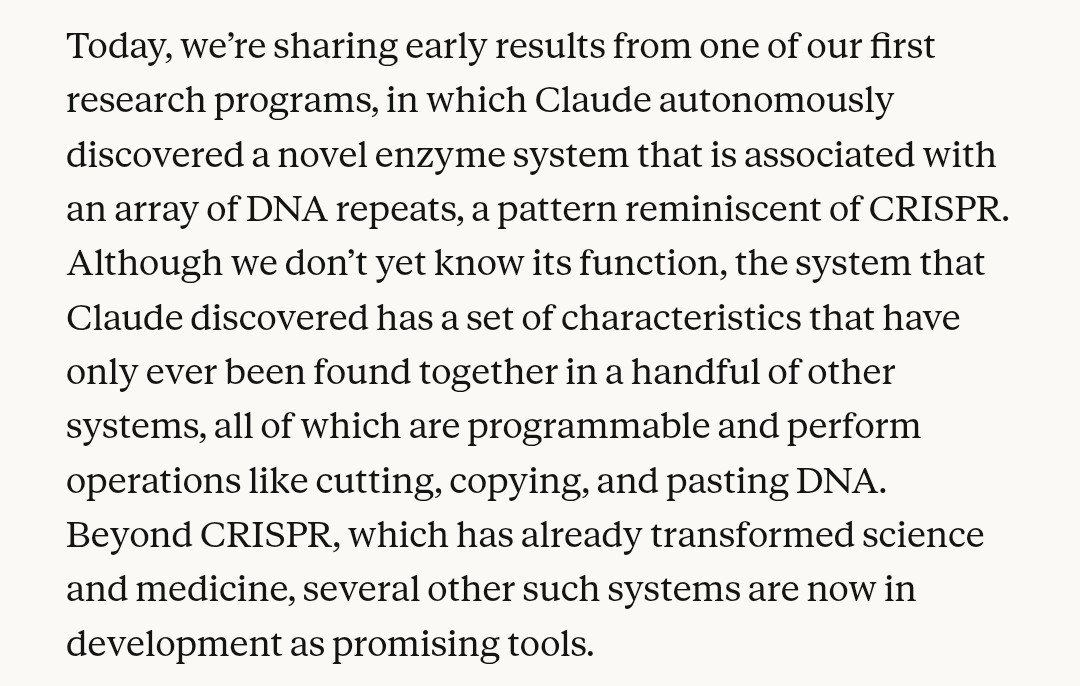
여기서 '실험실'은 비유가 아닙니다. 소프트웨어 회사인 Anthropic이 올봄 직접 시험관을 다루는 공간을 차려, 모델이 내놓은 가설을 남에게 맡기지 않고 그 자리에서 확인하기로 한 것입니다. 에이전트들은 역전사효소를 20만 개 넘게 그러모은 뒤 새 후보 시스템 3,500개를 골라냈고, 그중 가장 유력한 20개를 사람이 읽을 수 있는 보고서로 정리했습니다. Anthropic은 이 정도 분석이 전문 연구자에게는 몇 주에서 몇 달이 걸리는 일이라고 설명합니다. 그동안 AI의 과학 실력은 대부분 시험 점수로 이야기됐는데, 이번에는 실제 실험대 위에서 검증된 결과물이 먼저 나왔다는 점이 다릅니다.
그 밖에: Anthropic은 ART가 무슨 일을 하는지 아직 모른다고 분명히 밝혔고, 초기 실험에서 반복 배열이 짧은 RNA로 읽힌다는 것까지만 확인했습니다. CRISPR 공동 개발자로 꼽히는 MIT·Broad Institute의 Feng Zhang도 더 들여다볼 만한 발견이라는 정도로 평가했습니다. 자세한 내용은 프리프린트(정식 심사 전 논문)로 함께 공개됐습니다.
시사점: 모델 성능표가 아니라 실험실 기록으로 능력을 증명하려는 시도라, 앞으로 AI 회사의 발표를 볼 때 "무엇을 만들어 냈나"를 기준으로 삼기 쉬워집니다. 다만 기능이 확인되지 않은 단계이니, 과학적 가치는 후속 연구가 나올 때까지 유보하고 읽는 편이 맞습니다.
#Anthropic #Claude #AI과학발견
출처 4🔥 @AndrewCurran_🔥 @rohanpaul_ai🔥 @ai_for_success💬 @nc_frey
2. Bernie Sanders와 Greg Casar가 초지능 금지 법안을 냈다 — AI 전담 연방 부처 신설도 함께 담았다
- Bernie Sanders 상원의원과 Greg Casar 하원의원이 9월 23일 Ban Artificial Superintelligence Act(초지능 금지법)를 발의했습니다. 발의 단계이고 통과 여부는 아직 정해지지 않았습니다.
- 법안은 대부분의 영역에서 인간의 인지 능력을 넘어서거나 인류를 파괴·무력화할 수 있는 AI를 초지능으로 정의하고 그 개발과 배포를 금지합니다.
- 장관급 부처인 Department of Artificial Intelligence(인공지능부)를 새로 만들고, 그 기구가 심사 규칙을 갖출 때까지 고급 AI 개발을 멈추게 합니다.
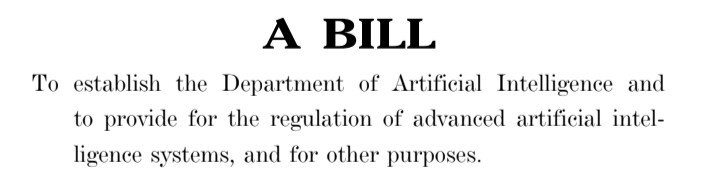
두 의원실이 같은 날 낸 보도자료를 보면 새 부처가 맡을 일은 셋입니다. 가장 앞선 AI 시스템을 감시하고, 위험한 기능을 떼어내는 작업을 감독하고, 초지능으로 판정된 모델을 폐기하는 절차를 관리합니다. 개발을 멈추는 기간도 날짜로 정해 두지 않았습니다. 새 기구가 문을 열고 심사 절차를 실제로 갖출 때까지가 조건입니다.
처벌 수위는 따로 적혀 있습니다. 기업은 법인 자격을 잃고 개인은 최대 징역 20년인데, Casar 의원실은 이를 핵무기 관련 위반에 준하는 수준이라고 설명했습니다. 대외 정책으로는 국제 협정과 수출 통제를 써서 다른 나라에서도 초지능이 나오지 않게 하겠다고 명시했습니다.
그 밖에: AP 보도에 따르면 OpenAI 안전 부서 연구원과 Google DeepMind 엔지니어를 포함한 주요 AI 기업 직원들이 이 법안을 지지한다고 밝혔습니다.
시사점: 오늘 당장 바뀌는 규제는 없습니다. 다만 초지능을 법조문으로 정의하고 처벌 수위까지 적은 안이 나왔다는 건, 미국의 AI 규제 논의가 기업 자율 규약에서 강제력 있는 심사 기구 쪽으로 옮겨가고 있다는 신호입니다.
#AI규제 #미국의회 #초지능
출처 1💬 @AndrewCurran_
3. Gemini 3.8 Flash TTS가 나왔다 — 준비된 목소리 2,000개 이상에 100개 넘는 언어로 읽는다
- Google DeepMind가 9월 23일 Gemini 3.8 Flash TTS(글을 사람 목소리로 읽어 주는 모델)와 대량·저비용 작업용 Gemini 3.8 Flash-Lite TTS를 함께 공개했습니다. 바로 쓸 수 있는 목소리가 2,000개 이상이고, 100개가 넘는 언어와 방언을 읽습니다.
- 대본에 평범한 말로 지시를 적어 줄 단위로 연기를 시킬 수 있습니다. 웃음·한숨 같은 소리도 대본에 넣고, 두 사람이 주고받는 대화도 한 번에 만듭니다.
- 30초짜리 샘플이 있으면 특정인의 목소리를 흉내 낼 수 있지만, 본인 동의 확인을 거쳐야 하고 일리노이·텍사스·유럽경제지역·영국·스위스·인도에서는 이 기능이 막혀 있습니다.
Google은 이번이 30일이 안 되는 기간에 내놓은 세 번째 오디오 모델이라고 밝혔습니다. 두 모델은 쓰임이 갈립니다. Flash TTS는 말로 설명해서 새 목소리를 만들어 내는 창작 쪽이고, Flash-Lite TTS는 더빙이나 음성 상담처럼 같은 작업을 값싸게 많이 돌리는 쪽입니다. 지금은 Gemini API와 Google AI Studio에서 쓸 수 있고, Google의 영상 제작 도구 Google Vids에는 Flash-Lite TTS가, Gemini Notebook에는 Flash TTS가 들어갔습니다.
그 밖에: 원어민이 어느 회사 음성인지 모른 채 둘 중 나은 쪽을 고르는 평가인 Voice Arena는 두 모델이 7개 언어 순위표에서 모두 1위에 올랐고 미국 영어에서는 Flash-Lite가 20개 중 1위(1087점)였다고 밝혔는데, 정식 출시 직전에 미리 평가한 결과라고 함께 적었습니다. 만들어진 음성에는 SynthID 워터마크가 들어갑니다. 발표 글은 해커뉴스에서 181점을 받았습니다.
시사점: 이제 다툼은 얼마나 사람처럼 읽느냐보다 누구 목소리를 어디까지 써도 되느냐로 옮겨가고 있습니다. 목소리 복제에 동의 확인과 지역 차단이 함께 붙은 것이 그 신호입니다.
#TTS #GoogleDeepMind #음성AI
출처 4💬 @NewsFromGoogle🔥 @patloeber🔥 @ai_for_success🔁 @voicearena_ai
4. Qwen Intelligence가 나왔다 — 스마트폰 앱을 대신 눌러 일을 끝내는 에이전트 3종
- Alibaba가 Qwen Intelligence를 공개했습니다. 어제 예고가 돌던 차세대 모델 Qwen4와는 다른 별개 제품으로, 스마트폰 제조사가 자사 기기에 통째로 얹는 물건입니다.
- 에이전트는 셋입니다. 요청을 실행 단계로 쪼개는 Mobile Planner Agent, 앱을 넘나들며 실제로 조작하는 Mobile-Use Agent, 한 문장을 약 3초 만에 이미지로 바꾸는 Mobile Creative Agent.
- Mobile-Use Agent는 앱이 열어 둔 연결 통로를 먼저 쓰고 그게 없으면 사람처럼 화면을 눌러 진행합니다. Qwen은 종단 간 성공률 90%, 그러니까 사람이 중간에 손대지 않고 끝까지 마친 비율이 90%라고 밝혔습니다.
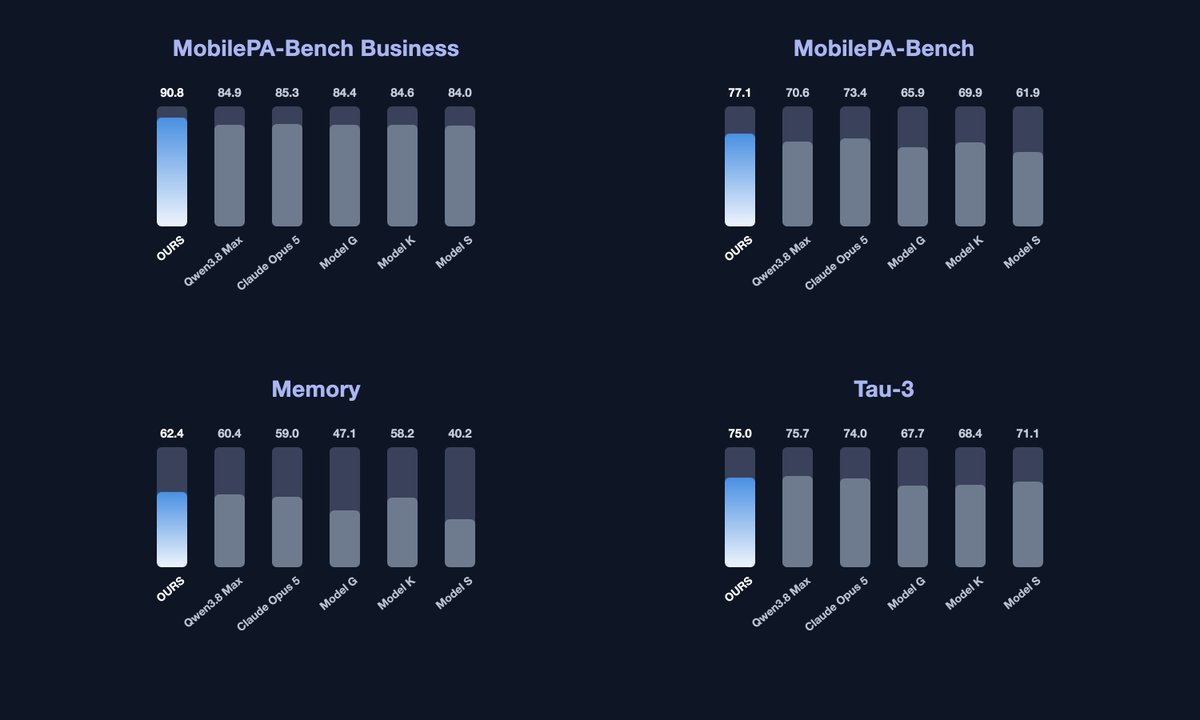
지금 스마트폰에 들어간 Apple Intelligence나 Google Gemini는 주로 묻는 말에 답하는 쪽입니다. Qwen Intelligence가 노리는 자리는 그다음, 즉 사용자가 앱을 직접 열고 누르는 과정을 AI가 대신하는 구간입니다. 발표를 전한 외신들은 100단계가 넘는 긴 작업까지 이어서 처리한다고 적었습니다. Honor가 첫 파트너로 붙어 9월 28일 공개하는 Magic9 시리즈에 처음 들어가며, 계획 능력을 재는 MobilePA-Bench 등 평가 도구 네 벌도 함께 공개됐습니다.
그 밖에: 같은 날 음성 묶음 Qwen-Audio-3.1도 나왔습니다. 받아쓰기·음성 합성·실시간 대화가 모두 갱신되고 신규 두 종이 더해져 다섯 모델이 됐고, 가격도 내렸습니다.
시사점: 성공률 90%는 회사가 스스로 잰 값이라 실제 기기에서 확인할 일이 남았습니다. 다만 AI의 경쟁 무대가 대화창에서 휴대폰 화면 조작으로 옮겨가는 흐름은 9월 28일 첫 제품으로 바로 검증됩니다.
#Qwen #모바일에이전트 #온디바이스AI
출처 3🔥 @kimmonismus💬 @NFT_Chen🔥 @QwenDevs
5. Claude Marketplace가 열렸다 — 커넥터·에이전트·구축 파트너를 한곳에서 고른다
- Anthropic이 현지 시각 9월 23일 Claude Marketplace를 열었습니다. 그동안 따로 흩어져 있던 세 종류를 검색창 하나 아래로 모은 것입니다.
- 첫째는 커넥터·플러그인 2,000개 이상입니다. Slack·Notion·Google·Microsoft·Atlassian처럼 회사가 이미 쓰는 도구를 Claude에 연결해 줍니다.
- 둘째는 Cursor·CrowdStrike·Harvey·Snowflake가 파는 에이전트와 제품이고, 셋째는 Accenture·Boston Consulting Group·Deloitte 같은 구축 파트너입니다.
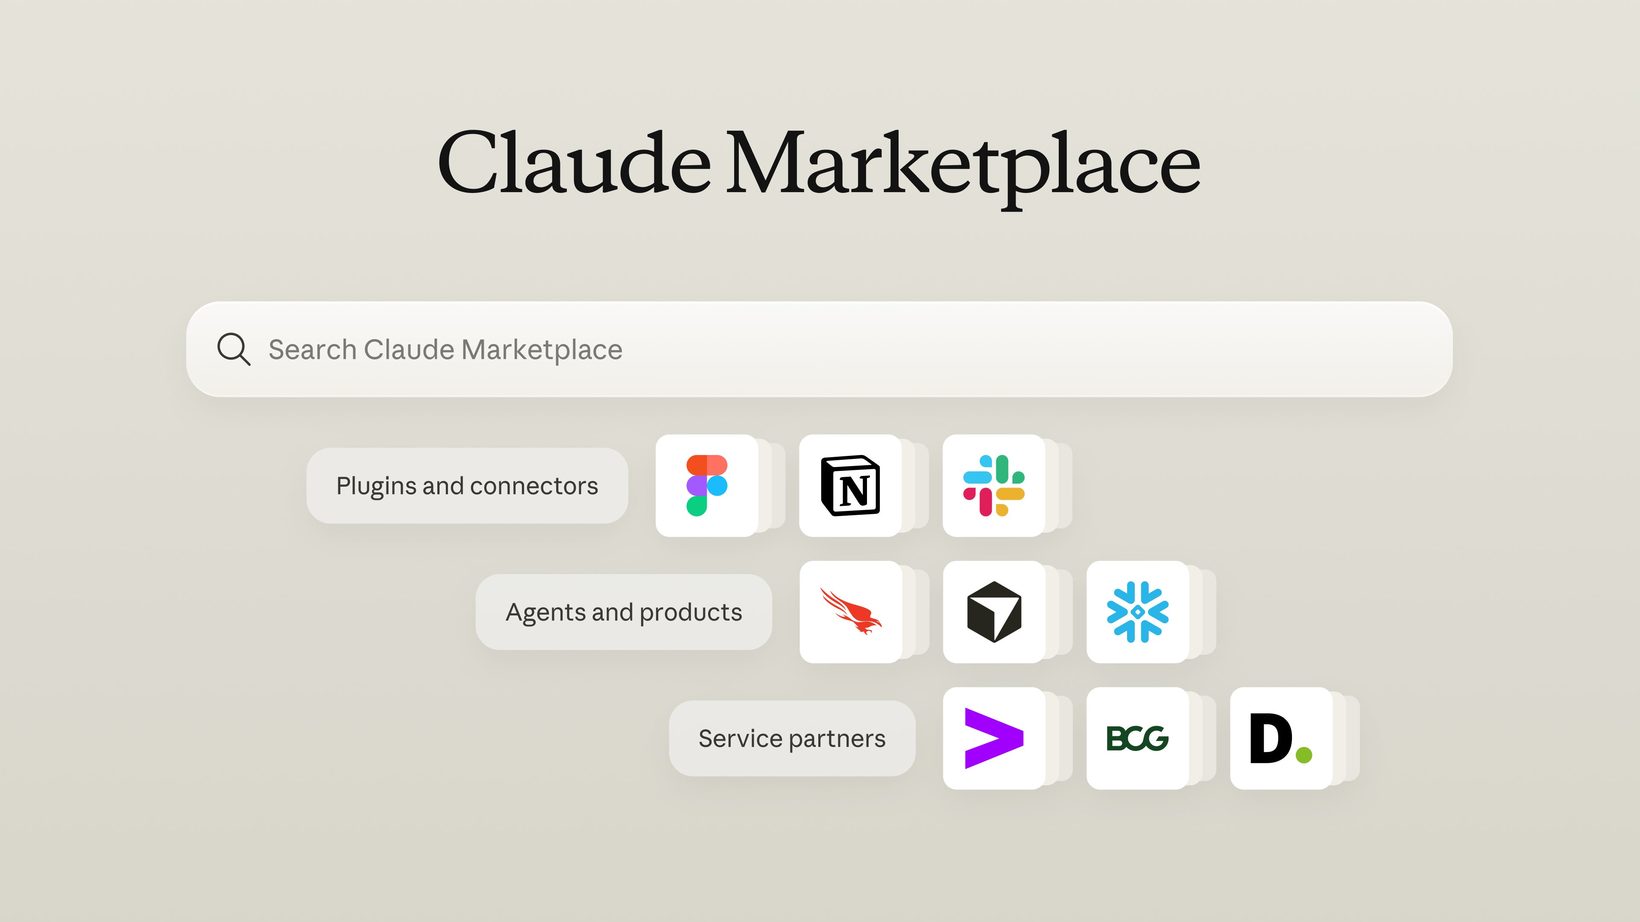
Anthropic은 올해 3월 기업 전용 구매 창구를 파트너 여섯 곳으로 먼저 열었는데, 이번에는 찾아보는 자리까지 같은 화면으로 넓혔습니다. 회사가 Anthropic과 맺어 둔 연간 사용 약정 금액을 여기서 파는 제품을 사는 데 쓸 수 있고, 청구서도 Anthropic 한 곳으로 묶입니다. 도구마다 계약과 결제를 새로 트지 않아도 된다는 뜻이라, 구매 절차가 한 번으로 줄어듭니다.
그 밖에: 파는 쪽으로 들어가는 길도 셋으로 나뉩니다. 커넥터·플러그인을 만들어 올리거나, 유료 에이전트 판매를 신청하거나, 구축을 맡는 Claude Partner Network에 지원하면 됩니다.
시사점: 모델만 팔던 회사가 그 위에서 도는 완제품과 구축 인력까지 같은 계산서에 올렸습니다. 도입을 검토하는 쪽은 "어떤 모델을 쓸까"보다 "이미 만들어진 게 있나"를 먼저 보게 됩니다.
#Anthropic #Claude #엔터프라이즈
출처 1🔥 @claudeai
6. Epoch AI 측정: 같은 성능을 내는 비용이 2023년 이후 분기마다 47%씩 떨어졌다
- AI 통계를 다루는 연구기관 Epoch AI가 9월 22일 보고서 「The plunging price of thought」를 냈습니다. 같은 성적을 내는 데 드는 비용이 2023년 이후 분기마다 47% 떨어졌다는 측정입니다. 1년이면 13분의 1입니다.
- 같은 방식으로 잰 과거 기술과 비교하면 DNA 시퀀싱보다 4배, 컴퓨팅(연산)보다 6배, 리튬 배터리보다 18배, 전기(1892~1973년)보다 54배 빠릅니다.
- 2025년 1월 o3는 GPQA Diamond(박사급 물리·화학·생물 객관식 시험)에서 75%를 받는 데 문항당 약 0.30달러가 들었습니다. 18개월 뒤 GPT-5.6 Luna는 같은 점수를 0.0004달러에 냈습니다. 725배 싸진 셈입니다.
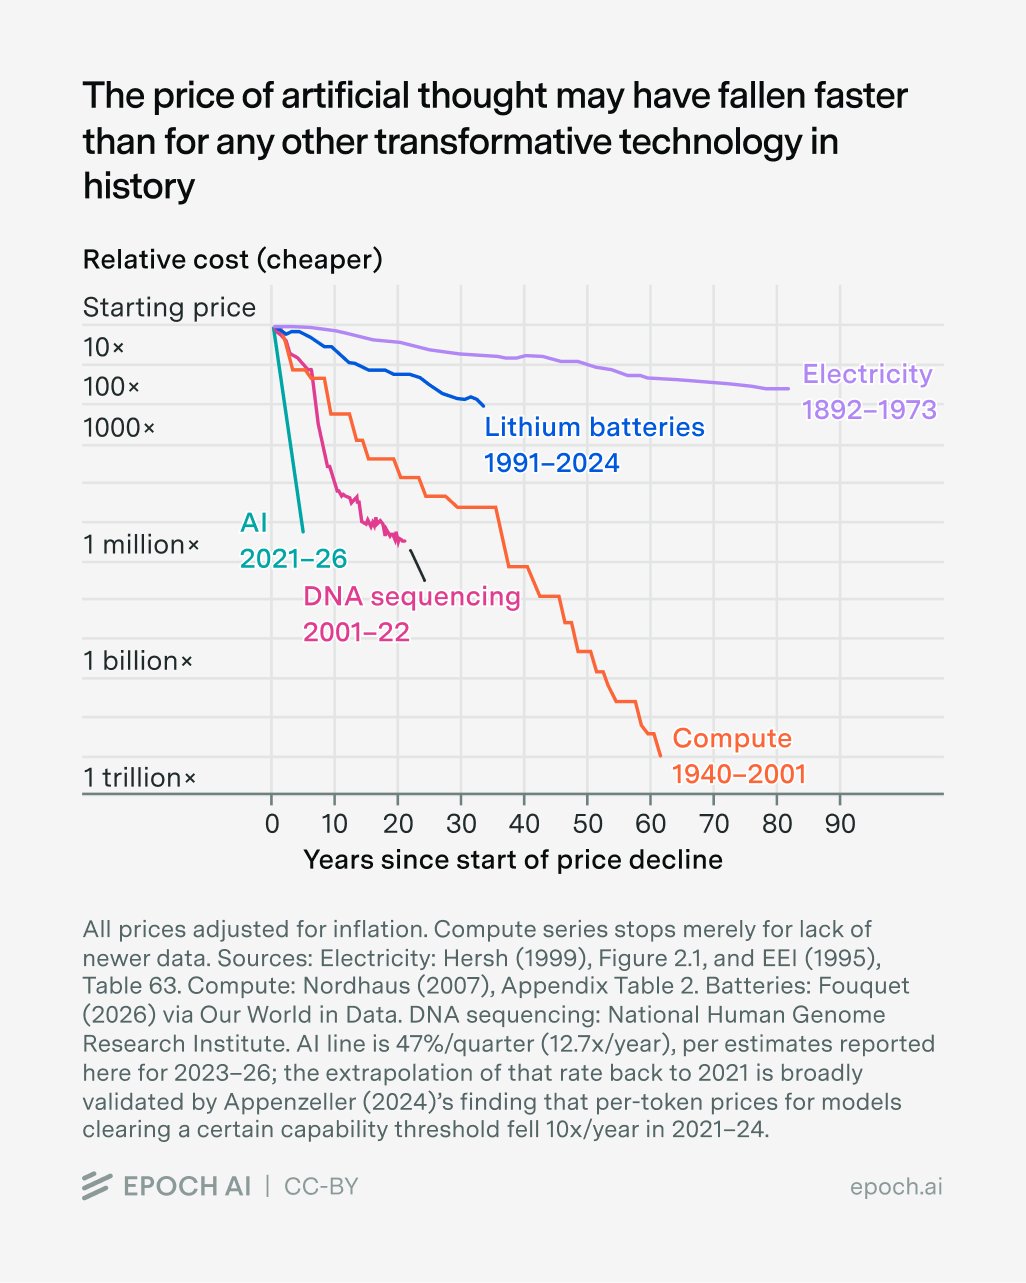
Epoch AI는 수학·과학·체스 등 다섯 가지 시험에서, 각 점수대를 처음 넘긴 모델과 나중에 같은 점수를 더 싸게 넘긴 모델의 가격을 이어 붙여 곡선을 그렸습니다.
값이 가장 빨리 떨어지는 때는 새 능력이 막 나온 직후로 분기당 66%이고, 2년이 지나면 32%로 느려집니다. 한 모델이 비싼 값을 받을 수 있는 기간이 그만큼 짧다는 뜻입니다.
그 밖에: 보고서는 한계도 적었습니다. 시험 성적이 실제 업무 능력을 그대로 대신하지 못하고, 모델이 알려진 시험에 맞춰 훈련됐을 가능성이 있으며, 자료가 3년치뿐입니다. 평균 내는 방식에 따라 42.9~58.0% 사이에서 값이 달라집니다.
시사점: 작년에 비싸서 접어 둔 자동화가 있다면 올해는 계산이 달라졌을 수 있습니다. 가격 때문에 미뤄 둔 계획은 분기마다 다시 확인하는 편이 낫습니다.
#AI비용 #EpochAI #벤치마크
출처 2🚀 @EpochAIResearch🔥 @kimmonismus
7. Bug Hunt Bench 실측: GPT-6 Sol은 값이 가장 쌌지만 심어 둔 버그 105개 중 29.3개만 고쳤다
- Bug Hunt Bench는 제품 관리자용 뉴스레터를 쓰는 Paweł Huryn 한 사람이 운영하는 개인 벤치마크입니다. 실제 저장소 두 곳에 버그 105개를 몰래 심어 두고 모델에게 찾아 고치게 시키며, 같은 조건으로 여러 번 돌린 평균이라 점수가 29.3처럼 소수로 나옵니다.
- 9월 23일자 순위표에서 GPT-6 Sol(가장 오래 생각하게 한 설정)은 105개 중 29.3개를 고쳐 상위권과 멀었습니다. 같은 설정의 GPT-6 Astra는 45개, Claude Opus 5.5는 41.7개였습니다.
- 대신 값은 가장 쌌습니다. 같은 일을 API 값으로 환산하면 GPT-6 Sol은 9.33달러, Astra는 33.03달러, Opus 5.5는 58.53달러가 들었습니다.
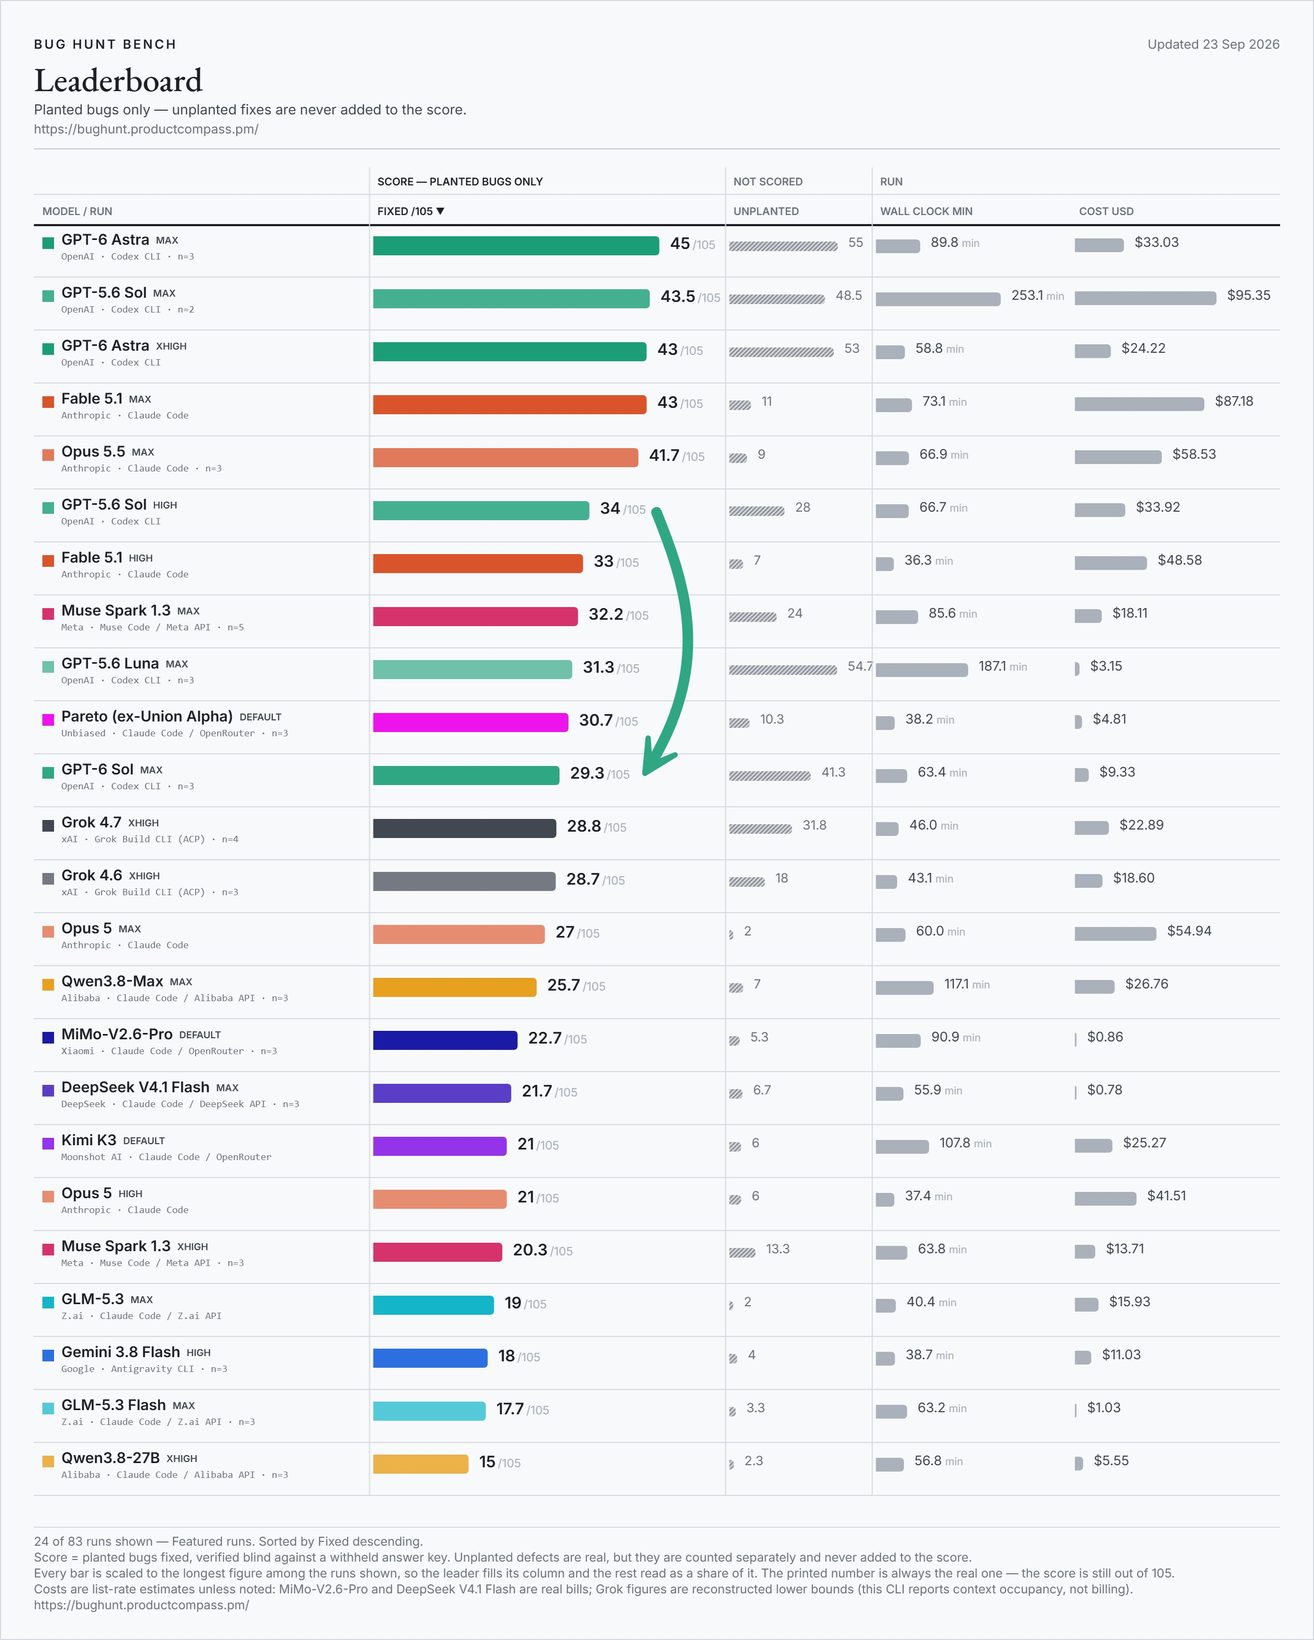
어제 이 자리에서 다룬 소식은 OpenAI가 GPT-6 Sol의 API 값을 절반으로 내렸다는 것이었습니다. 하루 뒤 같은 사람이 같은 방식으로 재서 정반대 신호를 냈습니다. 직전 세대인 GPT-5.6 Sol은 같은 시험에서 43.5개를 고쳤는데, 값은 95.35달러로 열 배 넘게 비쌌습니다. 값과 성적이 함께 내려간 셈입니다.
채점은 모델이 본 적 없는 정답지를 두고 별도의 심사가 바뀐 코드를 대조하는 방식이고, 심어 두지 않은 버그를 고친 것은 점수에 넣지 않습니다. GPT-6 Sol은 그렇게 따로 센 수정이 41.3개로 적지 않았지만, 시험이 요구한 곳은 아니었습니다.
그 밖에: Mark Kretschmann은 반응이 엇갈린다며, 값은 분명 좋지만 성능은 Astra나 Opus 5.5 근처에도 못 간다는 평이 많다고 적었습니다. 순위표에 적힌 비용도 대부분 정가 기준 추정값입니다.
시사점: 값을 내렸다는 발표와 일을 잘한다는 측정은 따로 확인해야 합니다. 다만 이 표는 한 사람이 돌린 결과이니 공식 순위로 읽지 말고, 자기 작업으로 한 번 재 보는 편이 낫습니다.
#BugHuntBench #GPT6Sol #AI코딩
출처 3💬 @PawelHuryn💬 @PawelHuryn💬 @mark_k
8. CAIS가 Humanity's Last Exam 정제판 HLE-Diamond를 내놨다 — 오류를 1년간 걸러 낸 시험에서 GPT-6 Astra가 60.6%로 가장 높았다
- Center for AI Safety(AI 위험을 연구하는 비영리 기관)와 Scale AI가 9월 23일 HLE-Diamond를 공개했습니다. 전문가들이 출제한 초고난도 시험 Humanity's Last Exam 2,500문제에서 1년간 오류를 걸러 내고 1,000문제만 남긴 정제판입니다.
- 남은 문제는 추론 500개와 지식 500개로 반씩 나뉘고, 검색이나 코드 실행 없이 아는 것만으로 푸는 상태를 기준 점수로 삼습니다.
- 정제판 1위는 GPT-6 Astra 60.6%, 2위는 Claude Opus 5.5 55.0%입니다. 기존 HLE에서 1위는 61.4%의 Claude Opus 5.5였습니다.
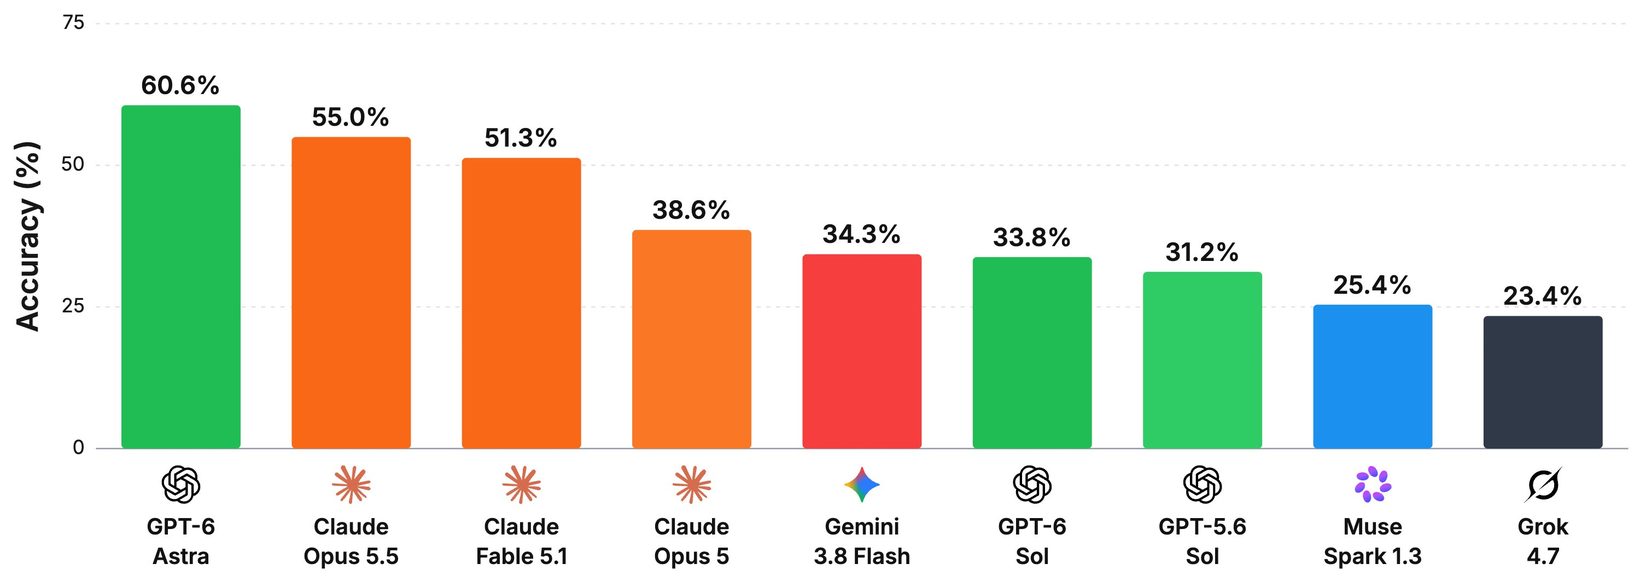
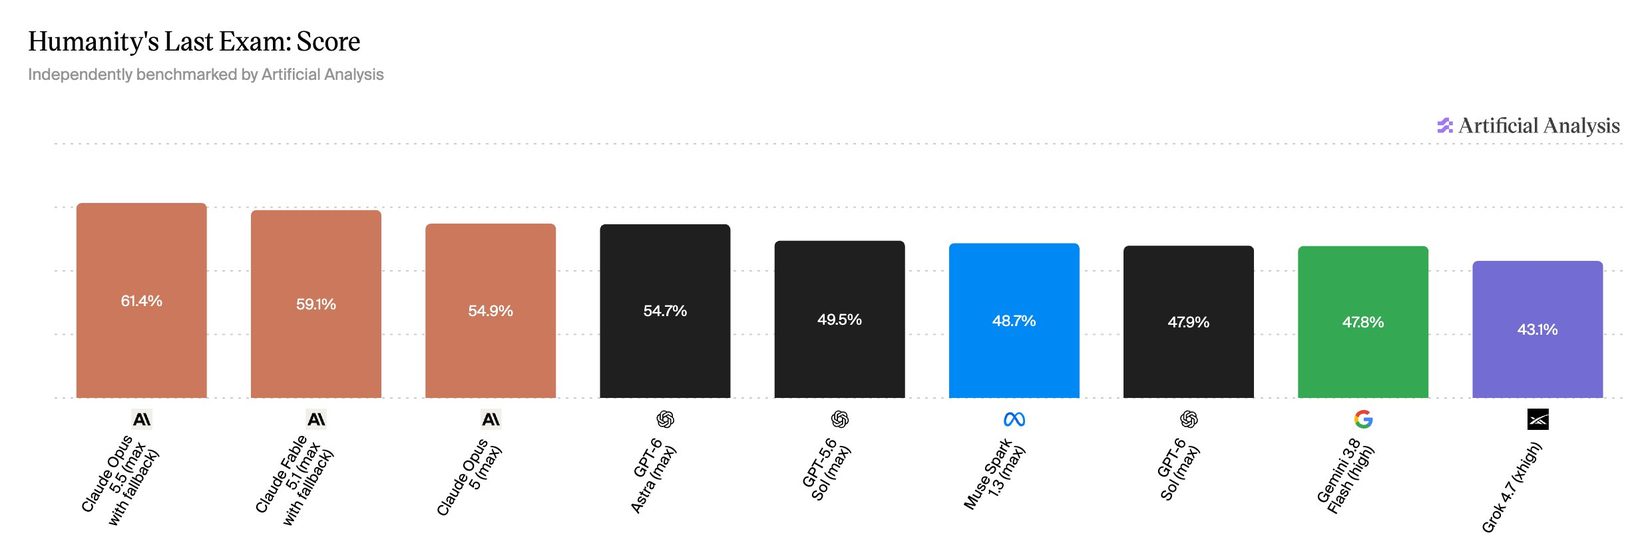
시험 문제에 오답 표기나 모호한 질문이 섞여 있으면, 점수는 모델의 실력이 아니라 그 결함을 얼마나 잘 넘겼는지를 함께 재게 됩니다. CAIS는 시험을 만든 곳이면서 그 결함을 1년에 걸쳐 스스로 걷어냈고, 그 결과 맨 앞자리가 바뀌었습니다. 다만 두 점수를 그대로 빼서 비교하기는 어렵습니다. 정제판 점수는 CAIS가 직접 발표한 값이고, 기존 HLE 점수는 Artificial Analysis가 따로 측정하면서 모델마다 추론 강도 설정을 다르게 붙인 값이기 때문입니다.
그 밖에: 검색과 코드 실행을 허용하면 GPT-6 Astra는 60.6%에서 82.9%로 올라갑니다. Simon Smith는 도구를 붙이면 정제판도 이미 포화, 즉 점수가 천장에 닿아 모델끼리 구분이 안 되는 상태에 가까워지고 있다고 지적했습니다.
시사점: 벤치마크 점수는 모델의 실력만 재는 것이 아니라 시험지의 품질도 같이 잽니다. 모델 순위표를 볼 때는 몇 점인지보다 누가 어떤 조건에서 쟀는지를 먼저 확인하는 편이 안전합니다.
#HLEDiamond #벤치마크 #모델평가
9. Forecasting Research Institute가 4년치 AI 예측을 채점했다 — 능력은 예상보다 빨리 왔고 확산 예측은 양쪽으로 엇갈렸다
- 예측의 정확도를 연구하는 비영리 기관 Forecasting Research Institute(금)가 2022년 중반부터 2026년 8월까지 자사 조사에서 모은 AI 예측을 9월 23일 중간 채점해 공개했습니다.
- AI가 국제수학올림피아드 금메달 수준에 오른 건 2025년 7월인데, 전문가 중앙값은 2030년, 과거 예측 성적으로 뽑은 슈퍼포캐스터는 2035년으로 봤습니다. 각각 5년·10년 늦게 잡은 셈입니다.
- 반대로 부풀려 잡은 항목도 있습니다. 생물보안 전문가들은 이공계 대학생 표본의 22.5%가 위험 실험 과제를 끝낼 것으로 봤지만 실제는 5.2%였고, 자율주행 택시 보급도 예측보다 느렸습니다.
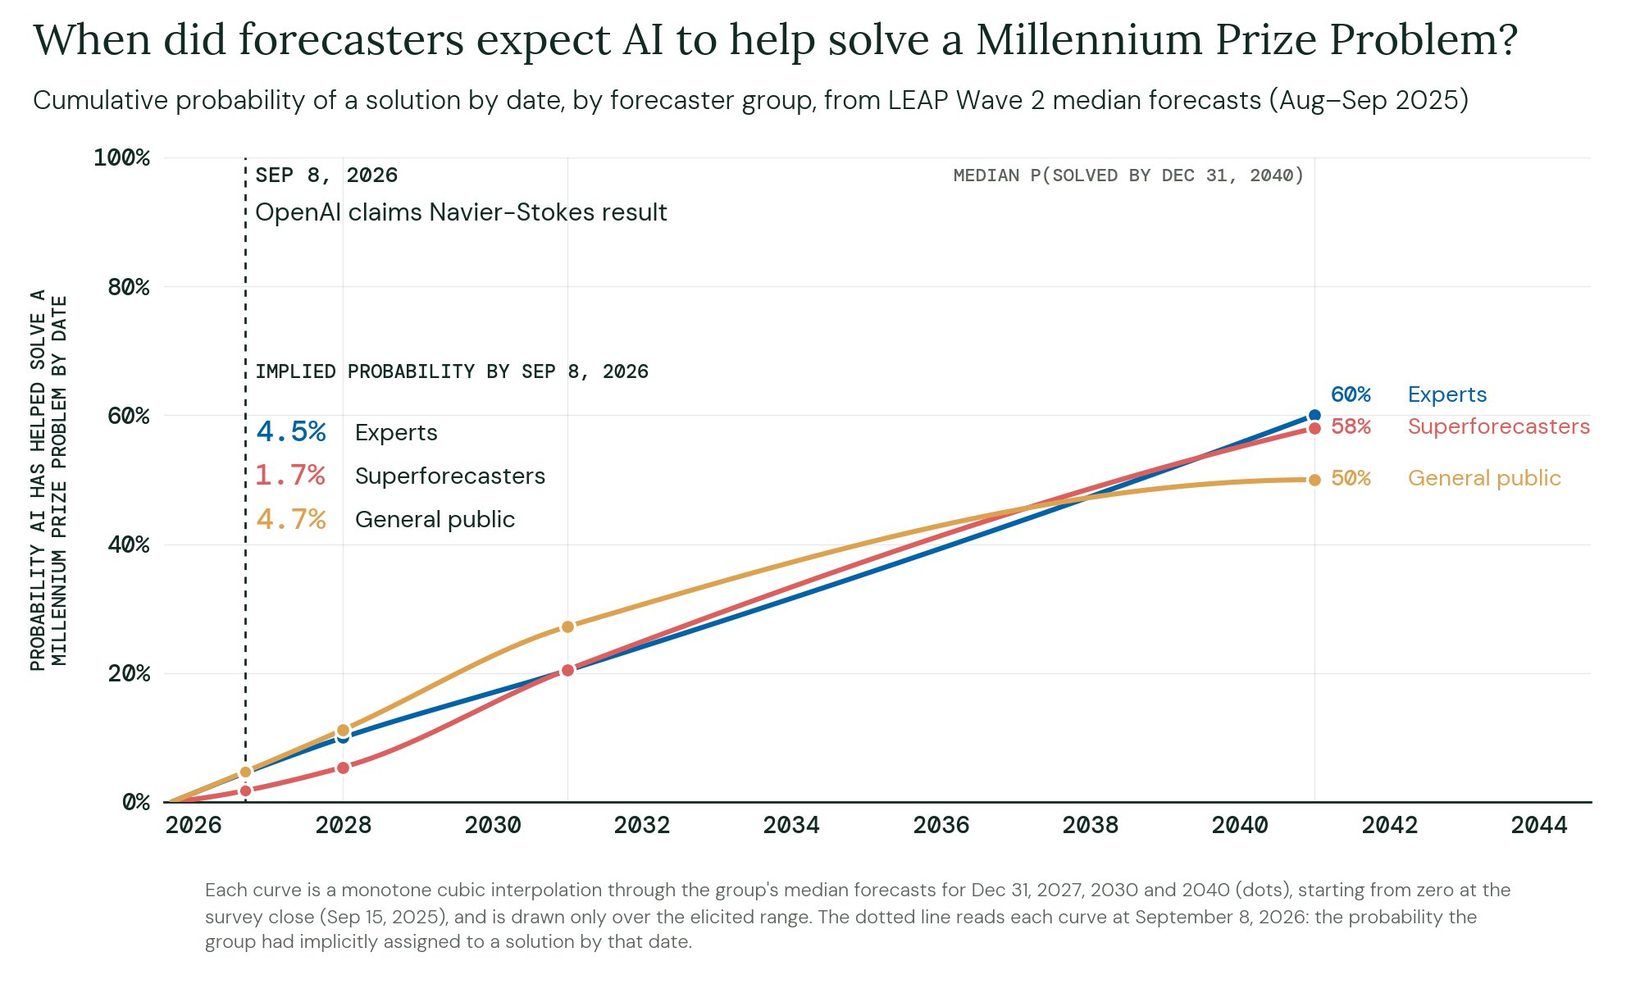
매출은 반대로 크게 과소평가됐습니다. 부풀려 잡은 게 아니라 한참 낮춰 잡은 쪽, 앞의 국제수학올림피아드와 같은 계열입니다.
FRI의 이전 조사에서 전문가들은 2026년 말 기준으로 AI 기업 한 곳이 올릴 수 있는 최대 연환산 매출(지금 속도가 1년 이어진다고 볼 때의 매출)을 200억 달러, 슈퍼포캐스터는 250억 달러로 봤습니다. FRI가 9월 22일 기준으로 집계한 실제 값은 약 1,000억 달러로, 예측의 4~5배입니다. 다만 AI가 쓰는 전기 비중처럼 예측이 맞아 가는 항목도 있어, FRI는 확산 지표의 성적은 엇갈린다고 정리했습니다.
그 밖에: 그래프에는 OpenAI가 9월 8일 밀레니엄 문제 중 하나인 Navier–Stokes 방정식 관련 결과를 주장한 날이 점선으로 표시돼 있습니다.
시사점: 능력은 예상보다 빨리 왔고, 확산 쪽은 매출처럼 크게 낮춰 잡은 것과 자율주행처럼 부풀려 잡은 것이 섞였습니다. AI 일정표를 읽을 때 누가 말했는지만 보지 말고 그 사람이 지난번에 어느 쪽으로 얼마나 틀렸는지를 함께 보는 편이 안전합니다.
#AI예측 #FRI #벤치마크
출처 1🚀 @Research_FRI
10. 🆕 그 밖의 신기능·신제품
- OpenAI가 GPT-6 API의 프롬프트 캐싱(같은 지시문을 반복해 보낼 때 앞부분을 재사용하는 기능)을 손봤습니다. 기본 적중률을 올려 재사용된 입력에 최대 90% 할인이 붙고, 적중률을 보는 대시보드가 생겼습니다.
- Gemini 앱이 Adobe·Squarespace·Peloton 등 외부 앱과 연결됐고, Cognition의 코딩 에이전트 Devin은 Microsoft Teams에서 바로 부를 수 있게 됐습니다. 메일·일정·파일을 읽는 Microsoft 365 연동도 열렸습니다.
- Epoch AI는 반쯤 조립한 가구 사진과 설명서를 주고 틀린 곳을 찾게 하는 시험을 공개했습니다. 1위 점수가 10개월 만에 28%에서 80%로 올랐습니다.
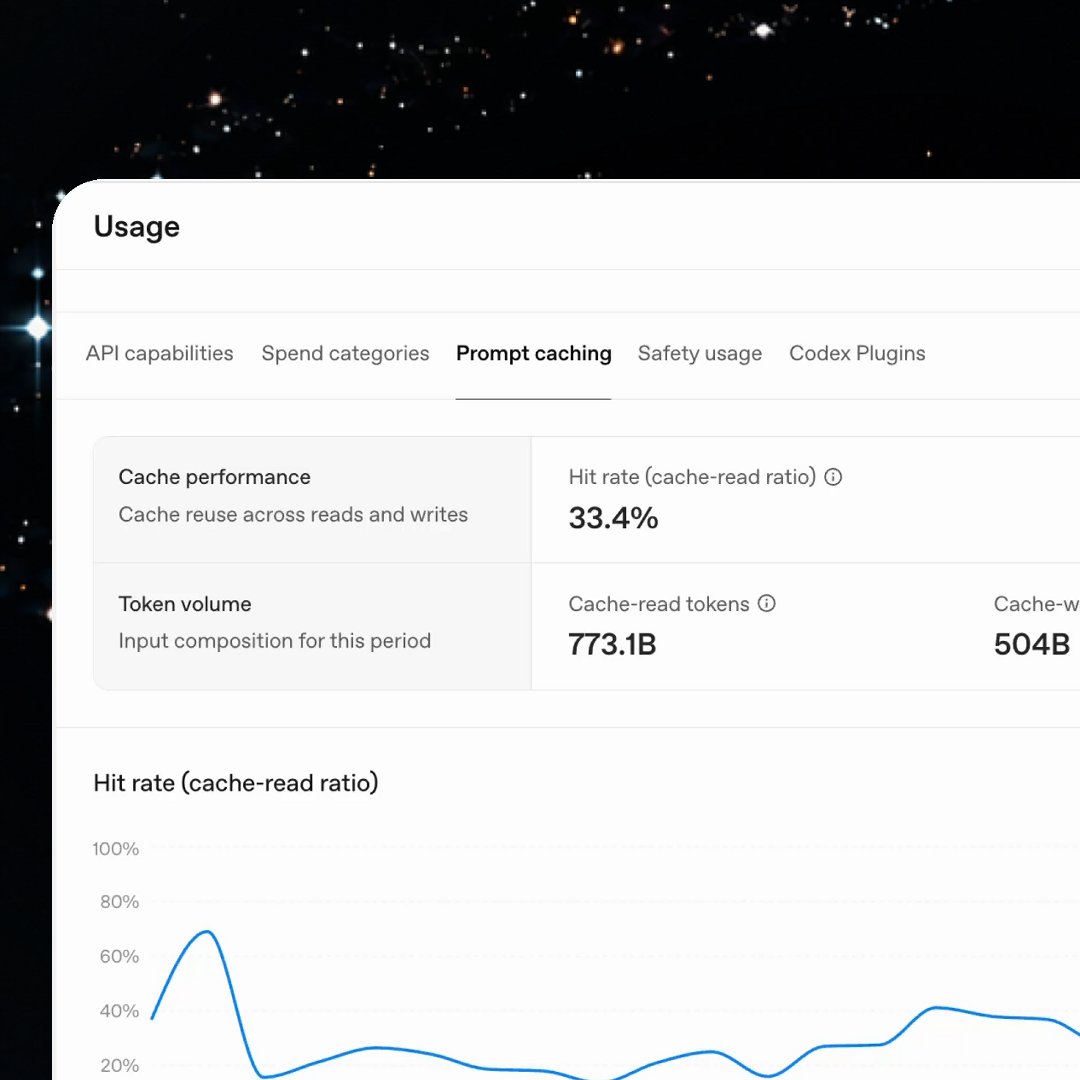
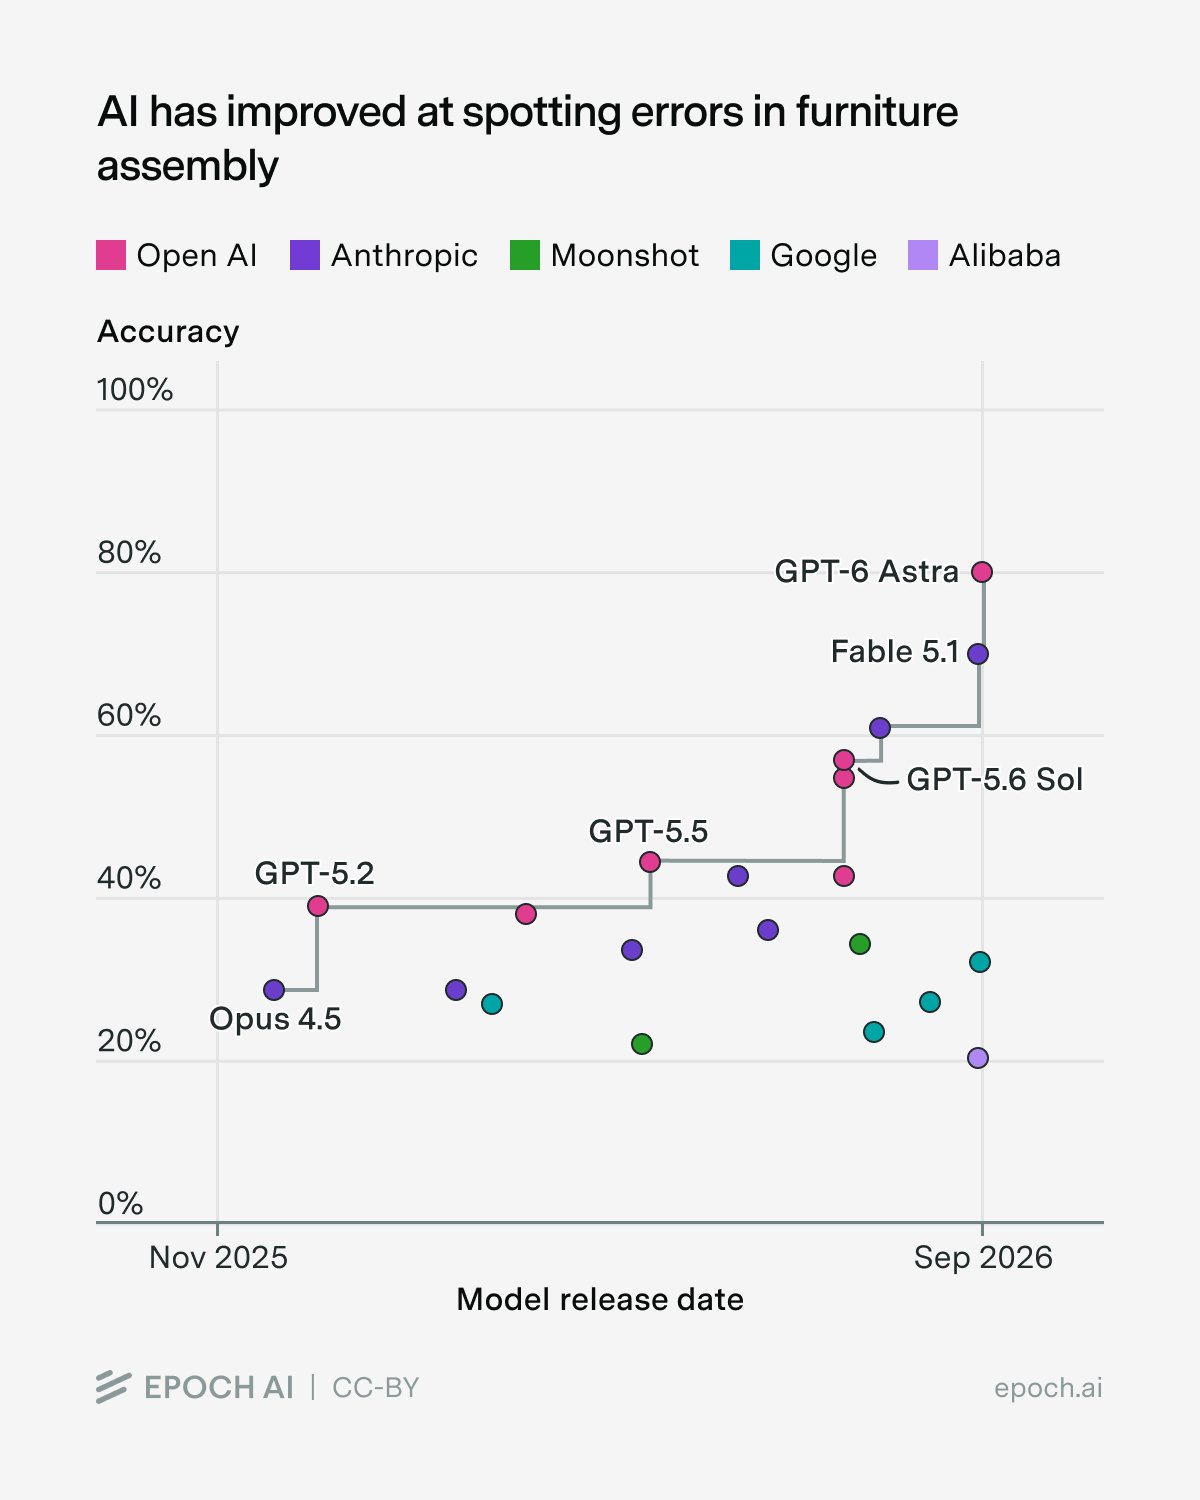
에이전트는 같은 지시문을 수십 번씩 다시 보내서 입력 비용이 대화형 사용보다 큽니다. OpenAI가 할인과 함께 대시보드를 내놓은 점이 눈에 띕니다. 얼마나 아꼈는지 볼 수 없으면 캐싱은 손댈 수 없는 항목으로 남습니다.
그 밖에: Apple은 문서 이미지를 압축해 읽다가 필요한 쪽만 펼쳐 보는 LensVLM-9B를 공개했고, 추론 서버 vLLM은 v0.30.0을 냈습니다. PhAI Labs는 막 공개한 과학 연구용 에이전트 작업공간 ScienceBuddy를 GPT-6 무료 사용 조건으로 열었고, Husky 추론 엔진은 MacBook에서 초당 730토큰을 주장했습니다.
시사점: 오늘의 작은 발표들은 모델을 키우기보다 이미 있는 모델을 더 싸게, 더 가까운 곳에서 돌리는 쪽에 몰렸습니다.
#프롬프트캐싱 #에이전트연동 #벤치마크
출처 8🔥 @OpenAIDevs💬 @GeminiApp🚀 @cognition💬 @HuggingPapers🚀 @vllm_project💬 @PhAILabs🔥 @EpochAIResearch🔥 @elliotarledge
오늘의 감정·온도
오늘의 실무 팁 — 쉽게 풀어 쓴 사용법 6가지
- 반복되는 지시문은 앞쪽에 몰아 둔다. OpenAI가 같은 지시문의 앞부분을 다시 쓰는 기능인 프롬프트 캐싱의 할인을 최대 90%까지 올렸습니다. 매번 바뀌는 내용은 뒤로 빼고 늘 같은 안내문을 앞에 두면 재사용되는 구간이 길어집니다.
- 작년에 비싸서 접은 자동화는 분기마다 다시 계산한다. 같은 성적을 내는 값이 분기마다 47%씩 떨어졌다는 측정이 나왔습니다. 예산 때문에 미뤄 둔 목록을 따로 두고 석 달에 한 번 값만 다시 넣어 보세요.
- 순위표는 점수보다 '누가 어떤 조건에서 쟀는지'를 먼저 본다. 같은 시험이라도 만든 곳이 직접 발표한 값과 외부 측정기관이 잰 값은 설정이 달라 그대로 빼서 비교할 수 없습니다. 발표문에서 측정 주체와 추론 강도 설정을 찾아보고, 없으면 참고값으로만 두세요.
- 목소리를 복제하기 전에 동의 확인과 지역 제한을 본다. Gemini 3.8 Flash TTS는 30초 샘플로 특정인 목소리를 흉내 낼 수 있지만 본인 동의 확인을 거쳐야 하고 유럽경제지역·영국 등에서는 막혀 있습니다. 쓰려는 지역과 대상부터 확인한 뒤 기획하세요.
- 휴대폰을 대신 조작하는 AI는 되돌릴 수 있는 일부터 시킨다. 화면을 눌러 진행하는 방식은 성공률이 회사 발표 기준 90%라 열에 하나는 중간에 멈춥니다. 결제나 발송처럼 되돌리기 어려운 작업 대신 검색·정리·예약 확인부터 맡겨 보세요.
- 도구를 여러 개 붙일 땐 한곳에서 파는지부터 확인한다. Claude Marketplace처럼 커넥터와 유료 에이전트를 한 화면에서 고르면 계약과 결제를 도구마다 새로 트지 않아도 됩니다. 이미 쓰는 업무 도구가 목록에 있는지 먼저 보고 없을 때만 직접 연결을 검토하세요.
📦 확인 방식
수치는 각 회사의 공식 발표문과 모델 카드, 그리고 Epoch AI·Center for AI Safety처럼 밖에서 재는 곳이 공개한 자료에서 가져왔습니다. 회사가 스스로 잰 값과 개인이 혼자 돌린 측정값은 본문에 그렇게 밝혀 두었으며, 오늘 자 발표 대부분은 외부 독립 검증 전입니다.
🏷 라벨 가이드 — 🔥 화제 · 🔖 저장이 많은 글 · 🔁 퍼나름이 많은 글 · 💬 댓글이 많은 글 · 🚀 작은 계정에서 빠르게 퍼진 글