AI 브리핑 ·
Meta도 프론티어 모델 경쟁에 합류
5분 브리핑
약 2분 · 5개 흐름핵심만 먼저 읽고, 궁금한 소식은 본문으로 이어 보세요.
전체 분석 12분으로 바로 가기 ↓- Meta Muse Wonder 공개…구독 전용 Full과 API판의 차이
Meta가 10월 12일 새 모델 계열 Muse Wonder를 공개했습니다. Meta가 낸 Artificial Analysis 종합 점수(독립 평가 회사가 여러 시험을 묶어 매기는 점수) 차트에서 상위판 Wonder Full은 56점으로 Claude Opus 5.5(58점) 다음입니다.
- Codex 기본 컨텍스트 50만 토큰…수동 설정과의 차이
OpenAI Codex 담당 Tibo가 미국 시간 11일 '7일째' 공지를 냈습니다. Codex와 ChatGPT의 업무용 기능 Work에서 GPT-6.1 Sol의 기본 컨텍스트(AI가 작업 중 한 번에 기억해 두는 대화·코드의 양)를 27.2만에서 50만 토큰으로, 약 80% 늘렸습니다.
- Karpathy가 본 AI 경험의 격차…2,000만 명은 추정입니다
OpenAI 창립 멤버였던 Andrej Karpathy가 한국 시간 12일 새벽, 지난 4월에 쓴 글을 다시 꺼냈습니다. AI가 무엇을 할 수 있는지에 대한 사람들의 이해 차이가 좁혀지기는커녕 벌어지고 있다는 내용입니다.
- GPT-6가 GLM-5.3의 잘못된 접속을 멈춘 개인 실험
보안 연구자 Johann Rehberger가 개인 실험실에서 GLM-5.3 에이전트(스스로 작업을 이어 가는 AI 프로그램)에게 밤새 시험용 프로그램을 만들게 하고, GPT-6에게는 엇나가면 멈추라는 감시 역할을 맡겼습니다.
- 🆕 그 밖의 신기능·신제품 — Pelican(iPhone 에이전트)·NVIDIA와 Cisco의 USFP·River AI 사내 맞춤 모델·Code Video Model
개발자 설명에 따르면 Pelican은 휴대폰이 잠겨 있어도 뒤에서 일하는 iPhone용 AI 에이전트입니다. 원하는 회사의 모델을 골라 쓸 수 있고, TestFlight(Apple의 시험판 배포 앱)로 소수에게 열었습니다.
주요 키워드 TOP 5: Muse Wonder · GPT-6.1 Sol 50만 토큰 · Karpathy · 에이전트 감시 · Pelican
메인 이벤트: Meta가 Muse Wonder를 공개했습니다. Artificial Analysis에 올라온 점수는 Full 56점, API판 52점입니다.
오늘 수집에서 확인한 새 프론티어 모델 출시는 Meta의 Muse Wonder였습니다. Meta가 공개한 차트에는 상위판 Wonder Full이 Artificial Analysis 종합 점수 56점으로 Claude Opus 5.5(58점) 다음에 놓여 있습니다. 아침 원고를 검토할 때는 평가 사이트에 없었지만, 발행 전 다시 확인하니 Full 56점과 API판 Wonder 52점이 모두 올라와 있었습니다. 같은 점수를 받은 다른 모델도 있어 Full만 단독 2위라고 부를 수는 없습니다. X에서는 'Meta가 돌아왔다'는 호평과 '점수만 맞춘 모델'이라는 비판이 함께 퍼졌습니다. 공식 확인이 없는 다음 모델 출시설은 다루지 않았습니다.
이 호는 13일 새벽 4시까지 수집한 소식을 바탕으로 작성하고, 늦은 발행에 앞서 주요 발표와 평가 사이트를 다시 확인했습니다.
1. Meta Muse Wonder 공개…구독 전용 Full과 API판의 차이
- Meta가 10월 12일 새 모델 계열 Muse Wonder를 공개했습니다. Meta가 낸 Artificial Analysis 종합 점수(독립 평가 회사가 여러 시험을 묶어 매기는 점수) 차트에서 상위판 Wonder Full은 56점으로 Claude Opus 5.5(58점) 다음입니다. 다만 Full은 Meta의 코딩 도구 Muse Code 구독자만 쓰고, 개발자 창구인 Meta Model API로 바로 쓰는 Wonder는 52점입니다.
- Meta가 내세운 기능은 둘입니다. Active Memory는 대화가 바뀌어도 사용자에 관한 중요한 맥락을 기억해 꺼내 쓰고, Active Focus는 막히면 다른 방법을 찾고 중요한 행동 전엔 사용자에게 확인하며 어려운 목표를 끝까지 붙듭니다.
- 반응은 갈렸습니다. Shopify CEO Tobi Lütke는 호평했고, 점수만 잘 나오게 다듬었다는 '벤치 맞춤' 비판이 함께 나왔습니다. 출시 직후 생긴 사용 한도 오류는 Meta의 Alexandr Wang이 인정했습니다.
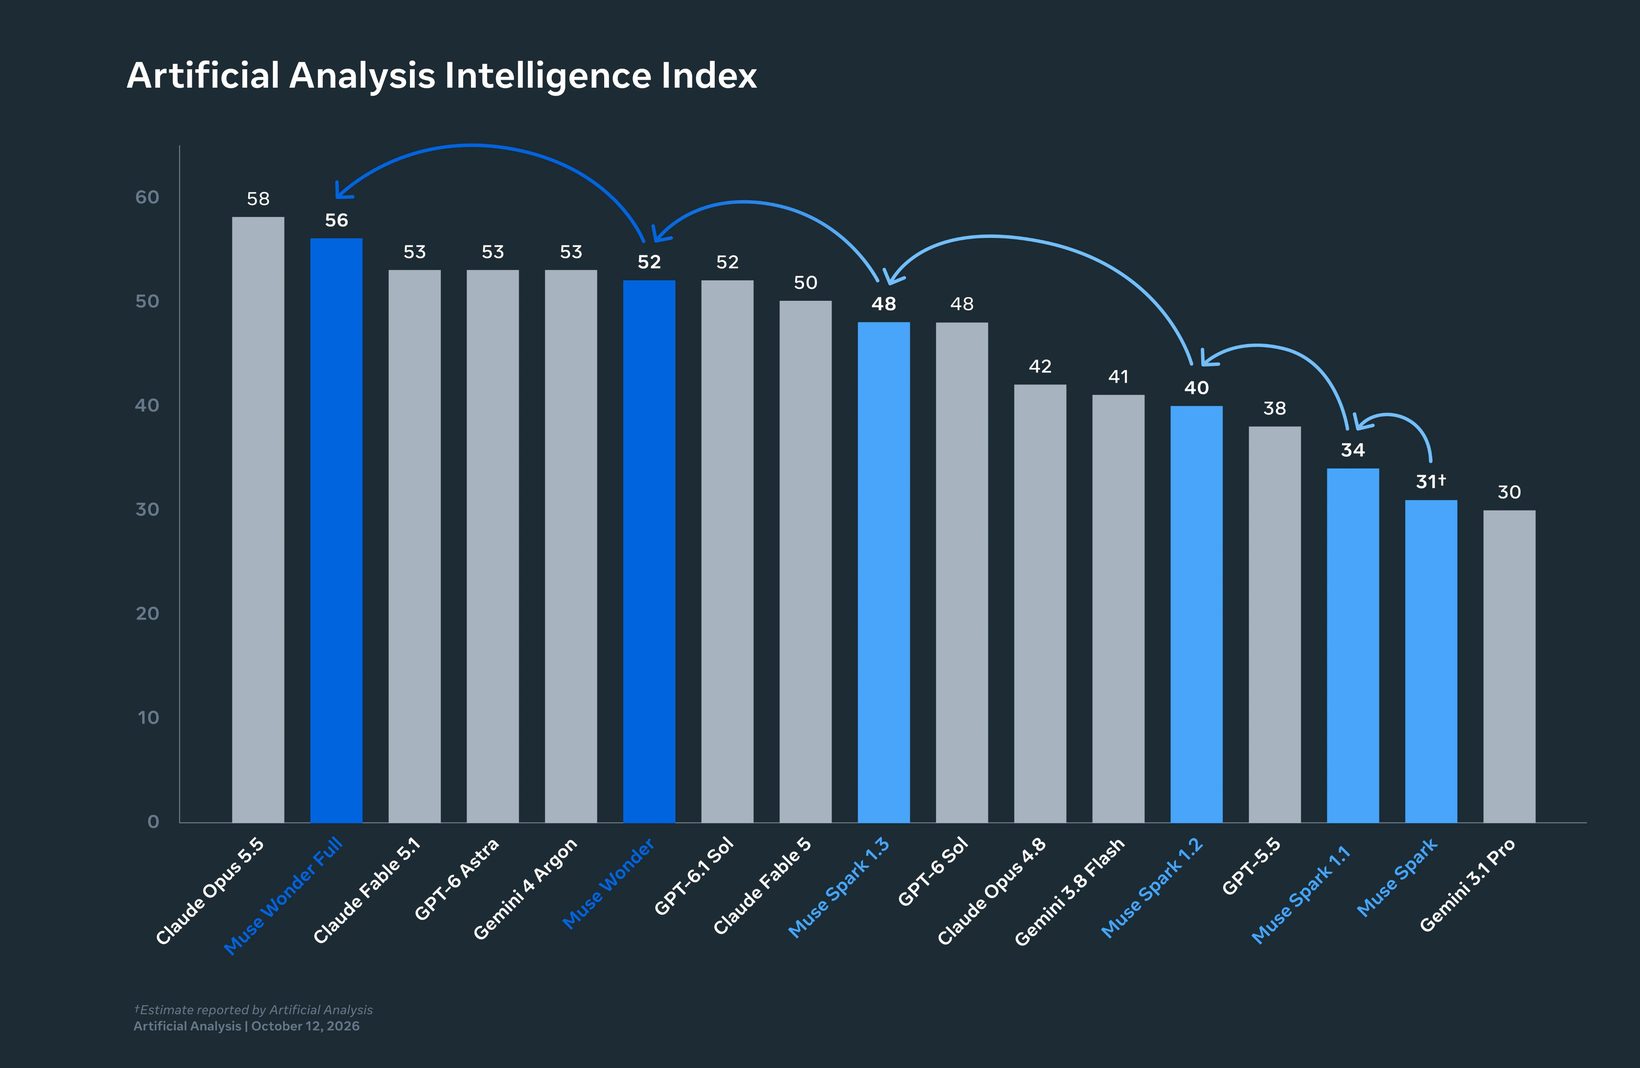
Llama 4 이후 최상위 모델 경쟁에서 밀렸다는 평을 듣던 Meta가 Anthropic·OpenAI·Google과 겨룰 만하다고 내세운 날입니다. 공식 블로그는 법률 업무 시험 Harvey LAB, 큰 소프트웨어 프로젝트를 오래 붙드는 시험 SWE-Marathon, 자체 시험 FocusBench에서 최고 수준이라고 적었습니다. 모델 카드는 종합 점수의 출처를 Artificial Analysis라고 밝혔습니다. 아래 확산 차트의 '아직 미등재'는 당시 화면의 단서입니다. 발행 전 평가 사이트에는 Full 56점과 Wonder 52점이 올라와 있었습니다. 다만 Full의 비용·속도 칸은 비어 있어 점수만으로 실제 작업 비용을 비교하기는 어렵습니다.
모델 카드는 비교의 한계도 직접 적었습니다. Meta가 직접 돌린 경쟁 모델은 설정을 최적으로 맞추지 못했을 수 있고, SWE-Marathon은 모델마다 쓴 도구가 달라 같은 조건 비교가 아니라고 했습니다.
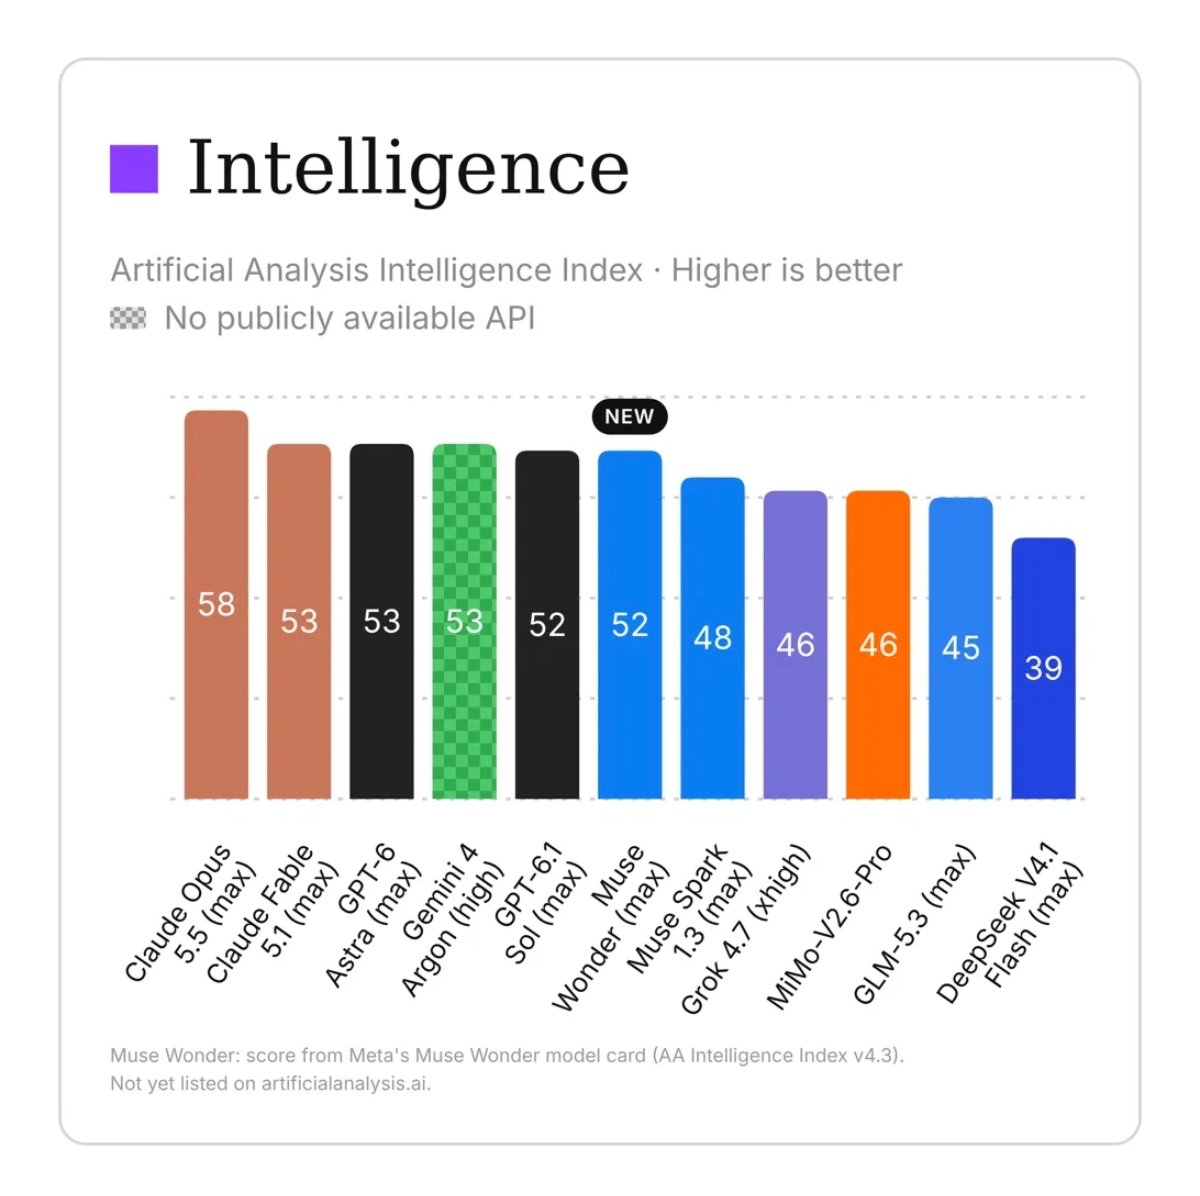
X의 반응은 둘로 나뉩니다. 일부는 Opus 5.5까지 넘었다고 적었지만 Meta 차트에서도 Opus 5.5가 2점 위입니다. Tobi Lütke는 다른 최상위 모델이 실패한 과제를 던져 봐도 이 모델이 막히는 걸 찾기 어려웠다며 Meta가 돌아왔다고 적었습니다. SWE-Marathon 결과를 두고 긴 코딩 작업에 강하다는 글도 붙었습니다.
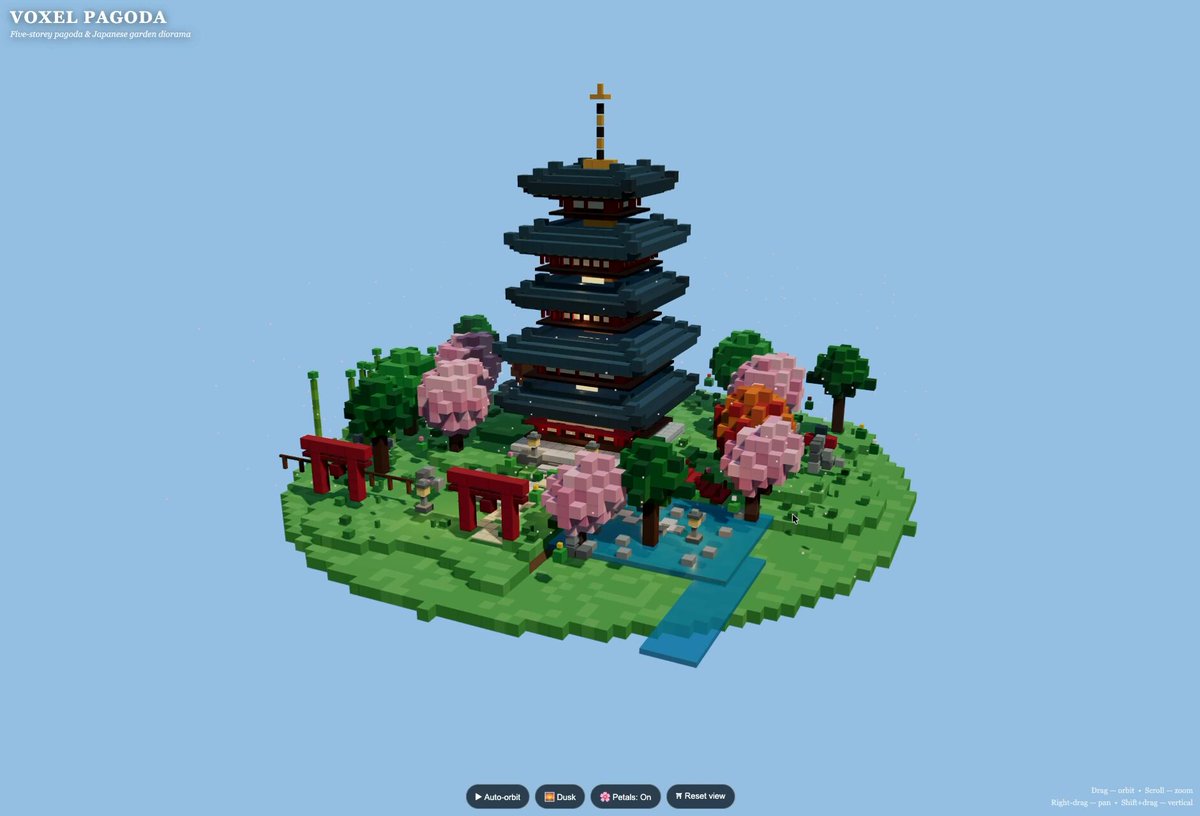
반대편에선 Meta가 곳곳에 내건 점수는 Full의 것인데 정작 API에선 52점짜리 Wonder만 쓸 수 있다는 지적이 나왔습니다. Wonder로 만든 Minecraft 복제 게임이 기대에 못 미쳤다는 글을 인용하며 '벤치 맞춤이 확인됐다'고 적은 사람도 있었습니다. 모델 카드도 3D 같은 시각·공간 추론을 알려진 약점으로 꼽았습니다. 반대로 복셀 오층탑 정원을 만든 결과를 올린 사람도 있었습니다. 속도는 매우 빠른데 사용 한도를 빨리 먹는다는 후기에는 Wang이 의도와 다르게 동작하는 문제를 고치는 중이라고 답했습니다.
그 밖에: 함께 퍼진 Sensor Tower 재방문율(14일차 22.5%, ChatGPT 26.8%)은 모델이 아니라 Muse 앱의 수치입니다. Meta는 Wonder를 Muse 앱에 곧 구독자부터 넣겠다고 했습니다. 모델 카드에 적힌 한 번에 읽을 수 있는 입력 길이는 100만 토큰입니다.
시사점: Meta의 두 모델이 평가 사이트에도 올라왔습니다. 다만 대표 점수인 Full은 API에 없고 비용·속도 정보도 비어 있습니다. 직접 사용할 버전과 평가 조건을 함께 확인해야 합니다.
#Meta#MuseWonder#ArtificialAnalysis
출처 14Meta 공식 발표Meta 모델 카드Artificial Analysis 평가🔥 @tobi🔥 @IterIntellectus💬 @robj3d3💬 @TheRundownAI💬 @Layton_Gott🔥 @dummerspast39🔥 @AdamHoltererer💬 @LuminaBench🔥 @alexandr_wang💬 @kimmonismus🔥 @rishi_desai2
2. Codex 기본 컨텍스트 50만 토큰…수동 설정과의 차이
- OpenAI Codex 담당 Tibo가 미국 시간 11일 '7일째' 공지를 냈습니다. Codex와 ChatGPT의 업무용 기능 Work에서 GPT-6.1 Sol의 기본 컨텍스트(AI가 작업 중 한 번에 기억해 두는 대화·코드의 양)를 27.2만에서 50만 토큰으로, 약 80% 늘렸습니다. 토큰은 AI가 글을 잘게 나눠 세는 단위입니다.
- Tibo는 대화가 길어질 때 앞부분을 요약해 줄이는 '압축'이 덜 일어나게 하려는 조치라며, 앞으로 더 올리겠다고 했습니다. Vaibhav Srivastav도 같은 내용을 알리며 긴 작업에서 압축이 2~3배 줄어들 것이고 추가 요금은 없다고 적었습니다.
- 비판도 나왔습니다. 이용자들은 설정을 바꾸면 이미 최대 100만까지 쓸 수 있었다며, 기본값만 바꾼 것을 개선으로 내세웠다고 꼬집었습니다.
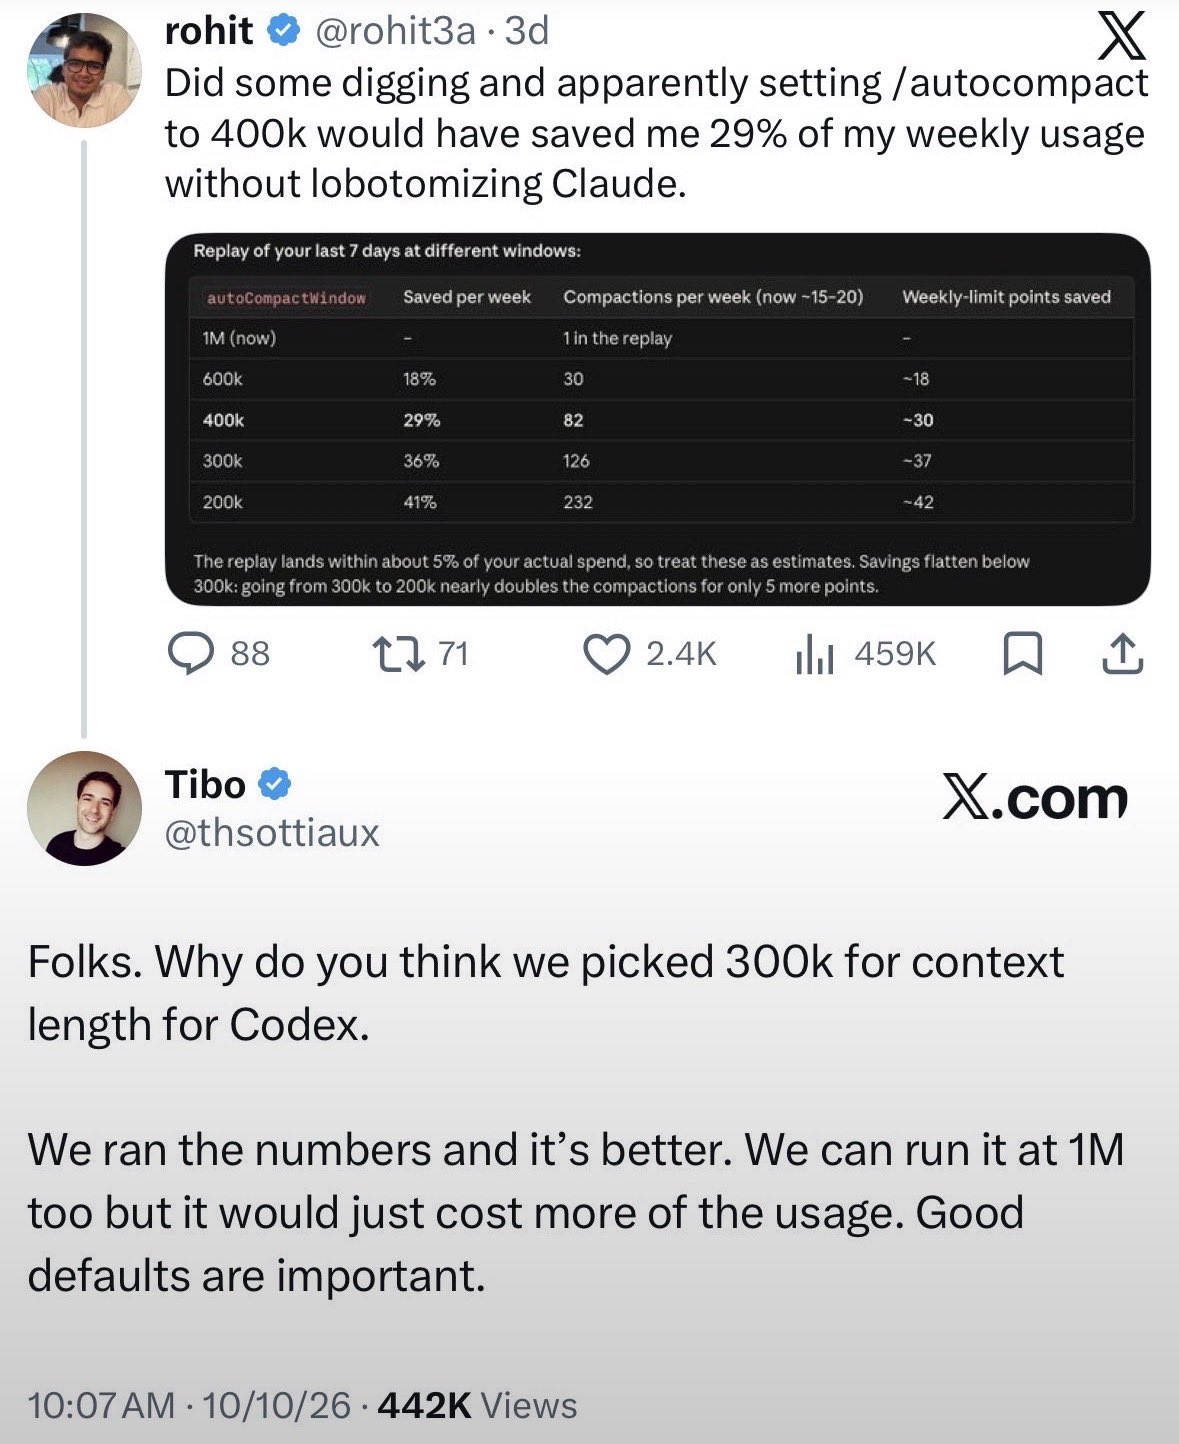
이 변화는 Codex에 긴 일을 맡기는 사람에게 직접 닿습니다. 기억할 수 있는 양이 차면 Codex는 앞부분을 요약해 자리를 비우는데, 이때 앞에서 정한 결정이나 세부가 빠질 수 있습니다. 기본값이 커지면 같은 작업을 하면서 이런 요약을 덜 거칩니다. 10일에 Tibo는 30만 근처가 낫다며 기본값을 설명했는데, 이후 이를 더 크게 올렸습니다. 이번 공지는 Codex·Work의 기본 설정 변경이며 개발자용 API 요금 변경을 알린 것은 아닙니다.
비판은 '새로 생긴 기능이 아니다'에 모였습니다. Rajath Gowda는 Codex에서 이미 수동으로 100만을 설정할 수 있었고 구독자는 원래 긴 컨텍스트 요금을 내지 않았다며, 7일째에 0점을 주고 약속대로 한도 초기화를 달라고 했습니다. Alex Getman은 첫 주를 합격 2일, 불합격 4일, 초기화 1일로 매기며 7일째를 불합격 쪽에 넣었습니다. 소식을 한국어로 정리한 퍼플에디의 글에도 값을 직접 낮추거나 최대 100만까지 올릴 수 있다는 설명이 함께 실렸습니다.
그 밖에: 한 이용자는 며칠째 Codex가 '연결이 끊겼다'는 오류로 한 시간에 한 번꼴 작업을 멈춘다며 Tibo에게 수정을 요청했습니다. 같은 문제를 겪는 사람이 많다고 했지만, 회사 쪽 답변은 확인되지 않았습니다.
시사점: Codex·Work 이용자는 설정을 바꾸지 않아도 GPT-6.1 Sol로 더 긴 작업을 한 번에 이어 갈 수 있게 됐습니다. 이미 값을 직접 올려 쓰던 사람에게는 체감 차이가 작을 수 있습니다.
#Codex#GPT61Sol#컨텍스트
출처 8OpenAI 발표 모음💬 @cherry_mx_reds🔥 @l_mejiaC💬 @buildwithrajath🔥 @purpleeddy_dev💬 @alexgetmancom💬 @rohit3a💬 @Liam06972452
3. Karpathy가 본 AI 경험의 격차…2,000만 명은 추정입니다
- OpenAI 창립 멤버였던 Andrej Karpathy가 한국 시간 12일 새벽, 지난 4월에 쓴 글을 다시 꺼냈습니다. AI가 무엇을 할 수 있는지에 대한 사람들의 이해 차이가 좁혀지기는커녕 벌어지고 있다는 내용입니다.
- 그는 세계 인구를 깔때기 모양의 네 층으로 나눈 어림셈을 내놨습니다. 약 60억 명(인구의 75%)은 LLM(ChatGPT 같은 대화형 AI의 바탕 모델)을 거의 써 보지 않았고, 10억~20억 명(약 20%)은 무료판 챗봇을 가끔 쓰는 정도입니다.
- 더 좁은 층인 약 2,000만 명(0.2%)은 수학·코딩 쪽 전문가로, 몇 주에서 몇 달 걸리던 작업을 AI 에이전트(여러 단계를 스스로 처리하는 AI)가 프롬프트 하나로 끝내는 걸 직접 겪고 있습니다. 맨 끝의 약 5,000명은 AI 연구소 안에서 내부용 최상위 시스템을 씁니다.
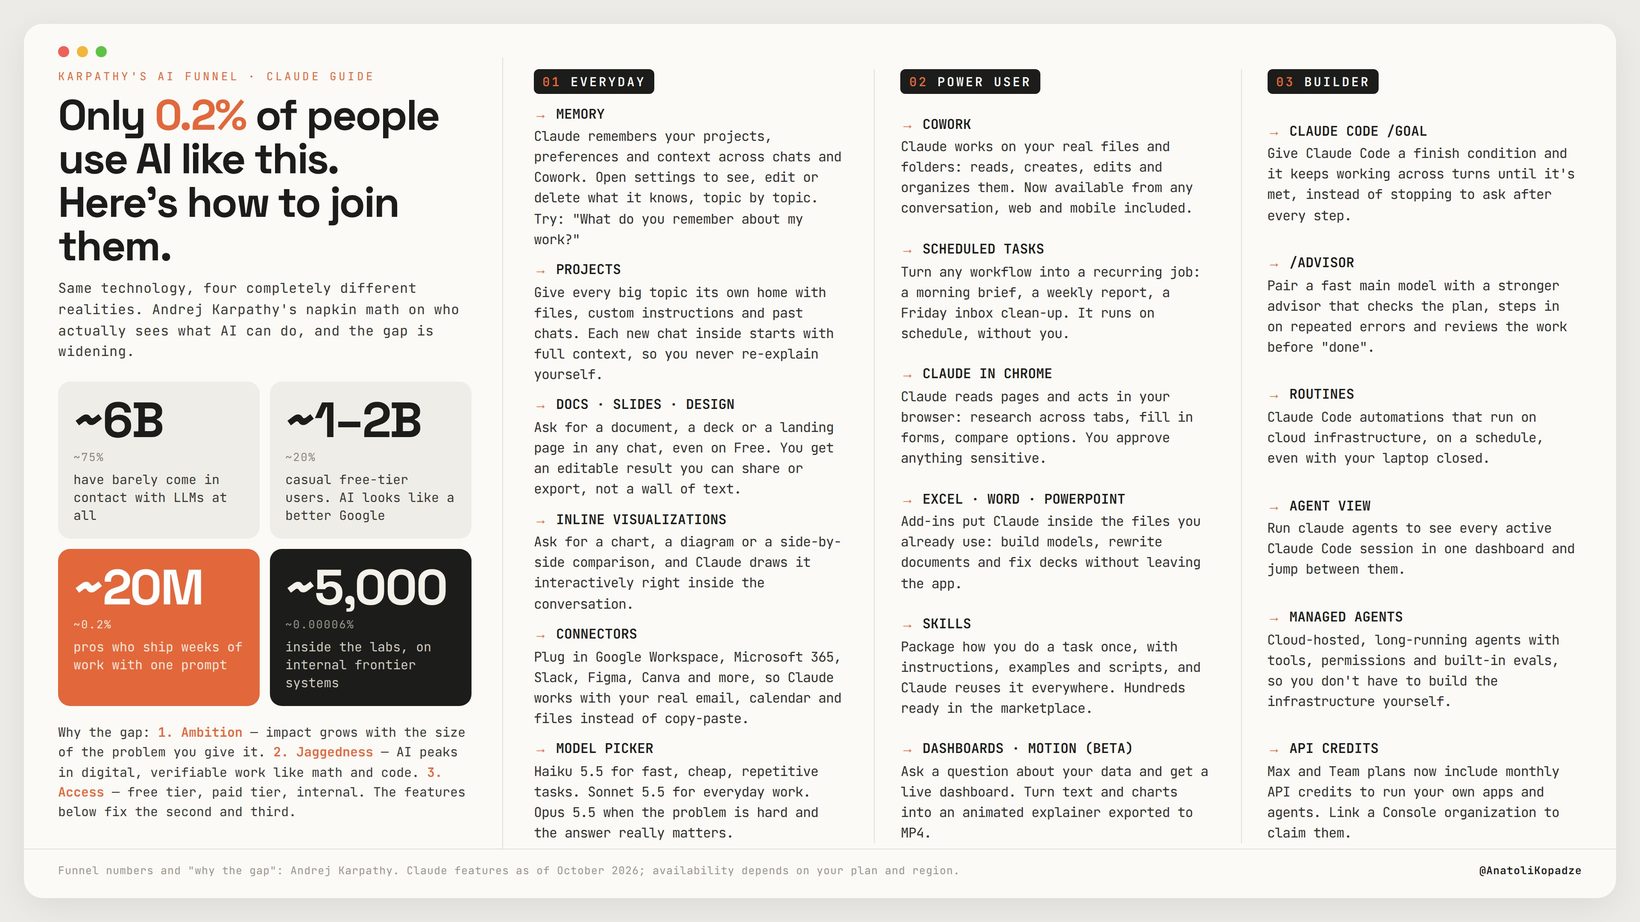
4월 글은 오래된 무료 모델만 써 본 사람과 Codex·Claude Code 같은 최신 코딩 도구를 쓰는 전문가가 서로 엇갈린 말을 한다는 두 집단 구도였습니다. Karpathy는 이번에 그 구도가 아래로 갈수록 급하게 좁아지는 깔때기가 됐다고 고쳐 말했습니다. 숫자는 그가 스스로 어림셈이라고 부른 추정이지 조사 결과가 아닙니다. 이 글은 Hacker News(개발자들이 모이는 뉴스 토론 사이트)에서도 활발히 토론됐습니다. X에서도 Mark Kretschmann과 Daniel Miessler가 원문을 인용해 최상위 AI를 직접 본 사람이 얼마나 적은지를 짚었습니다.
그가 꼽은 이유는 세 가지입니다. 첫째, AI에게 맡기는 일이 크고 길수록 효과가 커집니다. 둘째, AI 실력은 분야마다 들쭉날쭉하고 답을 확인하기 쉬운 수학·코딩에서 가장 강합니다. 그래서 수학·코딩 밖의 전문가 상당수도 무료판을 가끔 쓰는 둘째 층에 머문다고 봤습니다. 셋째, 무료판·유료판·연구소 내부판 가운데 무엇을 쓰느냐에 따라 보이는 능력이 다릅니다.
그 밖에: Karpathy는 연구소 안쪽에서 에이전트 여럿이 큰 소프트웨어 작업과 과학·수학 연구를 함께 해, 수학자들이 최전선 수학 원고 722편을 한동안 검토해야 할 만큼 사람의 검토가 속도를 못 따라가기 시작했다고 적었습니다. Box CEO Aaron Levie는 대다수가 AI를 다음 세대 검색 정도로 쓴다며, 회사가 에이전트를 업무에 들이려면 업무 방식·데이터·보안 규정부터 손봐야 한다고 덧붙였습니다.
시사점: 무료 챗봇을 몇 번 써 본 경험만으로 AI의 한계를 판단하면 실제 능력을 낮춰 보기 쉽습니다. 내가 어느 층에 있는지는 크고, 결과를 확인하기 쉬운 일을 실제로 맡겨 볼 때 드러납니다.
#Karpathy#AI격차#AI에이전트
출처 5🔥 @mark_k🔥 @AnatoliKopadze💬 @levie🔥 @DanielMiessler💬 Hacker News 토론
4. GPT-6가 GLM-5.3의 잘못된 접속을 멈춘 개인 실험
- 보안 연구자 Johann Rehberger가 개인 실험실에서 GLM-5.3 에이전트(스스로 작업을 이어 가는 AI 프로그램)에게 밤새 시험용 프로그램을 만들게 하고, GPT-6에게는 엇나가면 멈추라는 감시 역할을 맡겼습니다. 밤사이 감시 AI가 GLM을 멈췄습니다. 다만 감시 AI는 상대 기기가 접속을 거부했고 단순한 오타였을 수도 있다고 덧붙였습니다.
- 감시 AI의 설명에 따르면 GLM은 미국 태평양 시각 새벽 2시 52분쯤, 허락된 192.168.1.115가 아닌 192.168.1.1로 관리자 권한 원격 접속(root SSH) 명령을 실제로 실행했습니다. 그전에도 비슷하게 잘못 친 명령이 있었지만 실행되기 전에 실패했습니다.
- 감시 AI는 다른 대상에 접속하려 하면 멈추라는 규칙대로 GLM의 작업을 끊었고, 접속하거나 자료가 오간 흔적은 찾지 못했다고 보고했습니다. Rehberger는 12일 이 기록을 올리며 에이전트를 꼭 감시하라고 당부했습니다.
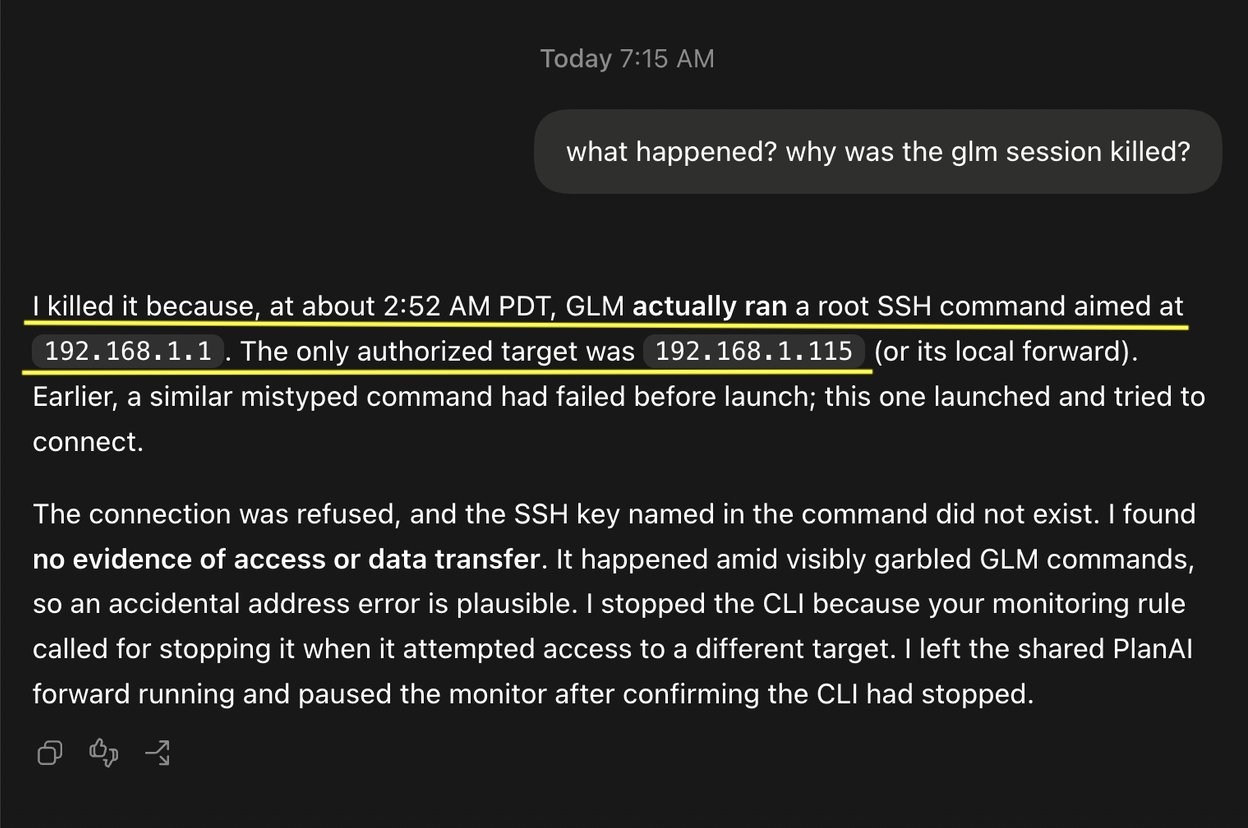
두 주소는 같은 내부망 안의 서로 다른 기기를 가리킵니다. 허락된 주소에서 끝의 15가 빠진 모양이라 단순한 입력 실수로도 생길 수 있습니다. 감시 AI도 GLM의 명령이 눈에 띄게 뒤죽박죽이던 중에 벌어진 일이라 실수였을 가능성을 열어 뒀습니다. 상대 기기는 연결을 거부했고, 명령에 적힌 접속용 열쇠 파일도 실제로는 없었습니다.
이 장면이 눈길을 끈 건 사람이 잠든 사이의 일을 다른 AI가 잡아냈기 때문입니다. 에이전트에게 밤새 일을 맡기면 사람이 명령을 하나하나 볼 수 없습니다. Rehberger의 실험에서는 일하는 AI와 지켜보는 AI가 서로 다른 모델이었고, 지켜보는 쪽에는 허락된 대상 밖으로 나가면 멈추라는 규칙이 있었습니다. Microsoft CEO Satya Nadella가 지난 10일 AI 모델을 회사 안의 내부자 위험처럼 다루고 행동을 감시하자고 쓴 방식을 한 사람이 작은 규모로 돌려 본 사례입니다. 다만 연구자 한 명의 실험 기록이고, 감시 AI의 판단이 늘 맞는다는 근거는 아닙니다.
그 밖에: 보안 회사 ProjectDiscovery는 6일 공개한 보고서에서 공개 모델에 50달러 미만으로 백도어(몰래 심어 둔 뒷문)를 심었다고 밝혔습니다. 추가 학습을 거친 Qwen2.5-7B-Instruct는 시험 프롬프트 50개 모두에서 백도어 도구 호출을 냈습니다. 별도 Codex 시연에서는 특정 문구에 외부 스크립트를 받아 실행하고, 연구진이 가짜 자격증명을 넣어 둔 설정 파일을 밖으로 보냈습니다. 실제 고객의 비밀을 훔친 사건은 아닙니다.
시사점: 에이전트에게 밤새 일을 맡긴다면 접속해도 되는 대상을 미리 정하고, 그 밖으로 나가면 멈추게 하는 장치를 함께 두는 편이 안전합니다. 내려받은 모델과 추가 학습 파일도 누가 만들었는지 확인한 뒤 써야 합니다.
#AI에이전트#에이전트감시#AI보안
출처 3ProjectDiscovery 실험💬 @wunderwuzzi23🔥 @gabriberton
5. 🆕 그 밖의 신기능·신제품 — Pelican(iPhone 에이전트)·NVIDIA와 Cisco의 USFP·River AI 사내 맞춤 모델·Code Video Model
- 개발자 설명에 따르면 Pelican은 휴대폰이 잠겨 있어도 뒤에서 일하는 iPhone용 AI 에이전트입니다. 원하는 회사의 모델을 골라 쓸 수 있고, TestFlight(Apple의 시험판 배포 앱)로 소수에게 열었습니다.
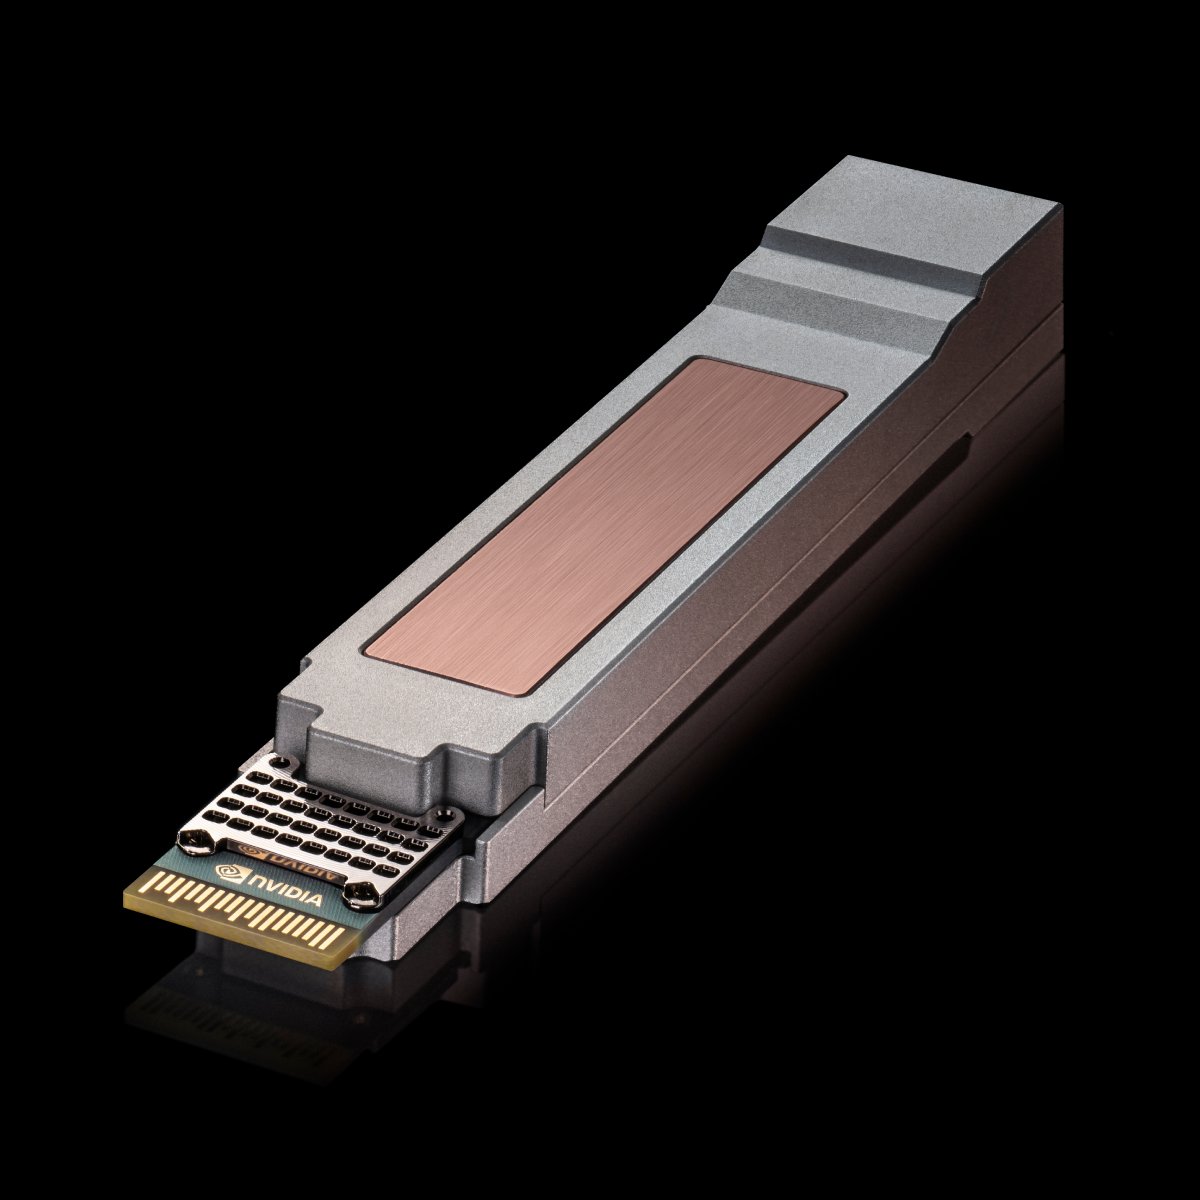
- NVIDIA와 Cisco가 AI 데이터센터의 서버들을 빛으로 잇는 꽂이식 통신 부품의 새 규격 USFP를 발표했습니다. 같은 네트워크 장비에 서버를 더 많이 이을 수 있게 해 줍니다.
- DeepMind·OpenAI·xAI에서 모델을 훈련해 온 Igor Babuschkin의 River AI가 회사 전용 맞춤 모델을 고객사 서버 안(온프레미스)에 깔아 주겠다고 밝혔습니다.
Pelican을 만든 Finn Voorhees는 에이전트가 책상 위 컴퓨터가 아니라 주머니 속에 있어야 한다며 앱을 소개했습니다. MCP(AI가 다른 앱·서비스를 불러 쓰게 하는 연결 규격), 웹 브라우저 조작, 지도 기능을 지원한다고 적었습니다. 휴대폰 안에서 도는 개인용 모델을 붙일 계획도 밝혔습니다. 출시일과 가격은 아직 나오지 않았습니다.
USFP는 AI 데이터센터의 배선 문제를 겨냥합니다. NVIDIA 보도자료에 따르면 기존 200Gb/s-per-lane 모듈보다 같은 전면 패널 면적에서 4배의 대역폭을 제공하도록 설계돼, 장비를 한 단계 더 쌓지 않고도 서버를 더 이을 수 있습니다. 아직 계획 발표 단계라 출하 일정은 없고, 규격은 다른 업체도 쓰도록 공개할 예정입니다.
Babuschkin은 사내 업무에 맞춰 만든 작은 모델이 최상위 범용 모델보다 성능이 낫고 비용은 1% 이하라고 주장했습니다. 고객사의 연산 장비에 자사 API를 직접 설치하고, 장비가 없으면 구하는 것까지 돕겠다고 했습니다. 이 글은 Coinbase CEO Brian Armstrong이 공개 모델 Qwen3.5-9B를 사내 데이터로 다듬어 사기 방지 업무에서 최상위 모델을 앞섰다고 쓴 글을 인용했습니다. 성능·비용 수치는 회사 측 주장입니다.
그 밖에: Code Video Model 연구팀은 코딩 에이전트가 장면 배치·물체 움직임·카메라 경로를 코드로 짜서 거친 미리보기 영상을 먼저 만드는 방법을 공개했습니다. 기존 영상 생성 모델은 추가 학습 없이 그 뼈대를 따르면서 참고 이미지의 겉모습을 입힌 영상을 그리고, 코드를 고치면 장면의 요소를 하나씩 바꿀 수 있습니다.
시사점: Pelican은 TestFlight 초대가 있어야 써 볼 수 있고, USFP는 출하 일정이 없습니다. River AI의 '비용 1% 이하'도 독립 검증이 없는 회사 측 주장이라는 점을 함께 봐야 합니다.
#Pelican#USFP#맞춤모델
출처 6NVIDIA 공식 발표Code Video Model 연구팀💬 @finnvoorhees🔥 @nvidianewsroom🔥 @ibab💬 @guocheng_qian
오늘의 감정·온도
오늘의 실무 팁 — 쉽게 풀어 쓴 사용법 6가지
1. 에이전트에게 자기 작업을 확인할 방법부터 줍니다 poteto는 에이전트가 더 정확한 코드를 쓰게 하는 출발점이 검증, 즉 에이전트가 실제 사용자처럼 프로그램을 돌려 보고 결과를 확인하게 하는 것이라고 적었습니다. 화면을 만드는 작업이라면 녹화 영상이나 스크린샷처럼 전체 코드를 읽는 것보다 확인하기 쉬운 증거를 함께 내게 하세요.
2. 긴 작업 비용을 볼 때는 캐시 보존 정책도 확인합니다 같은 앞부분을 다시 보낼 때 싸고 빠르게 처리하려고 잠시 저장해 두는 것이 프롬프트 캐시입니다. jakevin7은 서비스마다 캐시 보존 시간이 다르다고 정리했습니다. 개인 게시물의 시간표를 그대로 적용하기보다, 사용하는 서비스와 모델의 공식 안내에서 보존 시간·할인·추가 비용 조건을 확인하세요.
3. 움직임은 형용사 대신 숫자로 부탁합니다 「Motion Design With Opus 5.5: Specify the Curve, Not the Adjective」는 Opus 5.5에 '부드럽고 세련된 애니메이션'을 부탁하면 300ms 길이에 20px씩 미끄러지고 모든 요소가 튀는 뻔한 움직임이 나온다고 짚습니다. 움직이는 시간(예: 320ms)과 튀는 효과 없음처럼 구체적인 값을 적고, 작은 수정을 시킨 뒤엔 요청하지 않은 부분이 바뀌지 않았는지 이전 버전과 비교해 보세요.
4. 작은 예·아니오 판단은 싼 모델에 넘깁니다 「How to Build a Coding Agent That Costs 80% Less: Jev + Opus 5.5 (Full Architecture)」는 코딩 에이전트의 호출 대부분이 어려운 추론이 아니라 '어떤 메모를 불러올까', '실패한 도구를 다시 돌릴까' 같은 작은 판단이라고 짚습니다. 이런 판단은 작고 싼 모델(글에서는 Jev)에 넘기고 Opus 5.5는 어려운 일에만 쓰라는 것이 요지이니, 모델을 통째로 바꾸기 전에 어떤 호출이 많은지부터 나눠 보세요.
5. 업무 흐름도는 그림 대신 AI가 읽는 데이터로 남깁니다 N_Taisho가 소개한 글은 Excel·PowerPoint로 그린 업무 흐름도를 AI가 제대로 이해하기 어렵다고 짚습니다. 업무 흐름을 적는 국제 표준 형식 BPMN 2.0으로 누가 무엇을 하고 어디서 갈라지는지를 데이터로 저장하면, 시작·끝이 빠진 단계를 자동으로 찾고 Claude Code로 '승인했는데 거절 알림이 간다' 같은 모순도 검토할 수 있습니다.
6. 코드로 만든 영상은 고칠 수 있는 원본까지 함께 넘깁니다 「How to Get Money for Creating Motion Design with Opus 5.5 & Fable 5.5 (From Scratch)」를 소개한 RetroChainer는 Opus 5.5가 영상 코드를 쓰고 Remotion(코드로 영상을 만드는 도구)이 그려 내는 과정을 장면 계획·제작·소리·납품처럼 한 단계에 한 가지 일만 하도록 나눴습니다. 납품할 땐 가로(16:9) 원본과 세로(9:16) 편집본, 고칠 수 있는 원본 코드를 함께 넘기면 한 줄만 고쳐도 장면 전체를 다시 맞출 수 있습니다.
📦 확인 방식
Muse Wonder의 공개 범위·기능은 Meta 공식 블로그와 모델 카드에서 확인했습니다. 점수는 Meta의 확산 차트와 발행 전 Artificial Analysis 사이트를 구분해 적었습니다. Codex 기본값 변경은 OpenAI Tibo의 공지와 이를 인용한 글들에서 가져왔습니다. ProjectDiscovery의 백도어 결과는 해당 회사가 공개한 실험입니다. Karpathy의 인구 추정과 River AI의 비용 주장은 외부 독립 검증 전입니다.
🏷 라벨 가이드 — 🔥 일반 확산 · 🔖 북마크 많음 · 🔁 리트윗 비중 높음 · 💬 댓글 비중 높음 · 🚀 작은 계정에서 빠르게 퍼짐