AI 브리핑 ·
Google, Gemini 4 Argon 일반 공개
5분 브리핑
약 2분 · 7개 흐름핵심만 먼저 읽고, 궁금한 소식은 본문으로 이어 보세요.
전체 분석 15분으로 바로 가기 ↓- Google, 최상위 모델 Gemini 4 Argon 일반 공개…API·Gemini 앱·Antigravity에 열렸고, 독립 종합 점수는 GPT-6 Astra와 같았다
Google이 미국 시간 13일 Gemini 4 Argon을 일반에 열었습니다. 2주 전부터 보안 방어 기관과 초기 고객에게만 먼저 주던 모델입니다.
- SpaceXSI가 Grok·Grok Bot·Cursor·X Premium을 'The X Subscription' 하나로 묶었다…월 8~200달러, 사용량은 한 통에서 꺼내 쓴다
SpaceXSI(SpaceX Super Intelligence)가 10월 12일(미국 시간) Grok(xAI의 AI 채팅), Grok Bot(일을 대신 처리하는 AI 동료), Cursor(AI 코딩 도구), X Premium을 구독 하나로 합쳤습니다.
- Anthropic이 '증류' 방어를 강화해 Claude에서 빠져나가는 데이터를 90~99% 줄였다고 밝혔다
Anthropic이 10월 12일(미국 시각) 공식 블로그에서 증류 공격을 막는 새 방법을 공개했습니다. 증류는 다른 회사 모델의 답을 대량으로 모아 자기 모델을 훈련시키는 방식이고, 회사는 이렇게 빼가는 데이터가 초기 증거상 90~99% 줄었다고 밝혔습니다.
- Anthropic 레드팀이 공개 모델의 '스스로 복제'를 시험했다… GLM-5.2는 시험망 8대 전부에 퍼졌고, 혼자 퍼지는 복제기는 아직 없다
Anthropic에서 위험한 능력을 미리 점검하는 Frontier Red Team이 10월 12일 보고서를 냈습니다. 누구나 내려받아 돌리는 공개 모델이 데이터센터 없이 값싼 기기만으로 자신을 복제해 퍼질 수 있는지 시험했습니다.
- Anthropic이 하루 코드 병합 3만 건에 막혀 git 대신 Claude와 함께 자체 버전 관리 도구 Scion을 만들었다
Anthropic이 10월 13일 엔지니어링 블로그에서 사내 코드 저장소를 git(코드 변경 이력을 관리하는 표준 도구)에서 직접 만든 Scion으로 옮겼다고 밝혔습니다. 고친 코드를 본 코드에 합친 건수(병합)는 5월 하루 평균 약 2,500건에서 9월 하루 3만 건 이상으로 10배 넘게 늘었습니다.
- Agent Arena, 순위 기준에 'Bash 안정성' 반영…Claude Opus 5.5가 1위, Gemini 4 Argon은 5위로 들어왔다
AI 에이전트(사람 대신 여러 단계를 스스로 처리하는 AI)를 실제 사용 기록으로 비교하는 Arena가 10월 12일 순위 기준 하나를 바꿨습니다. 명령줄(글자로 컴퓨터에 명령을 내리는 창) 작업에서 명령 한 번당 실패가 얼마나 적은지를 보는 Bash Reliability입니다.
- 🆕 그 밖의 신기능·신제품 — Fish Audio Drama 3·Grok Bot 0.70.2·Indra·Character.ai 파산보호 신청
Fish Audio Drama 3 Preview: 글로 연기 톤을 지시하는 음성 합성 모델을 누구나 내려받을 수 있게 공개했습니다. 독립 평가 회사 Artificial Analysis의 발음 정확도 시험(용어·약어를 제대로 읽는지 재는 시험)에서 93.2%로 ElevenLabs의 Eleven v4(91.7%)를 앞서 전체 1위입니다.
주요 키워드 TOP 5: Gemini 4 Argon · The X Subscription · 증류 방어 · 자기 복제 · Scion | 메인 이벤트: Google이 최상위 모델 Gemini 4 Argon을 API·Gemini 앱·Antigravity에 열었고, 독립 종합 점수는 GPT-6 Astra와 같은 53점입니다
Google이 미국 시간 13일 최상위 모델 Gemini 4 Argon을 일반에 열었습니다. 독립 평가 회사 Artificial Analysis의 종합 점수는 53점으로 GPT-6 Astra와 같습니다. API 요금은 11월 30일까지 100만 토큰당 입력 $2·출력 $10입니다. 같은 점수의 GPT-6 Astra보다 시험 비용이 약 60% 수준이라는 집계도 나왔습니다. 다만 먼저 써 본 사람들의 평가는 맡긴 일에 따라 갈렸습니다. 글 구조를 잡거나 새 앱을 처음부터 만드는 일에선 빨랐지만, 엉망인 기존 코드를 고치는 시험에선 21%에 그쳤습니다. 이 구간에 OpenAI의 공식 신규 발표는 없었고, Claude Fable 5.5 출시설처럼 공식 확인이 없는 소문은 이번 호에서 다루지 않았습니다.
1. Google, 최상위 모델 Gemini 4 Argon 일반 공개…API·Gemini 앱·Antigravity에 열렸고, 독립 종합 점수는 GPT-6 Astra와 같았다
- Google이 미국 시간 13일 Gemini 4 Argon을 일반에 열었습니다. 2주 전부터 보안 방어 기관과 초기 고객에게만 먼저 주던 모델입니다. Logan Kilpatrick에 따르면 개발자용 Gemini API는 전 세계에, Gemini 앱은 유료 구독 Pro·Ultra에, Google의 코딩 에이전트 앱 Antigravity는 Ultra 구독자에게 열렸습니다.
- API 요금은 100만 토큰(AI가 글을 잘게 나눠 세는 단위)당 입력 $2·출력 $10입니다. Google 가격표상 11월 30일까지의 값이고, 12월 1일부터는 $4·$20으로 두 배가 됩니다. 무료 등급에서는 쓸 수 없습니다.
- 독립 평가 회사 Artificial Analysis가 여러 시험을 묶어 매기는 종합 점수는 53점입니다. GPT-6 Astra·Claude Fable 5.1과 같고, 1위 Claude Opus 5.5(58점)보다는 5점 낮습니다.
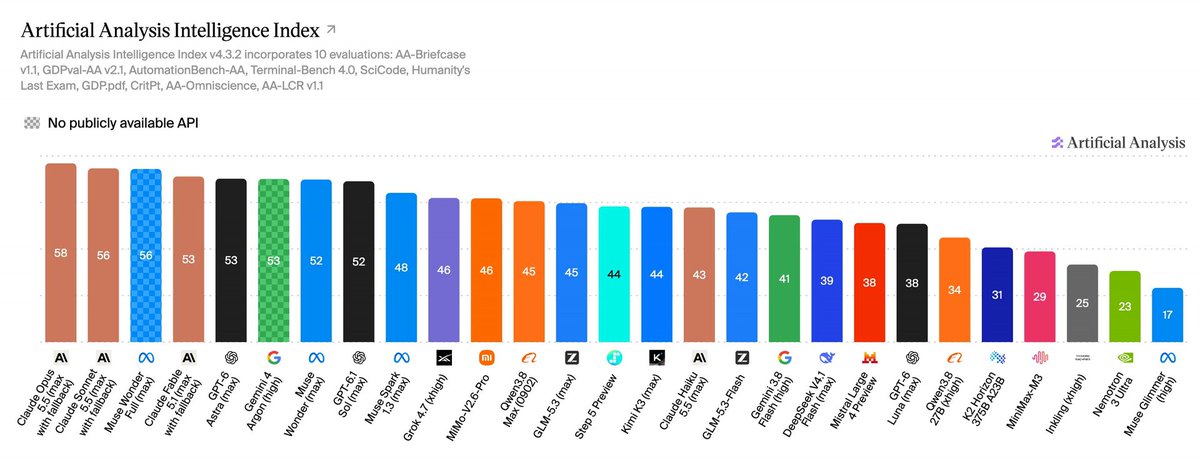
Google 공식 표에서 Argon은 금융·법률·세무 같은 실무 과제를 묶은 Vals Index에서 68.9%로 비교 모델 중 가장 높았습니다. 반대로 명령창에서 개발 작업을 끝까지 해내는 시험 Terminal-bench 4.0에선 57.4%로 비교한 네 모델 중 가장 낮았고, 1위 Opus 5.5(66.4%)와 9점 차이가 났습니다. 어려운 개발 과제를 푸는 FrontierSWE v2에서도 55.0%로 가장 낮았습니다(1위 GPT-6 Astra 65.5%). 회사가 직접 고르고 돌린 시험이라는 점은 감안해야 합니다.
독립 평가에선 비용이 눈에 띕니다. Artificial Analysis 집계로 지수 시험 한 건에 든 비용은 할인가 기준 $1.99로, 같은 53점인 GPT-6 Astra의 약 60% 수준입니다. 같은 회사의 지식 시험에서 모르는 내용을 지어내는 환각 비율은 15%로, 상위 모델 가운데 가장 낮았다는 정리도 나왔습니다. 코드 편집기 Cursor의 코딩 시험 CursorBench에선 52.9%로 Fable 5.1보다 높았다는 측정도 공유됐습니다. AI 에이전트끼리 겨루는 순위표 Agent Arena에선 상위 5위 안에 들었습니다(6번에서 다룹니다).
미디어 회사 Every의 팀원 6명은 일주일 먼저 써 보고 잘하는 일과 못하는 일을 뚜렷하게 나눴습니다. Dan Shipper는 글 구조를 잡고 비유를 다듬는 글쓰기 파트너로 가장 마음에 든다고 했고, 처음부터 만드는 앱도 빨랐습니다. 웹캠으로 심박을 재는 앱을 35분 만에 Opus 5.5 수준으로 만들었다고 합니다. 반면 엉망인 기존 코드를 고치는 시험에선 4시간 47분 일하고 21%에 그쳐 다른 최상위 모델(81~85%)에 크게 못 미쳤습니다. 다른 팀원이 돌린 시험에선 38번 중 17번이 자기 수정을 검토하는 단계를 0.03초 만에 끝내 사실상 건너뛰었습니다. Antigravity는 Claude Code·Codex보다 6개월에서 1년 뒤처졌다고 봤습니다.
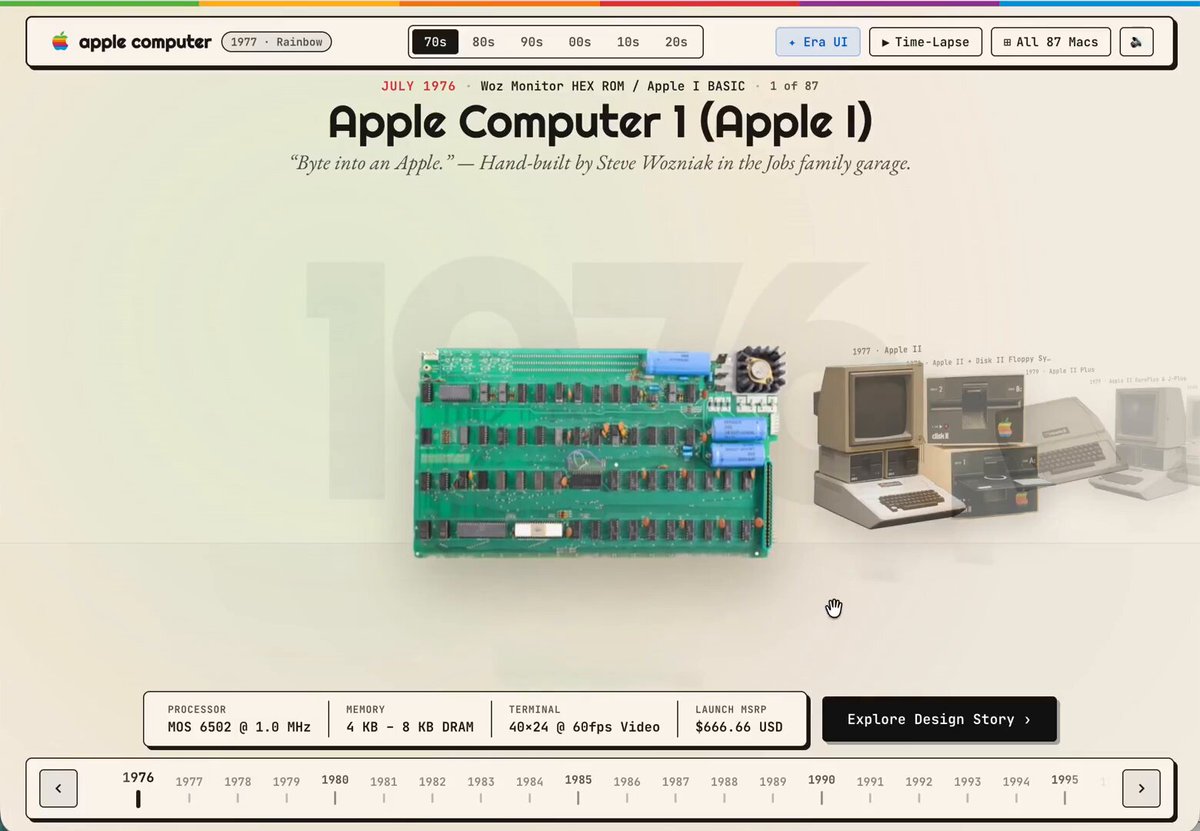
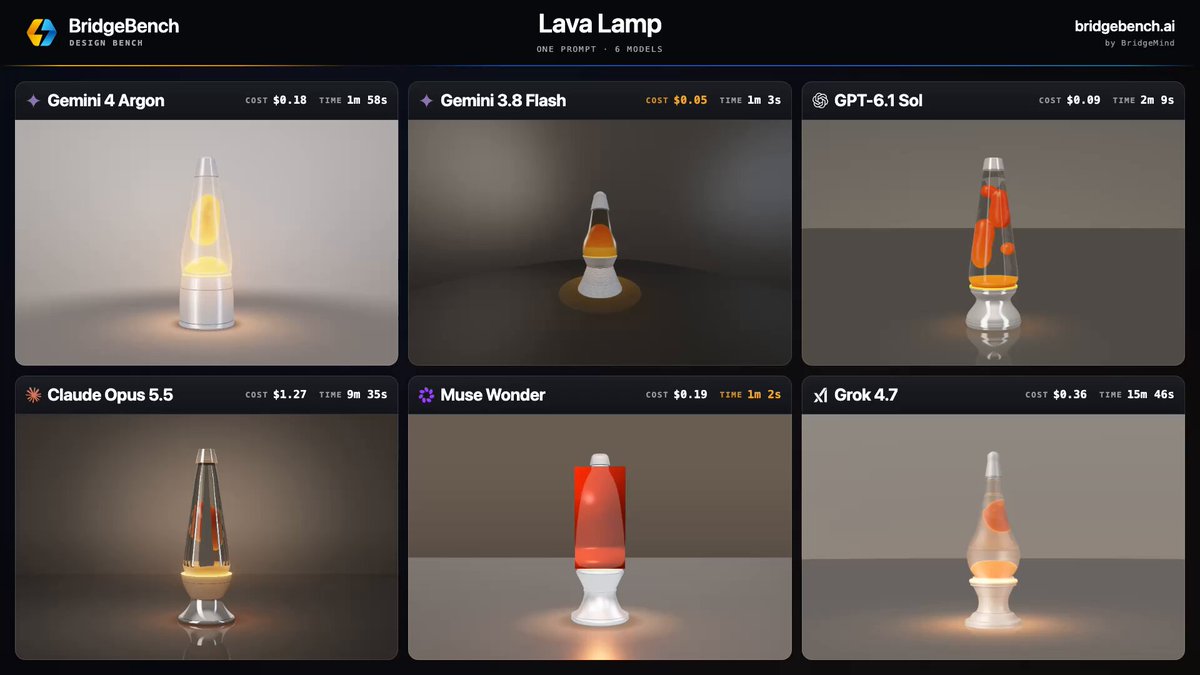
그 밖에: Justine Moore는 사진·자료 없이 Apple 컴퓨터 박물관을 요청했더니 Argon이 옛 사진을 모아 정리하고 50년치 사양을 넣은 3D 화면을 만들었다고 했습니다. Sundar Pichai는 Pixel 설계 파일로 3D 프로그램 Blender에서 분해 애니메이션을 만들며 자기 렌더링을 보고 1,000번 고친 Google 직원 사례를 올렸습니다. 한 이용자는 미국 정치 지식 문제에서 틀린 답을 지어냈다고 적었습니다(단일 사례).
시사점: Gemini 앱 Pro 구독자도 바로 쓸 수 있고 API는 11월 말까지 반값입니다. 글 구조 잡기나 새 앱 시제품엔 써 볼 만하지만, 기존 코드를 고치게 했다면 바뀐 부분을 직접 검토하는 편이 안전합니다.
#Gemini4Argon#AI요금
출처 10💬 @OfficialLoganK🚀 @GoogleDeepMind🔥 @alexmichaelio🔥 @LuminaBench🔥 @arena🔥 @bridgemindai💬 @danshipper🔥 @venturetwins🔥 @sundarpichai🔥 @synthwavedd
2. SpaceXSI가 Grok·Grok Bot·Cursor·X Premium을 'The X Subscription' 하나로 묶었다…월 8~200달러, 사용량은 한 통에서 꺼내 쓴다
- SpaceXSI(SpaceX Super Intelligence)가 10월 12일(미국 시간) Grok(xAI의 AI 채팅), Grok Bot(일을 대신 처리하는 AI 동료), Cursor(AI 코딩 도구), X Premium을 구독 하나로 합쳤습니다.
- 요금은 무료·Plus 8달러·Premium 30달러·Super 100달러·Ultra 200달러(월 기준)의 다섯 단계입니다. 사용량은 Plus를 기준으로 Premium 4배, Super 15배, Ultra 50배입니다.
- 모든 단계에서 Grok과 Cursor가 사용량 한 통을 같이 쓰고, 이 한도는 매주 다시 채워집니다.
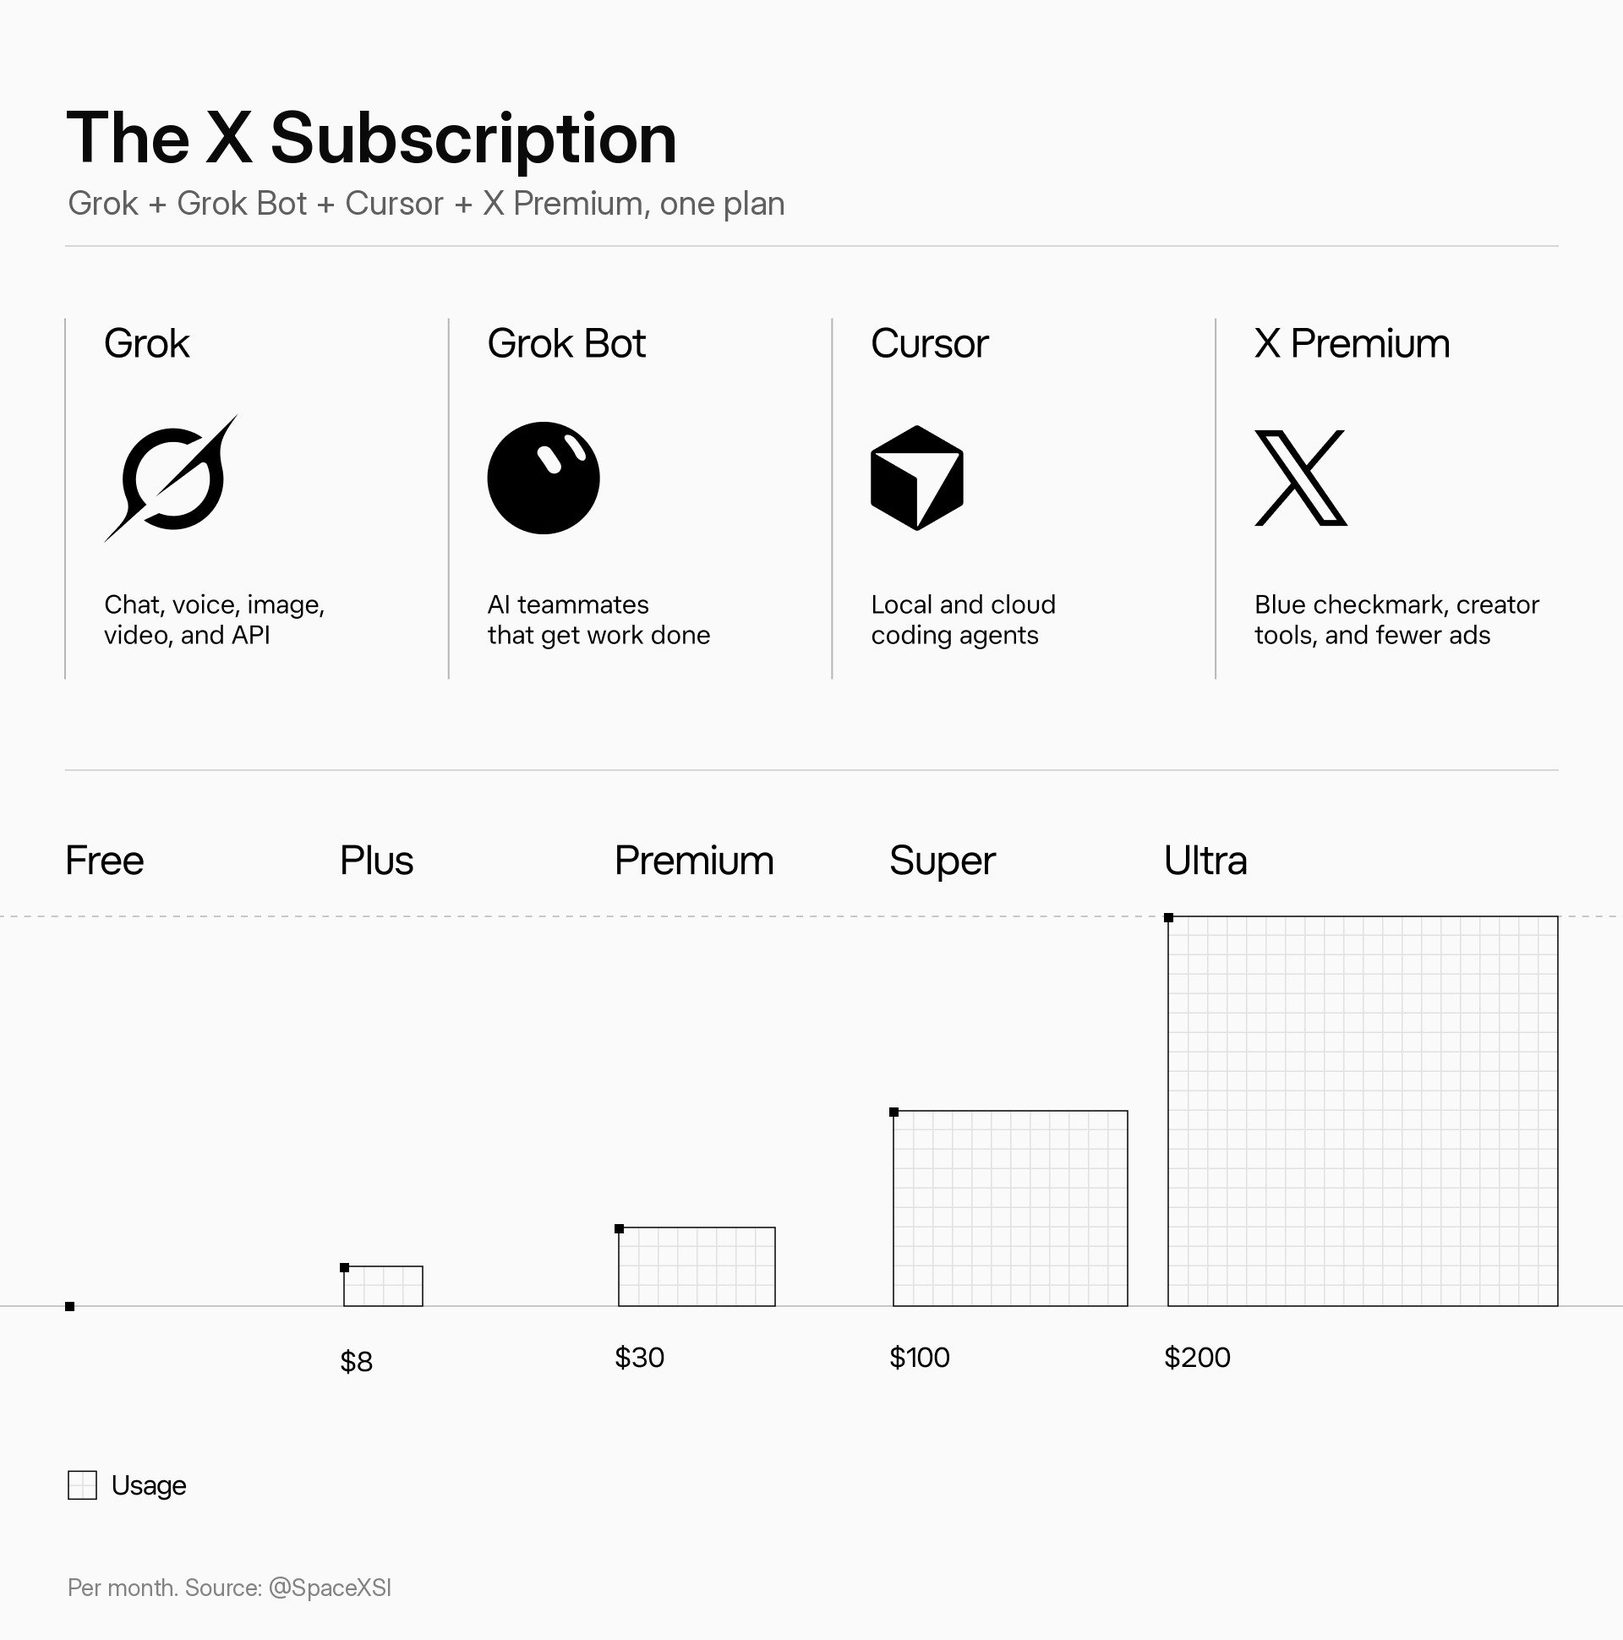
지금까지는 Grok, Cursor, X Premium을 각각 따로 결제해야 했습니다. 새 구독은 결제를 하나로 합치고, 같은 사용량을 대화와 코딩, 에이전트 작업 가운데 어디에 쓸지 사용자가 고르게 했습니다. 공지에 따르면 한도를 주 단위로 다시 채우기 때문에 하루 몰아 써도 한 달 몫이 한꺼번에 사라지지 않습니다. 다만 공식 페이지는 사용량을 'Plus의 4배'처럼 배수로만 적고, 실제로 몇 번 쓸 수 있는지는 밝히지 않았습니다.
가장 눈에 띄는 단계는 30달러짜리 Premium입니다. 회사는 이 단계에 SuperGrok(Grok 유료 플랜), Cursor Pro, X Premium+ 혜택을 담았고, 따로 사면 월 90달러였다고 설명합니다. 자사 모델로 하는 코딩 사용량도 비슷한 기존 Cursor 플랜보다 최소 2배 많다고 밝혔습니다.
그 밖에: Cursor 안에서 Claude·GPT 같은 다른 회사 모델은 Premium 이상에서만 쓸 수 있고, 구독료와 별도로 API 정가만큼 충전해서 냅니다. 기존 SuperGrok·Cursor·X Premium 구독자는 그대로 두면 바뀌는 게 없고, 갈아타면 옛 플랜의 남은 기간을 일할로 환불받습니다.
시사점: Grok 모델로 코딩을 많이 하는 사람은 같은 돈으로 쓸 수 있는 양이 늘어납니다. 반대로 Cursor에서 Claude·GPT를 주로 쓰던 사람은 새 구독에서 그 사용분을 따로 내야 하니, 갈아타기 전에 지금 어떤 모델을 쓰는지부터 확인하는 편이 좋습니다.
#TheXSubscription#Grok#Cursor
출처 4💬 @poteto🔥 @ns123abc💬 @XFreeze💬 @mark_k
3. Anthropic이 '증류' 방어를 강화해 Claude에서 빠져나가는 데이터를 90~99% 줄였다고 밝혔다
- Anthropic이 10월 12일(미국 시각) 공식 블로그에서 증류 공격을 막는 새 방법을 공개했습니다. 증류는 다른 회사 모델의 답을 대량으로 모아 자기 모델을 훈련시키는 방식이고, 회사는 이렇게 빼가는 데이터가 초기 증거상 90~99% 줄었다고 밝혔습니다.
- 증류에 연루된 계정 수만 개를 차단했습니다. 수집을 시작한 계정을 2시간 안에 막는 경우가 많았다고 합니다.
- 대가도 있습니다. 일부 정상 개발자는 Claude에 연결하는 방식을 고쳐야 했고, 증류 차단 장치가 정상 요청을 잘못 막는 비율은 0.1% 미만이라고 했습니다.
증류는 최상위 모델이 문제를 푸는 과정을 대량으로 받아 적어, 훨씬 적은 비용으로 비슷한 모델을 만드는 지름길입니다. Anthropic은 특히 Claude가 답하기 전에 거치는 생각 과정이 표적이라고 보고, 이 기록을 쉽게 빼내지 못하게 막는 데 집중했습니다. 생각 과정 기록만 따로 세면, 증류하는 쪽이 빼낸 분량이 예전의 10분의 1~100분의 1로 줄었다고 합니다. 이 차단 장치는 현재 Claude Sonnet 5.5, Claude Opus 5·5.5, Claude Fable 5·5.1에 걸려 있습니다.
블로그는 회사 이름도 들었습니다. 중국 AI 회사 Zhipu가 GLM-5.3을 만들면서 미국 최상위 모델의 해킹 관련 능력을 증류했고, Moonshot의 Kimi 모델로 들어온 요청 일부가 몰래 Claude로 넘겨졌다고 적었습니다. 증류하는 쪽이 돈을 내고 보내던 요청 수조 토큰(AI가 글을 읽고 쓰는 단위)어치도 수익을 포기하고 돌려보냈다고 밝혔습니다.
그 밖에: 9월 24일부터는 차단 장치의 오판이 0.1% 미만인 증류 같은 영역에서, 답을 받기 전에 막힌 요청에도 다시 요금을 받고 있습니다. David Sacks는 X에서 증류를 막기에 가장 좋은 위치는 정부가 아니라 Anthropic이었다며, 새 규제를 서두를 일이 아니라는 근거로 이번 발표를 들었습니다.
시사점: 최상위 모델의 답을 베껴 값싼 모델을 만드는 길이 좁아진다는 뜻입니다. 다만 90~99%는 Anthropic이 직접 낸 초기 수치라 외부 검증은 아직 없고, 회사도 이 효과가 얼마나 갈지 모른다며 쫓고 쫓기는 싸움이 계속될 것이라고 적었습니다.
#Anthropic#증류#Claude
출처 2🔥 @DavidSacks🔥 @VaibhavSisinty
4. Anthropic 레드팀이 공개 모델의 '스스로 복제'를 시험했다… GLM-5.2는 시험망 8대 전부에 퍼졌고, 혼자 퍼지는 복제기는 아직 없다
- Anthropic에서 위험한 능력을 미리 점검하는 Frontier Red Team이 10월 12일 보고서를 냈습니다. 누구나 내려받아 돌리는 공개 모델이 데이터센터 없이 값싼 기기만으로 자신을 복제해 퍼질 수 있는지 시험했습니다.
- 방화벽으로 막은 가상 기기 8대짜리 시험망에서 GLM-5.2는 다섯 번 중 네 번 8대 전부로 퍼졌습니다. 나머지 한 번도 7대까지 갔습니다. 시험한 공개 모델 중 처음부터 끝까지 해낸 건 GLM-5.2뿐이었습니다.
- 보고서는 크기 300억 파라미터(모델 크기를 재는 단위) 이하의 소형 모델이 지금까지의 속도로 좋아지면 올해 말 이 수준에 닿는다고 내다봤습니다. 다만 기기에 침입하는 단계는 일부러 쉽게 열어 둔 '최대치' 조건이었고, 실제로 혼자 퍼지는 복제기는 아직 없다고 적었습니다.
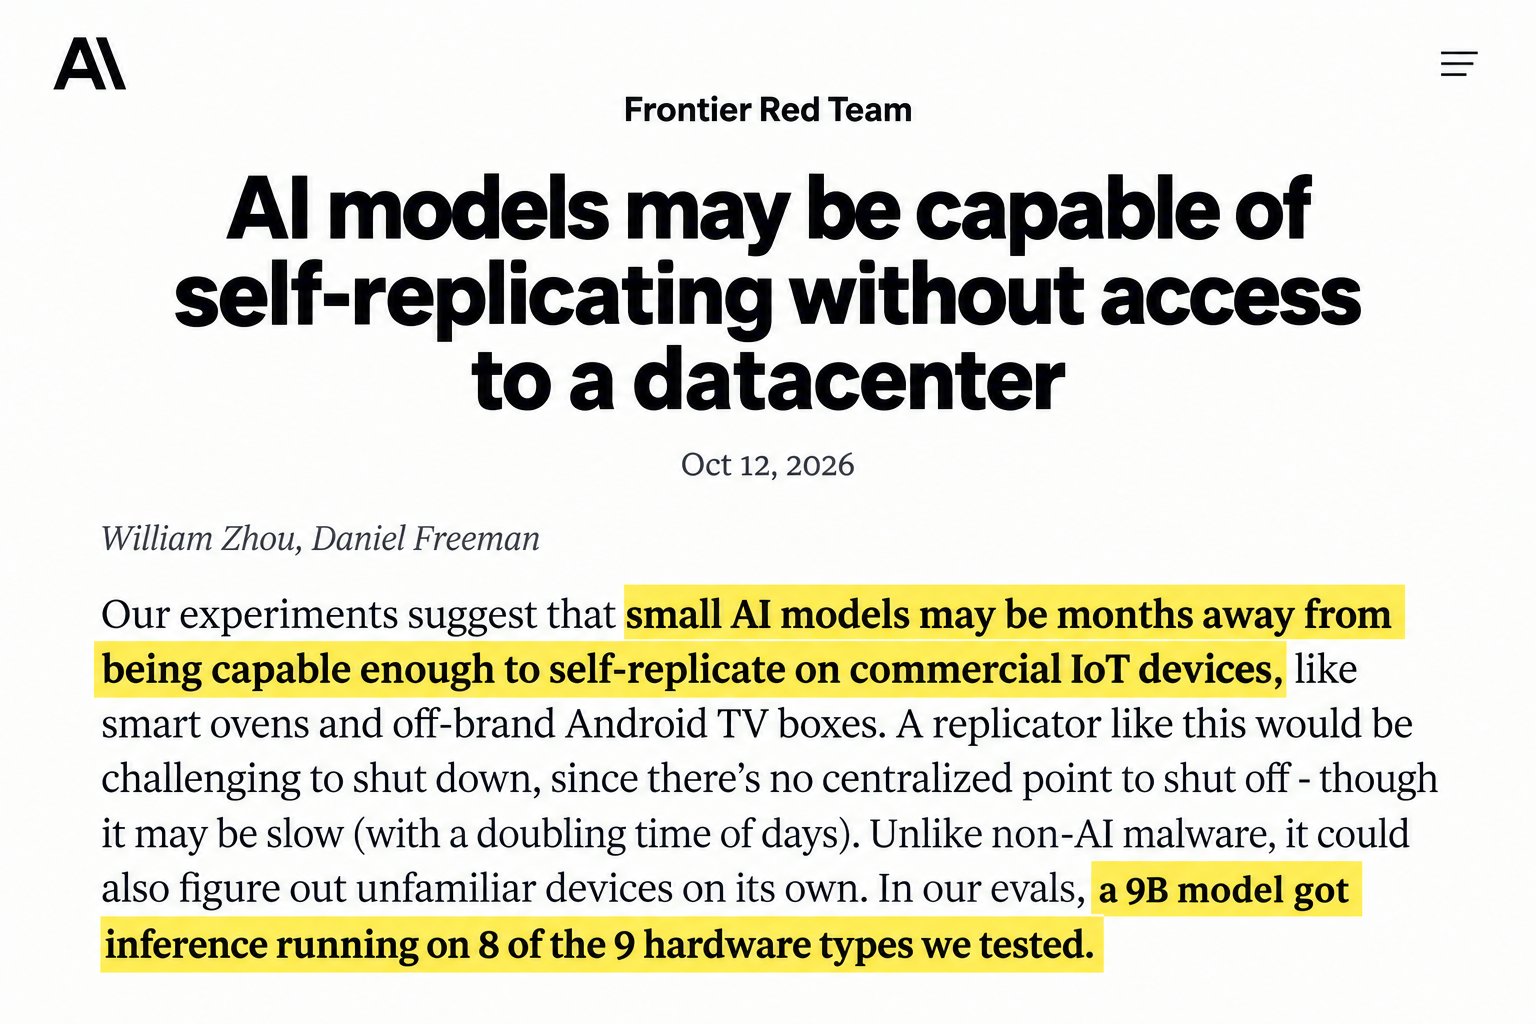
보고서가 자세히 다룬 건 침입보다 '남의 기기에서 모델을 돌리는' 단계입니다. 개당 약 55달러인 무명 브랜드 Android TV 박스 15대에 Gemma4-26B 모델을 나눠 올렸더니 초당 0.39토큰, 곧 단어 조각 하나에 2~3초가 걸렸습니다. 느리지만 돌아는 갔습니다. 더 작은 90억 파라미터(9B)급 모델은 시험한 하드웨어 9종 중 8종에서 모델 실행 환경을 갖췄습니다. Qwen3.5-9B의 각 복제본이 시도한 방법과 실패를 메모로 남겨 다음 세대에 넘기자, 실행 환경을 세우는 성공률이 첫 세대 45%에서 이후 61~84%로 올랐습니다.
이런 복제기가 생기면 끌 수 있는 중앙 스위치가 없다는 게 보고서의 걱정입니다. 대신 속도는 느려서, 9B 모델이 한 번 복제하는 데 하루에서 이틀 넘게 걸리고 감염 기기가 두 배가 되는 데도 며칠이 걸릴 것으로 봤습니다.
그 밖에: Qwen3.5-9B에 Claude Opus 4.8의 조언을 붙여 줘도 실행 환경을 세우는 성공률은 눈에 띄게 오르지 않았습니다. 보고서는 대책으로 인터넷 기기를 감염시켜 한꺼번에 부리던 과거 Mirai 봇넷 사례를 들었습니다. 한 인터넷 업체가 감염 가입자를 격리하고 정리 방법을 안내하자 14일 안에 감염의 92%가 사라졌고, 통보하지 않았을 때는 74%였습니다.
시사점: 확인된 건 'AI 웜'(스스로 퍼지는 AI 악성코드)이 아니라, 침입을 쉽게 열어 준 시험망에서 공개 모델이 복제 단계를 끝까지 이었다는 사실입니다. 소형 모델의 올해 말 전망과 '아직 실제 복제기는 없다'는 한계를 함께 읽어야 합니다. 값싼 인터넷 가전의 기본 보안 설정이 AI 안전 문제로도 이어진다는 신호입니다.
#AI안전#자기복제#Anthropic
출처 3💬 @vikktorrrre💬 @dani_avila7💬 @heyorvian
5. Anthropic이 하루 코드 병합 3만 건에 막혀 git 대신 Claude와 함께 자체 버전 관리 도구 Scion을 만들었다
- Anthropic이 10월 13일 엔지니어링 블로그에서 사내 코드 저장소를 git(코드 변경 이력을 관리하는 표준 도구)에서 직접 만든 Scion으로 옮겼다고 밝혔습니다.
- 고친 코드를 본 코드에 합친 건수(병합)는 5월 하루 평균 약 2,500건에서 9월 하루 3만 건 이상으로 10배 넘게 늘었습니다.
- 7명이 Scion과 코드 검토 도구 Antique를 함께 만들어 5개월 만에 옮기기를 끝냈습니다.
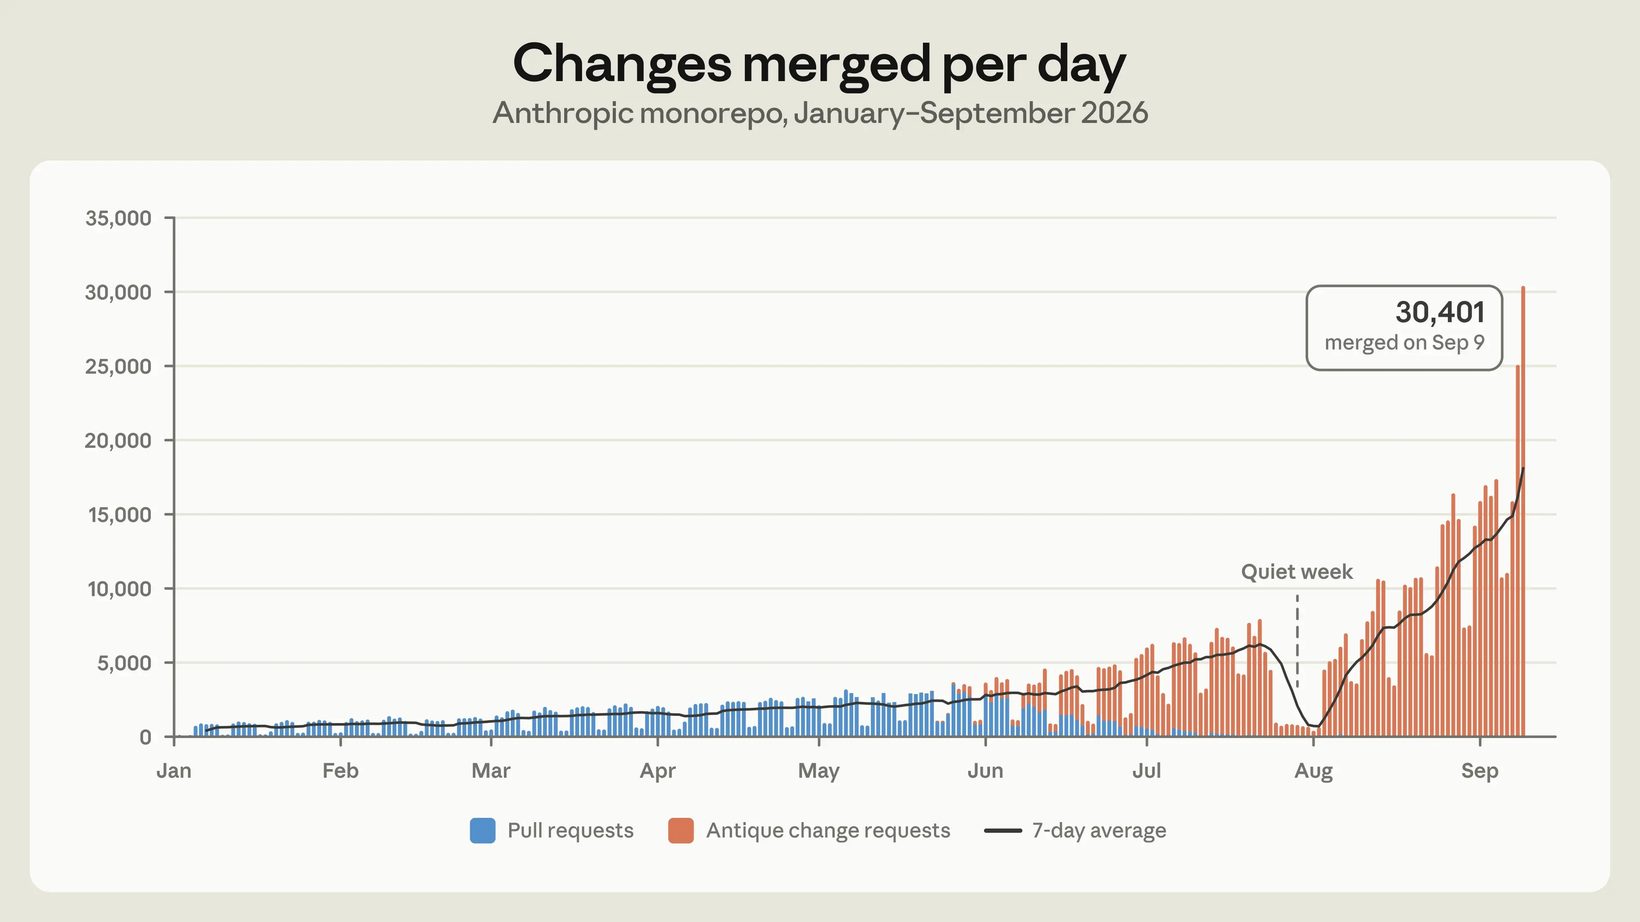
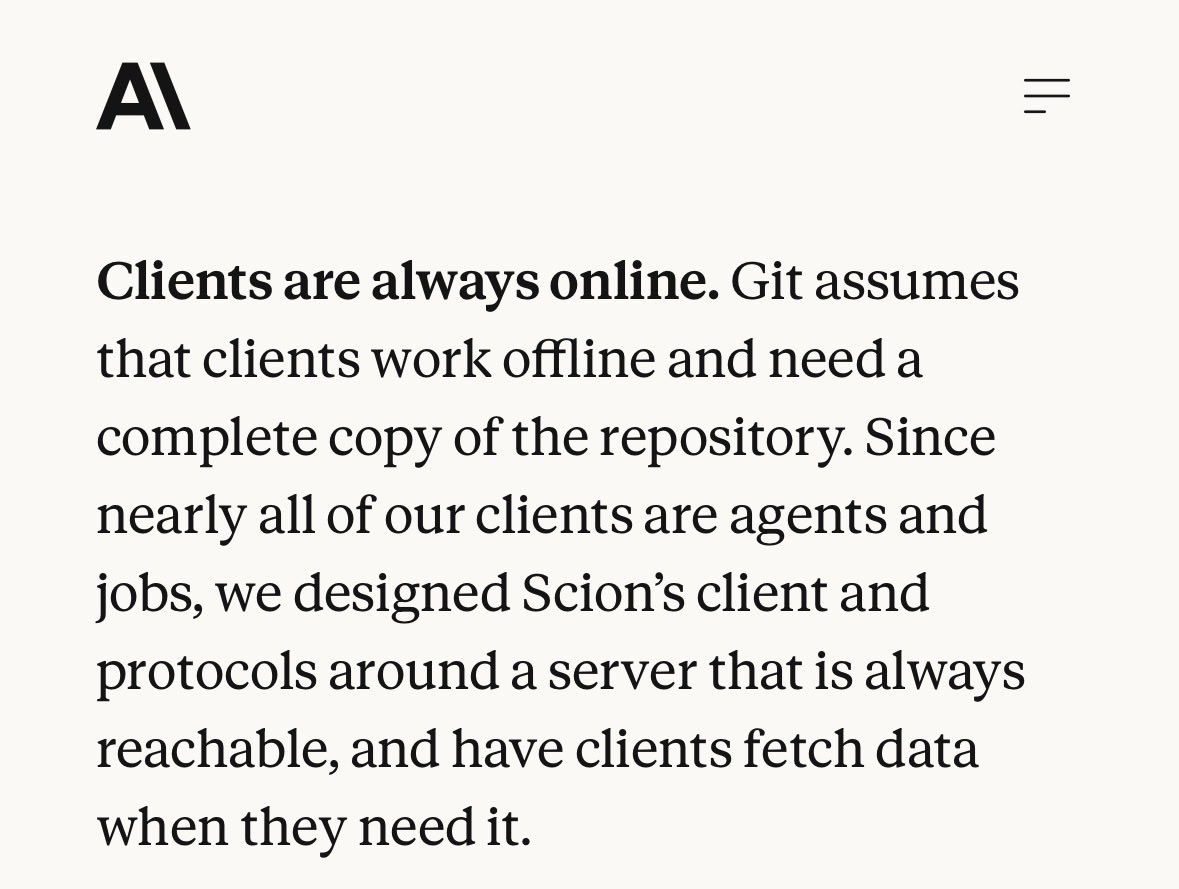
git은 개발자마다 저장소 전체를 내려받아 인터넷 없이도 일한다는 전제로 만들어졌습니다. Anthropic 저장소는 이력만 100GB에 가깝고, 자동 검사 작업이 하루 약 2,500만 번 코드를 내려받습니다. 그대로 받으면 하루 600PB(페타바이트)가 넘어서, 수백 개의 내부 복제본으로 버텨 왔습니다. 그런데 이 저장소를 쓰는 쪽은 이제 거의 다 사람이 아니라 늘 연결된 에이전트와 자동 작업입니다. 그래서 Scion은 이력을 서버에 두고 필요한 파일만 그때그때 받게 했습니다. 회사에 따르면 옛 복제 설비보다 CPU·메모리 사용이 200분의 1로 줄었고, 자동 작업이 코드를 받는 시간은 몇 분에서 몇 초로 짧아졌습니다.
만드는 과정에도 Claude가 깊이 들어갔습니다. 참여한 엔지니어 전원이 이제 Claude가 자기보다 코드를 잘 쓴다고 평가한다고 회사는 적었습니다. git 데이터를 Scion으로 옮겨 담는 시제품을 사람이 먼저 짰는데, Claude가 다시 쓰자 메모리는 20분의 1로 줄고 속도는 4배가 됐습니다. 엔지니어는 설계 방향을 정하고, 에이전트가 시스템의 핵심 제약을 어길 때 "안 된다"고 막는 역할을 자주 맡았다고 합니다. Anthropic은 Scion이 일반 용도의 git 대체품은 못 된다며, 도구를 공개하는 대신 설계 경험을 나누겠다고 했습니다.
그 밖에: Ars Technica가 10월 9일 소개한 Harvard University 연구는 700곳이 넘는 회사의 개발 기록을 분석했습니다. 코딩 에이전트를 들인 뒤 코드 줄 수는 30% 늘었지만 작업·기능을 끝내는 비율은 통계적으로 의미 있게 달라지지 않았고, 코드를 올린 뒤 합쳐지기까지의 검토 시간이 49% 길어졌습니다.
시사점: 에이전트가 사람보다 많은 코드를 내기 시작하면 저장소와 검토 같은 기존 개발 과정이 병목이 됩니다. Anthropic은 도구를 새로 만들어 풀었지만, 올해 3월까지 자료로 본 회사들에서는 사람의 검토가 속도를 붙잡았습니다.
#Anthropic#Scion#코딩에이전트
출처 3🔥 @AndrewCurran_Anthropic 공식 발표Ars Technica 보도
6. Agent Arena, 순위 기준에 'Bash 안정성' 반영…Claude Opus 5.5가 1위, Gemini 4 Argon은 5위로 들어왔다
- AI 에이전트(사람 대신 여러 단계를 스스로 처리하는 AI)를 실제 사용 기록으로 비교하는 Arena가 10월 12일 순위 기준 하나를 바꿨습니다. 명령줄(글자로 컴퓨터에 명령을 내리는 창) 작업에서 명령 한 번당 실패가 얼마나 적은지를 보는 Bash Reliability입니다.
- 바뀐 기준을 반영한 종합 순위에서 Claude Opus 5.5가 1위, GPT-6.1 Sol이 2위입니다. 3~5위는 Claude Fable 5.1, GPT-6 Astra, 새로 나온 Gemini 4 Argon 순입니다.
- 14위까지 모두 내려받을 수 없는 회사 모델입니다. 누구나 내려받아 쓸 수 있는 공개 모델 중에선 GLM-5.2가 15위로 가장 높았습니다.
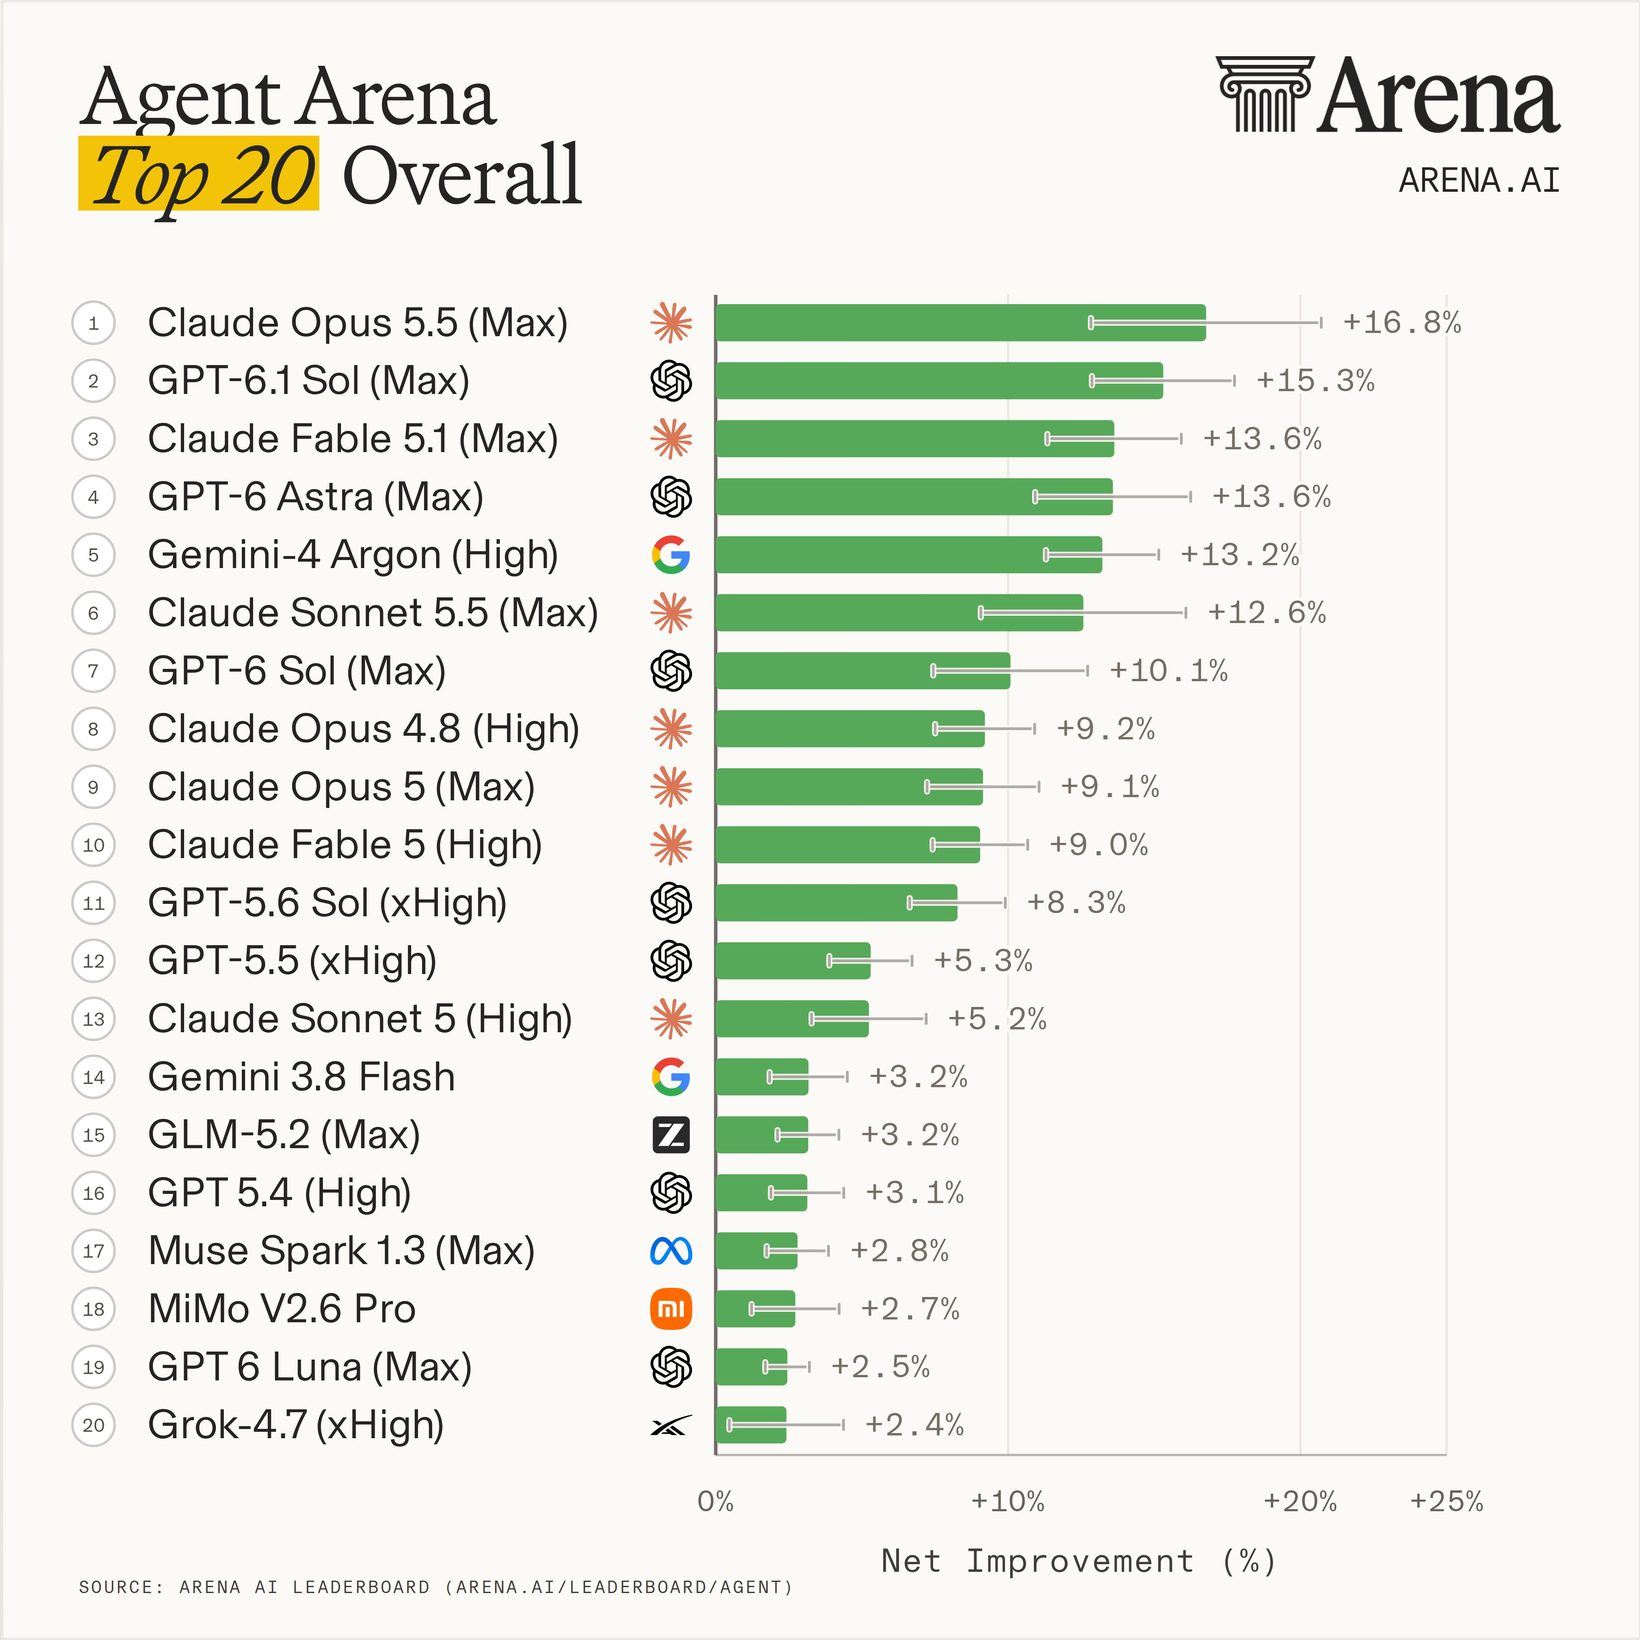
Agent Arena는 시험 문제 대신 사용자가 Arena에서 에이전트에게 맡긴 실제 작업 기록으로 순위를 매깁니다. 모델 이름 옆 Max·High는 생각을 얼마나 오래 하게 했는지 정한 설정입니다.
바뀌기 전 Bash Recovery는 명령이 틀린 뒤 몇 번 만에 회복하는지만 셌습니다. 그래서 명령을 한 번도 틀리지 않은 모델은 이 항목에서 이득을 보지 못했습니다. 제대로 돌아가 결함을 찾아낸 테스트나 결과가 없는 검색을 실패로 잘못 세기도 했습니다. 이제는 AI 판정기가 명령마다 목적과 결과, 오류 원인을 봅니다. 네트워크 장애처럼 에이전트 탓이 아닌 오류는 빼고 셉니다. Arena는 이 변경으로 여러 모델의 순위가 움직였다고만 밝혔고, 어느 모델이 얼마나 움직였는지는 공개하지 않았습니다.
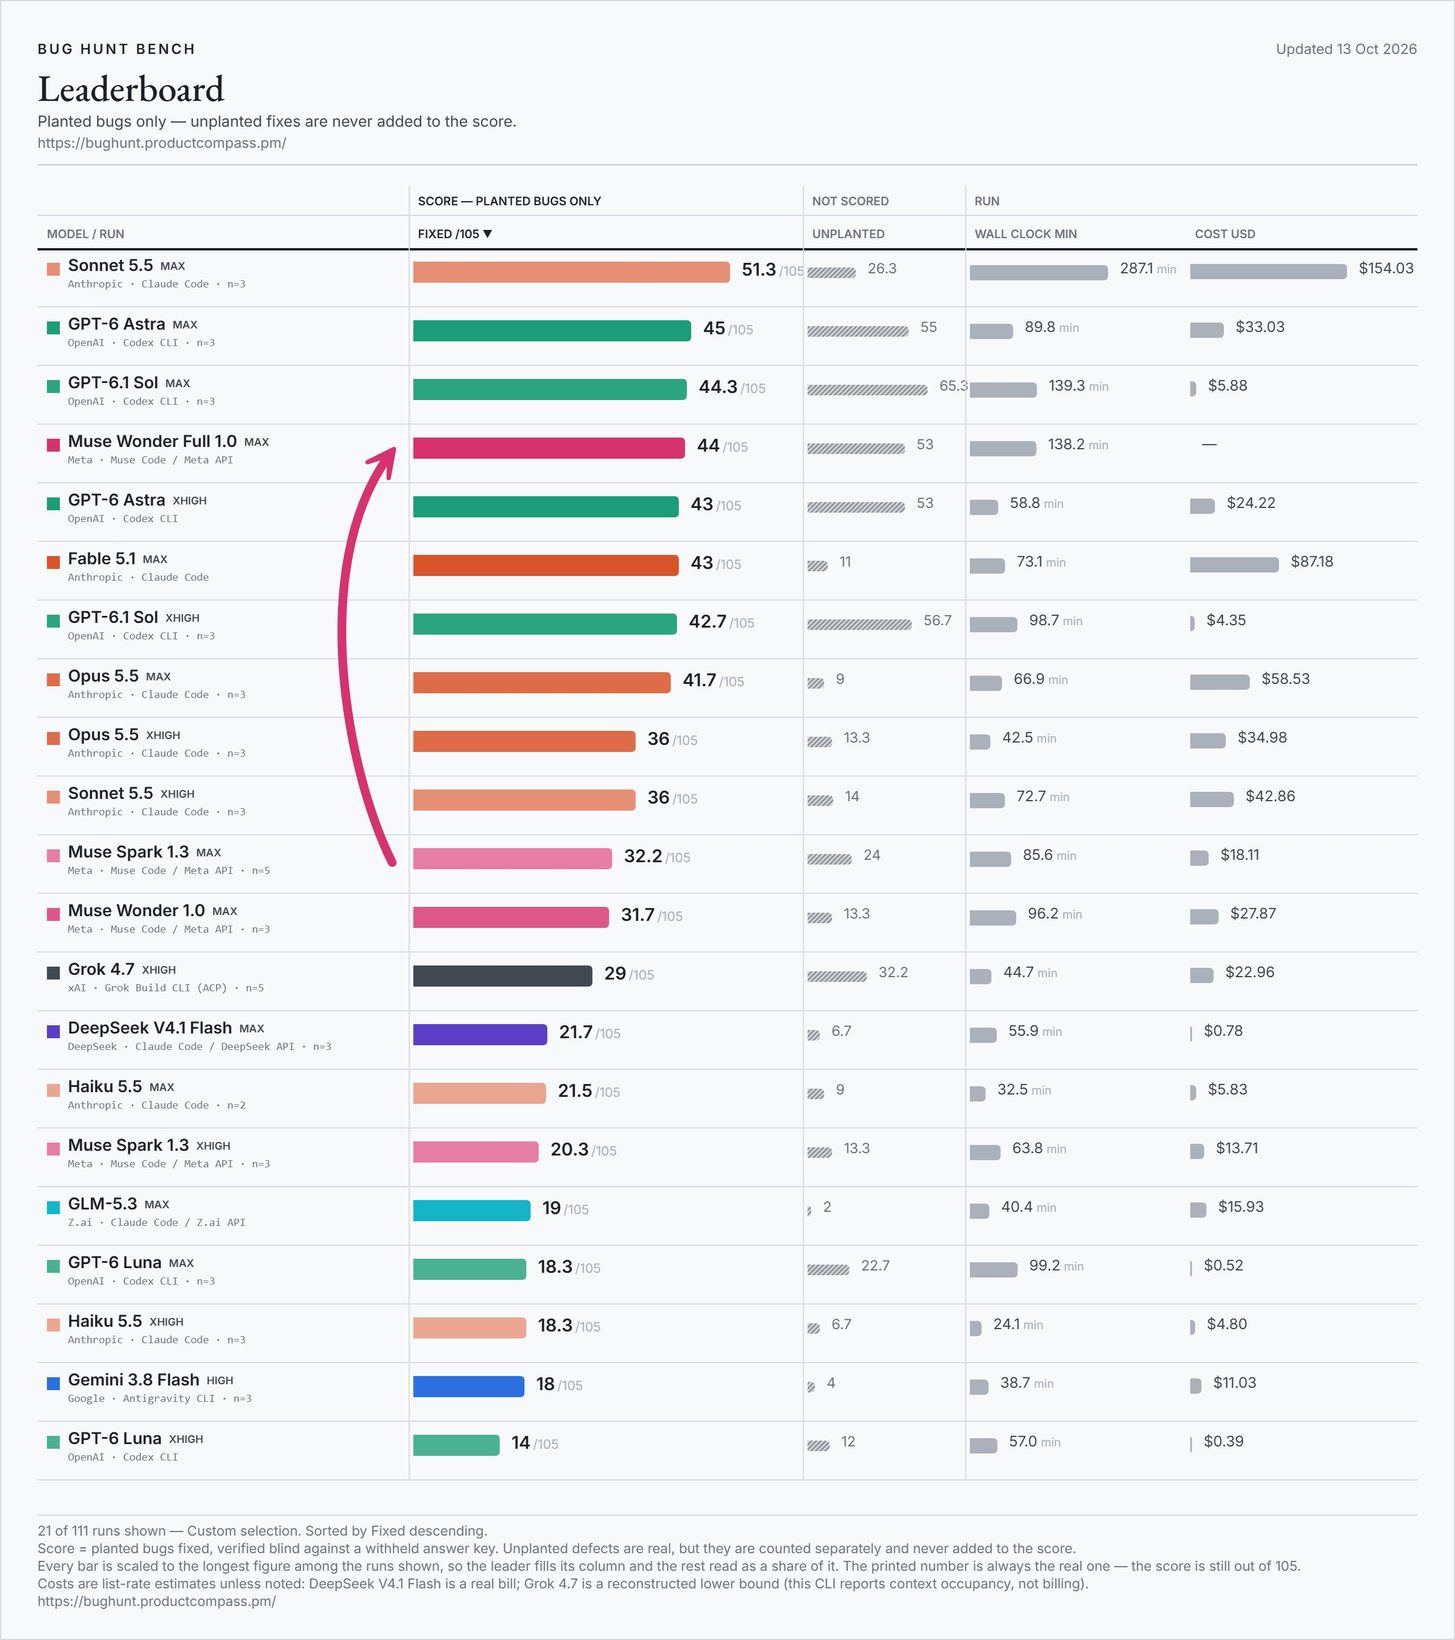
그 밖에: 뉴스레터 운영자 Paweł Huryn이 만든 버그 수리 시험 Bug Hunt Bench도 10월 13일 표를 갱신했습니다. 저장소 두 곳에 심어 둔 버그 105개 중 Meta의 Muse Wonder Full은 44개를 고쳐 GPT-6 Astra(45개)와 비슷했고, 맨 위는 Claude Sonnet 5.5로 평균 51.3개였습니다.
시사점: 실제 사용 기록으로 매긴 순위에서도 1~6위의 오차 막대가 서로 겹칩니다. 에이전트에게 명령줄 작업을 맡긴다면 순위 한 줄보다 내 작업에서 직접 견줘 보는 편이 정확합니다.
#AgentArena#벤치마크#코딩에이전트
7. 🆕 그 밖의 신기능·신제품 — Fish Audio Drama 3·Grok Bot 0.70.2·Indra·Character.ai 파산보호 신청
- Fish Audio Drama 3 Preview: 글로 연기 톤을 지시하는 음성 합성 모델을 누구나 내려받을 수 있게 공개했습니다. 독립 평가 회사 Artificial Analysis의 발음 정확도 시험(용어·약어를 제대로 읽는지 재는 시험)에서 93.2%로 ElevenLabs의 Eleven v4(91.7%)를 앞서 전체 1위입니다.
- Grok Bot 0.70.2: 봇마다 전용 메일 주소를 받을 수 있고, Figma·Notion·Canva 같은 앱이 채팅 안에 카드로 바로 뜹니다. 되돌릴 수 없는 일을 하기 전에는 사람에게 승인을 받습니다.
- Indra: Datalab이 매개변수 100만 개짜리 아주 작은 OCR(사진·스캔 속 글자를 텍스트로 읽는 기술) 모델을 공개했습니다. 그래픽카드 없이 CPU만으로 초당 최대 49쪽을 읽는데, 32코어 서버 CPU에서 잰 값입니다.
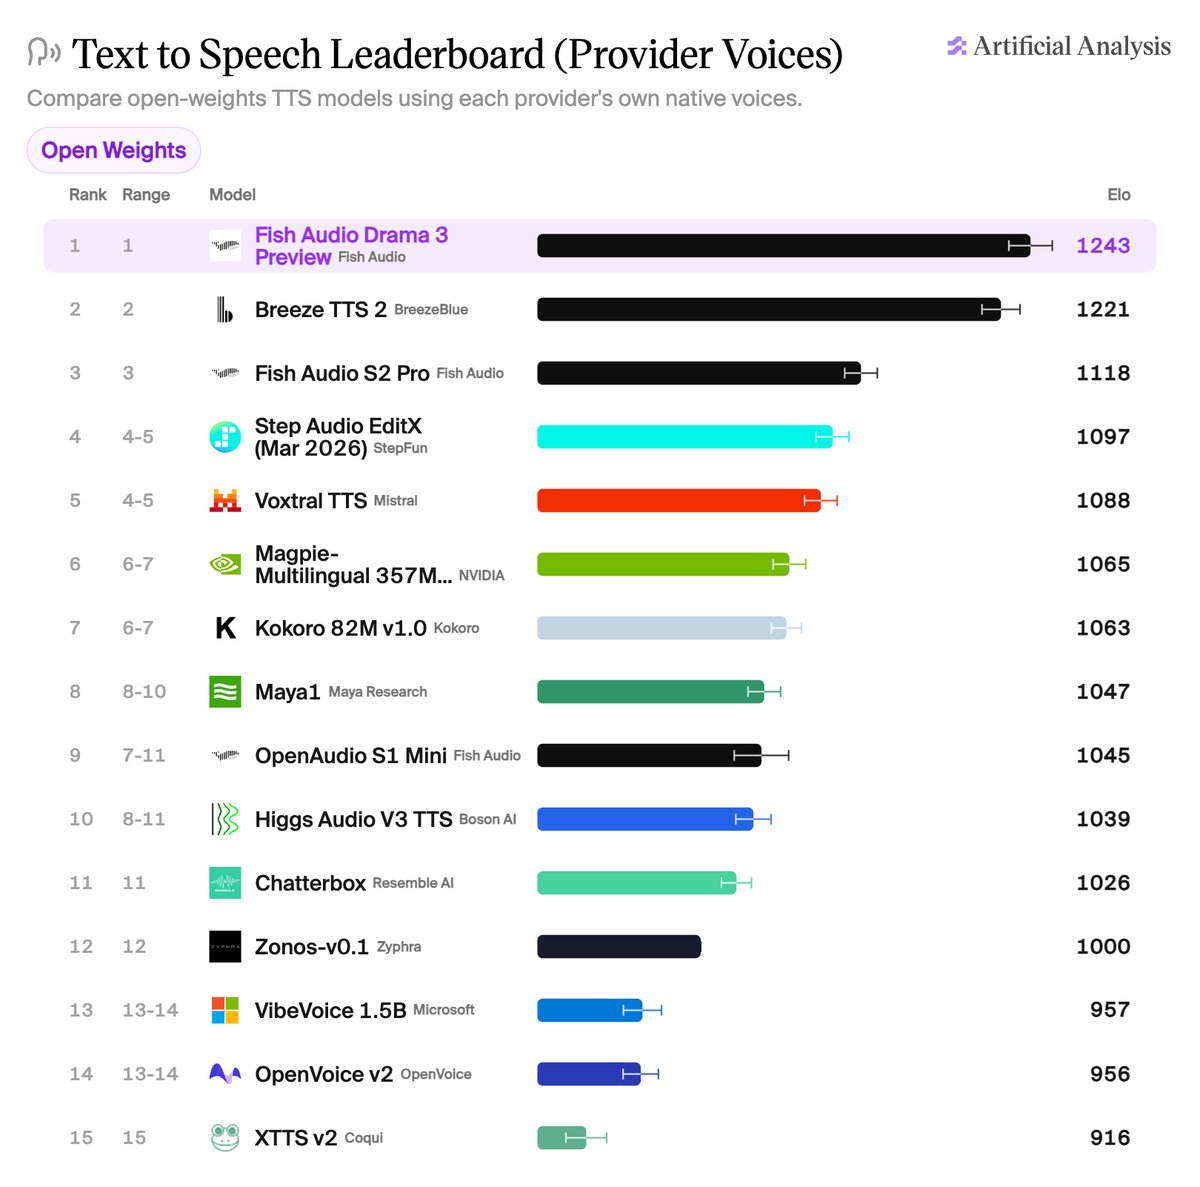
Drama 3는 대본에 기호를 넣는 대신 "인생을 포기한 것처럼 말해" 같은 문장으로 톤을 정하고, 여러 인물이 나오는 장면을 대본 하나로 더빙하는 용도에 맞췄습니다. 다만 공개·비공개 모델을 합친 같은 비교에서는 10위여서, 청취자 선호로는 최상위 비공개 음성을 넘어선 것은 아닙니다. 모델 파일은 Fish Audio 자체 라이선스로 풀렸으니 상업적으로 쓰려면 조건을 먼저 봐야 합니다. Grok Bot은 며칠 전 레고 주문 시연에서 카드 사진으로 결제하라는 안내에 경고가 나왔는데, 이번 버전은 되돌릴 수 없는 일 앞에서 먼저 사람에게 묻습니다. Indra가 스캔본에서 읽는 문자는 라틴·키릴·데바나가리 등이고, 한국어는 지원 목록에 없습니다.
그 밖에: Bloomberg는 Epic Games가 Star Wars·Marvel 캐릭터가 나오는 미공개 Disney 협업 슈팅 게임을 연기하고, 개발자들에게 코드와 그림을 AI 도구로 만들라고 지시했다고 보도했습니다. Character.ai는 12일(현지 시각) 회사 매각을 위해 챕터 11(미국 법원 감독 아래 진행하는 회생 절차)을 신청했습니다. 서비스는 지금 그대로 운영하며, 매각은 11월 말~12월 초 마무리를 목표로 한다고 밝혔습니다.
시사점: Character.ai는 인수자가 나오지 않으면 서비스를 닫는다고 밝혔으니, 이용자라면 유료 기능 변경 공지를 챙겨 보세요. 공개 음성 모델로 더빙을 시험할 때는 라이선스의 상업 이용 조건부터 확인하세요.
#FishAudio#GrokBot#CharacterAI
출처 6🔥 @ArtificialAnlys🔥 @EXM7777💬 @ericzakariasson🔥 @VikParuchuri💬 @unusual_whales💬 @burny_tech
오늘의 감정·온도
오늘의 실무 팁 — 쉽게 풀어 쓴 사용법 6가지
1. Grok Bot에는 '끝났을 때의 모습'부터 적어서 맡깁니다 「Stop Wasting Your Grok Bot Usage」는 많은 사람이 Grok Bot에 막연한 일을 맡기고, 돌려 보다가 잘못 알아들은 걸 깨닫고 처음부터 다시 시키면서 사용량을 낭비한다고 짚습니다. 2번의 새 구독처럼 사용량을 한 통에서 꺼내 쓴다면, 시작 전에 무엇을 어떤 모양으로 끝내면 되는지 적어 두는 것만으로 다시 시키는 횟수를 줄일 수 있습니다.
2. 예·아니오 판단은 판단 전용 모델에 맡겨 볼 수 있습니다 「JEV: YOUR LLM’S SECOND BRAIN (Use Cases)」는 '이 메일이 스팸인가', '어느 작업자에게 넘길까' 같은 단순한 질문에 최상위 모델을 쓰는 건 낭비라며, 이런 판단만 싸게 맡는 모델 Jev를 소개합니다. Artificial Analysis가 새로 낸 판단 전용 모델 비교표 Decision Index에서도 Jev 1.13이 58점으로 1위였고, Claude Haiku 5.5 같은 일반 언어 모델은 더 정확하지만 비용과 응답 시간이 훨씬 컸습니다.
3. 오래 도는 에이전트는 지난 기록을 요약해 가볍게 둡니다 「Building Long-Running Agents with ScaleDown and Deep Agents」는 오래 일하는 에이전트를 만드는 핵심을 '어떤 정보를 언제 AI가 한 번에 보는 작업 공간에 넣을지' 정하는 일로 봅니다. 오래된 대화 기록은 요약하고 도구가 돌려준 긴 결과는 줄여서 넣으라는 것이고, LangChain은 이런 요약·추출·분류만 싸고 빠르게 맡는 ScaleDown의 모델을 지원하기 시작했습니다.
4. 지시 파일은 짧게, 확인 방법은 분명하게 둡니다 Matt Pocock은 에이전트로 코딩할 때 흔히 하는 실수 목록을 올렸습니다. 그중엔 스킬(에이전트에게 주는 작업 설명서)이 너무 긴 것, 모든 작업에서 읽히는 공통 지시 파일이 너무 무거운 것, 에이전트가 자기 작업을 검증할 방법이 없는 것이 있습니다. 에이전트를 옆에서 너무 많이 챙기는 것도 실수로 들었으니, 확인 방법을 먼저 정해 주고 중간 개입은 줄여 보세요.
5. 아낀 시간과 함께 검토에 드는 시간도 셉니다 François Chollet은 에이전트가 기능 하나를 만들며 엔지니어 2시간을 아껴 줘도, 팀 전체가 의견을 맞추고 검토하는 데 3시간이 들면 손해라고 적었습니다. 5번의 Harvard University 연구에서도 코딩 에이전트를 들인 뒤 검토 시간이 49% 길어졌으니, 효과는 코드 줄 수가 아니라 코드가 합쳐질 때까지 걸린 시간으로 재 보세요.
6. 새 모델은 같은 지시로 내 작업에서 직접 견줘 봅니다 Adidotdev가 전한 비교에서는 같은 지시를 줬을 때 Gemini 4 Argon이 10분 동안 주간 사용량의 약 1.5%를, Opus 5.5가 15분 동안 4%를 썼습니다. 한 사람이 한 번 시험한 결과이니 수치보다 방법을 가져다 쓰세요. 자주 맡기는 작업 하나를 정해 두 모델에 똑같이 주고, 걸린 시간과 사용량과 결과를 나란히 적어 두면 됩니다.
📦 확인 방식
Gemini 4 Argon의 공개 범위·요금·공식 점수는 Google 공식 페이지와 발표에서, 증류 방어·자기 복제 시험·Scion은 Anthropic 블로그와 보고서에서 가져왔습니다. The X Subscription의 단계별 세부, 증류 방어의 90~99%, Every 팀의 사용 평가는 외부 독립 검증 전입니다.
🏷 라벨 가이드 — 🔥 일반 확산 · 🔖 북마크 많음 · 🔁 리트윗 비중 높음 · 💬 댓글 비중 높음 · 🚀 작은 계정에서 빠르게 퍼짐