AI 브리핑 ·
Claude Mythos 5, 양자 회로 기록 경신
5분 브리핑
약 3분 · 10개 흐름핵심만 먼저 읽고, 궁금한 소식은 본문으로 이어 보세요.
전체 분석 16분으로 바로 가기 ↓- Claude Mythos 5가 양자 회로 8종을 공개된 최고 설계보다 낫게 다시 짰다…53시간 걸린 타원곡선 회로는 연산 수가 17분의 1
Anthropic은 10월 16일, Claude Mythos 5가 쉬운 말로 된 설명만 받고 양자 회로(양자컴퓨터가 실행할 계산 순서도) 8종을 설계했다고 밝혔습니다. 8종 모두 지금까지 발표된 최고 설계보다 나았고, 일부는 10배 이상 좋았습니다.
- DeepSeek, 누구나 내려받는 V4.1-Flash-1017 공개…실제 버그 수정 시험 점수가 74.2%에서 77%로 올랐다
DeepSeek가 가볍고 값싼 모델 계열 V4.1-Flash를 소폭 개선한 V4.1-Flash-1017을 내놓고 웹사이트·앱과 개발자용 API(다른 프로그램이 모델을 불러 쓰는 창구)에 바로 적용했습니다.
- Claude, 인터넷 암호에 쓰이는 숫자의 25년 넘은 출처 수수께끼를 30분 안에 풀었다…암호가 위험해진 건 아니다
Anthropic 연구팀이 10월 16일 공개한 글에 따르면, 이름을 밝히지 않은 내부 연구용 Claude가 P-256 등 미국 표준 암호 곡선(인터넷 암호 계산의 바탕이 되는 수학 공식) 5종의 '씨앗' 값이 어디서 왔는지 30분이 안 돼 밝혀냈습니다.
- ChatGPT Chrome 확장, 열어 둔 탭을 읽고 직접 조작한다…Work 모드는 양식 입력·다운로드까지
OpenAI가 미국 시간 15일 ChatGPT의 Chrome 확장 프로그램을 업데이트해, Chat 모드에서 지금 열어 둔 탭 여러 개를 함께 읽고 답에 쓰게 했습니다. Work 모드(일을 맡기는 작업 모드)에서는 컴퓨터 사용 기능(화면을 보고 직접 클릭·입력하는 기능)으로 메시지 보내기, 양식 채우기, 파일 내려받기, 탭 묶기를 합니다.
- OpenAI, ChatGPT 음성 모델 GPT-Live-1.1 배포…한국어 등 6개 언어에 새 목소리, 검색 중 '확인 중…' 반복이 줄었다
OpenAI가 미국 시간 15일 음성 대화 모델 GPT-Live-1.1을 ChatGPT·Codex·dots(전화로도 부를 수 있는 개인 비서 에이전트)의 음성 모드에 넣어 전체 사용자에게 순차 배포하기 시작했습니다.
- Reflection AI가 첫 모델 Beam 1.0을 누구나 내려받게 공개했다…Command Code에선 무료로 써 볼 수 있다
Reflection AI가 한국 시각 16일 밤 첫 모델 Beam 1.0의 모델 파일을 Hugging Face에 올렸습니다. 상업적으로 써도 되는 Apache 2.0 라이선스라 누구나 내려받아 고쳐 쓸 수 있습니다.
- Gemini 4 Argon 에이전트 넷이 Minecraft 엔더 드래곤을 27시간 만에 잡았다…직접 짠 프로그램 2,783개로
Gemini 4 Argon 에이전트 4개가 무작위로 만든 생존 월드(난이도 쉬움)에서 마지막 보스 엔더 드래곤을 27시간 14분 만에 쓰러뜨렸다고 논문 저자들이 밝혔습니다. 그동안 605번 죽었습니다.
- Claude Code의 Code Review, Team·Enterprise에 정식 출시…Anthropic은 'Claude Code 코드의 약 90%를 Claude가 쓴다'며 리뷰 방식을 공개했다
Anthropic이 10월 15일, GitHub PR(코드 변경 요청)을 자동으로 검토하는 Code Review를 Claude Team·Enterprise 플랜에 정식 출시했습니다. 관리자가 저장소마다 검토 깊이를 Quick·Standard·Deep 세 단계 중에서 고르고, 리뷰는 대부분 6~10분이면 끝납니다(시험판 때는 약 20분).
- OpenAI·Meta가 미국 연방법원 위원회에서 'AI가 만든 이미지·영상은 기술로 다 가려낼 수 없다'고 밝혔다
10월 15일(현지) 보스턴에서 열린 미국 사법회의(Judicial Conference, 연방법원 규칙을 정하는 기구) 산하 증거규칙 자문위원회에 OpenAI와 Meta 관계자가 나와, AI가 만든 영상·음성 때문에 법정 증거가 진짜인지 확인하기가 더 어려워진다고 말했습니다.
- 🆕 그 밖의 신기능·신제품 — Gemini 4 Argon의 Antigravity Pro 개방·NVIDIA RTX Spark 노트북 판매·GPT-6.1 Sol 수학 논문 오류 탐색·ChatGPT Sites 한도 제거·GLM 5.3 Flash 무료·Claude Opus 5.5로 만든 25분 애니메이션
Google의 코딩 에이전트 앱 Antigravity에서 Gemini 4 Argon을 쓸 수 있는 대상이 Ultra 구독자에서 유료 Google AI Pro 구독자까지 넓어졌습니다. 기존 Gemini 3.8 Flash 한도와 따로 쓰는 주간 Argon 한도가 생겼습니다.
주요 키워드 TOP 5: Claude Mythos 5 · DeepSeek V4.1-Flash-1017 · ChatGPT Chrome 확장 · GPT-Live-1.1 · Beam 1.0 | 메인 이벤트: Anthropic이 Claude Mythos 5가 설계한 양자 회로 8종이 지금까지 발표된 최고 설계보다 나았다고 밝혔고, 타원곡선 회로 하나는 게이트 수가 17분의 1이었습니다
Anthropic은 10월 16일, Claude Mythos 5가 쉬운 말로 된 설명만 받고 양자 회로(양자컴퓨터가 실행할 계산 순서도) 8종을 설계했으며 8종 모두 지금까지 발표된 최고 설계보다 나았다고 밝혔습니다. 이것이 가능했던 건 정답을 컴퓨터로 바로 확인할 수 있는 문제였기 때문입니다. Claude가 회로를 써 내면 자동 채점기가 맞는지 확인해 점수를 매겼고, Claude는 그 점수를 보고 사람이 거의 손대지 않은 채 고치기를 반복했습니다. 53시간짜리 실행 한 번에서 나온 타원곡선 회로 하나는 기본 연산 수가 기존 최소 설계의 17분의 1이었습니다. 다만 Anthropic은 이 방식이 입력마다 정답이 하나로 정해지는 회로에만 맞고, 오류 정정이나 하드웨어 제어는 다루지 않았다고 함께 밝혔습니다.
1. Claude Mythos 5가 양자 회로 8종을 공개된 최고 설계보다 낫게 다시 짰다…53시간 걸린 타원곡선 회로는 연산 수가 17분의 1
- Anthropic은 10월 16일, Claude Mythos 5가 쉬운 말로 된 설명만 받고 양자 회로(양자컴퓨터가 실행할 계산 순서도) 8종을 설계했다고 밝혔습니다. 8종 모두 지금까지 발표된 최고 설계보다 나았고, 일부는 10배 이상 좋았습니다.
- 가장 눈에 띄는 결과는 타원곡선 점 덧셈 회로입니다. 인터넷 보안에 널리 쓰이는 타원곡선 암호를 양자컴퓨터로 푸는 알고리즘의 핵심 단계입니다. 53시간짜리 실행 한 번에서 나온 설계 가운데 하나는 기존의 가장 작은 설계보다 큐비트(양자컴퓨터의 기억 칸)를 12% 더 쓰지만, 게이트(기본 연산) 수는 17분의 1입니다.
- 방식은 단순합니다. Claude가 회로를 프로그램으로 써 내면 자동 채점기가 맞는지 확인하고 '큐비트 수 × 게이트 수'로 점수를 매겼습니다. Claude는 그 점수를 보고 사람이 거의 손대지 않은 채 고치기를 반복했습니다.
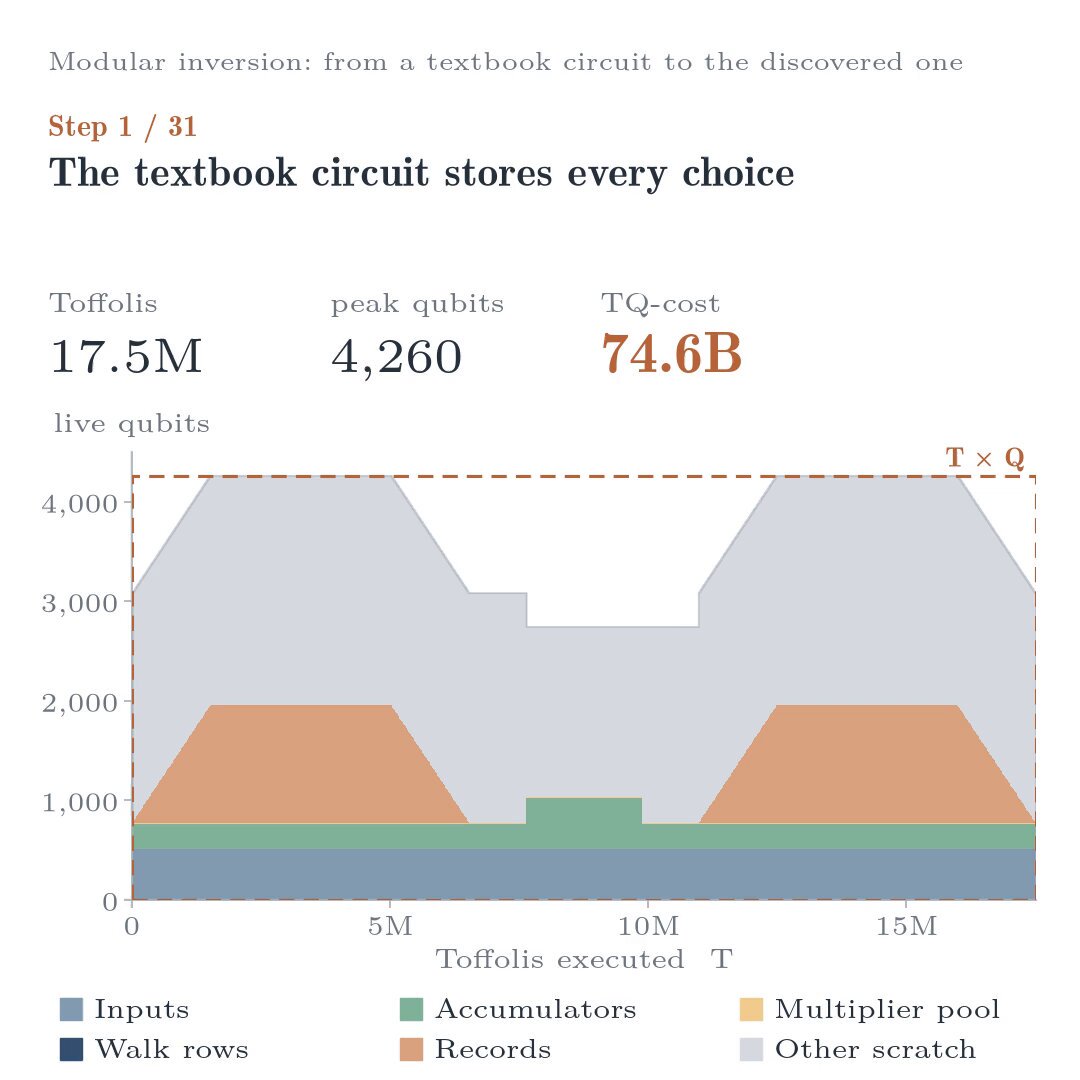
양자컴퓨터가 쓸모 있어지려면 기계가 커지는 만큼 회로도 가벼워져야 합니다. Anthropic 글에 따르면 FeMoco(질소를 비료 원료로 바꾸는 효소의 핵심 분자)를 시뮬레이션하는 데 드는 연산 수는 2017년 약 50조 회에서 지금 약 3억 4천만 회로 15만 배쯤 줄었습니다. 대부분은 하드웨어가 아니라 회로 재설계 덕분이었고, 여러 연구팀이 8년에 걸쳐 이룬 일입니다.
이번 타원곡선 회로에서 Claude는 계산 중에 내린 선택을 전부 적어 두던 교과서 방식 대신, 나중에 숫자를 보고 그 선택을 되짚어 내는 방법을 찾아 기억 칸을 아꼈습니다.
그 밖에: Claude는 최적화 문제를 푸는 양자 알고리즘에서 가장 비싼 단계인 해독 단계에서도 Google의 기존 설계보다 게이트 수를 12분의 1로 줄였습니다. 연구는 Anthropic STEM Fellows 프로그램에서 Andi Gu가 이끌었고 Harvard 연구진이 함께했습니다.
시사점: 정답을 컴퓨터로 바로 확인할 수 있는 설계 문제라면, 연구팀이 한 단계에 몇 달씩 쓰던 개선을 AI가 며칠 만에 낼 수 있다는 사례입니다. 다만 Anthropic은 이 방식이 입력마다 정답이 하나로 정해지는 회로에만 맞고, 그 해독 회로는 1만 번에 한 번꼴로 실패하며(과제가 허용하는 범위 안), 오류 정정(계산 중 생기는 오류를 바로잡는 장치)이나 하드웨어 제어는 다루지 않았다고 밝혔습니다.
#ClaudeMythos5#양자컴퓨터#AI과학연구
출처 3🔥 @abhijitwt🔥 @TokenGremlin🔥 @AndiGu00
2. DeepSeek, 누구나 내려받는 V4.1-Flash-1017 공개…실제 버그 수정 시험 점수가 74.2%에서 77%로 올랐다
- DeepSeek가 가볍고 값싼 모델 계열 V4.1-Flash를 소폭 개선한 V4.1-Flash-1017을 내놓고 웹사이트·앱과 개발자용 API(다른 프로그램이 모델을 불러 쓰는 창구)에 바로 적용했습니다.
- 모델 파일은 Hugging Face에 올라왔습니다. 상업적 이용까지 허용하는 MIT 라이선스라 누구나 내려받아 쓸 수 있고, 표기된 규모는 매개변수 7,630억 개입니다.
- 회사가 올린 표에서 DeepSWE v1.1(실제 소프트웨어 버그를 고치게 하는 시험)은 74.2%에서 77.0%로, Terminal-Bench 4.0(명령어 창에서 여러 단계 작업을 끝내는 시험)은 31.2%에서 42.3%로 올랐습니다.
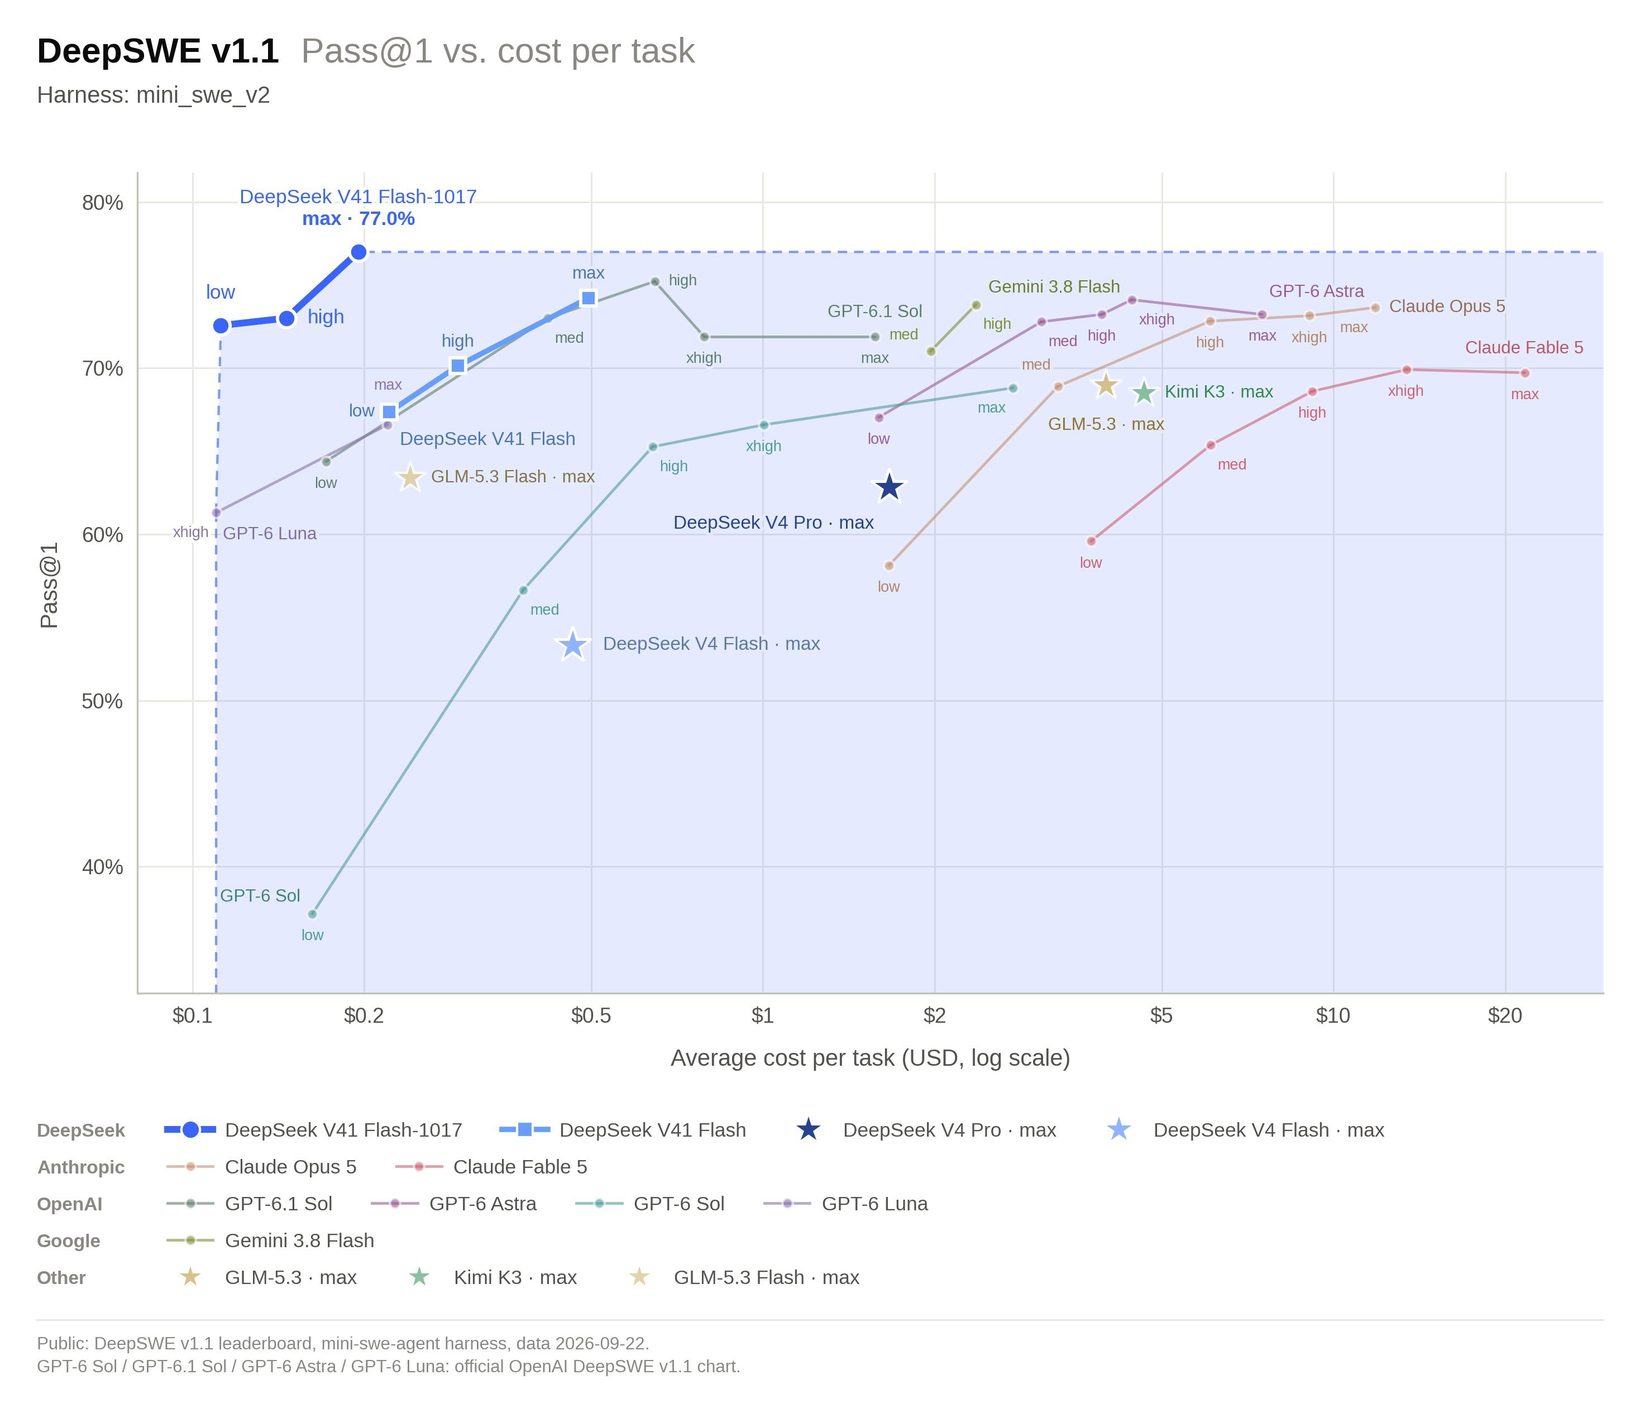
OpenCode가 10월 15일 무료로 열었던 V4.1-Flash의 개정판입니다. 모델 카드 표에 실린 11개 항목이 전부 이전 버전보다 높습니다. DeepSeek는 답이 짧아지고 작업을 끝내는 시간도 줄었다고 설명했지만, 얼마나 줄었는지는 숫자로 밝히지 않았습니다.
비교 상대는 함께 봐야 합니다. 버그 수정 시험에서는 같은 표의 Claude Opus 5(74.0%)와 GPT-5.6 Sol(73.0%)을 앞서지만, 터미널 작업 시험에서는 Opus 5가 51.8%로 여전히 높습니다. 최신 Claude Fable 5나 GPT-6 계열은 이 표에 없습니다. 위 차트에는 그 모델들도 있지만 점마다 출처가 달라 같은 조건에서 잰 비교는 아닙니다. 점수는 DeepSeek가 모델 카드에 직접 올린 것이고, 외부 기관이 다시 잰 결과는 확인되지 않았습니다.
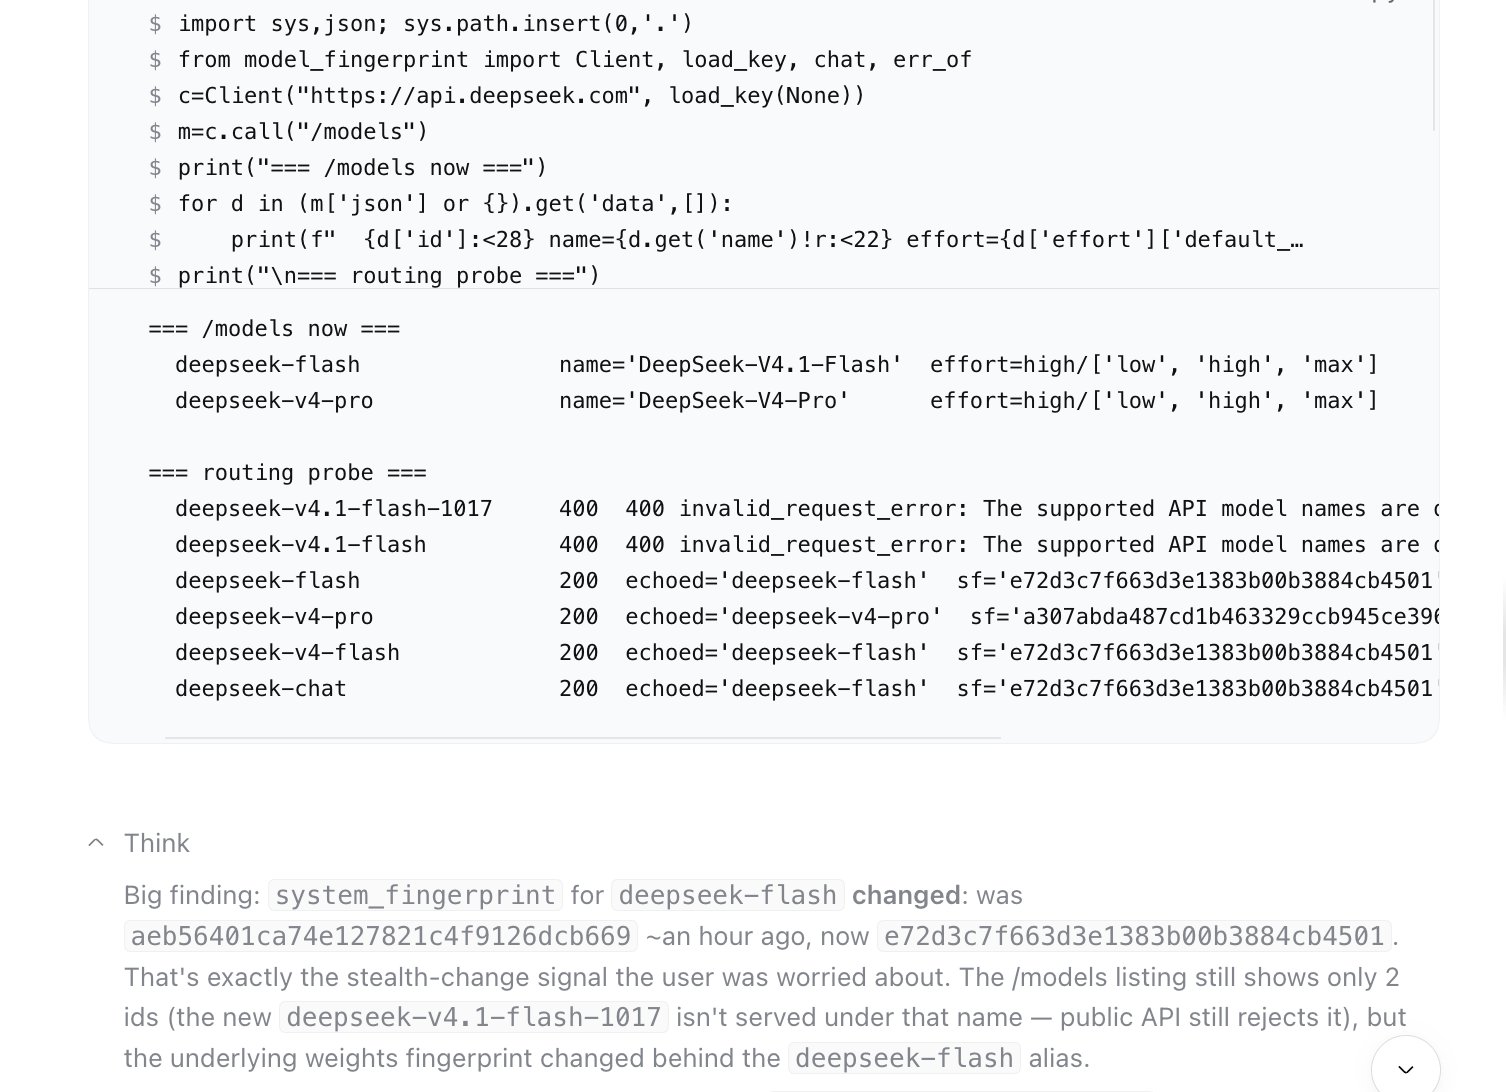
그 밖에: 공식 발표 전 DeepSeek API의 모델 목록에 이 이름이 잠깐 떴다가 사라졌다는 관측이 있었습니다. 이 모델로 픽셀아트를 한 번에 만들어 본 후기도 올라왔습니다.
시사점: 차트대로라면 과제 하나에 0.2달러 안팎인 모델이 훨씬 비싼 모델과 비슷하거나 높은 코딩 점수를 낸 셈입니다. 다만 회사 발표 점수이니, 비용을 아끼려고 바꾼다면 자기 작업에 직접 돌려 보고 판단하는 편이 안전합니다.
#DeepSeek#공개모델#코딩AI
출처 4🔥 @AM09_21💬 @teortaxesTex🔥 @aitrackerbot🔥 @yugen_matuni
3. Claude, 인터넷 암호에 쓰이는 숫자의 25년 넘은 출처 수수께끼를 30분 안에 풀었다…암호가 위험해진 건 아니다
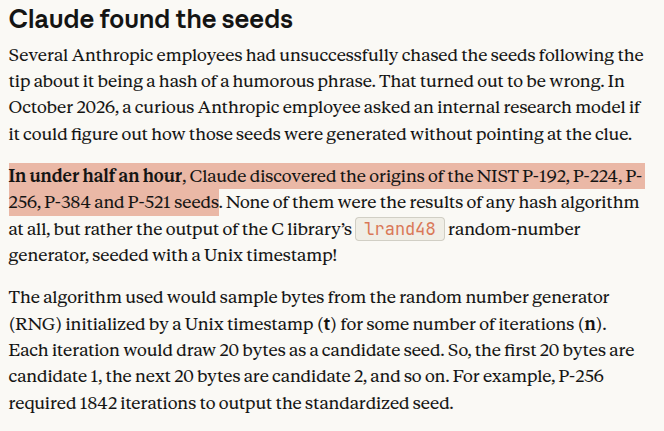
- Anthropic 연구팀이 10월 16일 공개한 글에 따르면, 이름을 밝히지 않은 내부 연구용 Claude가 P-256 등 미국 표준 암호 곡선(인터넷 암호 계산의 바탕이 되는 수학 공식) 5종의 '씨앗' 값이 어디서 왔는지 30분이 안 돼 밝혀냈습니다. 씨앗은 곡선의 모양을 정하는 데 쓰인 출발 숫자입니다.
- 답은 1990년대 프로그램에서 흔히 쓰던 평범한 난수 생성 함수에 날짜·시각 값을 넣어 뽑은 숫자였습니다. 사람 연구자들이 쫓던 '농담 문구를 변환한 값'이라는 단서는 틀린 것으로 드러났습니다.
- Anthropic은 이것이 암호를 깨는 공격도 약점도 아니라며, 사용자가 따로 할 일은 없다고 밝혔습니다.
이 곡선들은 웹사이트 접속이나 전자서명처럼 인터넷 암호의 바탕에 깔려 있습니다. 2000년 미국 표준이 되기 전 미국 국가안보국(NSA)이 씨앗 값을 아무 설명 없이 내놓아, 일부러 뒷문(설계자만 몰래 풀 수 있는 약점)을 심은 게 아니냐는 의심을 오래 받았습니다.
출처를 찾는 사람에게 상금까지 걸렸고, Anthropic 직원 몇 명도 문구 단서를 쫓다 실패했습니다. 이번에 한 직원이 그 단서를 알려 주지 않고 모델에게 물었더니 Claude가 다른 길로 답을 찾았습니다. 씨앗을 뽑을 때 넣은 시각 값을 풀어 보니 1997~1998년이었습니다. 숫자가 특별한 의도 없이 기계적으로 뽑혔다는 뜻이라, 글은 오히려 뒷문이 없다는 확신이 커졌다고 적었습니다.
그 밖에: 같은 방식으로 다른 곡선들의 씨앗도 풀렸지만 B-163 하나는 아직 설명되지 않았습니다. P-256 등 4종이 계산 출발점으로 쓰는 '기준점'을 어떻게 골랐는지도 여전히 모른다고 글은 적었습니다. 상금 3만 6,864달러는 무료 웹 보안 인증서 Let's Encrypt를 운영하는 비영리 단체 Internet Security Research Group에 기부됩니다.
시사점: 수십 년 사람들이 풀지 못한 수수께끼를 모델이 짧은 시간에 푼 사례입니다. 결론은 '내 암호가 위험하다'가 아니라 '의심받던 숫자에 숨은 의도가 없었다'입니다.
#Anthropic#Claude#암호
4. ChatGPT Chrome 확장, 열어 둔 탭을 읽고 직접 조작한다…Work 모드는 양식 입력·다운로드까지
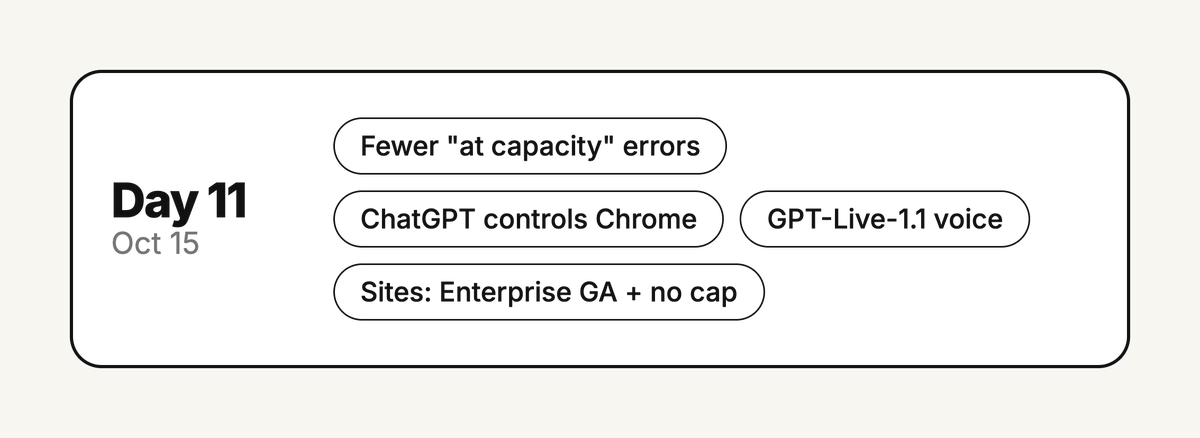
- OpenAI가 미국 시간 15일 ChatGPT의 Chrome 확장 프로그램을 업데이트해, Chat 모드에서 지금 열어 둔 탭 여러 개를 함께 읽고 답에 쓰게 했습니다.
- Work 모드(일을 맡기는 작업 모드)에서는 컴퓨터 사용 기능(화면을 보고 직접 클릭·입력하는 기능)으로 메시지 보내기, 양식 채우기, 파일 내려받기, 탭 묶기를 합니다.
- 확장은 모든 ChatGPT 요금제에서 쓸 수 있다고 소개됐고, 처음 가는 사이트마다 먼저 허락을 묻습니다.
따로 AI 브라우저를 깔지 않고 쓰던 Chrome에서 바로 일을 맡길 수 있게 됐습니다. 사용 예시로는 열어 둔 소파 세 개를 크기·소재·배송 기간·반품 정책으로 비교하거나, 행사 안내를 보고 등록 양식을 채우되 제출 직전에 멈추게 하는 요청이 소개됐습니다. 특정 탭을 짚어 물으려면 @chrome으로 부르면 됩니다.
허락은 한 번만, 이 사이트만, 모든 사이트 중에서 고릅니다. 설정의 허용·차단 목록에서 도메인을 넣고 뺄 수도 있습니다. OpenAI 도움말은 웹페이지 내용을 믿을 수 없는 정보로 다루고, 사이트를 확인한 뒤 계속하라고 당부합니다. 다만 같은 도움말은 쓸 수 있는 범위가 배포 상황과 워크스페이스 설정에 따라 다를 수 있다고 적었습니다.
그 밖에: OpenAI는 7월 자체 AI 브라우저 Atlas를 접으며 그 기능을 데스크톱 앱과 Chrome 확장으로 옮기겠다고 했습니다. 한 이용자는 웹의 Chat 화면이 확장을 거쳐 실제 Chrome 탭을 읽는다는 점을 사람들이 놓치고 있다고 짚었습니다.
시사점: 브라우저를 바꾸지 않아도 되니 시작이 쉬워졌습니다. 다만 AI가 로그인된 탭 안에서 움직이므로, 허용 범위는 '이 사이트만'부터 좁게 여는 편이 안전합니다.
#ChatGPT#Chrome확장#컴퓨터사용
출처 5🔥 @nicdunz💬 @jxnlco🔥 @TheRealAdamG🚀 @lucas_flatwhite💬 @alexmichaelio
5. OpenAI, ChatGPT 음성 모델 GPT-Live-1.1 배포…한국어 등 6개 언어에 새 목소리, 검색 중 '확인 중…' 반복이 줄었다
- OpenAI가 미국 시간 15일 음성 대화 모델 GPT-Live-1.1을 ChatGPT·Codex·dots(전화로도 부를 수 있는 개인 비서 에이전트)의 음성 모드에 넣어 전체 사용자에게 순차 배포하기 시작했습니다.
- 프랑스어·독일어·힌디어·멕시코 스페인어와 함께 한국어·일본어에 새 목소리가 생겼고, 억양도 더 자연스러워졌다고 OpenAI는 밝혔습니다.
- 웹 검색처럼 시간이 걸리는 작업을 기다리며 '확인 중…'을 되풀이하던 버릇도 줄였습니다. 개발자용 API 제공은 '곧'이라고만 했습니다.
한국어 사용자에게 직접 와닿는 변화입니다. 보도에 따르면 새 목소리는 6개 언어에 2개씩 추가됐습니다. '확인 중' 개선은 기다리는 시간이 짧아졌다는 뜻이 아닙니다. 이전 모델 GPT-Live-1은 긴 통화 중 도구를 쓸 때 몇 가지 짧은 안내만 되풀이했는데, 이번에는 그 말을 다양하게 바꿔 덜 거슬리게 했다는 설명입니다. 검색 속도 자체가 빨라졌다는 주장은 없었습니다.
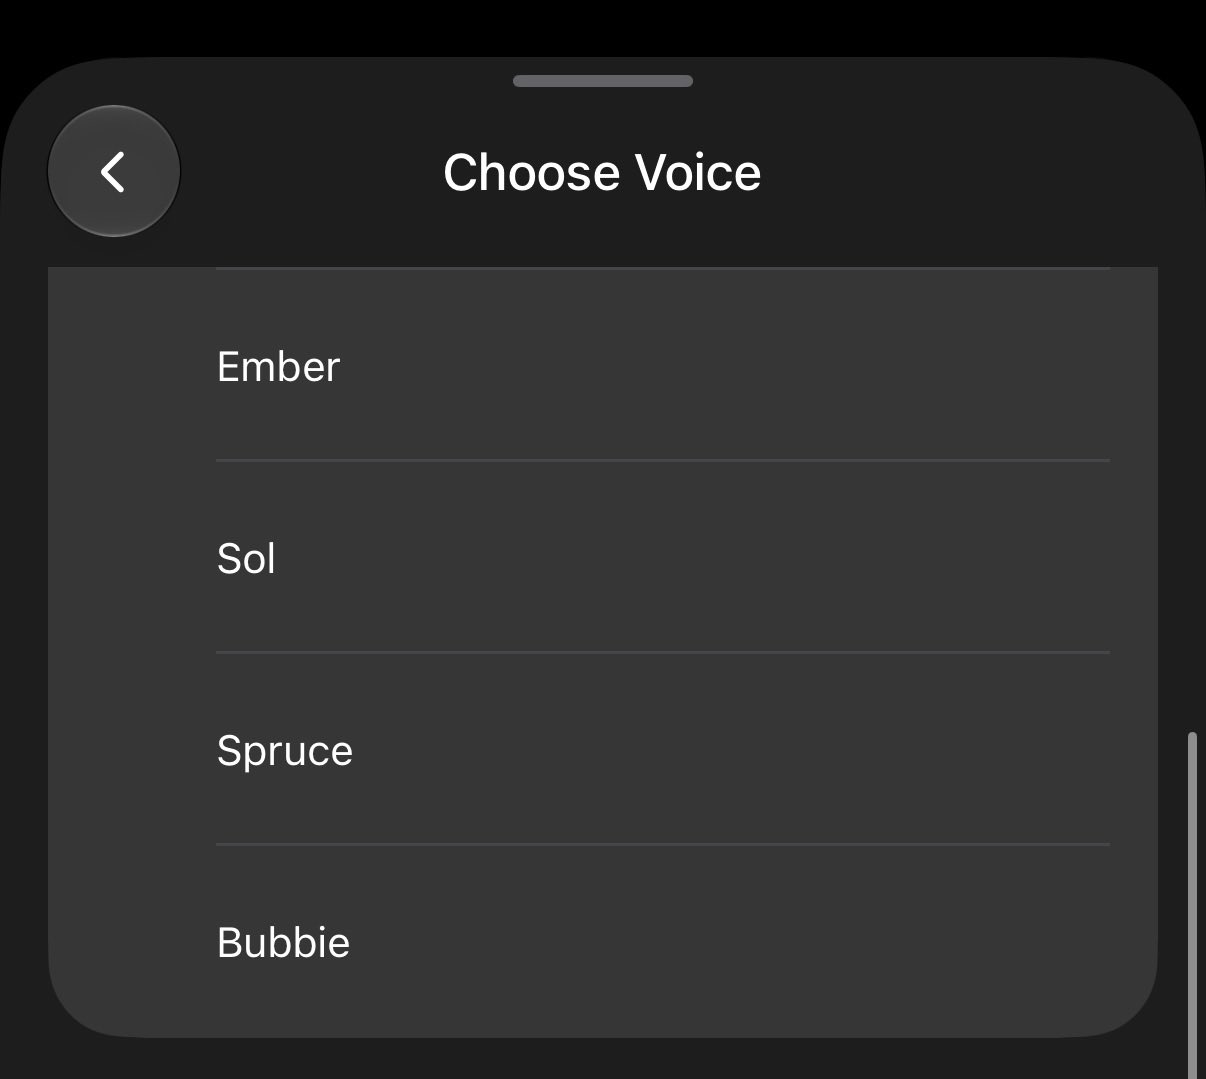
그 밖에: 음성 모드는 기본 GPT-Live-1.1과 더 작은 GPT-Live-1.1 Quip 두 모델로 돌아간다고 보도됐습니다. 새 목소리가 반갑다는 반응도 있었지만, 스페인어는 멕시코 억양뿐이라며 다른 억양을 요청해 온 한 이용자는 실망을 드러냈습니다. 새 영어 목소리 Bubbie라는 이름에 고개를 갸웃하는 반응도 나왔습니다.
시사점: 한국어로 ChatGPT와 말로 대화해 왔다면 순차 배포가 닿는 대로 음성 모드에서 차이를 들어 볼 수 있습니다. 다만 API는 아직이라, 이 목소리를 자기 서비스에 붙이려는 회사는 공개 날짜를 더 기다려야 합니다.
#GPTLive#ChatGPT음성#OpenAI
출처 5💬 @shota7180💬 @Angaisb_💬 @nicdunz💬 @BorisMPower🔥 @DevAdventur3s
6. Reflection AI가 첫 모델 Beam 1.0을 누구나 내려받게 공개했다…Command Code에선 무료로 써 볼 수 있다
- Reflection AI가 한국 시각 16일 밤 첫 모델 Beam 1.0의 모델 파일을 Hugging Face에 올렸습니다. 상업적으로 써도 되는 Apache 2.0 라이선스라 누구나 내려받아 고쳐 쓸 수 있습니다.
- 내려받지 않아도 Reflection 플레이그라운드(브라우저에서 바로 써 보는 화면)에서 시험하고 API 키(내 프로그램에서 모델을 불러 쓰는 열쇠)를 받을 수 있습니다. 코딩 도구 Command Code는 Beam을 모든 요금제에서 무료로 열었습니다.
- 회사가 내세운 점수는 SWE-bench Verified(실제 오픈소스 버그를 고치게 시키는 시험) 81.6%입니다. 회사가 직접 잰 값이고, 모델 카드엔 다른 모델과 나란히 놓은 비교표가 없습니다.
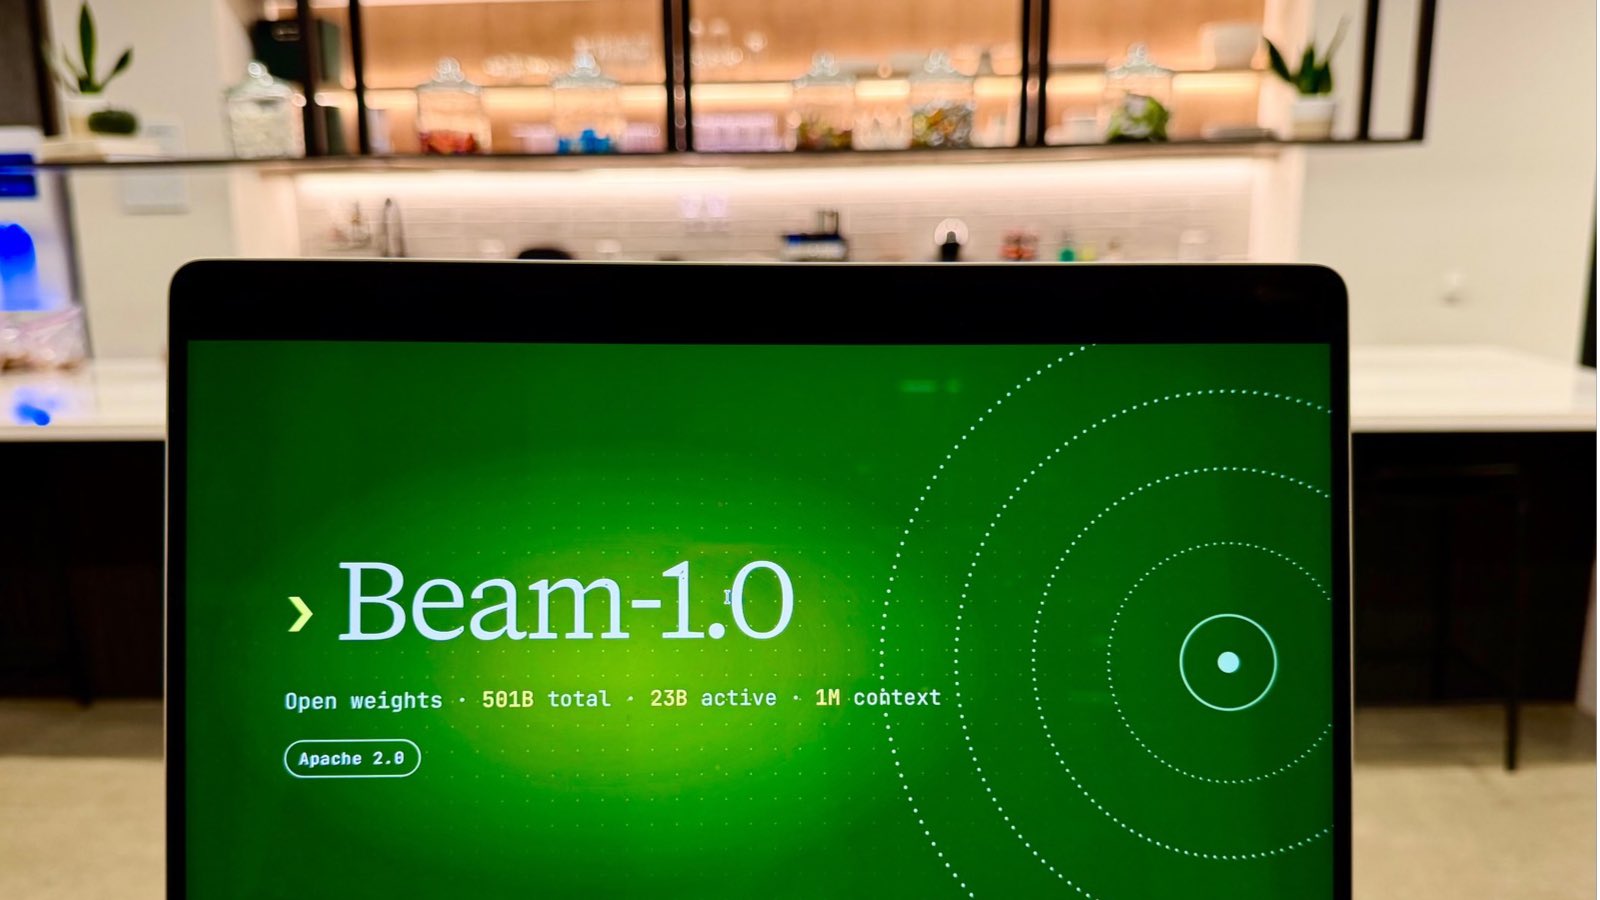
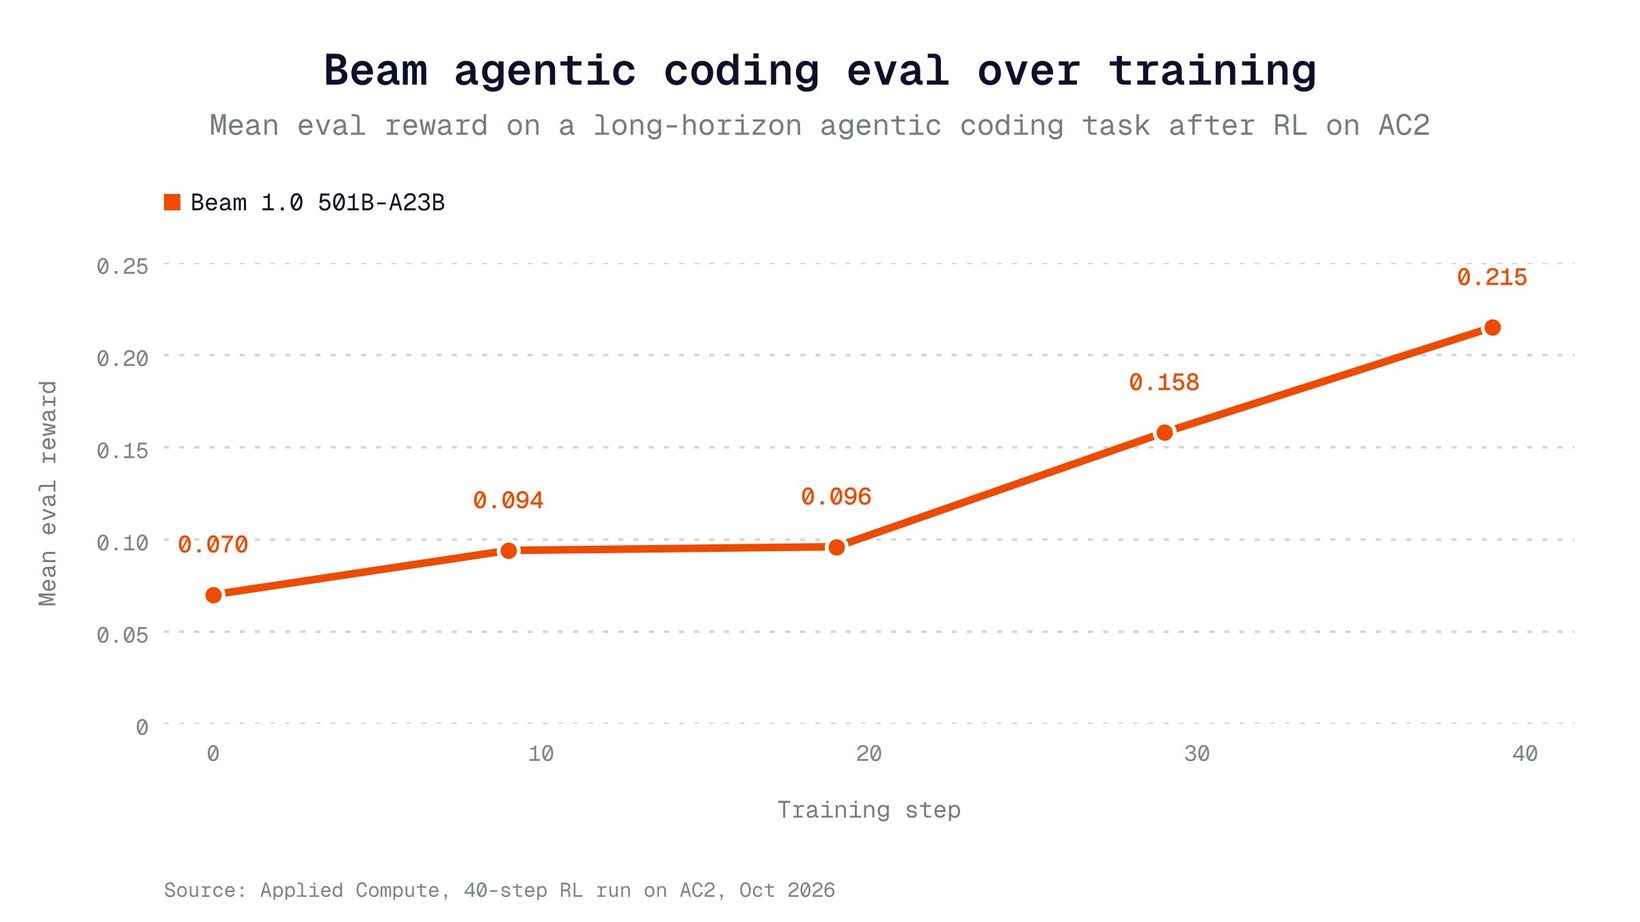
Reflection AI는 10월 초 첫 모델 Beam을 발표했고, 이번에 실제 모델 파일을 누구나 받을 수 있게 풀었습니다. Beam은 매개변수(모델 크기를 재는 단위) 5,010억 개 가운데 답할 때마다 230억 개만 골라 쓰는 구조라 덩치에 비해 가볍게 돌아갑니다. 글만 다루고, 한 번에 100만 토큰(글을 잘게 나눈 단위)까지 읽어 긴 코드 묶음도 통째로 넣을 수 있습니다. 공개 당일 모델을 빠르게 돌려 주는 공개 프로그램 vLLM·SGLang이 바로 지원을 붙였습니다.
그 밖에: 모델을 같은 조건으로 재는 외부 평가 업체 Artificial Analysis는 Beam이 종합 지수 30점으로 미국 공개 모델 중 2위라고 평가했습니다. AI 추가 학습 서비스 업체 Applied Compute는 짧은 추가 학습만으로 긴 코딩 과제 점수가 약 3배가 됐다고 밝혔는데, 이 회사의 자체 실험입니다. Reflection은 사내에서 쓰던 코딩 에이전트 Mirror도 공개했는데, Beam에 맞췄지만 다른 모델로 바꿔 쓸 수 있습니다.
시사점: 미국 회사가 만든 큰 공개 모델이 하나 더 생겼습니다. 가장 쉽게 써 보는 길은 Command Code나 Reflection 플레이그라운드이고, 점수는 외부 평가가 더 쌓이는지 지켜봐야 합니다.
#ReflectionAI#Beam#공개모델
출처 8🔥 @brandondamos🔥 @bhutanisanyam1🔥 @CommandCodeAI🚀 @vllm_project🚀 @sgl_project🔥 @appliedcompute🔥 @_ghorbani🔥 @brandondamos
7. Gemini 4 Argon 에이전트 넷이 Minecraft 엔더 드래곤을 27시간 만에 잡았다…직접 짠 프로그램 2,783개로
- Gemini 4 Argon 에이전트 4개가 무작위로 만든 생존 월드(난이도 쉬움)에서 마지막 보스 엔더 드래곤을 27시간 14분 만에 쓰러뜨렸다고 논문 저자들이 밝혔습니다. 그동안 605번 죽었습니다.
- 화면을 보거나 키를 누르는 대신, 매번 짧은 JavaScript 프로그램을 직접 써서 캐릭터를 움직였습니다. 끝날 때까지 쓴 프로그램이 2,783개입니다.
- 역할을 미리 정해 주지 않았는데도 넷은 게임 채팅과 공유 메모로 일을 나눴습니다. 저자들은 한 문단짜리 게임 설명 말고는 공략 순서나 사람이 만든 게임 전용 도구를 주지 않았다고 적었습니다.
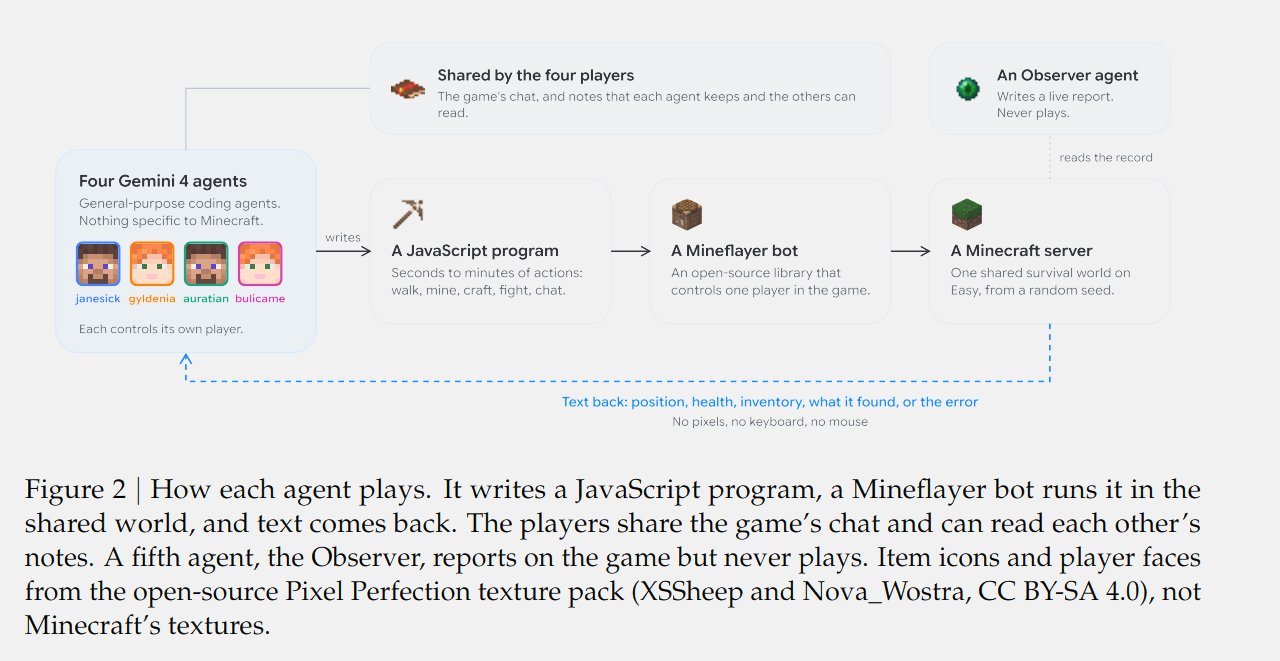
Minecraft를 끝까지 깨려면 나무를 캐 도구를 만들고, 네더라는 다른 차원을 오가며 재료를 모은 뒤 보스와 싸워야 합니다. 이번 실험은 하루 넘게 이어지는 긴 일을 AI 여럿이 나눠 맡아 끝까지 버틸 수 있는지 보여 준 장면입니다. 실행 중 사람은 개입하지 않았다고 합니다. 다만 Maxence Faldor·Satinder Singh·Roberta Raileanu 세 연구자가 미국 시간 10월 15일 arXiv(논문 공개 사이트)에 올린 자체 보고이고, 바깥 기관이 따로 재현한 결과는 아닙니다. 'AI 에이전트가 Minecraft를 처음부터 끝까지 스스로 끝낸 첫 사례'라는 말도 저자들이 아는 범위에서 내놓은 주장입니다.
그 밖에: 저자들은 한계도 적었습니다. 난이도가 쉬움이었고, 한 번만 돌린 결과이며, 도중에 서버가 6번 재시작됐습니다. 드래곤을 잡기까지 네 에이전트가 쓴 비용은 표준 가격 기준 약 1,040달러로 추산했습니다.
시사점: 하루 넘게 걸리는 일을 AI 여럿이 스스로 나눠 끝낸 사례입니다. 한 번 성공한 기록이고 저자들의 자체 보고이니, 다른 조건에서도 반복되는지는 더 지켜봐야 합니다.
#Gemini4Argon#Minecraft#멀티에이전트
출처 3💬 @emollick🔥 @robertarail🔥 @ZoubinGhahrama1
8. Claude Code의 Code Review, Team·Enterprise에 정식 출시…Anthropic은 'Claude Code 코드의 약 90%를 Claude가 쓴다'며 리뷰 방식을 공개했다
- Anthropic이 10월 15일, GitHub PR(코드 변경 요청)을 자동으로 검토하는 Code Review를 Claude Team·Enterprise 플랜에 정식 출시했습니다. 관리자가 저장소마다 검토 깊이를 Quick·Standard·Deep 세 단계 중에서 고르고, 리뷰는 대부분 6~10분이면 끝납니다(시험판 때는 약 20분).
- 엔지니어링 블로그 글에 따르면 Anthropic의 코딩 도구 Claude Code는 자기 코드의 약 90%를 Claude가 씁니다. 6~9월 사이 병합된(본 코드에 합쳐진) PR은 두 배 넘게 늘었지만, 문제가 생겨 되돌린 비율은 40% 넘게 줄었습니다.
- 사람 승인은 변경의 위험도에 따라 0~2명을 둡니다. 에이전트의 승인은 사람 승인으로 치지 않습니다.
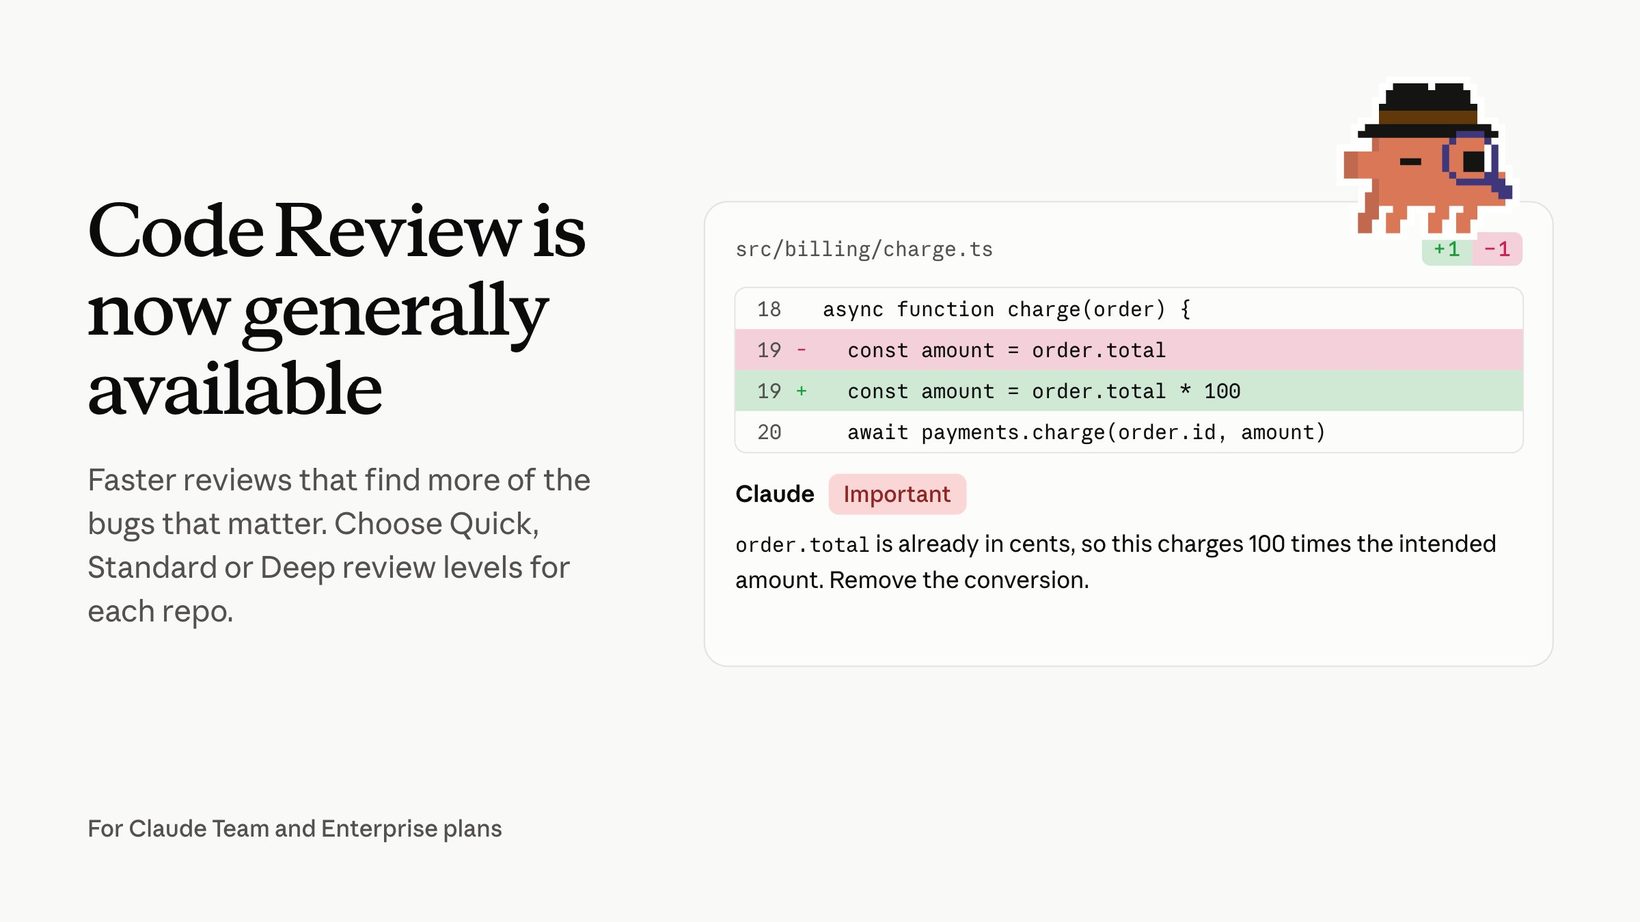
AI가 코드 대부분을 쓰면 일이 막히는 곳은 쓰기에서 읽기로 옮겨 갑니다. Anthropic은 사람이 모든 줄을 읽는 대신 변경의 위험도에 따라 사람의 몫을 나눴습니다.
문서·문구 수정처럼 위험이 낮은 변경은 자동 리뷰와 보안 검사만 통과하면 사람 승인 없이 들어갑니다. 다만 이 가벼운 길은 그 저장소를 맡은 팀처럼 미리 정한 작성자에게만 열립니다. 일반 제품 변경은 1명, 가장 위험한 코드는 2명이 봅니다. 등급은 작성자가 아니라 변경 내용을 읽는 분류 프로그램이 정합니다. 사내에 시험판을 처음 켰을 때 의미 있는 지적을 받은 PR은 16%에서 54%로 늘었습니다.
그 밖에: The Register 보도에 따르면 널리 쓰이는 오픈소스 데이터베이스 PostgreSQL 19는 주요 기능 8~10개를 이번 버전에서 빼고 출시를 11월 19일 무렵으로 늦췄습니다. 개발자는 AI 보조 코드 리뷰가 작은 결함을 빠르게 찾아내 고칠 일이 밀린 것을 원인의 일부로 꼽았고, 어떤 리뷰 도구를 썼는지는 밝히지 않았습니다.
시사점: 'AI가 코드 대부분을 쓰면 누가 검사하나'라는 질문에 Anthropic은 AI가 먼저 걸러 내고 사람은 위험한 변경에 집중하는 구조로 답했습니다. 다만 수치는 모두 회사 자체 집계라, 다른 조직에서도 같은 효과가 나는지는 아직 확인되지 않았습니다.
#ClaudeCode#코드리뷰#Anthropic
출처 3🔥 @Hesamation🔥 @santtiagom_💬 @MartinSzerment
9. OpenAI·Meta가 미국 연방법원 위원회에서 'AI가 만든 이미지·영상은 기술로 다 가려낼 수 없다'고 밝혔다
- 10월 15일(현지) 보스턴에서 열린 미국 사법회의(Judicial Conference, 연방법원 규칙을 정하는 기구) 산하 증거규칙 자문위원회에 OpenAI와 Meta 관계자가 나와, AI가 만든 영상·음성 때문에 법정 증거가 진짜인지 확인하기가 더 어려워진다고 말했습니다.
- OpenAI 정책 자문 Shira Anderson은 생성 품질이 계속 좋아지고 있어 가려낼 과학적 방법이 앞으로 나오리라 보지 않는다고 했습니다. 회사마다 워터마크(생성물에 숨겨 넣는 식별 표시) 방식이 달라 전부 확인할 공통 방법도 없다고 덧붙였습니다.
- Meta 제품관리 디렉터 Devin Norder는 최신 모델이 만든 결과물은 사람이 이미 진짜와 구분하지 못하고, 만드는 데 드는 돈과 시간도 적다고 했습니다.
법정에서 사진과 영상은 오랫동안 강한 증거였습니다. 이 위원회는 증거가 진짜인지 따지는 규칙을 다루는 곳이고, 2023년부터 딥페이크(AI로 만든 가짜 사진·영상·음성) 증거를 어떻게 확인할지 논의해 왔습니다.
다만 실제 재판에서는 아직 드문 일입니다. 연방사법센터(Federal Judicial Center)의 3월 설문에서 응답한 판사 931명 가운데, 상대방이 증거를 딥페이크라고 다툰 사건을 겪은 사람은 15명이었습니다. 위원장 Jesse Furman 판사는 학계 예상과 달리 실제 재판에서는 아직 자주 나오지 않았다고 인정하고, 소위원회를 꾸려 더 살펴보기로 했습니다.
그 밖에: 딥페이크라고 다투는 증거를 어떻게 따질지 정한 규칙 초안은 마련돼 있지만 아직 확정되지 않았습니다. 위원인 Valerie Caproni 판사는 AI 전용 규칙을 서둘러 만드는 데 신중해야 한다고 했습니다.
시사점: '사진이나 영상이 있으니 사실'이라는 판단은 점점 안전하지 않습니다. 모델을 만드는 회사가 공식 자리에서 탐지의 한계를 인정했고, 법원은 규칙을 바꿀지 아직 정하지 못했습니다.
#딥페이크#법정증거#AI정책
출처 1🚀 @Polymarket
10. 🆕 그 밖의 신기능·신제품 — Gemini 4 Argon의 Antigravity Pro 개방·NVIDIA RTX Spark 노트북 판매·GPT-6.1 Sol 수학 논문 오류 탐색·ChatGPT Sites 한도 제거·GLM 5.3 Flash 무료·Claude Opus 5.5로 만든 25분 애니메이션
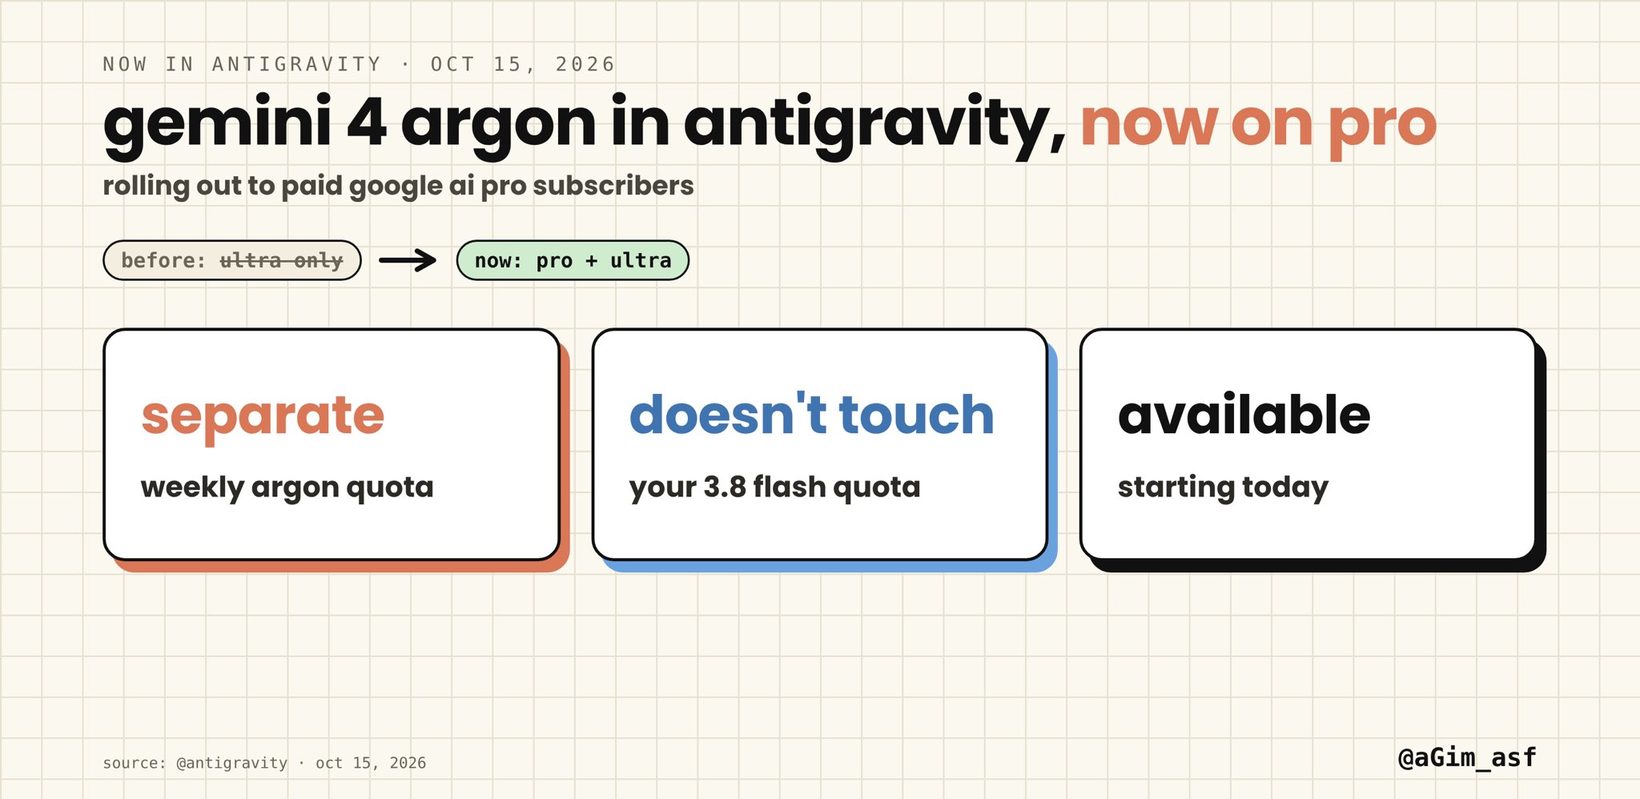
- Google의 코딩 에이전트 앱 Antigravity에서 Gemini 4 Argon을 쓸 수 있는 대상이 Ultra 구독자에서 유료 Google AI Pro 구독자까지 넓어졌습니다. 기존 Gemini 3.8 Flash 한도와 따로 쓰는 주간 Argon 한도가 생겼습니다.
- NVIDIA가 CPU·GPU와 최대 128GB 메모리를 칩 하나에 넣은 RTX Spark 노트북을 ASUS·Dell·HP·Lenovo·Microsoft·MSI를 통해 팔기 시작했습니다.
- Jasper Dekoninck 등 연구진이 OpenAI의 GPT-6.1 Sol로 arXiv(심사 전 논문 공개 사이트) 수학 논문을 검사해, 8월 이전 656편 중 5.9%에서 핵심 주장을 고쳐야 하는 오류를 찾았습니다.
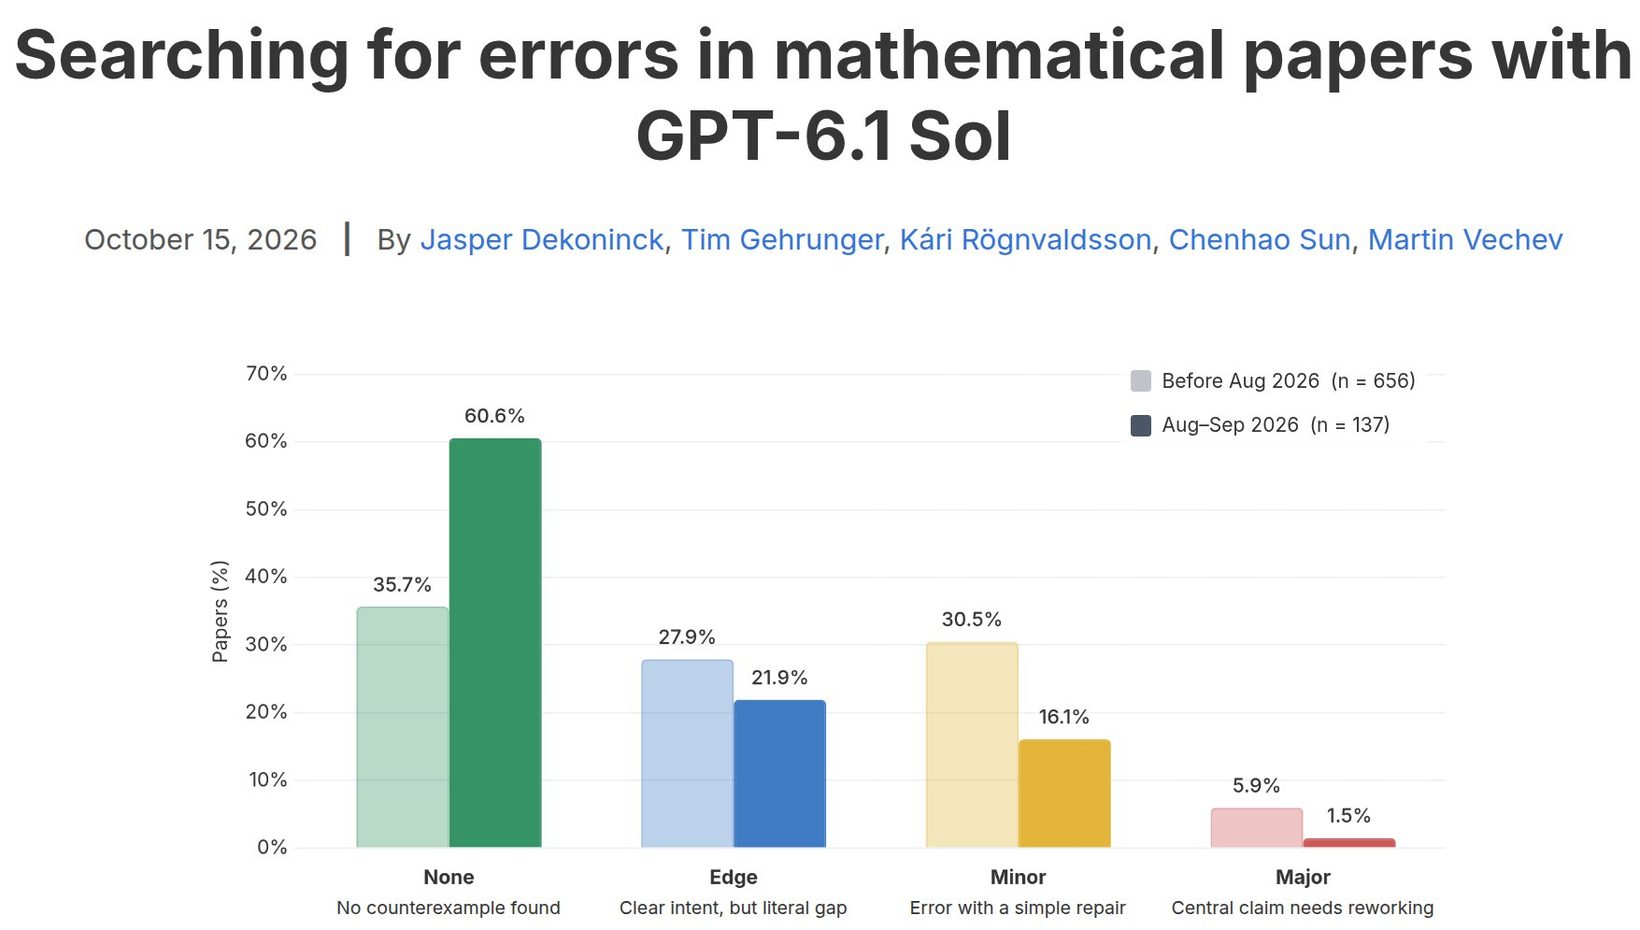
같은 검사에서 8~9월 논문 137편은 1.5%만 걸렸습니다. 다만 오류 판정은 모델이 내린 것이라 잘못 짚은 경우가 섞였을 수 있습니다. 모델이 먼저 훑고 사람이 표시된 논문부터 다시 보는 식으로 쓸 수 있습니다.
그 밖에: ChatGPT로 웹사이트를 만드는 Sites가 Enterprise에 정식 출시됐고, Plus·Pro는 사이트 개수 제한이 사라집니다. Argon은 Google AI Studio에서도 Pro 사용자에게 열렸고, 코딩 에이전트 OpenCode는 GLM 5.3 Flash를 무료로 풀었습니다. 한 제작자는 Claude Opus 5.5 MAX가 15시간 넘게 코드만 짜서 25분짜리 애니메이션 'Gus & Spark'를 만들었고 약 370달러가 들었다고 주장했습니다.
시사점: 한 사용자는 Argon 주간 한도가 빨리 닳는다는 초기 반응을 전했습니다. 큰 작업을 맡기기 전에 남은 한도부터 확인하세요.
#Gemini4Argon#RTXSpark#GPT61Sol
출처 9💬 @aGim_asf💬 @LyalinDotCom💬 @EvanOtero💬 @simpsoka💬 @NVIDIARTXSpark💬 @StockSavvyShay🔥 @haider1🔥 @thdxr🔥 @ziwenxu_
오늘의 감정·온도
오늘의 실무 팁 — 쉽게 풀어 쓴 사용법 6가지
1. 작업 규칙 파일은 좋은 본보기를 읽힌 뒤 만듭니다 copyconstruct는 claude.md(Claude Code가 일을 시작할 때마다 먼저 읽는 규칙 파일)를 만들면서 좋아하는 프로그래밍 책과 블로그, 잘 만든 오픈소스 프로젝트, 존경하는 엔지니어들의 코드를 Claude에게 먼저 읽게 했습니다. 그는 분명한 지시와 제약, 맥락을 주면 이제 Claude가 거의 언제나 자기보다 나은 코드를 쓴다고 적었으니, 규칙 파일을 백지에서 쓰기보다 따라 하고 싶은 본보기부터 건네 보세요.
2. 한 달에 한 번, 다시 쓸 수 있는 작업을 찾게 합니다 Michael Fenech은 Grok Bot 같은 AI 비서에게 지난 30일 동안 함께 한 대화·파일·결과물을 돌아보고, 그대로 다시 쓸 것·고쳐 쓸 것·틀로 만들 것·방법만 적어 둘 것으로 나누게 하는 점검 프롬프트를 공유했습니다. 가장 쓸모 있는 다섯 개만 먼저 보여 주고, 아직 파일을 옮기거나 새로 만들지 말며, 고객 정보처럼 민감한 내용은 빼라고 함께 지시하는 것이 요점입니다.
3. AI에게 글을 다듬게 할 땐 숫자와 부정 표현을 검사하게 합니다 oga_aiichiro가 v2.0.0을 낸 일본어 문장 다듬기 스킬(에이전트에게 주는 작업 설명서) yomiyasu는 고친 글을 돌려주기 전에 숫자나 부정 표현이 바뀌지 않았는지 스스로 검사합니다. 일본어용 도구지만, 어떤 AI로 글을 고치든 '원문과 숫자·부정어가 그대로인지 확인한 뒤 돌려 달라'는 한 줄을 붙이면 같은 실수를 줄일 수 있습니다.
4. 음성 AI의 목소리는 여러 개 만들어 비교합니다 theteriyu는 GPT-Live가 가장 자연스러운 음성 AI라며, 글로 설명해 목소리를 만드는 기능을 쓸 때 억양·음색·성별을 지정하고 마음에 드는 걸 고르기 전에 4개 이상을 만들어 보라고 권했습니다. 대화 중 '네', '그렇죠' 같은 맞장구를 많이 넣어 달라고 요청하는 것도 자연스럽게 들리게 하는 방법으로 꼽았습니다.
5. 일을 맡길 땐 무엇이 결과를 증명할지부터 말하게 합니다 daniel_mac8은 Anthropic 리드 엔지니어 Felix Rieseberg가 공유한 프롬프트를 '/be-ambitious'라는 무료 스킬로 만들었습니다. 그 분야 최고 전문가라면 무엇을 할지, 어떤 날것의 자료에서 출발할지, 어떤 방법과 도구를 쓸지, 무엇이 결과가 맞다는 증거가 될지를 에이전트가 먼저 말하게 하는 네 단계입니다.
6. 집 기기를 손볼 땐 제품 정보부터 건넵니다 doooyle은 자기 TV의 판매 페이지를 Claude Code에 보내 손볼 수 있는지 물었고, 안내를 따라 광고와 불필요한 앱을 없앤 뒤 매출·일정·날씨를 띄우는 화면보호기까지 만들었다고 적었습니다. 제조사가 허용하지 않는 개조는 보증이 사라지거나 기기가 고장 날 수 있으니, 원래대로 되돌리는 방법부터 물어보고 시작하세요.
출처 6🔥 @copyconstruct💬 @Michael_Fenech_🚀 @oga_aiichiro🔥 @theteriyu🔥 @daniel_mac8🔥 @doooyle
📦 확인 방식
양자 회로와 암호 곡선 결과는 Anthropic 연구 글에서, DeepSeek와 Beam의 사양·점수는 각 회사 모델 카드에서, Minecraft 실험은 arXiv 논문에서, 법원 위원회 발언은 회의를 전한 보도에서 가져왔습니다. 회사와 저자가 직접 잰 점수·수치는 외부 독립 검증 전입니다.
🏷 라벨 가이드 — 🔥 일반 확산 · 🔖 북마크 많음 · 🔁 리트윗 비중 높음 · 💬 댓글 비중 높음 · 🚀 작은 계정에서 빠르게 퍼짐