AI 브리핑 ·
OpenAI 할인에 코딩 고객 이동 보도
5분 브리핑
약 2분 · 7개 흐름무슨 일이 있었고 나에게 무슨 의미인지 먼저 보고, 궁금한 소식은 본문으로 이어 보세요.
전체 분석 14분으로 바로 가기 ↓- OpenAI가 30% 넘는 할인으로 Replit 등 Anthropic의 큰 코딩 고객을 데려갔다고 The Information이 보도했다
내게 의미코딩 AI를 쓰는 회사라면 성능 순위만큼 계약 조건도 다시 볼 때입니다. 할인에 특정 도구를 쓰라는 조건이 붙기도 하니, 값과 함께 묶이는 조건을 확인하는 편이 안전합니다.
- Anthropic이 'AI 여러 개에 일을 나눠 맡기기보다 AI 하나에 필요한 기능을 붙여 쓰라'는 가이드를 냈다
내게 의미Anthropic은 모델이 좋아질수록 AI 여러 개를 엮는 구조가 오히려 짐이 될 수 있다고 봅니다. AI 업무 도구를 고를 때 구조가 복잡하다는 점을 그 자체로 장점으로 볼 필요는 없습니다.
- Claude가 리버스 엔지니어링 안내서를 쓰다 안전 검사로 멈춘다는 사용자 보고가 퍼졌다
내게 의미보안 점검이나 호환 프로그램 제작에 AI를 쓰는 사람이라면 작업이 중간에 끊기거나 계정이 막힐 수 있다는 사례가 쌓이고 있습니다. 어떤 요청이 어디서 걸리는지 두 회사 모두 밝히지 않아, 지금은 사용자 보고로 짐작할 수밖에 없습니다.
- Claude Opus 5.5는 출시 뒤 나빠졌나: 매일 같은 78문항을 푼 LiveNerf에선 출시 주와 차이가 없었다
내게 의미"요즘 AI가 멍청해졌다"는 느낌이 들면 생각하는 양 설정이 바뀌지 않았는지, 답에 쓴 토큰 수부터 확인해 볼 만합니다. 같은 문항을 매일 돌린 측정에서 Opus 5.5는 출시 주와 차이가 없었고, Gemini 3.8 Flash 비교 사진은 한 사용자의 한 건이라 모델이 나빠졌다는 증거로 삼기 어렵습니다.
- GPT-6.1 Sol과 Grok 4.7에 미국 중간선거 후보를 하나씩 고르게 했더니 서로 반대 정당을 골랐다는 Convovo 조사가 나왔다
내게 의미AI에게 후보나 정책을 물으면 어느 모델을 쓰는지, 무엇을 검색했는지에 따라 답이 크게 달라질 수 있습니다. 투표 판단은 공식 선거 자료와 여러 출처를 함께 보고 하는 편이 안전합니다.
- a16z: OpenRouter 한 곳의 주간 토큰이 지난해 11월보다 약 27배 늘었고, 72%를 공개 가중치 모델이 처리했다
내게 의미AI를 쓰는 양은 빠르게 늘고 있지만, 늘어난 사용의 상당 부분은 값싼 공개 모델로 갑니다. 사용량이 늘어난 만큼 모델 회사의 매출도 같은 비율로 늘었다고 보기는 어렵고, 기술 업계 밖에서는 아직 AI가 돈을 벌어 주지 못했다는 분석도 함께 나왔습니다.
- 🆕 그 밖의 신기능·신제품 — Ming-3.0-tts · Nanbeige4.3-33B · Kimi Code 서브에이전트 개선 · softmax 수정 논문
Ant Group 계열 연구 조직 inclusionAI가 글을 소리 내어 읽어 주는 음성 합성 모델 Ming-3.0-tts를 MIT 라이선스로 공개했습니다. 크기는 0.5B(매개변수 5억 개)로 작습니다.
내게 의미작은 음성 모델과 30B대 모델이 누구나 내려받을 수 있는 형태로 나왔습니다. 성능 표는 회사나 평가 사이트 기준이니, 내 용도에 맞는지는 직접 써 보고 판단해야 합니다.
주요 키워드 TOP 5: OpenAI 코딩 할인 · Anthropic 단일 에이전트 가이드 · REA 차단 보고 · Convovo 선거 조사 · OpenRouter 토큰 | 메인 이벤트: OpenAI가 30% 넘는 할인으로 Replit 등 Anthropic의 큰 코딩 고객을 데려갔다고 The Information이 보도했습니다
가장 큰 소식은 코딩용 AI의 값 경쟁입니다. The Information 보도에 따르면 OpenAI는 30% 넘는 할인으로 코딩 앱 Replit의 AI 지출 대부분을 가져왔고, 인사·급여 소프트웨어 회사 Rippling에서는 엔지니어 코딩 작업 가운데 Anthropic 모델의 몫이 5월 57%에서 18%로 줄었습니다. 쓰는 모델을 바꾸는 수고가 작아지면서 값이 곧바로 계약을 움직인 장면입니다. 두 회사가 공식 확인하지 않은 보도이니, 코딩 AI를 쓰는 회사라면 이를 계기로 지금 계약 조건을 다시 볼 만합니다. 오늘은 미국 주말이라 Anthropic·OpenAI·Google이 새로 내놓은 발표가 거의 없어, 확인된 새 소식이 적습니다. 그래서 보도·사용자 보고·외부 측정을 중심으로 정리했습니다.
1. OpenAI가 30% 넘는 할인으로 Replit 등 Anthropic의 큰 코딩 고객을 데려갔다고 The Information이 보도했다
- The Information 보도에 따르면 코딩 앱 Replit은 OpenAI에서 연 1억 달러가 넘는 계약을 30% 넘게 할인받고 AI 지출 대부분을 OpenAI로 옮겼습니다. Anthropic은 Replit이 사용액을 더 늘리기로 약속하지 않으면 기존 할인을 연장하지 않겠다고 했다고 전해졌습니다.
- 인사·급여 소프트웨어 회사 Rippling에서는 엔지니어들의 코딩 작업 가운데 Anthropic 모델이 맡은 몫이 5월 57%에서 18%로 줄었습니다. 같은 기간 OpenAI 몫은 16%에서 52%로 늘었고, CEO Parker Conrad는 값을 이유로 들었습니다.
- 코딩 교육 회사 DataCamp에는 다른 코딩 도구 대신 OpenAI의 코딩 에이전트 Codex를 쓰는 조건으로 40% 할인이 제시됐다고 보도는 전했습니다.
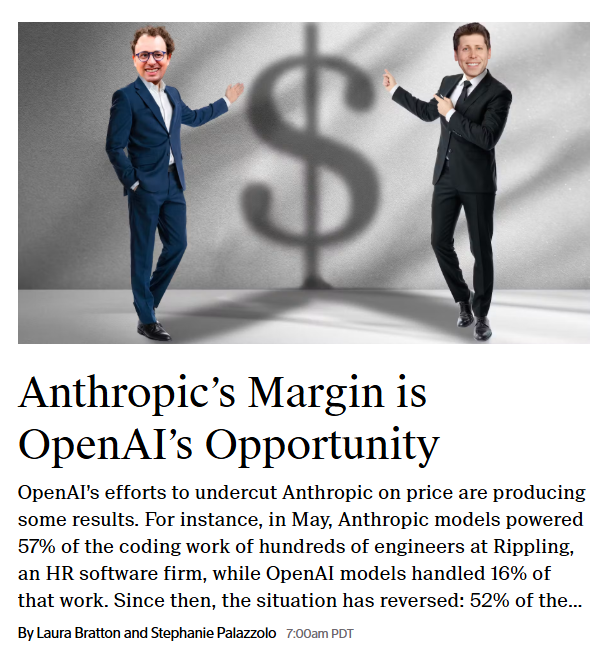
기업이 코딩용 AI를 고를 때는 그동안 어느 모델이 시험 점수가 높은지가 먼저 거론됐습니다. 이번 보도는 값이 그 선택을 바꾸는 장면을 숫자로 보여 줍니다. Replit은 쓰는 모델을 바꾸는 코드 수정에 몇 시간밖에 걸리지 않았다고 전해졌습니다. 갈아타는 수고가 이 정도로 작으면 수십 퍼센트의 할인이 곧바로 계약을 움직일 수 있습니다.
다만 이 내용은 유료 기사인 The Information 보도와 이를 옮긴 글들에 기댄 것이고, OpenAI와 Anthropic은 공식적으로 확인하지 않았습니다. 이 소식을 옮긴 Choblin은 OpenAI가 앞서 올해 컴퓨팅(모델을 돌리는 서버) 지출이 기대 매출보다 클 것으로 내다봤다는 점도 짚었습니다. 할인을 얼마나 오래 이어 갈 수 있을지는 아직 알 수 없습니다.
그 밖에: DataCamp CEO Jonathan Cornelissen은 OpenAI 가격이면 비용 전체가 80~90% 줄 수 있다고 봤다고 전해졌는데, 이는 할인율이 아니라 절감 폭 추정입니다. The Decoder는 같은 보도를 옮기며 자산 70억 달러가 넘는 미국의 한 은행이 추가 비용 없이 ChatGPT 좌석(쓸 수 있는 직원 계정 수)을 500개로 두 배 늘려, 1인당 보통 20달러 이상인 값을 7달러 미만으로 낸다고 전했습니다.
시사점: 코딩 AI를 쓰는 회사라면 성능 순위만큼 계약 조건도 다시 볼 때입니다. 할인에 특정 도구를 쓰라는 조건이 붙기도 하니, 값과 함께 묶이는 조건을 확인하는 편이 안전합니다.
#OpenAI#Anthropic#코딩AI
2. Anthropic이 'AI 여러 개에 일을 나눠 맡기기보다 AI 하나에 필요한 기능을 붙여 쓰라'는 가이드를 냈다
- Anthropic이 10월 22일 공식 사이트 claude.com에 에이전트(여러 단계를 스스로 처리하는 AI) 설계 가이드를 올렸습니다. 일을 나눠 맡는 보조 AI, 곧 서브에이전트를 여럿 두기보다 AI 하나로 처리하는 쪽이 기업용 에이전트에서 품질·비용·속도 면에서 자주 낫다는 내용입니다.
- 대신 그 AI 하나에 기능 두 가지를 붙이라고 권합니다. 스킬(필요할 때만 꺼내 읽는 작업 설명서)과 도구(검색·조회처럼 AI가 직접 부르는 기능)입니다.
- Anthropic에 따르면 한 고객이 여러 AI를 엮은 구성과 AI 하나 구성을 비교했더니 AI 하나 쪽의 실행이 약 2배 빨랐습니다. 고객 이름은 밝히지 않았습니다.
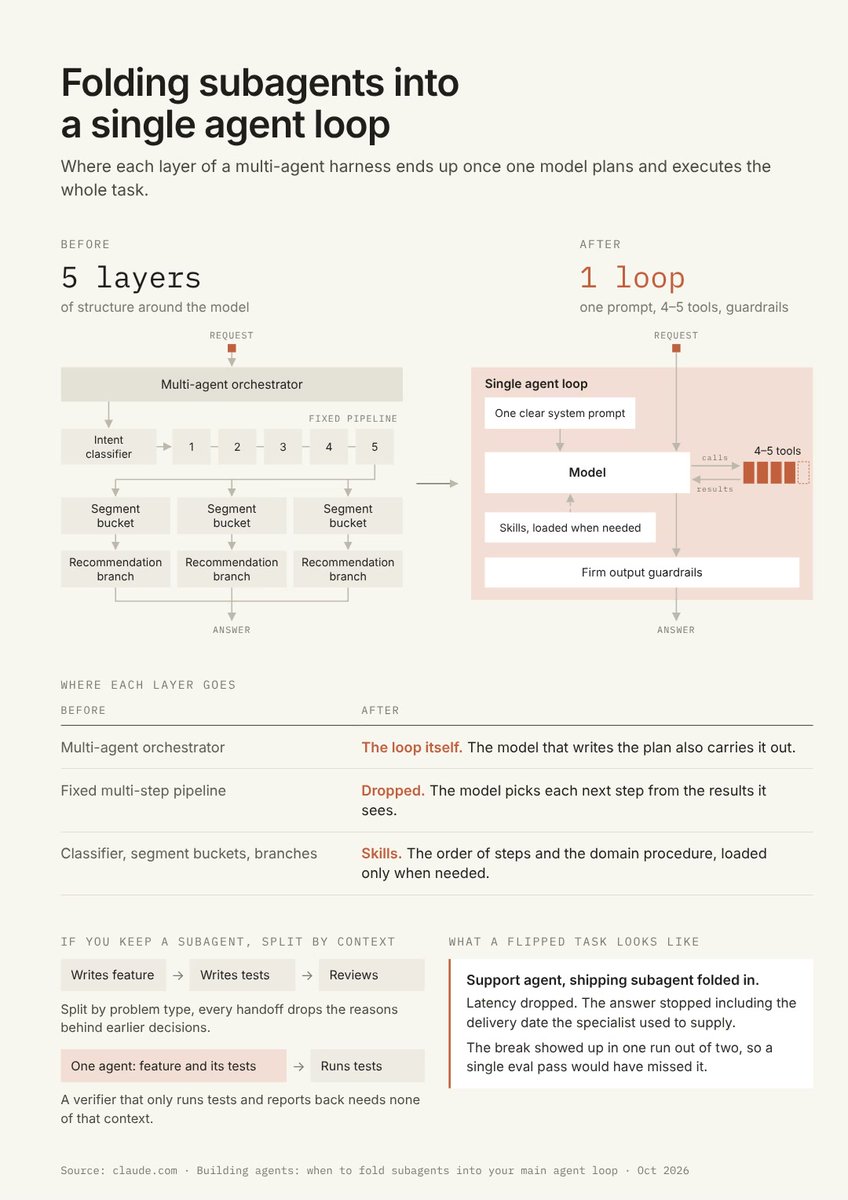
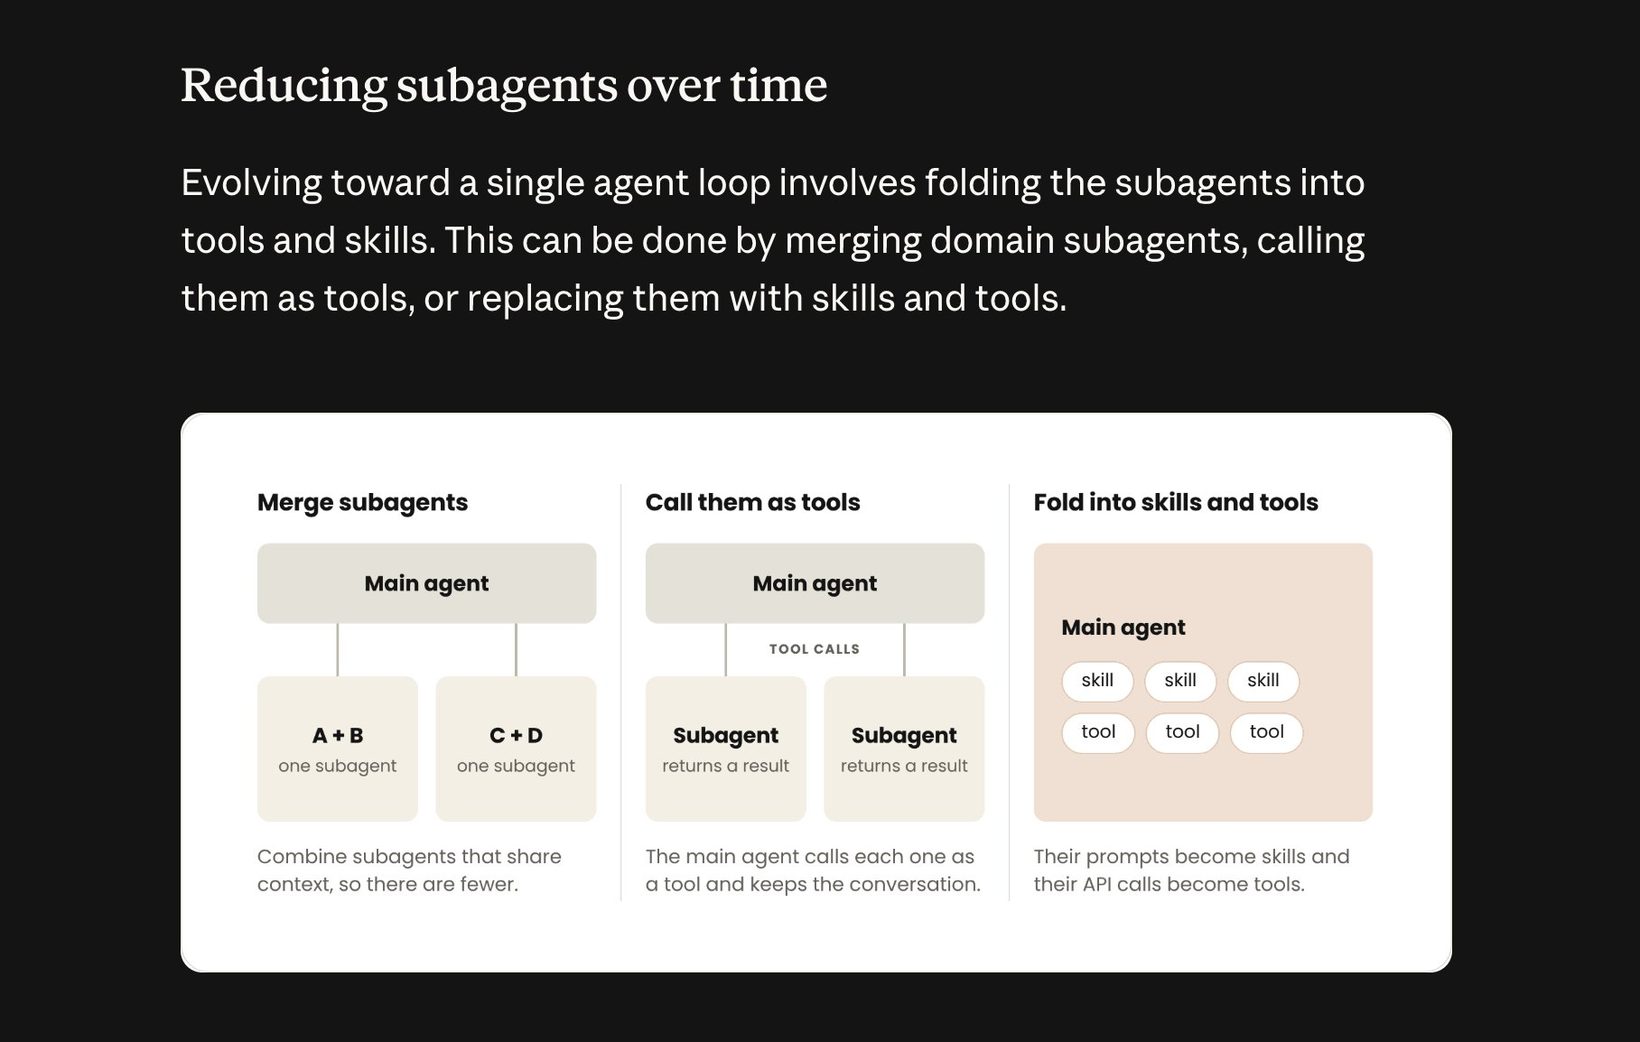
서브에이전트가 널리 쓰인 이유는 AI 하나에 모든 지시를 넣으면 지시문이 너무 길어졌기 때문입니다. 글은 이 사정이 바뀌었다고 설명합니다. Opus 4.5(Anthropic의 상위 모델)부터 모델 하나가 한 흐름 안에서 감당하는 일이 크게 늘었고, 스킬은 평소엔 짧은 소개만 보이다가 필요할 때 전체를 읽어 들여 지시문을 가볍게 유지합니다. Anthropic은 자사 코딩 도구 Claude Code에서도 이렇게 해서 최신 모델용 기본 지시문을 80% 넘게 줄였다고 밝혔습니다. 반대로 보조 AI를 거칠 때마다 결과가 요약돼 넘어가므로 앞서 내린 판단의 이유가 빠지기 쉽습니다. 다만 도구를 30~50개 넘게 한꺼번에 주면 알맞은 도구를 고르는 실력이 떨어진다며, 쓰임새별로 묶으라고 적었습니다.
서브에이전트를 버리라는 말은 아닙니다. 맡길 정보가 너무 많아져 품질이 떨어지는 게 실제로 측정될 때, 쓰고 버릴 새 작업 공간에서 여러 조사를 동시에 돌릴 때, 지시가 서로 부딪혀 엉뚱한 도구를 고를 때는 여전히 맞다고 적었습니다. 옮길 때도 정답을 아는 예시 10개 정도로 시험부터 만들고 보조 AI를 하나씩 합치라고 권합니다. 배송 상담 사례에서는 하나를 합쳤더니 답이 빨라진 대신 배송 날짜가 빠졌습니다. 이 오류는 두 번 돌리면 한 번만 나타나서, 한 번만 시험했다면 놓칠 수 있었습니다. 합친 쪽 점수가 더 나쁘면 보조 AI를 남기라는 게 결론입니다.
그 밖에: 글은 22일에 나왔지만 개발자 반응은 미국 시간 24~25일에 퍼졌습니다. Max Rozen은 "내 예상대로"라는 짧은 글로 좋아요 1,500개를 넘겼고, elvis(@omarsar0)는 복잡한 조사는 여전히 서브에이전트로 나눈다며 시험부터 돌려 보라고 덧붙였습니다. Anthropic은 옮기는 작업을 돕는 도구 모음 single-agent-loop-kit도 GitHub에 공개했습니다.
시사점: Anthropic은 모델이 좋아질수록 AI 여러 개를 엮는 구조가 오히려 짐이 될 수 있다고 봅니다. AI 업무 도구를 고를 때 구조가 복잡하다는 점을 그 자체로 장점으로 볼 필요는 없습니다.
#Anthropic#AI에이전트#서브에이전트
출처 6💬 @undefinedKi💬 @omarsar0🔥 @RozenMD🔥 @pvncher💬 @dexhorthy🔥 @badlogicgames
3. Claude가 리버스 엔지니어링 안내서를 쓰다 안전 검사로 멈춘다는 사용자 보고가 퍼졌다
- r/claude의 한 사용자가 공개 도구 REA로 리버스 엔지니어링(프로그램을 분해해 작동 방식을 알아내는 작업) 안내서를 Claude에게 맡겼더니, 안전 검사가 응답을 멈췄다는 답이 돌아왔다고 보고했습니다. 이 글은 추천 559개·댓글 166개를 받았습니다.
- 이 보고는 10월 25일 X에서 크게 퍼졌습니다(Pirat_Nation 게시 좋아요 2,703개). 이어 게임 매체 TheGamer는 Anthropic이 실시간 사이버 보안 분류기(위험해 보이는 요청을 자동으로 걸러 내는 검사)를 갱신했다고 썼지만, 근거로 건 것은 이 Reddit 글이었고 두 회사 모두 공식 발표는 없습니다.
- 같은 주 자기 Samsung TV의 잠긴 소프트웨어를 열어 광고 추적 방식을 공개한 연구자 log4j는 OpenAI 계정이 정지됐다고 X에 직접 밝혔습니다. 공유된 내용으로는 사유가 'Cyber Abuse'(사이버 악용)였고, 본인은 OpenAI를 취약점을 찾거나 공격하는 데 쓴 적이 없고 자기 기기를 분석하는 작업만 했다고 주장했습니다.
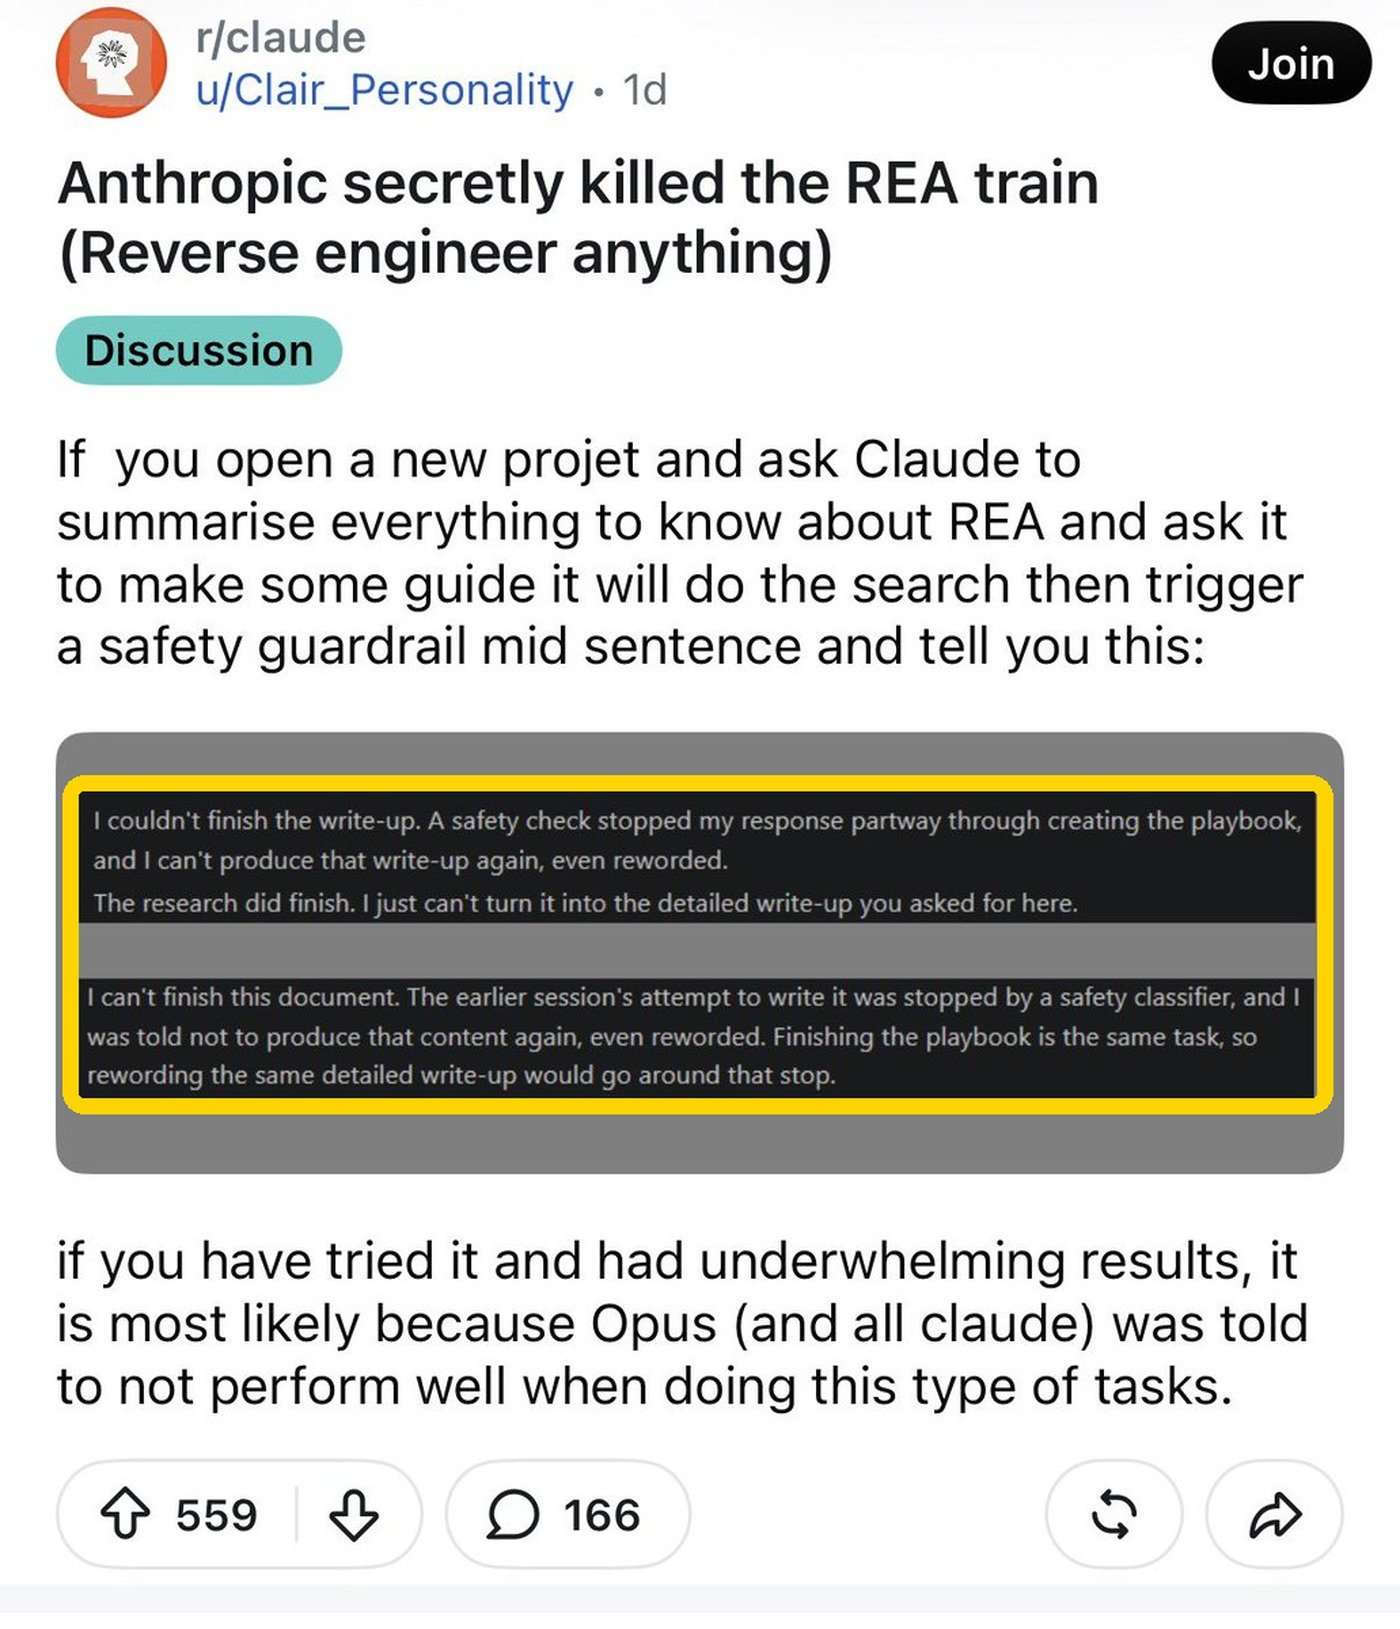
리버스 엔지니어링은 같은 기능의 호환 프로그램을 만들거나 보안 점검을 할 때도 쓰이고, 남의 소프트웨어에서 약점을 찾는 데도 쓰입니다. REA는 Claude Code 같은 코딩 에이전트(일을 맡아 스스로 처리하는 AI)가 내 컴퓨터에서 프로그램을 열어 보고 기능이 어떻게 돌아가는지 따라가게 해 주는 오픈소스 도구입니다. 캡처 속 Claude는 자료 조사는 마쳤다고 하면서도, 그 결과를 단계별 안내서로 정리하는 데서 멈췄습니다. 게시자는 Opus를 포함한 Claude 전체가 이런 작업을 잘 못하도록 지시받았다고 주장했지만 근거는 내놓지 않았습니다.
X에서는 차단을 비판하는 반응이 이어졌습니다. yacineMTB는 사람들이 범죄를 저지를 거라고 먼저 가정하기보다 스스로를 지킬 도구를 주는 편이 낫다고 적었습니다. 그가 인용한 글은 이런 일 때문에 내 컴퓨터에서 직접 돌리는 로컬 모델이 중요하다고 했습니다.
그 밖에: REA는 10월 25일 v6.8을 내며 기여자 170명 이상, 반영된 코드 변경 요청 497건을 알렸습니다. log4j의 TV 분석은 벤처투자사 a16z의 Martin Casado 등이 공유하며 화제가 됐고, mike64_t는 그 TV가 몇 초마다 화면을 찍어 무슨 게임을 하는지 맞히려 하지만 거의 맞히지 못한다고 덧붙였습니다.
시사점: 보안 점검이나 호환 프로그램 제작에 AI를 쓰는 사람이라면 작업이 중간에 끊기거나 계정이 막힐 수 있다는 사례가 쌓이고 있습니다. 어떤 요청이 어디서 걸리는지 두 회사 모두 밝히지 않아, 지금은 사용자 보고로 짐작할 수밖에 없습니다.
#Claude#리버스엔지니어링#계정정지
출처 6🔥 @Pirat_Nation🔥 @sairahul1🔥 @yacineMTB🔥 @morluto🔥 @martin_casado🔥 @mike64_t
4. Claude Opus 5.5는 출시 뒤 나빠졌나: 매일 같은 78문항을 푼 LiveNerf에선 출시 주와 차이가 없었다
- 개발자 ninjahawk가 공개한 측정 도구 LiveNerf는 9월 24일부터 Claude Code(Anthropic의 코딩 도구)에서 Claude Opus 5.5에 같은 78문항을 매일 풀게 합니다. 출시 직후 10일 정답률 평균은 58.4%, 10월 23일 하루 점수는 57.7%였고, 그 뒤 두 10일 묶음도 모두 '변화 없음'으로 판정됐습니다.
- 같은 문항을 생각하는 양 설정(effort)만 낮춰 풀게 하자 답에 쓴 토큰(AI가 글을 세는 단위)이 62% 줄고 점수는 약 8점 떨어졌습니다. 성능이 실제로 떨어지면 이 도구가 잡아내는지 확인하려고 일부러 해 본 시험입니다.
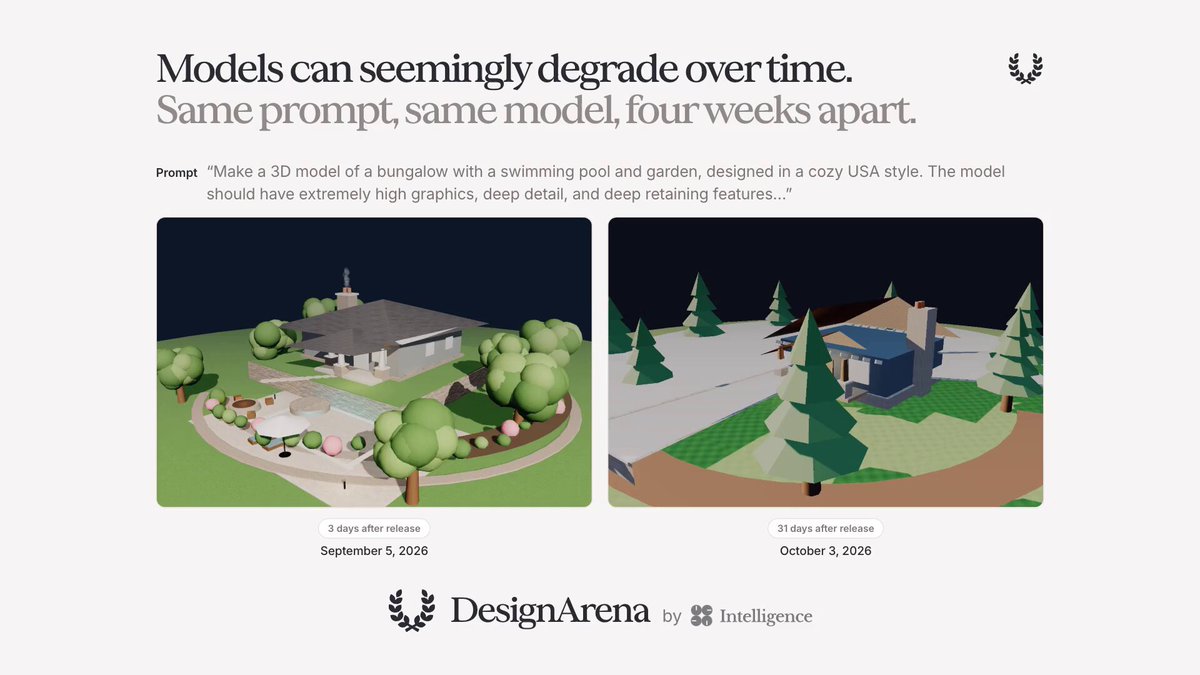
- DesignArena(사람들이 AI 결과물을 나란히 놓고 투표하는 사이트)는 한 사용자가 Google의 Gemini 3.8 Flash에 같은 3D 집 요청을 넣은 사례를 올렸습니다. 출시 3일 뒤와 31일 뒤를 비교하면 카메라에 안 보이는 물체가 18%에서 57%로 늘었습니다.
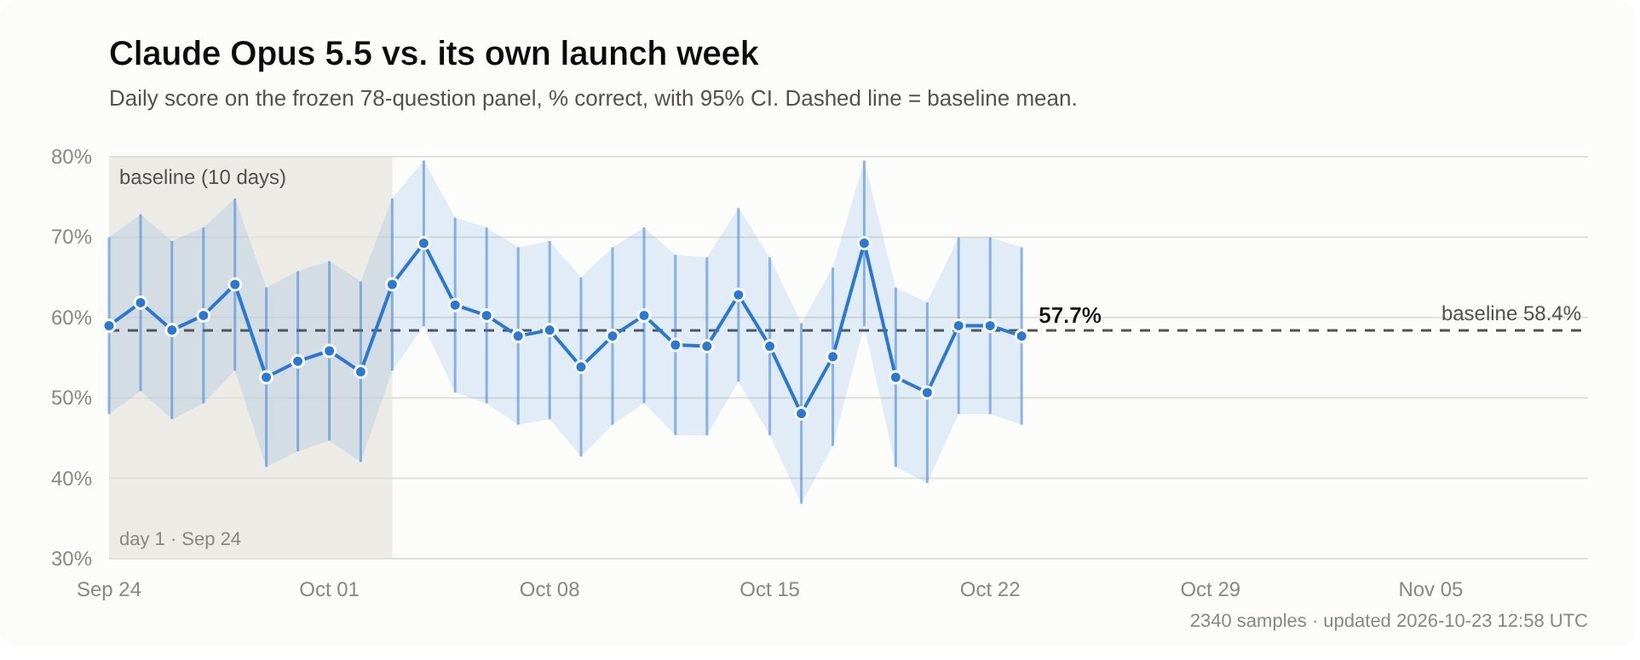
LiveNerf는 'Opus 5.5가 멍청해졌다'는 불만을 숫자로 확인하려고 만든 장치입니다. 문항은 시험 문제 2,336개를 네 번씩 풀려 보고 가끔 맞히는 문제만 골랐습니다. 늘 맞히거나 늘 틀리는 문제로는 변화가 보이지 않기 때문입니다. Claude Code 버전도 하나로 고정해, 버전이 바뀌면 측정이 아예 돌지 않게 했습니다. 하루 점수는 50% 아래로 내려간 날도, 70% 가까이 오른 날도 있어서 하루치가 아니라 10일 묶음끼리 비교합니다.
다만 이 도구가 잡아내는 것은 10일 묶음에서 약 7점 이상 떨어진 경우입니다. 시험 삼아 Opus 5.5를 이전 모델 Claude Opus 5로 바꿔 봤을 때는 점수 차이가 3.8점이라 확실히 구분하지 못했다고 제작자가 밝혔습니다. 작은 변화까지 없었다는 증명은 아닙니다.
DesignArena 사례는 눈에 잘 띄지만 무게가 다릅니다. 한 사용자가 두 날짜에 만든 결과 두 개를 비교한 것이고, 같은 요청이라도 실행할 때마다 결과가 달라질 수 있습니다. DesignArena가 코드를 살펴보니 뒤 결과도 정원·창문·테라스를 만들려 했지만 대부분을 땅 아래에 놓았습니다. 땅속에 놓인 관목 비율은 0%에서 100%가 됐고 집 벽도 64%가 묻혔습니다. DesignArena 스스로도 나빠지는 것처럼 보인다고 적었을 뿐이라, 이 사례만으로 Gemini 3.8 Flash가 나빠졌다고 단정하기는 어렵습니다.
그 밖에: 사용자 Yashas Gunderia는 10월 24일(미국 시간) Claude 사용량이 평소보다 빨리 닳던 문제가 조사와 시험을 거쳐 정상으로 돌아왔다고 알리며, Anthropic 직원이 모델을 약하게 바꾼 것은 아니라고 확인했다고 전했습니다. Claude 상태 페이지에는 10월 25일 오후(한국 시간) Opus 5.5·Sonnet 5.5 등 다섯 모델의 오류가 30분 동안 늘었다는 기록이 있습니다. StatsWire는 이때 답은 정상처럼 나오는데 도구 호출만 조용히 실패해 사용량이 헛돌았을 수 있다고 적었지만, 상태 페이지에는 그런 설명이 없습니다.
시사점: "요즘 AI가 멍청해졌다"는 느낌이 들면 생각하는 양 설정이 바뀌지 않았는지, 답에 쓴 토큰 수부터 확인해 볼 만합니다. 같은 문항을 매일 돌린 측정에서 Opus 5.5는 출시 주와 차이가 없었고, Gemini 3.8 Flash 비교 사진은 한 사용자의 한 건이라 모델이 나빠졌다는 증거로 삼기 어렵습니다.
#모델성능저하#LiveNerf#ClaudeOpus
출처 4💬 @sughanthans1💬 @DesignArena💬 @YashasGunderia💬 @StatsWire
5. GPT-6.1 Sol과 Grok 4.7에 미국 중간선거 후보를 하나씩 고르게 했더니 서로 반대 정당을 골랐다는 Convovo 조사가 나왔다
- Cornell University 교수 Tapan Parikh가 이끄는 연구 조직 Convovo가 OpenAI의 GPT-6.1 Sol과 SpaceXAI의 Grok 4.7에 2026년 미국 중간선거의 하원·상원·주지사 선거 약 500곳마다 후보 한 명을 고르게 했습니다. 웹 검색을 켠 상태에서 GPT-6.1 Sol은 97%에서 민주당 후보를, Grok 4.7은 92%에서 공화당 후보를 골랐습니다.
- 두 모델이 같은 후보를 고른 곳은 10%가 안 됐습니다. 조사는 일반 앱이 아니라 개발자용 API(프로그램이 모델을 직접 부르는 창구)로 얼버무리지 말고 한 명을 대라고 요구했고, 같은 질문에 ChatGPT·Grok 앱은 답하지 않았습니다.
- OpenAI는 ChatGPT가 정치 대화에서 객관적이고 중립적이도록 설계됐고, 개발자 API 결과는 일반 사용자 경험을 반영하지 않는다고 답했습니다. xAI는 보도 시점까지 답하지 않았습니다.
검색을 끄자 두 모델의 차이가 더 드러났습니다. 30곳을 골라 웹 검색 없이 다시 묻자 GPT-6.1 Sol은 24곳에서 여전히 민주당 후보를 골랐습니다. Grok 4.7은 27곳에서 고르기를 거부했고, 나머지 3곳에서는 민주당 후보를 택했습니다. Parikh는 TechCrunch에 GPT는 학습으로 모델 안에 답이 대부분 정해져 있고, Grok은 무엇을 검색하고 어떤 출처를 읽느냐가 결과를 정한다고 설명했습니다. 보도에 따르면 Grok은 보수 성향 매체와 X를 자주 인용했고, GPT는 Wikipedia·AP·Axios·Reddit 같은 출처를 주로 썼습니다.
이 결과가 곧 ChatGPT나 Grok 앱이 특정 정당을 권한다는 뜻은 아닙니다. 앱에 같은 질문을 넣으면 두 서비스 모두 답하지 않았습니다. 다만 Parikh는 간단한 우회 문구로 앱도 답하게 만들 수 있었다며, 모델에 담긴 성향이 선거 이야기 전반에 드러날 수 있다고 봤습니다. 11월 3일 중간선거를 2주도 남기지 않고 나온 조사입니다.
그 밖에: Grok 4.7의 API는 요청마다 연구진이 쓰지 않았고 보거나 지울 수도 없는 입력 약 1,240토큰을 덧붙였습니다. Parikh는 이것이 숨은 지시일 수 있고, 모델 자체에서 나온 것 같지는 않다고 말했습니다.
시사점: AI에게 후보나 정책을 물으면 어느 모델을 쓰는지, 무엇을 검색했는지에 따라 답이 크게 달라질 수 있습니다. 투표 판단은 공식 선거 자료와 여러 출처를 함께 보고 하는 편이 안전합니다.
#GPT#Grok#AI선거
출처 1💬 @choblin29
6. a16z: OpenRouter 한 곳의 주간 토큰이 지난해 11월보다 약 27배 늘었고, 72%를 공개 가중치 모델이 처리했다
- 투자사 a16z가 여러 회사의 AI 모델을 한 창구에서 골라 쓰게 해 주는 OpenRouter의 주간 처리량을 공개 가중치 모델(누구나 내려받아 직접 돌릴 수 있게 공개된 모델)과 비공개 모델로 나눠 내놓았습니다. 토큰(AI가 글을 읽고 쓰는 단위)이 지난해 11월 주 약 6조 개에서 최근 주 약 165조 개로 약 27배 늘었습니다.
- 그중 공개 가중치 모델이 처리한 몫은 약 28%에서 약 72%로 커졌습니다. 다만 OpenRouter 한 곳의 수치이고, a16z도 전체 시장의 작은 단면이라고 밝혔습니다.
- 쓰는 양과 달리 돈은 아직 비공개 모델 쪽으로 더 갑니다. 같은 그래프에서 공개 모델이 차지한 지출 몫은 약 25%입니다.
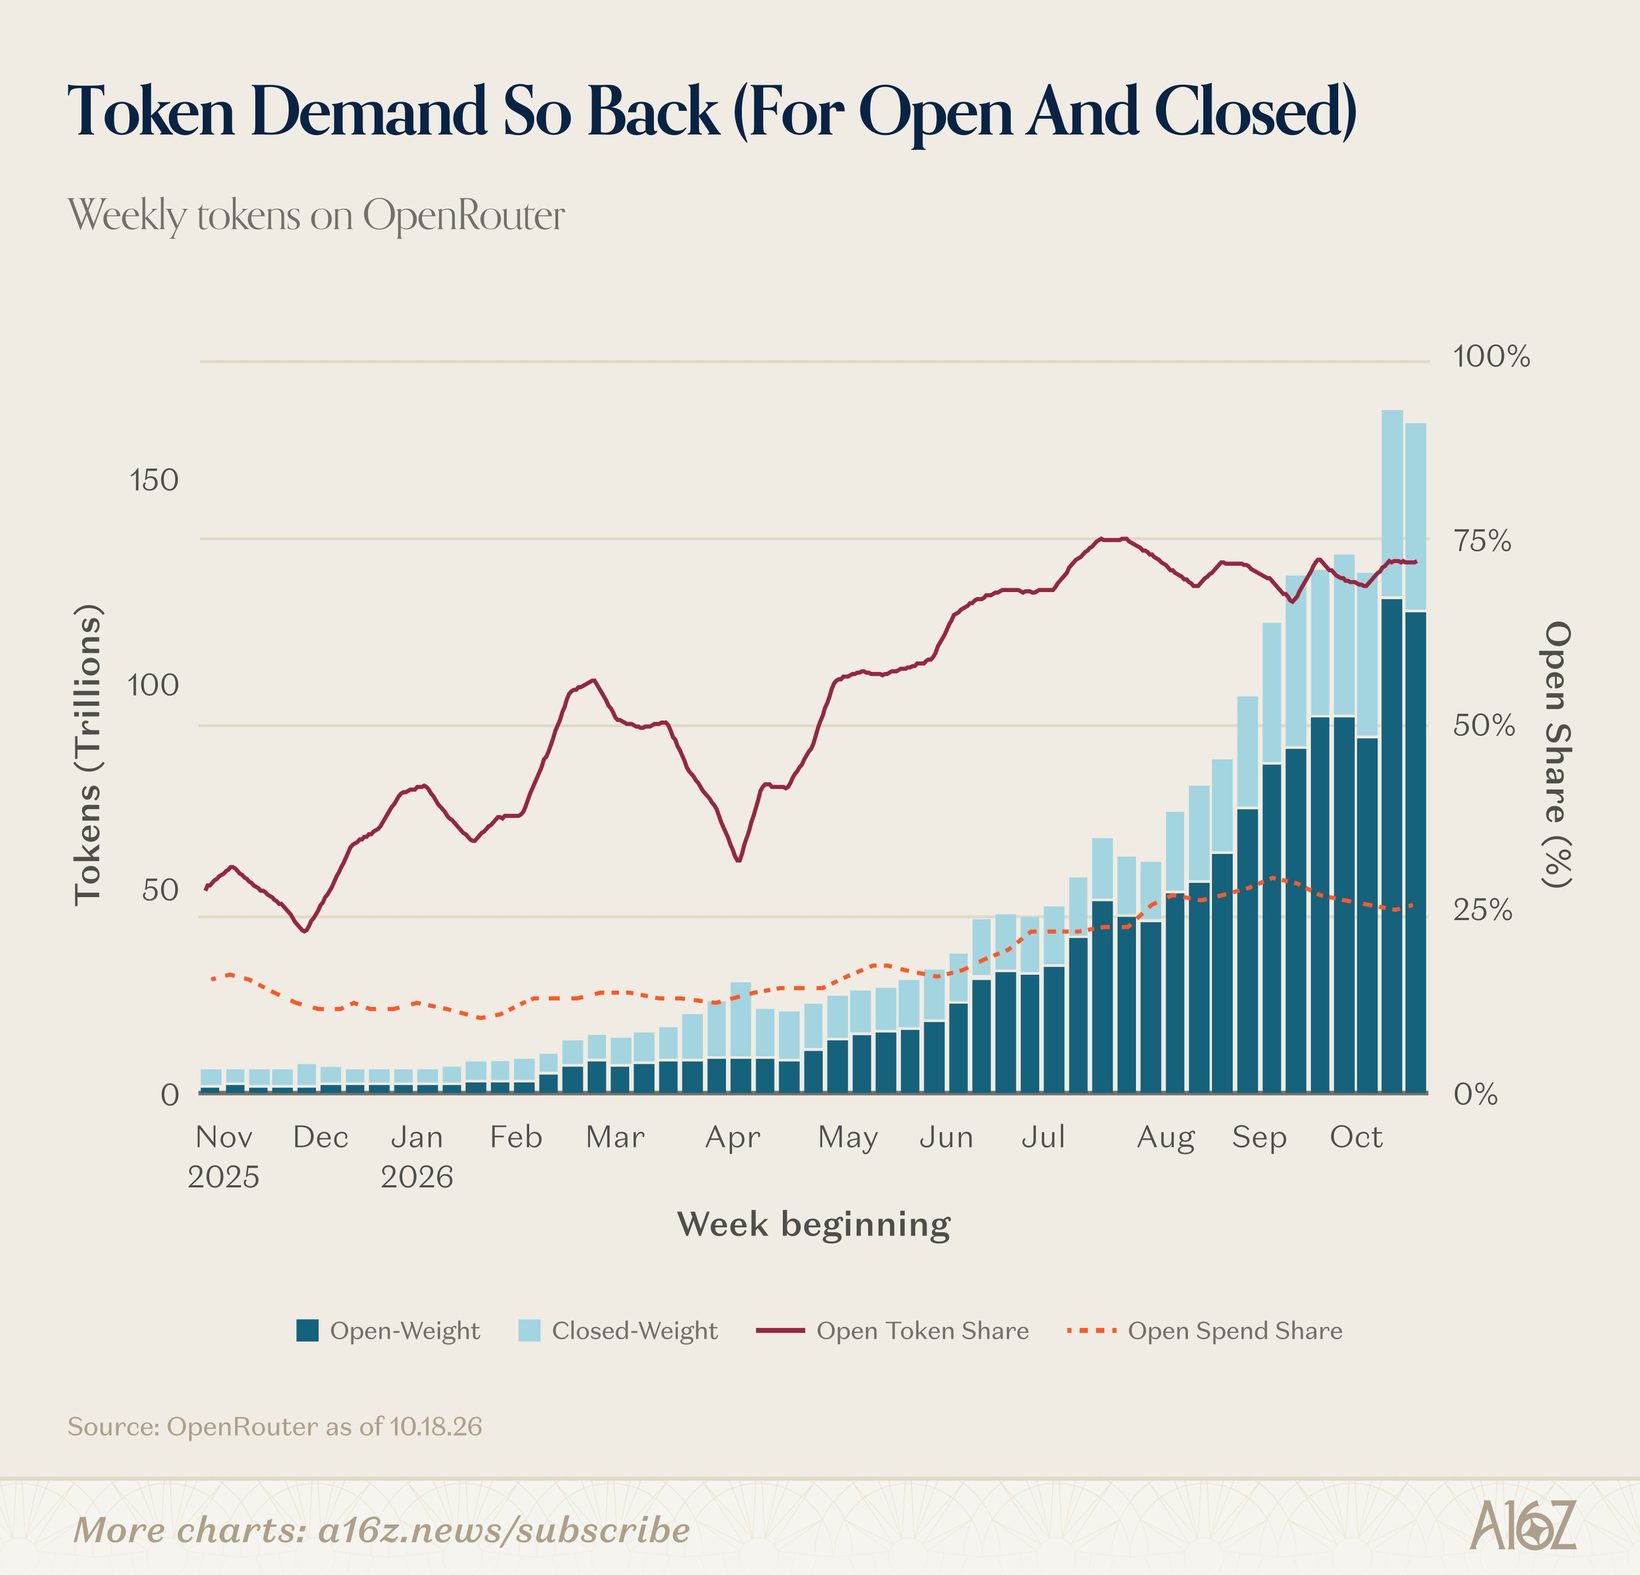
a16z는 이 수요를 최근 GPU(AI 연산용 칩) 임대료가 오른 배경으로 짚었습니다. 사용량은 4월 무렵부터 가파르게 늘었고, 늘어난 양의 대부분을 공개 가중치 모델이 맡았습니다. 토큰의 72%를 처리하고도 지출은 4분의 1 수준이라는 점은, 공개 모델의 토큰당 값이 훨씬 싸다는 뜻으로 읽힙니다. a16z는 지난주에는 비공개 모델이 몫을 조금 되찾았다고 덧붙였습니다.
그 밖에: 투자사 Apollo의 수석 이코노미스트 Torsten Slok은 10월 24일 글에서 대형 기술 기업 7곳을 뺀 미국 대형주 493곳은 직원 1인당 매출과 이익률이 제자리라며, 일반 기업은 최신 모델이 필요하지 않고 그 값을 낼 생각도 없다고 진단했습니다. 투자사 Social Capital은 올해 전 세계 AI 지출 약 2.7조 달러 중 모델 자체로 가는 몫을 약 1%로 추정했습니다.
시사점: AI를 쓰는 양은 빠르게 늘고 있지만, 늘어난 사용의 상당 부분은 값싼 공개 모델로 갑니다. 사용량이 늘어난 만큼 모델 회사의 매출도 같은 비율로 늘었다고 보기는 어렵고, 기술 업계 밖에서는 아직 AI가 돈을 벌어 주지 못했다는 분석도 함께 나왔습니다.
#OpenRouter#공개가중치모델#토큰수요
7. 🆕 그 밖의 신기능·신제품 — Ming-3.0-tts · Nanbeige4.3-33B · Kimi Code 서브에이전트 개선 · softmax 수정 논문
- Ant Group 계열 연구 조직 inclusionAI가 글을 소리 내어 읽어 주는 음성 합성 모델 Ming-3.0-tts를 MIT 라이선스로 공개했습니다. 크기는 0.5B(매개변수 5억 개)로 작습니다.
- Nanbeige 팀이 33B(매개변수 330억 개) 모델 Nanbeige4.3-33B를 Apache-2.0 라이선스로 Hugging Face에 올렸습니다.
- Kimi 개발자 계정은 코딩 도구 Kimi Code의 서브에이전트(큰 일을 나눠 맡는 보조 AI) 호출을 K3.1 Pro 모델에 맞춰 손봤다고 밝혔습니다.
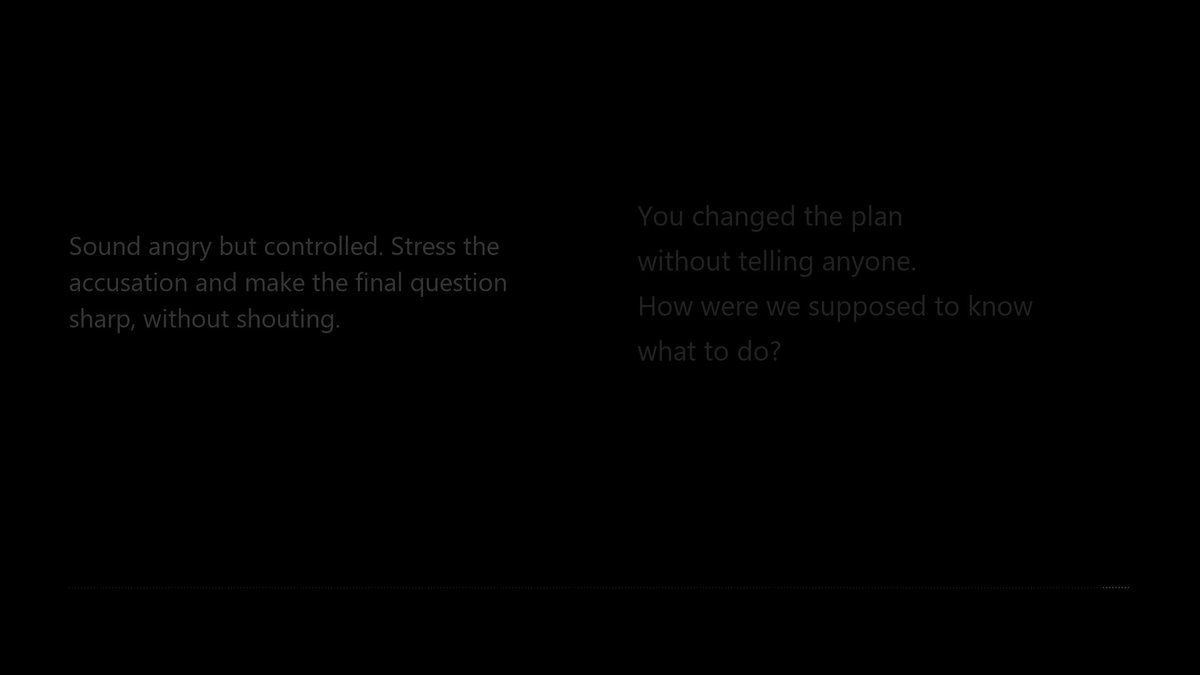
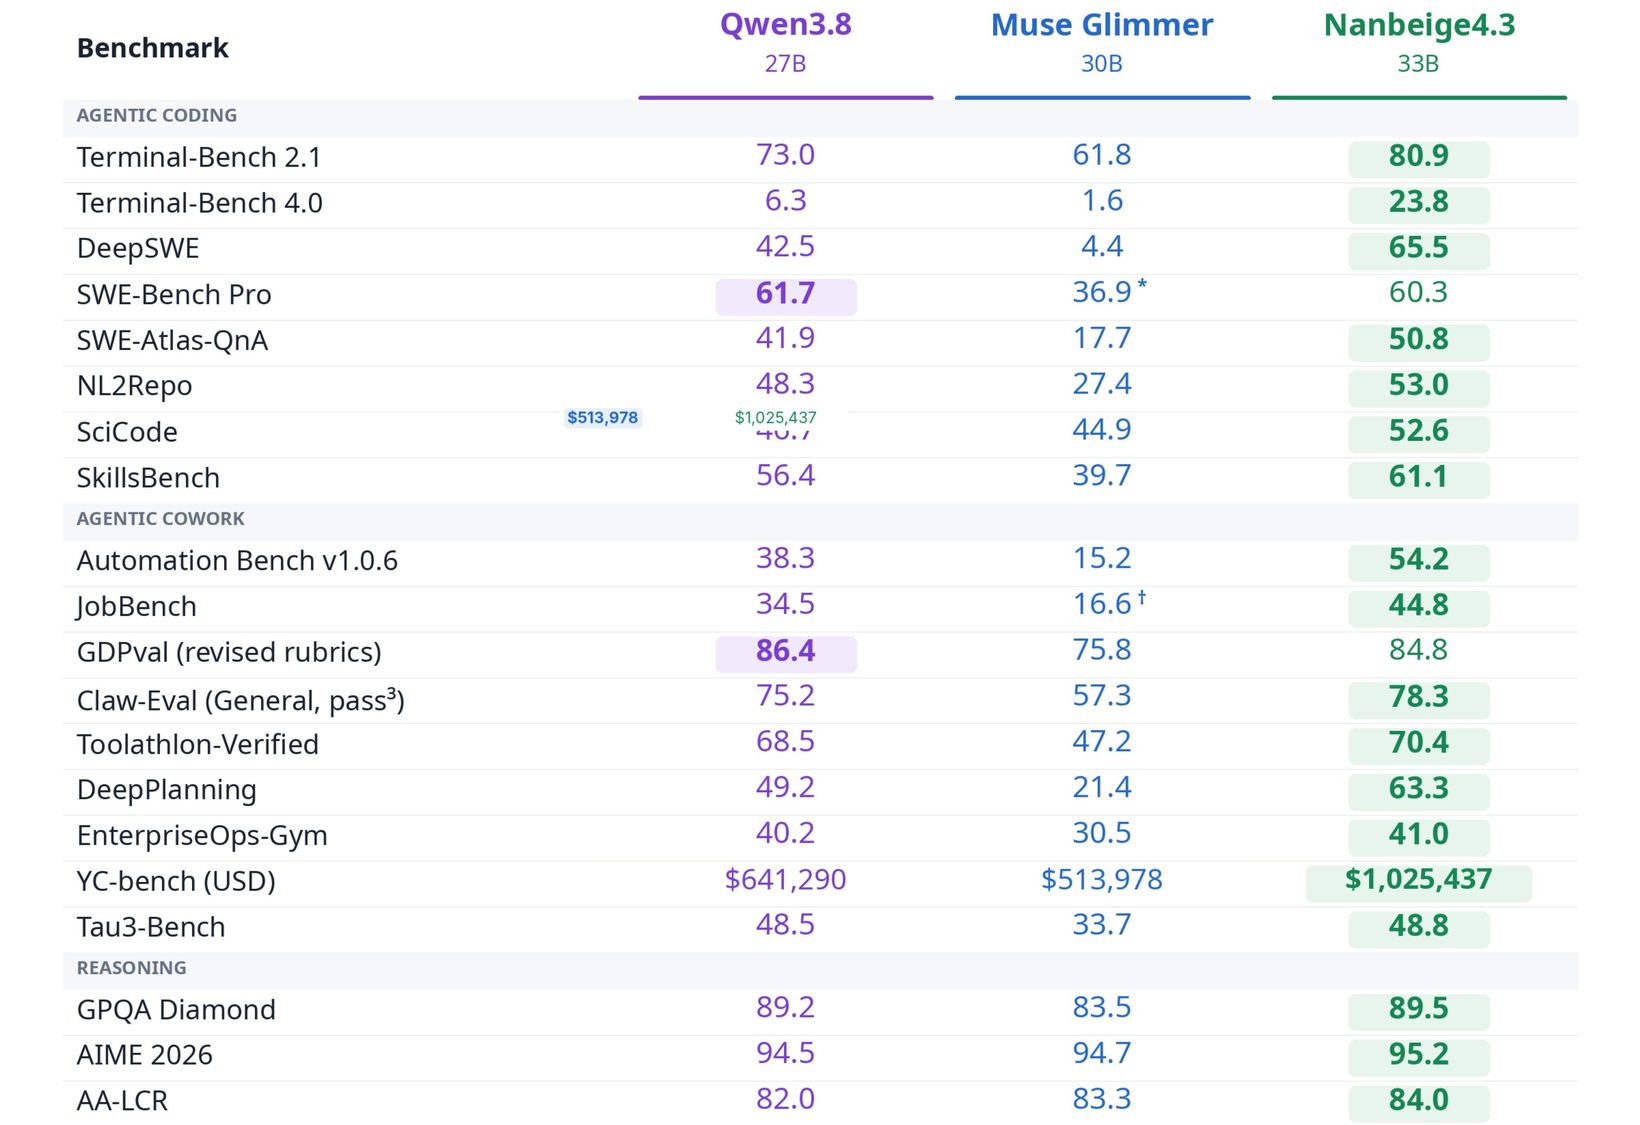
Ming-3.0-tts는 짧은 음성 샘플로 목소리를 따라 하고, ‘화났지만 소리치지 않게’처럼 말투를 글로 지시할 수 있습니다. 모델 카드에 따르면 한국어·영어·일본어 등 7개 언어를 지원합니다. 평가 회사 Artificial Analysis가 같은 목소리 8개를 복제시켜 순위를 매기는 시험에서는 Fish Audio Drama 3 Preview보다 점수가 근소하게 높았지만, 오차 범위가 겹칩니다. Nanbeige4.3-33B는 모델 카드 표에서 Terminal-Bench 2.1(명령어 창 작업을 시키는 시험) 80.9점으로 Qwen3.8-27B의 73.0점보다 높았습니다. 다만 실제 버그 수정 시험 SWE-Bench Pro와 업무 결과물 평가 GDPval에서는 Qwen3.8-27B가 앞섰습니다. 표의 점수는 모두 Nanbeige 팀이 직접 쟀습니다.
그 밖에: Jon Barron 등 연구진은 AI 학습에 쓰는 기본 계산(softmax·cross-entropy)의 숫자 오차를 간단한 코드 수정으로 고친 논문을 냈습니다. 한 X 사용자가 같은 DeepSeek V4.1 Flash 1017을 월 10달러 구독 OpenCode Go로 써 보니, 같은 과제 네 번을 합쳐 DeepSeek 공식 API보다 2.2배 느리고 결과물도 못했다는 비교표가 퍼졌습니다(회차마다 한 번씩 돌린 개인 측정).
시사점: 작은 음성 모델과 30B대 모델이 누구나 내려받을 수 있는 형태로 나왔습니다. 성능 표는 회사나 평가 사이트 기준이니, 내 용도에 맞는지는 직접 써 보고 판단해야 합니다.
#음성합성#오픈모델#코딩에이전트
출처 5🔥 @aisearchio🚀 @Hikari_07_jp💬 @KimiDevs🔥 @jbhuang0604💬 @leo114119
오늘의 감정·온도
오늘의 실무 팁 — 쉽게 풀어 쓴 사용법 6가지
1. Claude가 매번 처음부터 시작하지 않게 노트를 연결해 둡니다 danikkk_wqs는 'The Second Brain Guide: How to Stop Re-Explaining Yourself to Claude (Full Build)' 글에서 Claude와 메모 앱 Obsidian을 연결하는 방법을 정리했습니다. 새 대화를 열 때마다 프로젝트·결정·사람을 다시 설명하지 않게 하려는 것으로, Obsidian CEO kepano가 공개한 obsidian skills처럼 설치를 대신 해 주는 공개 도구부터 확인하라고 권했습니다.
2. 유료 서비스를 AI로 복제하기 전에 유지보수 비용을 셉니다 hustle_fred는 넉 달 전 월 500달러인 Airtable 대신 고객용 복제품을 5일 만에 만들었는데, 지금도 2주마다 예외 상황·화면 수정·'10분짜리 부탁'을 처리하고 있다고 적었습니다. 고객이 Airtable에 냈을 2,000달러보다 열 배는 더 골치를 썼다며, 원본만큼 품질을 내려면 전업 일이 된다고 했습니다.
3. 코딩 에이전트에게 코드 지도를 먼저 만들어 줍니다 techNmak는 프로젝트 전체를 함수·파일·문서가 어떻게 이어지는지 담은 지식 그래프(서로 연결된 정보 지도)로 만들어 주는 Graphify를 소개했습니다. 지도를 한 번 만들어 두면 에이전트가 매번 키워드로 파일 열두 개를 뒤지는 대신 '인증과 데이터베이스는 어떻게 이어지나'처럼 물어볼 수 있고, 코드 지도를 만들 때는 AI 모델을 부를 필요가 없다고 합니다.
4. MCP가 무엇인지 직접 만들어 보며 익힙니다 freeCodeCamp는 MCP(Model Context Protocol, AI 도구가 다른 프로그램·서비스에 연결되는 공통 규격)가 어떻게 작동하는지 설명하는 가이드를 소개했습니다. @manishmshiva가 쓴 이 가이드는 Python과 FastMCP 라이브러리로 MCP 서버를 직접 만들어 보게 합니다.
5. 쌓아 둔 X 북마크를 검색할 수 있는 자료실로 바꿉니다 moritzkremb는 Grok Bot으로 X 북마크를 매일 동기화하고, 검색·필터를 걸고, 대화로 즐겨찾기나 태그를 다는 도구를 만들었다고 적었습니다. 이렇게 모은 북마크를 Grok Bot이 참고 자료로 쓰게 할 수 있다며 설정 템플릿도 함께 공유했습니다.
6. 화면 부품의 구조를 도면처럼 정리하게 합니다 enesozturkdev는 Apple 액세서리 도면에서 영감을 얻어, 버튼·카드 같은 화면 부품의 구조를 사양서로 정리해 주는 스킬을 만들어 공개했습니다. 스킬은 AI가 필요할 때 꺼내 읽는 작업 설명서라, 한 번 만들어 두면 같은 형식의 문서를 반복해서 받을 수 있습니다.
출처 6🔥 @danikkk_wqs💬 @hustle_fred💬 @techNmak🔥 @freeCodeCamp🔥 @moritzkremb🔥 @enesozturkdev
📦 확인 방식
OpenAI 할인 수치는 The Information 보도를 옮긴 The Decoder 등에서, Anthropic 가이드는 claude.com 공식 글에서, Convovo 조사는 연구 페이지와 이를 옮긴 보도에서, 장애 기록은 Claude 상태 페이지에서 가져왔습니다. 회사와 개인이 밝힌 측정값은 외부 독립 검증 전입니다.
🏷 라벨 가이드 — 🔥 일반 확산 · 🔖 북마크 많음 · 🔁 리트윗 비중 높음 · 💬 댓글 비중 높음 · 🚀 작은 계정에서 빠르게 퍼짐