AI 브리핑 ·
AI가 다른 AI의 반복 답변을 고쳤다
5분 브리핑
약 2분 · 6개 흐름무슨 일이 있었고 나에게 무슨 의미인지 먼저 보고, 궁금한 소식은 본문으로 이어 보세요.
전체 분석 7분으로 바로 가기 ↓- GPT-6 Astra, Qwen3.5-0.8B 반복 답변 줄여…수학 시험 정답률 7.9%→48.1%
내게 의미AI가 다른 AI의 특정 고장을 찾아 내부 숫자를 고칠 가능성을 보여 줍니다. 외부 연구진의 초기 실험이며, 독립 재현은 미확인이므로 다른 모델에서도 같은 효과가 나는지는 더 확인해야 합니다.
- LongCat-2.5, 이미지 이해와 긴 코딩 작업을 지원하는 모델 공개
내게 의미시각 자료를 바탕으로 코딩·디자인 작업을 맡기려는 사람에게 선택지가 늘었습니다. 모델을 고를 때는 실제 작업의 완성도와 중간 수정에 드는 수고를 함께 비교할 만합니다.
- GDPx, Claude Opus 5.5·Gemini 4 Carbon·GPT-6 Astra의 전문 업무 능력 비교
내게 의미업무에 쓸 모델을 고른다면 종합 순위와 함께 분야별 점수와 비용을 볼 만합니다. 실제로 맡길 자료와 작업으로 시험하고, 결과를 사람이 얼마나 고쳐야 하는지도 확인해야 합니다.
- LifeVal, AI의 생활 업무 처리 능력 평가 공개
내게 의미생활 업무를 맡길 때는 추천 목록을 받는 데서 끝내지 말고, 어디까지 처리됐는지 확인할 만합니다. 장보기라면 주문 품목을, 메일 정리라면 해지할 대상을 먼저 정하고 결과를 검토하는 방식입니다.
- dots, 작업별 모델 자동 선택과 Terra 도입 예고
내게 의미계획대로라면 이용자가 모델 특성을 따져 고르는 부담이 줄어듭니다. 속도와 말투 개선은 담당자의 설명이며, 실제 체감 효과는 적용 뒤 확인해야 합니다.
- 🆕 그 밖의 신기능·신제품 — DeepSeek Harness 플러그인 제작·HackerTube 영상 추천
DeepSeek Harness(요청에 따라 도구를 쓰는 AI 앱)의 Creator Mode는 원하는 기능을 플러그인(앱에 붙이는 추가 기능)으로 만드는 모드입니다. · 제작자 발표는 디자인 작업 공간과 게임 등을 예로 들었습니다.
내게 의미평소 불편했던 기능이나 추천 목록을 작은 개인용 도구로 만들어 볼 수 있습니다. 사람은 만들 것을 정하고 결과를 확인해야 합니다.
주요 키워드 TOP 5: GPT-6 Astra · LongCat-2.5 · GDPx · LifeVal · dots | 메인 이벤트: GPT-6 Astra가 작은 모델의 반복 답변 문제를 줄여 수학 시험 정답률을 높인 연구 결과가 나왔습니다.
MIT CSAIL 연구진은 GPT-6 Astra로 작은 모델이 풀이 도중 같은 글을 되풀이하는 문제를 줄였습니다. 답을 끝까지 내지 못하던 문제가 줄면서 수학 시험 정답률도 올랐습니다. AI가 다른 AI의 고장을 찾아 고친 초기 사례이지만, 수학 능력 전반이 좋아졌다는 뜻인지는 구분해서 볼 필요가 있습니다.
시각은 인용 게시물의 작성 시각을 한국 시각(KST)으로 바꾼 값입니다.
1. GPT-6 Astra, Qwen3.5-0.8B 반복 답변 줄여…수학 시험 정답률 7.9%→48.1%
- MIT CSAIL(컴퓨터과학·AI 연구소) 연구진은 GPT-6 Astra로 작은 언어 모델 Qwen3.5-0.8B의 반복 답변 문제를 줄였다고 보고했습니다.
- 수학 문제 시험 MATH-500의 정답률은 7.9%→48.1%로 올랐습니다. 문제마다 답변 4개를 생성해 평균한 점수입니다.
- 가중치(모델의 동작을 정하는 내부 숫자)의 0.016%만 수정했습니다. 데이터를 반복 학습시키는 과정은 쓰지 않았습니다.
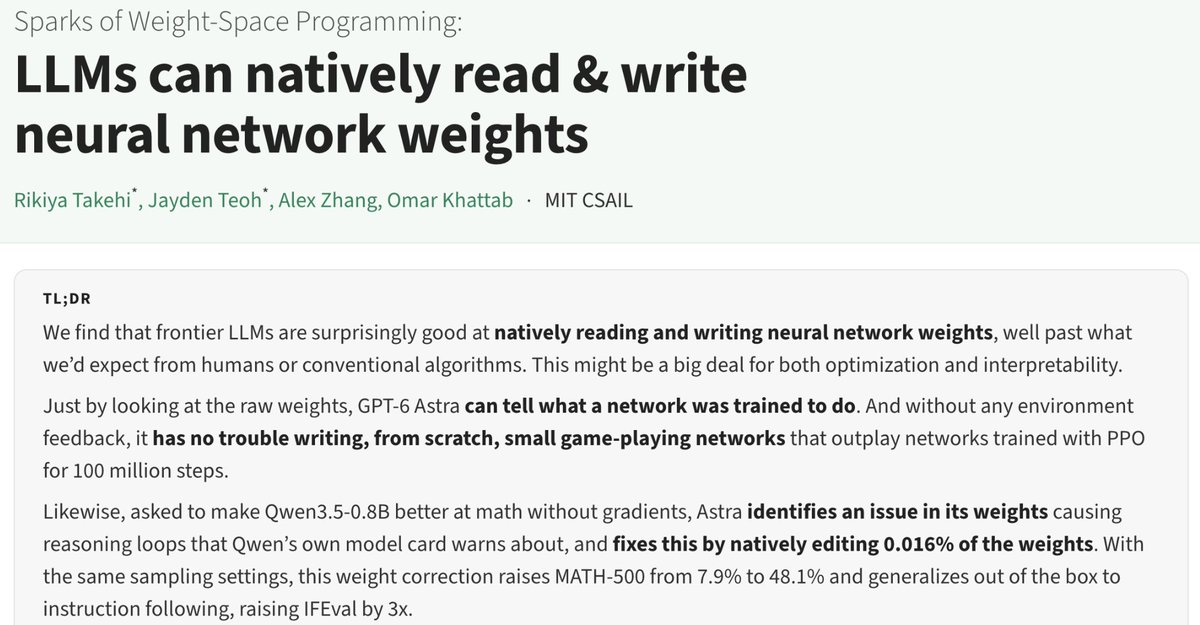
이 결과는 여러 연습 문제를 묶어 처리하는 모델 실행을 50회 허용한 수정 조건에서 나왔습니다. 작은 모델은 풀이 도중 같은 글을 되풀이하다 답을 끝내지 못하곤 했습니다. Astra는 연습용 문제의 응답과 내부 숫자를 살펴 반복을 일으키는 부분을 바꿨습니다.
수정 전후 답변 생성 설정은 같았고, 최종 평가 문제는 Astra에 보여 주지 않았습니다. 연구진은 이 개선을 원래 풀 수 있던 문제의 답을 끝까지 내도록 만든 효과라고 설명합니다. 수학 능력 전반이 같은 폭으로 좋아졌다고 읽기는 어렵습니다.
그 밖에: 반복 문제가 드문 Gemma 3 270M에서는 같은 방식으로 뚜렷한 수학 성능 개선을 얻지 못했습니다.
시사점: AI가 다른 AI의 특정 고장을 찾아 내부 숫자를 고칠 가능성을 보여 줍니다. 외부 연구진의 초기 실험이며, 독립 재현은 미확인이므로 다른 모델에서도 같은 효과가 나는지는 더 확인해야 합니다.
#GPT6Astra #Qwen35 #AI연구
출처 4🚀 @rikiyatakehi🔥 @jayden_teoh_💬 @lateinteraction연구자 실험 원문
2. LongCat-2.5, 이미지 이해와 긴 코딩 작업을 지원하는 모델 공개
- Meituan이 LongCat-2.5를 공개했습니다. 이미지와 글을 함께 읽으며 작업하는 모델입니다.
- 회사는 여러 단계의 코딩 작업을 주요 용도로 내세웁니다. 복잡한 소프트웨어 개발과 프로젝트 전체 구성, 디자인·3D(입체 표현) 작업을 겨냥합니다.
- API(다른 앱에서 모델을 불러 쓰는 연결 통로)로 이용할 수 있습니다.
공식 문서는 스크린샷 속 글자를 읽거나 차트를 분석하는 사용법을 안내합니다. 이런 이미지 이해를 코딩과 결합하면, 시각 자료를 참고해 웹페이지나 프로그램을 만드는 데 활용할 수 있습니다. Meituan은 작업을 여러 단계에 걸쳐 수행하는 AI 에이전트의 능력을 강화했다고 설명합니다. 자료를 읽고 결과물을 만드는 과정을 함께 맡기는 용도를 겨냥한 공개입니다.
그 밖에: 발표에 실린 다른 모델과의 성능 비교는 Meituan의 자체 평가입니다. 실제 업무에서 어느 모델이 더 잘하는지는 별도로 확인해야 합니다.
시사점: 시각 자료를 바탕으로 코딩·디자인 작업을 맡기려는 사람에게 선택지가 늘었습니다. 모델을 고를 때는 실제 작업의 완성도와 중간 수정에 드는 수고를 함께 비교할 만합니다.
#LongCat #이미지이해 #AI에이전트
출처 4🔥 @Meituan_LongCat💬 @CodetocashAiMeituan 공식 발표이미지 이해 공식 문서
3. GDPx, Claude Opus 5.5·Gemini 4 Carbon·GPT-6 Astra의 전문 업무 능력 비교
- AI·반도체 분석 업체 SemiAnalysis가 GDPx(자료를 찾고 도구를 써서 전문 업무를 수행하는 평가)를 공개했습니다. 11개 분야의 206개 과제로 구성한 전문 업무 수행 평가입니다.
- 종합 점수는 Claude Opus 5.5가 12.0%, Gemini 4 Carbon이 10.9%, GPT-6 Astra가 9.6%입니다. 각 분야에 같은 비중을 둔 이 시험의 점수입니다.
- 시험에서 측정한 과제당 평균 비용은 같은 순서로 51.41달러·16.29달러·53.99달러입니다. Carbon은 Opus에 가까운 점수를 더 낮은 비용으로 기록했습니다.
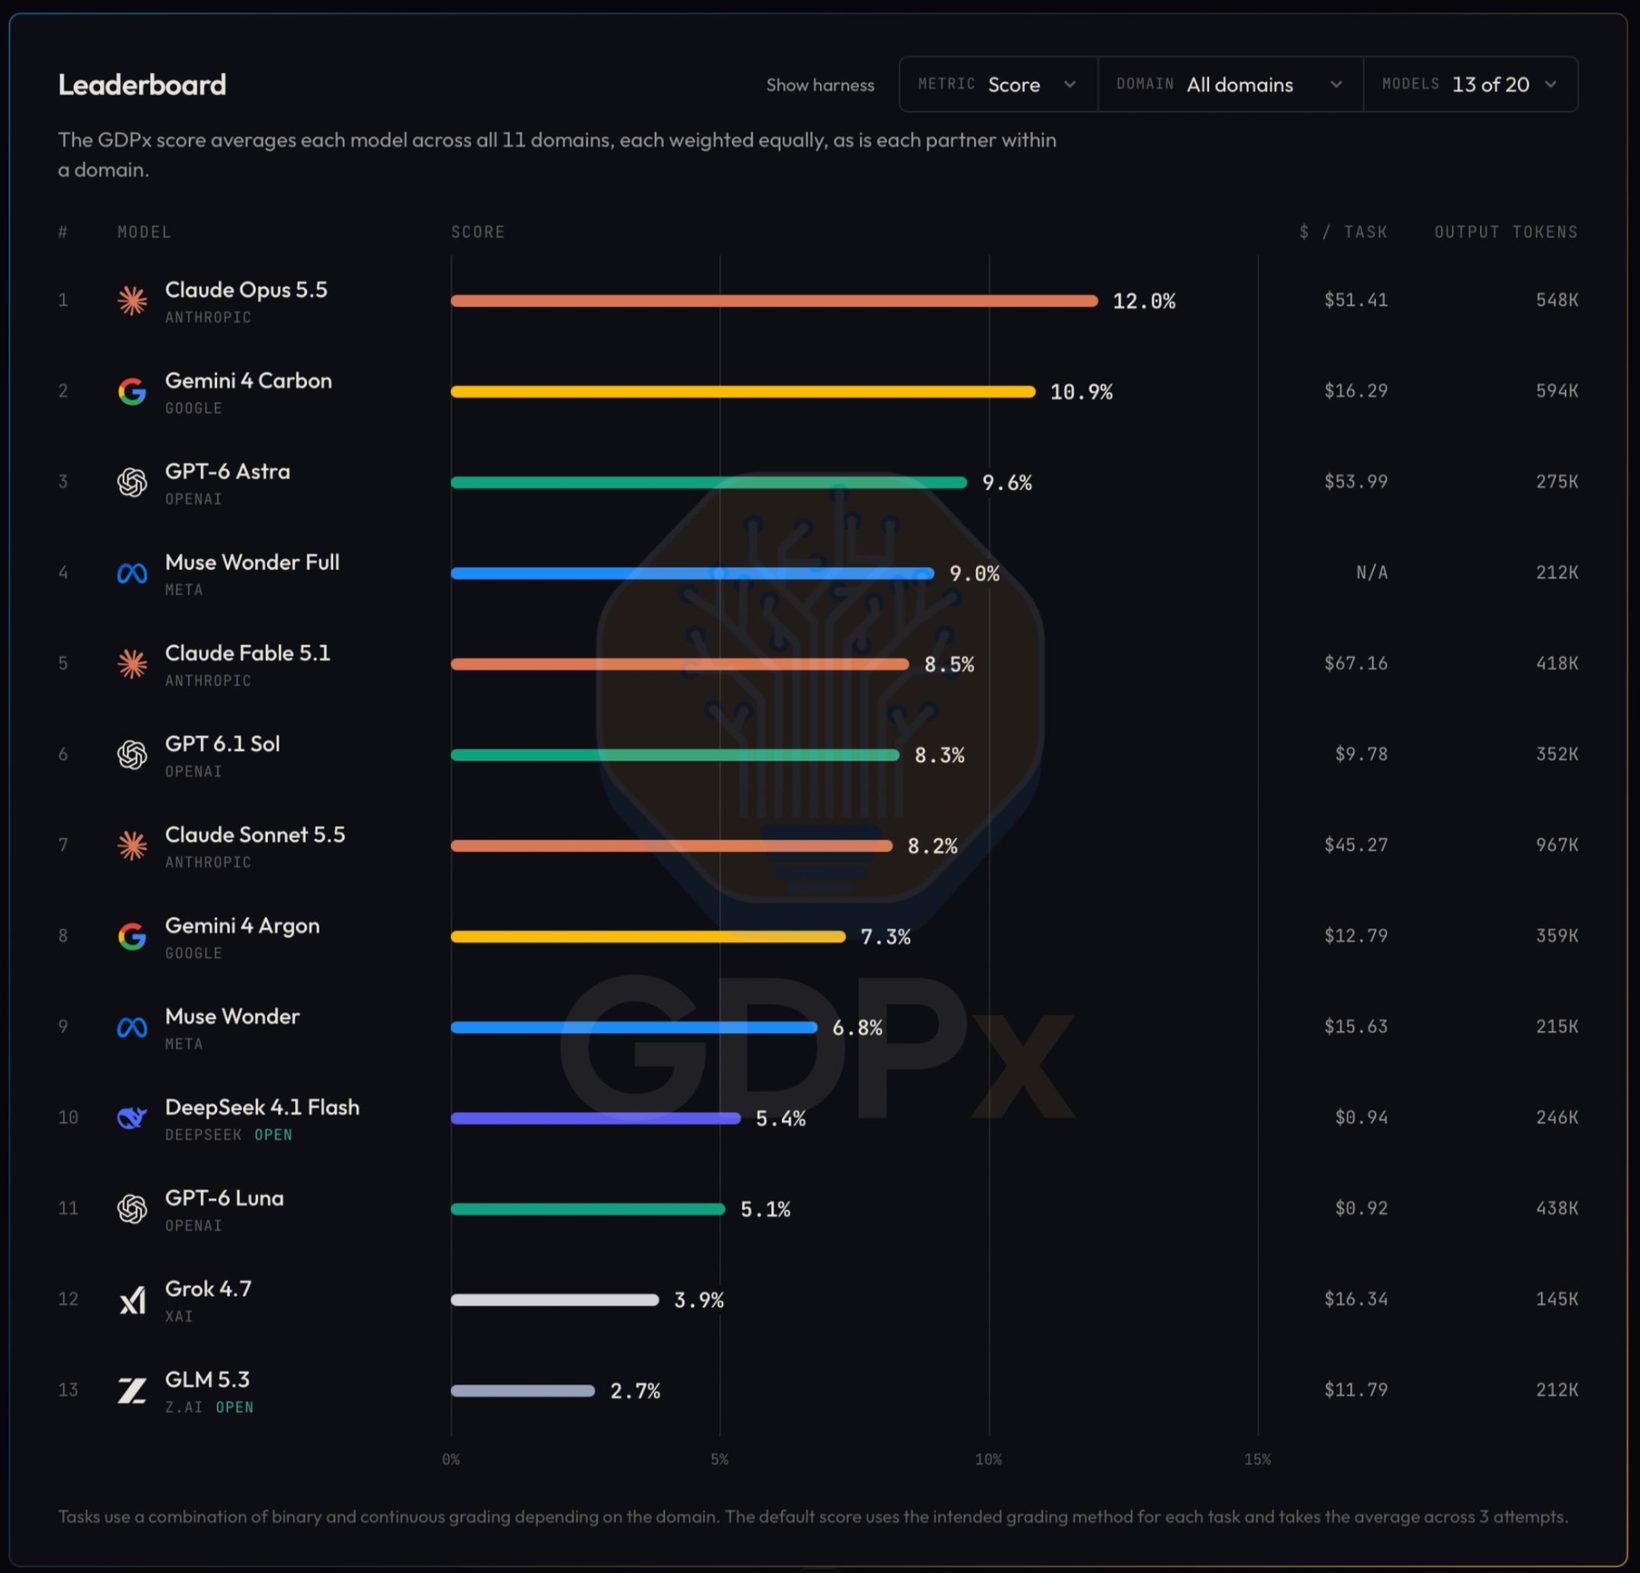
GDPx는 전문 업무를 맡길 AI를 고를 때, 답변의 인상 외에 수행 결과와 비용을 비교할 근거를 더합니다. 금융 과제에서는 여러 문서가 든 작업 공간에서 필요한 자료를 직접 찾아야 합니다. 주어진 내용을 그럴듯하게 정리하는 데서 끝나지 않고, 업무에 필요한 맥락을 모을 수 있는지도 보는 셈입니다.
다만 점수는 과제에 따라 성공 여부 또는 부분 점수를 매긴 뒤 세 차례 시도의 결과를 평균합니다. 12.0%를 일상 업무 전체의 성공률이나 대체 가능한 일자리 비율로 읽어서는 안 됩니다.
그 밖에: SemiAnalysis는 발표 당시 일반 공개 전이던 Carbon이 생물학과 소프트웨어 개발 분야에서 가장 높은 점수를 기록했다고 설명합니다. 모델마다 사용하는 실행 도구가 다르고, 안전장치가 일부 과제 수행을 막아 점수에 영향을 줄 수 있다는 조건도 밝혔습니다.
시사점: 업무에 쓸 모델을 고른다면 종합 순위와 함께 분야별 점수와 비용을 볼 만합니다. 실제로 맡길 자료와 작업으로 시험하고, 결과를 사람이 얼마나 고쳐야 하는지도 확인해야 합니다.
#GDPx #AI평가 #업무자동화
출처 5💬 @SemiAnalysis_🔥 @dylan522p🔥 @PatrickOjo_GDPx 평가 사이트SemiAnalysis 평가 설명
4. LifeVal, AI의 생활 업무 처리 능력 평가 공개
- OpenAI가 11월 2일 LifeVal(생활 속 일을 AI가 얼마나 잘 처리하는지 재는 평가)을 공개했습니다.
- 사람들이 어디에 도움을 원하는지 3,995명 설문으로 확인하고, 돌봄·쇼핑·가정 행정 등을 평가 분야로 정했습니다.
- The Rundown AI가 전한 GPT-6 Astra의 메일 구독 해지 점수는 100%입니다. 다만 해당 과제의 최고 기록 기준이며, 회사 자체 평가입니다.
원하지 않는 메일 구독을 정리하려면 어떤 메일을 더 받지 않을지 정하고, 실제 해지 절차까지 마쳐야 합니다. OpenAI는 이런 일을 돕는 데 조언이나 대화 응답만으로는 부족하다고 설명합니다.
LifeVal은 사람들이 시간을 쓰는 활동을 조사한 기존 자료에 설문을 더해 만들었습니다. AI가 실제 생활 업무를 얼마나 처리하는지 살펴보려는 시도입니다. 다만 특정 과제의 최고 점수가 내 계정에서도 매번 같은 결과를 낸다는 뜻은 아닙니다.
그 밖에: 공식 글은 이사 뒤 유치원 비교와 등록 정보 정리를 과제 사례로 소개합니다. 정부 서비스 이용도 평가 분야에 포함됩니다. 브라우저와 컴퓨터를 조작하는 능력을 생활 업무에 연결하려는 방향입니다.
시사점: 생활 업무를 맡길 때는 추천 목록을 받는 데서 끝내지 말고, 어디까지 처리됐는지 확인할 만합니다. 장보기라면 주문 품목을, 메일 정리라면 해지할 대상을 먼저 정하고 결과를 검토하는 방식입니다.
#LifeVal #GPT6Astra #생활업무
출처 4💬 @TheRundownAI💬 @_simonsmith🔥 @SiftByteOpenAI 공식 발표
5. dots, 작업별 모델 자동 선택과 Terra 도입 예고
- OpenAI 담당자 Tibo는 개인 AI 비서 dots를 구동하는 모델을 늘리는 작업을 진행 중이라고 밝혔습니다. GPT-6 Astra와 GPT-6.1 Terra 등이 포함됩니다.
- 후속 답글에서는 작업별 모델 자동 선택 계획을 설명했습니다. 한 작업 안에서도 부분마다 서로 다른 모델을 쓰겠다는 내용입니다.
- Tibo는 Terra가 응답 속도와 말투를 개선하고, dots를 더 많은 사람에게 제공하는 데 도움이 될 것이라고 말했습니다.
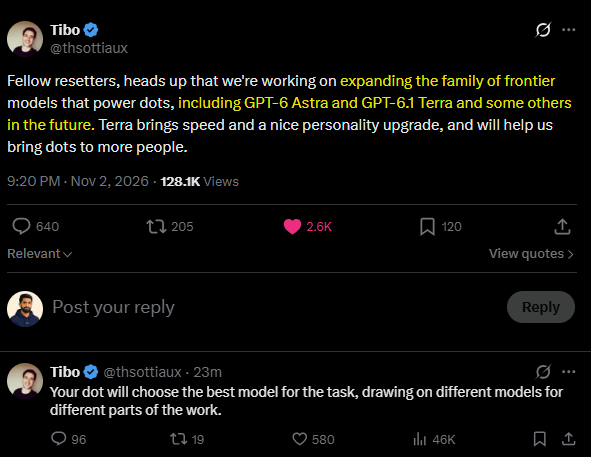
dots는 대화가 끝난 뒤에도 맡은 일을 이어 가는 AI 비서입니다. 여러 모델을 작업에 맞춰 쓰겠다는 계획은 답변을 기다리는 시간과 긴 작업의 처리 능력을 함께 고려하려는 방향으로 읽힙니다.
그 밖에: Tibo는 앞으로 다른 모델도 더할 계획이라고 덧붙였습니다. 구체적인 적용일은 이번 글에서 밝히지 않았습니다.
시사점: 계획대로라면 이용자가 모델 특성을 따져 고르는 부담이 줄어듭니다. 속도와 말투 개선은 담당자의 설명이며, 실제 체감 효과는 적용 뒤 확인해야 합니다.
#dots #모델자동선택 #GPT61Terra
출처 3💬 @thsottiaux💬 @SiftBytedots 공식 안내
6. 🆕 그 밖의 신기능·신제품 — DeepSeek Harness 플러그인 제작·HackerTube 영상 추천
- DeepSeek Harness(요청에 따라 도구를 쓰는 AI 앱)의 Creator Mode는 원하는 기능을 플러그인(앱에 붙이는 추가 기능)으로 만드는 모드입니다.
- 제작자 발표는 디자인 작업 공간과 게임 등을 예로 들었습니다.
- 카르파티는 Claude로 기술 커뮤니티 Hacker News에서 추천한 영상을 모은 HackerTube를 만들었습니다.
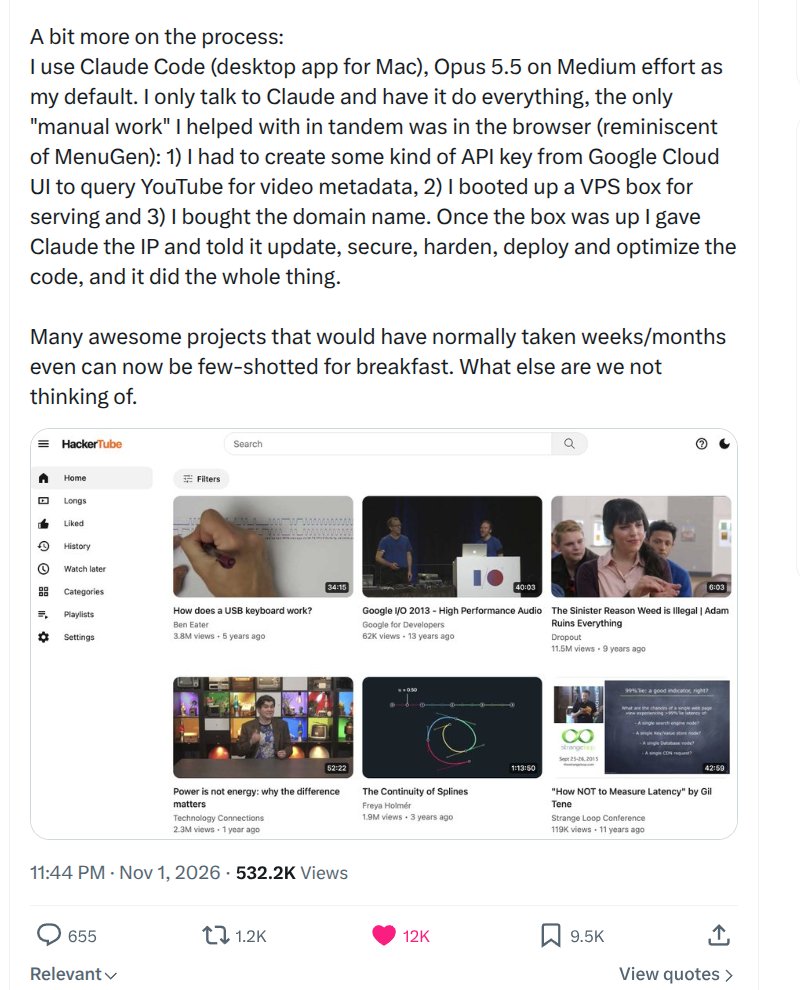
원하는 기능과 영상 선정 기준을 정해 AI에 제작을 맡긴 사례입니다. 카르파티의 10월 31일자 제작기에 따르면 HackerTube에는 영상 6,454개가 모였고 제작에는 약 2시간이 걸렸습니다. 다만 YouTube 정보 조회용 인증키 발급, 서버 준비, 사이트 주소인 도메인 구매는 직접 했습니다.
그 밖에: 공식 문서에 따르면 플러그인 추가 메뉴에서 Creator 모드를 시작합니다. DeepSeek Harness는 개발자 미리보기 단계입니다.
시사점: 평소 불편했던 기능이나 추천 목록을 작은 개인용 도구로 만들어 볼 수 있습니다. 사람은 만들 것을 정하고 결과를 확인해야 합니다.
#DeepSeekHarness #HackerTube #바이브코딩
출처 9🔥 @vishalsingh2972💬 @haizhong_zheng🔥 @rohanpaul_ai💬 @amorriscode🔥 @RLanceMartinCreator 공식 문서공식 저장소HackerTube카르파티 제작기
오늘의 감정·온도
오늘의 실무 팁 — 쉽게 풀어 쓴 사용법 6가지
1. 점수가 오른 이유부터 확인합니다
Qwen 연구에서는 반복 답변을 줄여 답을 끝까지 내는 능력이 좋아졌습니다. 같은 점수 상승이라도 어떤 문제가 줄었는지 확인하면 내 작업에 도움이 될지 판단하기 쉽습니다.
2. 이미지와 코딩을 함께 시험합니다
화면을 참고해 프로그램을 만들려면 글자를 잘 읽는지와 결과물을 잘 만드는지를 함께 봅니다. LongCat-2.5도 실제로 쓸 시각 자료를 주고 중간 수정에 드는 수고까지 확인할 만합니다.
3. 업무 모델은 분야와 비용을 함께 봅니다
GDPx의 종합 순위만으로 내가 맡길 업무의 결과를 예상하기는 어렵습니다. 같은 자료와 과제로 시험한 뒤 비용과 사람이 고쳐야 할 부분을 함께 비교합니다.
4. 생활 업무는 완료 범위를 먼저 정합니다
메일 정리라면 어떤 구독을 해지할지 먼저 정합니다. AI가 처리한 뒤에는 설명만 읽지 말고 실제 해지 여부를 확인합니다.
5. 기능 예고와 적용 완료를 구분합니다
dots의 모델 확대는 작업 중이라는 담당자 예고입니다. 실제 적용을 확인한 뒤 응답 속도와 말투가 내 사용 방식에 맞는지 살펴봅니다.
6. 개인용 도구 제작의 준비 작업도 챙깁니다
HackerTube 제작자는 AI에 코딩을 맡겼지만 인증키와 서버, 도메인은 직접 준비했습니다. 만들고 싶은 기능과 함께 사람이 준비하고 확인할 항목도 정해 둡니다.
📦 확인 방식
수치는 연구자 실험 원문·평가 사이트·공식 발표와 본문에 밝힌 보도에서 가져왔습니다. 회사·제작자의 자체 수치와 재현되지 않은 사용 성과는 외부 독립 검증 전입니다.
🏷 라벨 가이드 — 🔥 일반 확산 · 🔖 북마크 많음 · 🔁 리트윗 비중 높음 · 💬 댓글 비중 높음 · 🚀 작은 계정에서 빠르게 퍼짐