AI 브리핑 ·
Gemini 4 Carbon 제한 공개
5분 브리핑
약 2분 · 6개 흐름무슨 일이 있었고 나에게 무슨 의미인지 먼저 보고, 궁금한 소식은 본문으로 이어 보세요.
전체 분석 9분으로 바로 가기 ↓- Gemini 4 Carbon 발표…독립 종합평가 1위, 보안 담당자부터 제한 제공
내게 의미복잡한 개발·보안 작업을 AI에 맡길 선택지가 개선됐습니다. 다만 일반 공개일은 미정이므로, 지금 도입 계획을 세울 때는 점수와 함께 실제 이용 자격을 확인해야 합니다.
- Artificial Analysis 종합지수 v5, 비공개 시험 비중 60%로…Claude·GPT·공개 모델 다시 비교
내게 의미모델을 고를 때는 종합점수와 함께 작업별 평가 결과·비용을 볼 만합니다. 주로 영어로 진행하는 시험이므로 한국어 업무에서도 같은 순서일지는 직접 확인해야 합니다.
- Claude, 신약 후보 설계부터 제조 서류 검토까지…실제 연구 사례 공개
내게 의미연구팀은 후보 설계뿐 아니라 반복적인 서류 확인에도 AI를 활용할 수 있습니다. 다만 이번 발표의 연구는 대부분 사람 대상 시험 이전 단계이므로, 환자에게 효과가 입증된 치료제와 구분해야 합니다.
- DAYJOB: Tax, 세무 업무 50개 시험…Claude Sonnet 5.5도 통과율 10.8%
내게 의미AI에 업무를 맡길 때는 답변의 문장과 계산뿐 아니라 빠진 자료·기한·확인되지 않은 전제까지 사람이 검토할 필요가 있습니다. 이번 결과는 세무 업무를 끝까지 위임할 때 확인해야 할 한계를 구체적으로 보여 줍니다.
- Claude, 미국 연방·지방정부에 40% 할인…최소 지출 약정 없이 제공
내게 의미미국 공공기관이 작은 업무부터 비용과 효과를 확인하며 Claude 도입을 시험할 여지가 커졌습니다. 시범 운영의 시간 절약 수치를 다른 기관의 예상 성과로 그대로 적용하기는 어렵습니다.
- 🆕 그 밖의 신기능·신제품 — Exa 팟캐스트 검색·Claude Duet 초대 확대
Exa: 회사에 따르면 팟캐스트 에피소드 300만 개 이상을 대상으로 대본 속 발언 검색을 제공하며, 자료를 매일 갱신합니다.
내게 의미팟캐스트 조사에서는 검색된 발언의 앞뒤 맥락을 확인하고, Claude Duet은 거주 지역과 대기 명단·초대 여부를 먼저 확인할 만합니다.
주요 키워드 TOP 5: Gemini 4 Carbon · AI 종합평가 · Claude 신약 연구 · 세무 AI 한계 · 정부 AI 할인 | 메인 이벤트: Google의 Gemini 4 Carbon이 독립 종합평가에서 앞섰지만, 일부 보안 담당자부터 제한적으로 제공합니다.
Google은 Gemini 4 Carbon으로 오래 이어지는 개발 작업과 보안 취약점 수정을 개선했다고 밝혔습니다. 작업을 더 오래 이어갈 수 있다면 사람이 중간마다 다시 지시하는 부담을 줄일 여지가 있습니다. 다만 일부 보안 담당자부터 제공하므로, 독립 평가 점수와 내가 실제로 이용할 수 있는 범위를 함께 확인해야 합니다. 오늘 확인된 새 프론티어 모델 출시는 많지 않아, 새 평가와 실제 사용 결과·접근 조건을 중심으로 전합니다.
위 시각은 한국 시간(KST)으로, 본문에서 인용한 게시물이 올라온 때를 기준으로 정리했습니다.
1. Gemini 4 Carbon 발표…독립 종합평가 1위, 보안 담당자부터 제한 제공
- Google이 10월 28일 Gemini 4 Carbon을 발표했습니다. 회사에 따르면 오랜 시간 여러 단계를 수행하는 개발 작업과 보안 취약점을 찾아 고치는 능력이 개선됐습니다.
- 독립 평가 기관 Artificial Analysis의 추론·지식·코딩 등 9개 시험을 묶은 Intelligence Index v5에서 종합지수 59점으로 1위를 기록했습니다. 추론에 더 많은 노력을 쓰는 high 설정의 결과이며, 정답률 59%라는 뜻은 아닙니다.
- 보안 담당자부터 제한 제공합니다. 일부 보안 담당자에게 Fairwind Program을 통해 먼저 제공하며, 개발자·기업·일반 이용자로 넓힐 날짜는 밝히지 않았습니다.
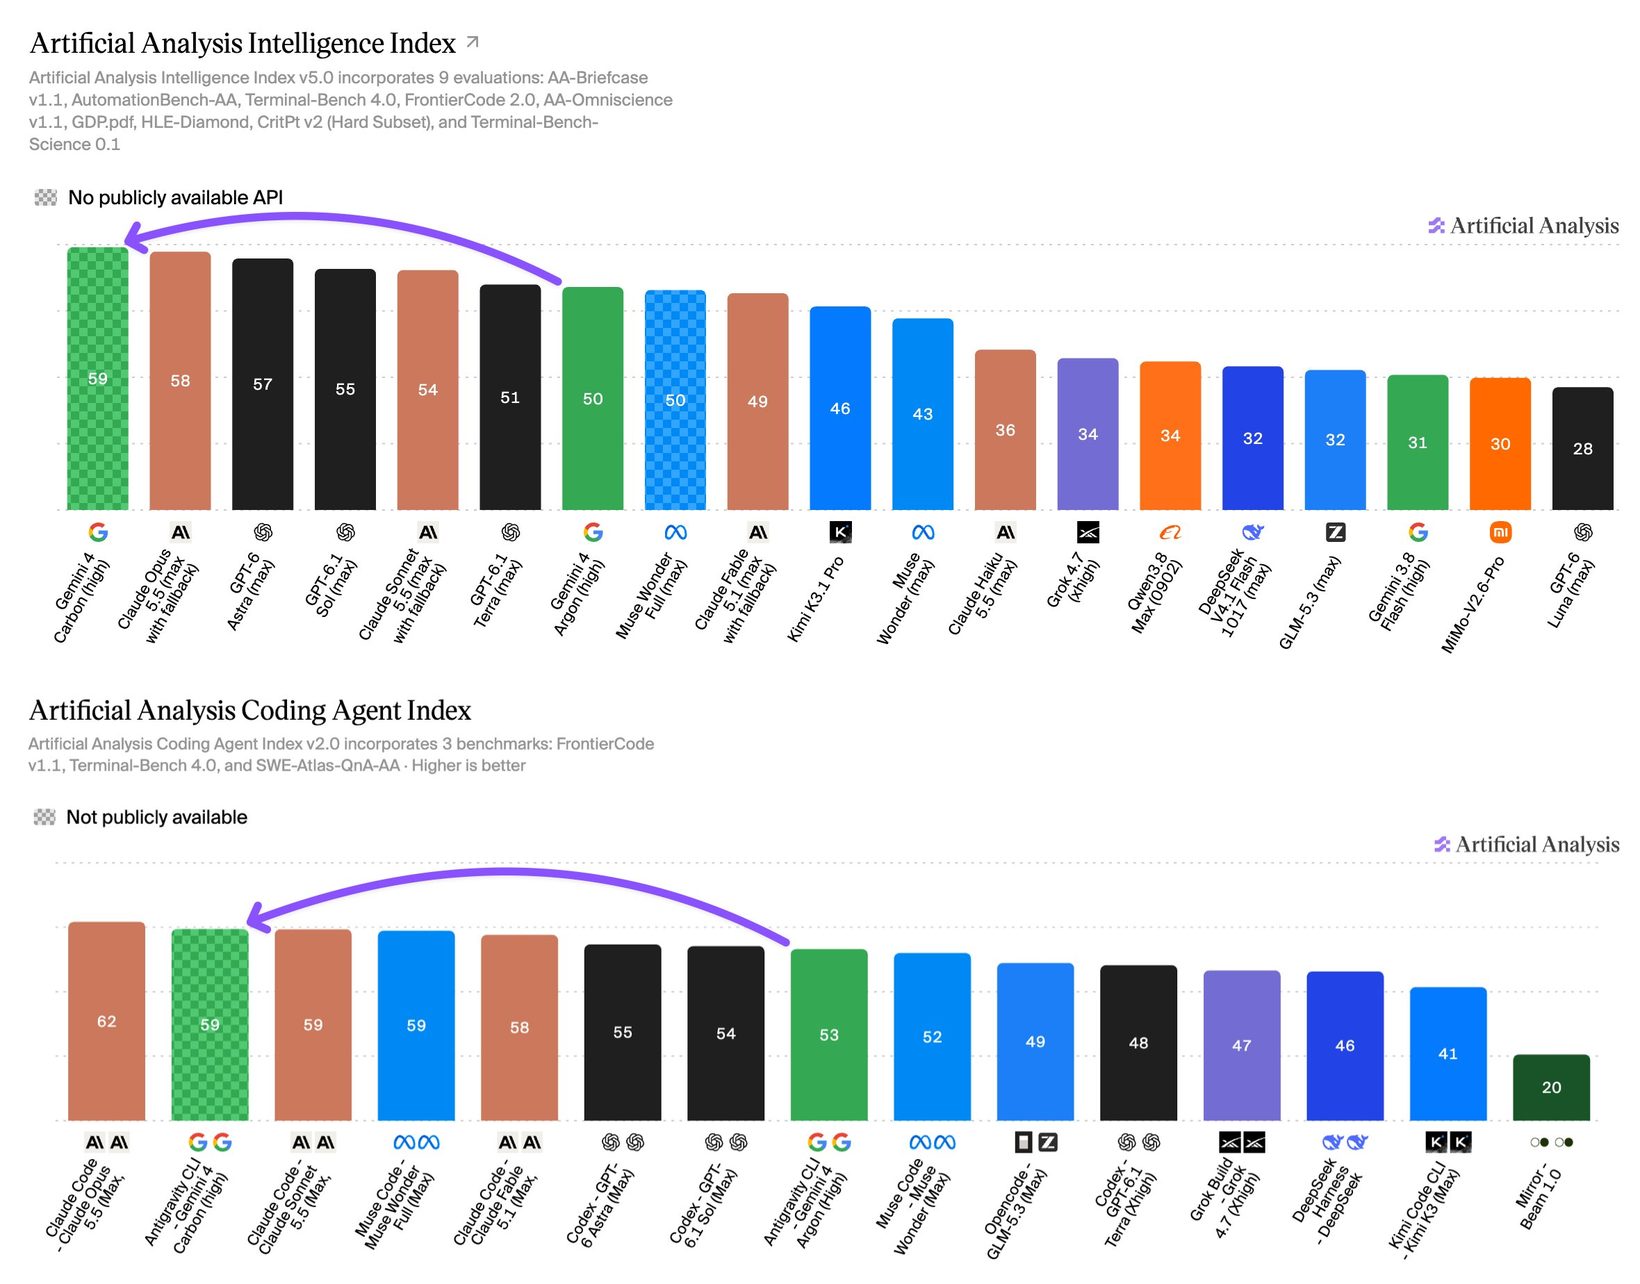
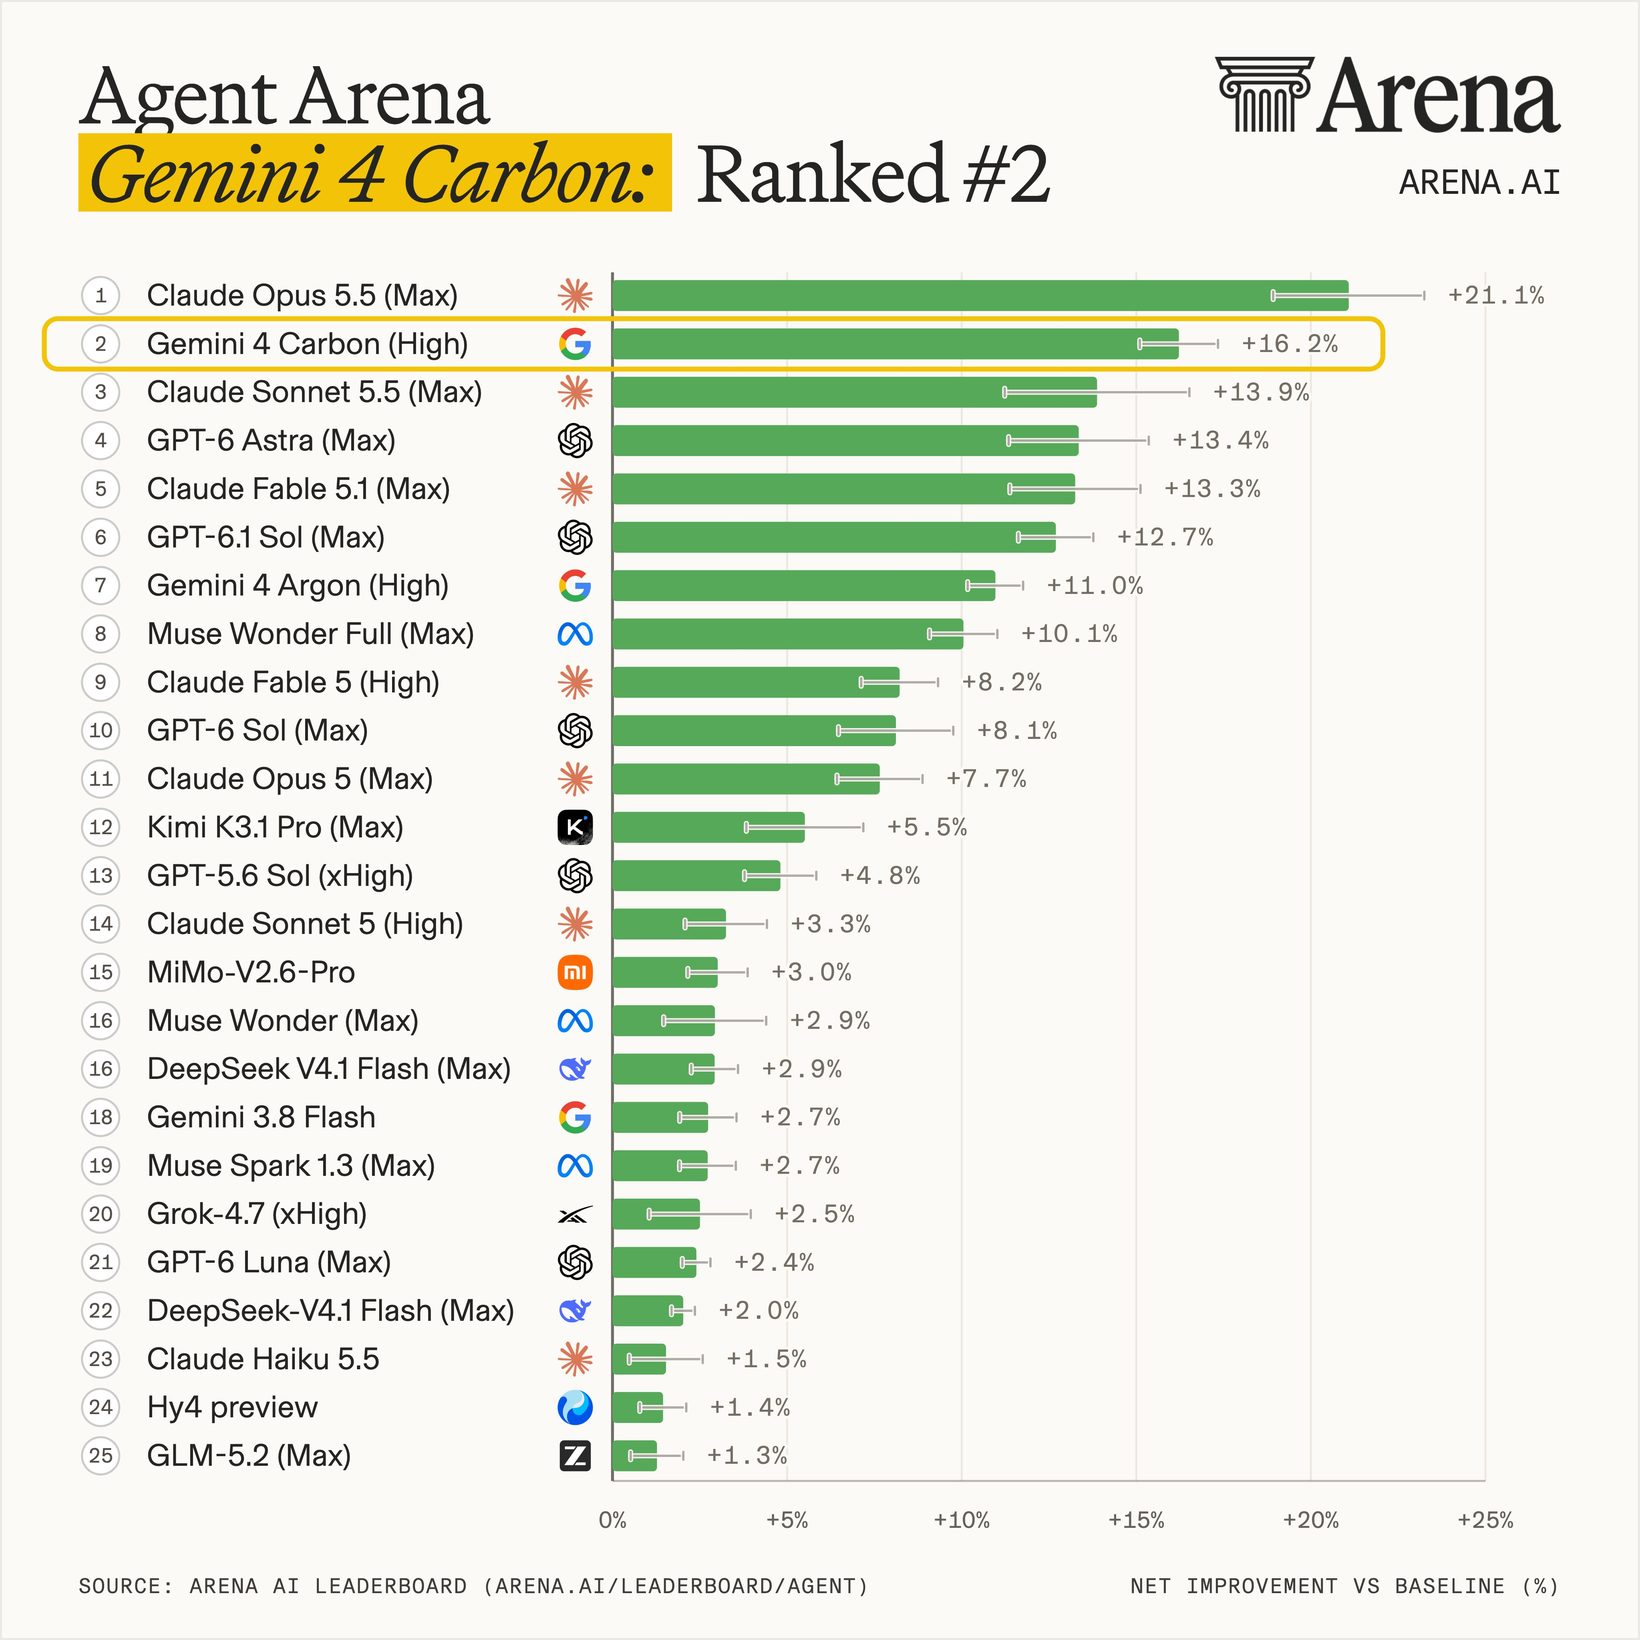
Google은 내부 개발팀이 Carbon을 며칠 동안 실행해 큰 소프트웨어의 미묘한 오류 원인을 찾고 수정했다고 설명합니다. 이런 작업을 더 오래 이어갈 수 있다면 사람이 중간마다 다시 지시해야 하는 부담을 줄일 여지가 있습니다. 다만 이는 회사가 전한 내부 사용 사례입니다.
독립 종합평가에서 앞섰다는 사실을 모든 작업에서 가장 잘한다는 뜻으로 받아들여서는 안 됩니다. 실제로 첨부 차트의 코딩 종합점수는 최고점에 못 미칩니다.
그 밖에: 출시 초기 요금은 100만 토큰(AI가 글을 처리하는 분량 단위)당 입력 2달러·출력 10달러이며, 초기 기간이 끝나면 각각 4달러·20달러입니다. Artificial Analysis의 비용 비교는 할인을 적용하지 않은 정가를 사용하므로, 발표 요금과 비교할 때 조건을 맞춰야 합니다.
시사점: 복잡한 개발·보안 작업을 AI에 맡길 선택지가 개선됐습니다. 다만 일반 공개일은 미정이므로, 지금 도입 계획을 세울 때는 점수와 함께 실제 이용 자격을 확인해야 합니다.
#Gemini4Carbon #AI성능평가 #보안
출처 6🔥 @ArtificialAnlys🔥 @ArtificialAnlys🔥 @ArtificialAnlys🔥 @arena🔥 @tulseedoshiGoogle 공식 발표
2. Artificial Analysis 종합지수 v5, 비공개 시험 비중 60%로…Claude·GPT·공개 모델 다시 비교
- AI 평가기관 Artificial Analysis가 10월 28일 종합 능력 지표인 Intelligence Index를 v5로 개편했습니다. 9개 시험의 점수를 가중평균하며, 비공개 평가 비중 60%는 문제 수가 아닌 점수 가중치 기준입니다. 시험 문제나 정답을 공개하지 않은 평가가 여기에 해당합니다.
- v5 발표 당시 종합점수는 Claude Opus 5.5가 58점, GPT-6 Astra가 57점입니다. GPT-6.1 Sol은 55점입니다. 모두 모델이 답을 만들 때 들이는 노력을 최대로 설정한 결과입니다.
- 모델 파일을 실제로 내려받을 수 있는 모델 중에는 DeepSeek V4.1 Flash 1017과 GLM-5.3이 각각 32점으로 앞섰습니다. 46점을 받은 Kimi K3.1 Pro는 발표 당시 파일이 미공개여서 구분해야 합니다.
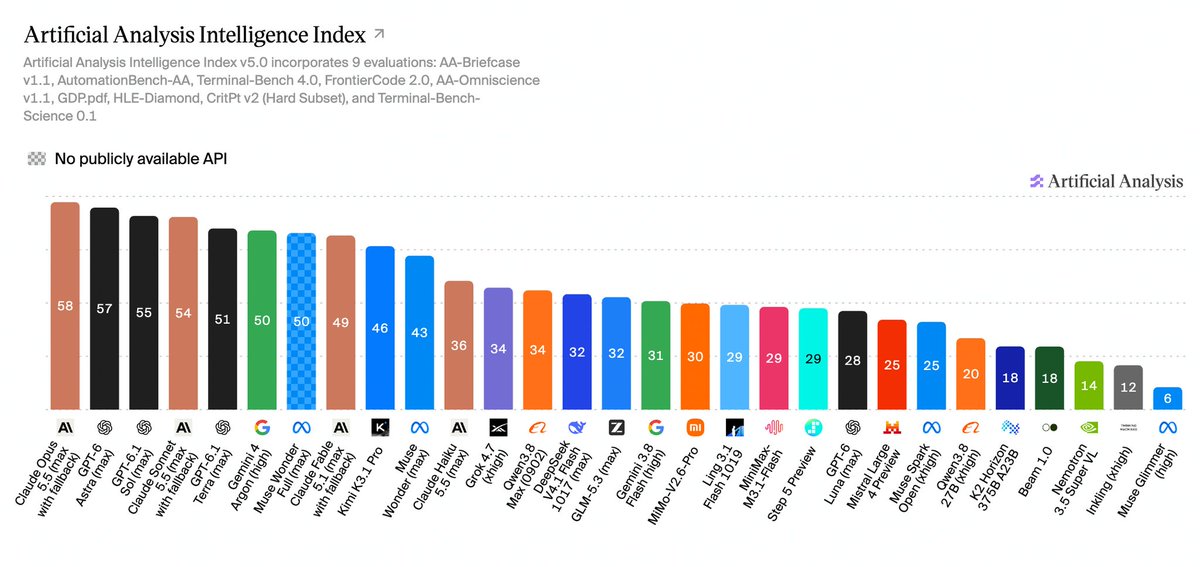
새로 들어간 FrontierCode 2.0은 실제 공개 소프트웨어의 수정 과제 132개를 풀게 합니다. 관리자가 받아들일 만한 변경인지 평가하며, 필수 검사를 하나라도 통과하지 못하면 해당 시도는 0점입니다. 발표 당시 평균 평가점수는 Claude Opus 5.5가 46%, GPT-6 Astra가 42%였습니다. 필수 검사를 통과하면 세부 기준별 점수를 합치므로, 과제를 완수한 비율과는 다릅니다.
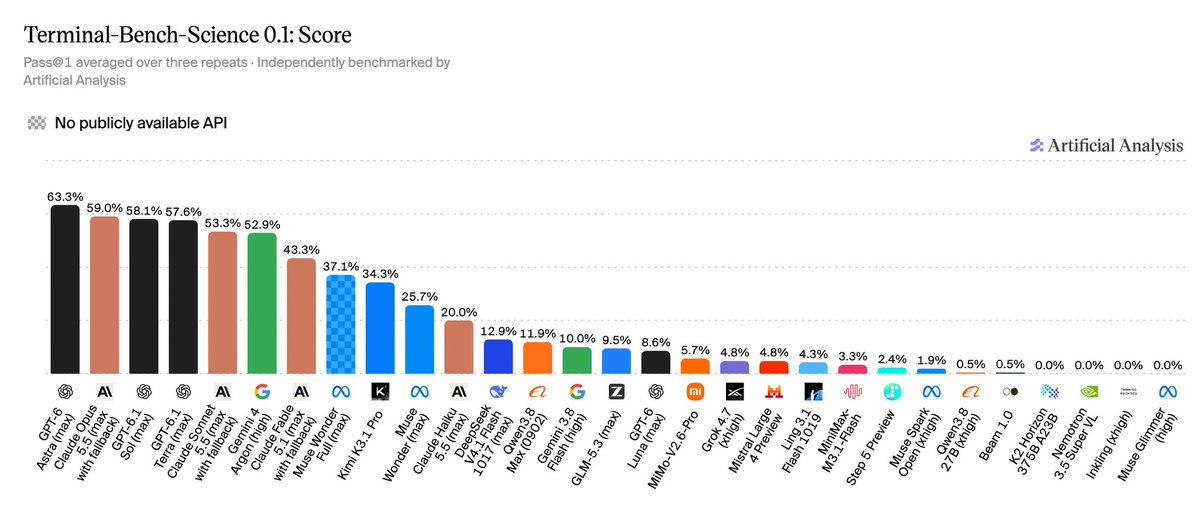
함께 추가된 Terminal-Bench-Science는 AI가 도구를 써서 과학 연구 작업을 마치는지 70개 과제로 평가합니다. 여기서는 GPT-6 Astra가 앞서, 작업별 강점은 다릅니다. 비공개 평가 확대는 이미 알려진 문제에 익숙해져 점수가 높아지는 영향을 줄이려는 취지입니다.
그 밖에: 발표 당시 답변에 들이는 노력을 최대로 설정했을 때 시험 과제당 가중평균 사용료는 GPT-6.1 Sol이 1.27달러, Claude Opus 5.5가 10.04달러였습니다. 이는 해당 평가를 수행할 때의 모델 사용료이며 월 구독료나 모든 업무의 처리 비용을 뜻하지 않습니다.
시사점: 모델을 고를 때는 종합점수와 함께 작업별 평가 결과·비용을 볼 만합니다. 주로 영어로 진행하는 시험이므로 한국어 업무에서도 같은 순서일지는 직접 확인해야 합니다.
#ArtificialAnalysis #모델평가 #AI비용
출처 5💬 @ArtificialAnlys🔥 @ArtificialAnlys🔥 @ArtificialAnlys공식 개편 발표평가 구성·방법
3. Claude, 신약 후보 설계부터 제조 서류 검토까지…실제 연구 사례 공개
- Anthropic이 10월 27일 신약을 개발하는 6개 조직과의 연구 사례를 공개했습니다. Claude를 후보 물질 설계부터 제조 기록 검토·임상시험 계획까지 활용했습니다.
- Enveda는 제조 기록 1,061쪽을 평가해 검토 시간 89% 단축을 보고했습니다. AI 처리와 사람의 확인을 합친 시간이 25시간 이상에서 3시간 미만으로 줄었습니다.
- Generate Biomedicines는 코딩용 AI 도구 Claude Code를 활용해 암 치료용 면역세포에서 공격 신호를 전달하는 단백질 부분을 약 70% 짧게 설계했습니다. 실험실 시험에서 암세포를 제거하는 기능도 개선됐다고 밝혔습니다.
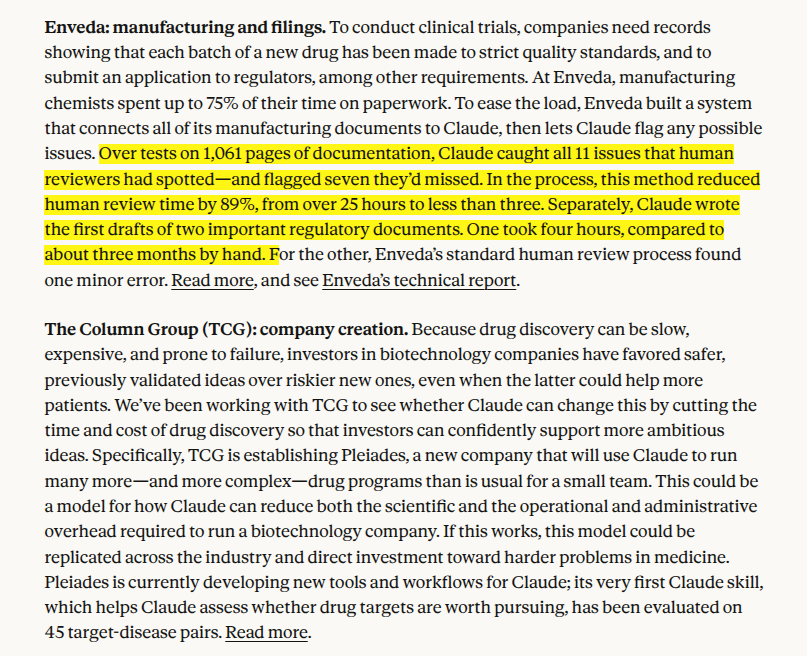
약이 환자에게 가기까지는 후보 물질을 찾는 일 외에도 제조 과정이 기준에 맞았는지 확인하는 문서 업무가 필요합니다. Enveda 사례는 AI가 의심되는 항목과 해당 페이지를 먼저 보여 주면 사람이 확인하는 시간을 줄일 수 있음을 보여 줍니다.
다만 한 임상 개발 과정의 제조 기록 4건을 평가한 결과이며, 최종 판단과 승인은 사람이 맡았습니다. 신약 개발 전체가 같은 비율로 빨라졌다는 뜻으로 확대할 수는 없습니다.
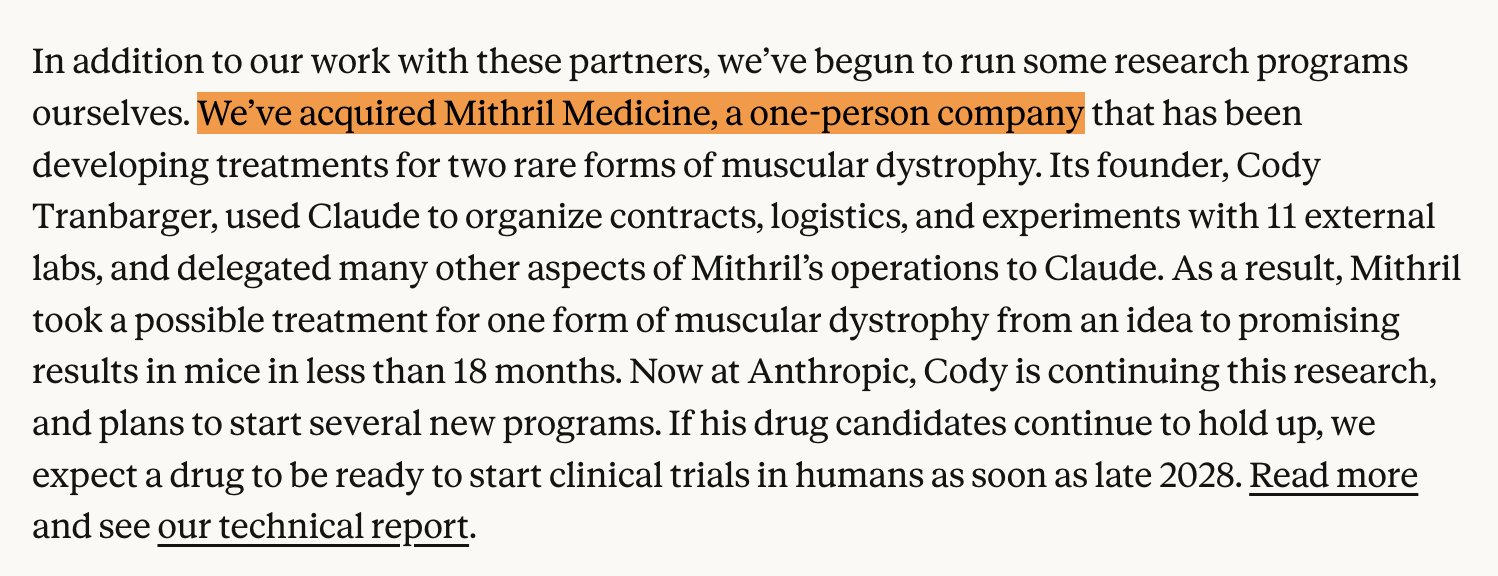
그 밖에: Anthropic은 1인 신약 개발사 Mithril Medicine을 인수했다고 밝혔습니다. 창업자는 Claude로 외부 연구소 11곳과의 계약·물류·실험을 조율했습니다.
관련 해설 「Roivant was ahead of its time」는 이 인수를 여러 연구 조직을 묶어 운영하는 사업 방식과 연결해 해석합니다. 이는 필자의 산업 전망이며 치료 효과를 검증한 결과는 아닙니다.
시사점: 연구팀은 후보 설계뿐 아니라 반복적인 서류 확인에도 AI를 활용할 수 있습니다. 다만 이번 발표의 연구는 대부분 사람 대상 시험 이전 단계이므로, 환자에게 효과가 입증된 치료제와 구분해야 합니다.
#Claude #신약개발 #연구업무
출처 7🔖 @Yuchenj_UW🔥 @rohanpaul_ai🔥 @wallstengine💬 @alexsarakiAnthropic 공식 발표Enveda 기술 보고서Generate 기술 보고서
4. DAYJOB: Tax, 세무 업무 50개 시험…Claude Sonnet 5.5도 통과율 10.8%
- AI 평가 업체 Surge AI가 10월 27일 DAYJOB: Tax(고객 자료를 조사해 세무 결과물까지 완성하는 시험)를 공개했습니다. 업무 50개로 구성했습니다.
- 최고 통과율은 Claude Sonnet 5.5의 10.8%입니다. 각 시도에서 평가 항목 95% 이상을 충족해야 통과합니다.
- 계산·근거 자료·중요 쟁점·최종 결과물을 함께 평가합니다. 고객이 말하지 않은 문제까지 찾아내는지 봅니다.
주택 매각 시점을 비교하는 과제에서 GPT-6 Astra는 제시된 두 날짜가 세금 혜택에 필요한 거주 요건을 충족한다고 올바르게 답했습니다. 하지만 매각이 미뤄지면 혜택을 잃을 수 있는 기한은 놓쳤습니다. 같은 사례에서 Claude Opus 5.5는 이 기한을 짚었습니다.
고객은 무엇을 물어야 할지조차 모를 수 있습니다. 따라서 세무 업무를 맡기려면 질문에 답하는 능력과 함께 묻지 않은 위험 찾기도 필요하다는 점을 보여 줍니다.
그 밖에: 통과율은 Claude Fable 5.1이 9.6%, Claude Opus 5.5가 9.2%, GPT-6 Astra가 4.8%입니다. Surge AI가 설계한 시험에서 측정한 값이며, 한국 세무 업무의 성공률로 일반화할 수는 없습니다.
시사점: AI에 업무를 맡길 때는 답변의 문장과 계산뿐 아니라 빠진 자료·기한·확인되지 않은 전제까지 사람이 검토할 필요가 있습니다. 이번 결과는 세무 업무를 끝까지 위임할 때 확인해야 할 한계를 구체적으로 보여 줍니다.
#DAYJOB #세무AI #업무위임
출처 2Surge AI 공식 발표DAYJOB: Tax 평가표
5. Claude, 미국 연방·지방정부에 40% 할인…최소 지출 약정 없이 제공
- Anthropic이 10월 27일 GSA(미국 연방정부의 조달 기관)와 협약을 확대해 Claude를 40% 할인한다고 발표했습니다.
- 대상은 기업용 Claude Enterprise·공공기관용 Claude for Government와 Claude API(다른 프로그램에서 Claude를 호출하는 연결 방식)입니다.
- 연방정부에 더해 주·지방·부족·준주 정부로 할인 대상을 넓혔습니다. 최소 지출 약정 없이 실제 사용량에 따라 지불할 수 있습니다.
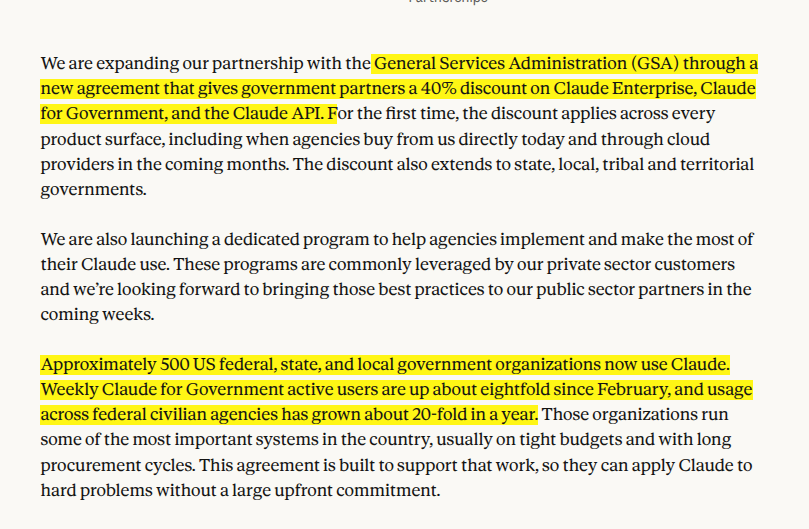
발표 시점부터 Anthropic 직접 구매에 할인이 적용되며, 클라우드 사업자를 통한 구매에는 수개월 내 확대할 예정입니다. 예산이 한정되고 조달 절차가 긴 공공기관에서 큰 금액을 미리 약속하지 않고 AI를 도입할 수 있도록 한 조건입니다.
그 밖에: Anthropic은 유타주 10개 기관 개발자 34명이 Claude Code를 쓴 4주 시범 운영 결과도 소개했습니다. 참가자의 71%가 20시간 이상을 아꼈다고 답한 자기 보고 수치입니다.
시사점: 미국 공공기관이 작은 업무부터 비용과 효과를 확인하며 Claude 도입을 시험할 여지가 커졌습니다. 시범 운영의 시간 절약 수치를 다른 기관의 예상 성과로 그대로 적용하기는 어렵습니다.
#Claude #공공기관AI #정부조달
출처 3💬 @rohanpaul_ai💬 @bchernyAnthropic 공식 발표
6. 🆕 그 밖의 신기능·신제품 — Exa 팟캐스트 검색·Claude Duet 초대 확대
- Exa: 회사에 따르면 팟캐스트 에피소드 300만 개 이상을 대상으로 대본 속 발언 검색을 제공하며, 자료를 매일 갱신합니다.
- Claude Duet: 일을 맡기고 필요한 일을 먼저 알려 주는 AI 비서 앱으로, 대기 명단을 거치는 시험 공개 단계입니다. 제품 책임자 카란 아후자는 10월 28일 미국 Max 구독자를 먼저 초대하고, 이어 미국 Pro 구독자를 초대할 예정이라고 밝혔습니다.
- 미국 외 이용자: 해당 안내에서는 접근 확대를 준비 중이라고 밝혔지만, 제공 날짜는 제시하지 않았습니다.
긴 인터뷰에서도 주제와 출연자를 함께 검색해 필요한 대목부터 확인하는 데 쓸 수 있습니다. Exa의 공식 안내에 따르면 전체 대본에 화자 이름과 발언 시각이 붙습니다. 기업이나 인물이 팟캐스트에서 어떻게 거론되는지 살피는 조사에도 활용할 수 있습니다.
그 밖에: OpenAI의 Tibo는 사용량 초기화(리셋)를 안내했습니다. 해당 게시물만으로 적용 대상·기간이나 전체 반영 완료 여부까지 확인할 수는 없습니다.
짧게 읽을 관련 글도 있습니다. MiniMax의 「Product Diary: Building Pro-Grade Mini Apps on an Agent OS」는 AI 작업 환경 안에 전문 업무용 앱을 두려는 제품 구상을 설명합니다. 「Swarms: a thousand agents working as a team」는 여러 AI가 일을 나눠 처리하는 도구에 관한 제작자의 설명입니다. 두 글은 제품 설계 관점이며 새 모델의 능력을 입증한 독립 평가와는 구분해야 합니다.
시사점: 팟캐스트 조사에서는 검색된 발언의 앞뒤 맥락을 확인하고, Claude Duet은 거주 지역과 대기 명단·초대 여부를 먼저 확인할 만합니다.
#Exa #ClaudeDuet #사용량리셋
출처 7🔥 @ExaAILabs💬 @ahuja_karan💬 @thsottiaux💬 @MiniMax_Code🚀 @MiguelriosENExa 공식 안내Claude Duet 공식 안내
오늘의 감정·온도
오늘의 실무 팁 — 쉽게 풀어 쓴 사용법 6가지
1. 모델을 고를 때 내 업무와 닮은 시험부터 봅니다 종합점수는 여러 능력을 묶은 값입니다. 코딩 수정과 과학 연구처럼 맡길 일이 다르면 해당 작업의 결과와 비용을 따로 비교합니다.
2. 높은 점수를 봤다면 이용 자격도 확인합니다 Carbon처럼 일부 조직에 먼저 제공하는 모델이 있습니다. 도입 일정에는 일반 공개일이 확인됐는지, 현재 신청 가능한 경로가 있는지 함께 적습니다.
3. 문서 검토는 근거 페이지를 함께 받습니다 Enveda 사례처럼 AI가 의심되는 항목과 해당 페이지를 짚게 할 수 있습니다. 최종 검토자는 원문을 열어 판단하고 승인합니다.
4. 질문하지 않은 위험도 찾아 달라고 요청합니다 세무 시험에서는 제시된 날짜의 조건을 맞게 판단하고도 다른 기한을 놓쳤습니다. 빠진 자료·기한·전제를 따로 정리하게 한 뒤 사람이 확인하는 데 활용합니다.
5. 할인은 구매 경로까지 비교합니다 Claude의 미국 정부 할인은 직접 구매와 클라우드 경유 구매의 적용 시점이 다릅니다. 대상 기관인지와 실제 구매 경로에 할인이 적용되는지 확인합니다.
6. 검색된 발언은 앞뒤 맥락을 듣습니다 팟캐스트 대본 검색은 긴 인터뷰의 필요한 대목을 찾는 데 활용할 수 있습니다. 화자와 발언 시각을 확인하고, 인용 전에는 원본의 앞뒤 내용을 함께 살펴봅니다.
📦 확인 방식 평가 수치는 평가기관 자료에서, 기능·접근 조건과 연구 사례는 공식 발표·기술 보고서에서 가져왔습니다. 회사·개인이 제시한 사용 성과와 전망 중 독립적으로 재현되지 않은 내용은 외부 독립 검증 전입니다.
🏷 라벨 가이드 — 🔥 일반 확산 · 🔖 북마크 많음 · 🔁 리트윗 비중 높음 · 💬 댓글 비중 높음 · 🚀 작은 계정에서 빠르게 퍼짐