AI 브리핑 ·
Mistral, 모델 공개와 요금 인하
5분 브리핑
약 2분 · 7개 흐름무슨 일이 있었고 나에게 무슨 의미인지 먼저 보고, 궁금한 소식은 본문으로 이어 보세요.
전체 분석 9분으로 바로 가기 ↓- Mistral Large 4, 가중치 공개…코딩 성능 높이고 API 가격 절반으로
내게 의미개발팀에는 코딩 AI의 사용료를 줄이거나 자체 서버에서 운영할 선택지가 늘었습니다. 도입을 검토한다면 실제 쓰는 개발 도구에서 자기 코드로 품질과 비용을 비교해 볼 만합니다.
- Codex·Work, Pro 한도 확대…ChatGPT Pro·Business에 API 크레딧 제공
내게 의미한도에 자주 막혔다면 사용량 화면에서 반영된 한도를 확인할 만합니다. 앱을 시험하려는 Pro·Business 구독자는 결제 설정에서 API 혜택을 신청하고 만료일까지의 사용 계획을 세울 수 있습니다.
- Particle-1, DeepSeek 기반 코딩 모델 공개…출력량 줄여 비용 절감 제시
내게 의미개발 작업을 AI에 반복해서 맡기는 팀이라면 작업당 비용과 대기를 줄일 후보가 생겼습니다. 도입 전에는 같은 과제를 끝까지 해결하는지와 결과물의 품질을 함께 비교할 만합니다.
- Phonic 1, 독립 음성 종합평가 1위…고객응대 과제에서 앞서
내게 의미상담 AI를 고를 때는 목소리를 들어 보는 데 더해, 우리 회사의 예약 변경·환불 규정을 지키며 업무를 마치는지도 시험할 만합니다.
- NVIDIA Nemotron 3.5 Transcribe, 회의 받아쓰기·화자 구분을 한 모델로
내게 의미회의 기록을 만드는 팀은 대본·발언자 표시·번역을 함께 처리할 선택지가 생겼습니다. 녹음 파일 처리용이므로 실시간 자막과 구분하고, 중요한 이름·발언자·답변은 원음을 확인해야 합니다.
- Rime Prism, 말하기 전 답변을 확인할 수 있는 음성 모델 공개
내게 의미음성 AI를 도입할 기업은 답변 속도와 함께, 필수 안내가 빠지거나 잘못된 약속이 담겼을 때 발화 전에 수정할 수 있는지 시험해 볼 만합니다.
- 🆕 그 밖의 신기능·신제품 — Ideogram 부분 편집·Basecamp의 Claude 연결
Ideogram 4.5 Precise Edit: 사진 일부를 고치는 도구에 편집 범위 설정이 추가됐습니다. · 회사에 따르면 최대 2K(2048×2048픽셀 분량) 영역을 원래 해상도로 수정하고, 범위 밖은 원본 그대로 보존합니다. · fal: 고칠 곳을 표시해 편집 범위를 자동으로 잡거나, 직접 지정할 수 있습니다.
내게 의미상품 사진을 수정할 때는 고칠 범위를 작게 지정하고, 결과물의 글자·색과 전체 크기를 확인할 만합니다.
주요 키워드 TOP 5: Mistral Large 4 · Codex · Particle-1 · Phonic 1 · 회의 받아쓰기 | 메인 이벤트: Mistral이 코딩 성능을 높인 Large 4의 모델 파일을 공개하고 사용료를 낮췄습니다.
Mistral이 Large 4의 가중치(학습을 마친 모델 파일)를 공개하면서, 내부 코드를 외부 서비스에 보내기 어려운 개발팀에도 자체 서버에서 코딩 AI를 운영할 선택지가 늘었습니다. 사용료도 낮아졌지만 직접 운영하려면 서버 비용과 관리 부담까지 비교해야 합니다. 오늘 확인된 새 범용 최상위 모델 발표는 많지 않아, 사용 조건과 코딩 효율·음성 모델의 변화를 함께 살폈습니다.
위 시각은 한국 시간(KST)이며, 본문에서 인용한 게시물이 올라온 때를 기준으로 정리했습니다.
1. Mistral Large 4, 가중치 공개…코딩 성능 높이고 API 가격 절반으로
- Mistral이 Mistral Large 4 개선판의 가중치를 공개했습니다. 기업이 자체 서버에서 실행하고 필요에 맞게 조정할 수 있습니다.
- API 가격은 미리보기판보다 약 절반으로 인하했습니다. 100만 토큰(AI가 글을 처리하는 분량 단위)당 입력 0.70달러, 출력 2.10달러입니다.
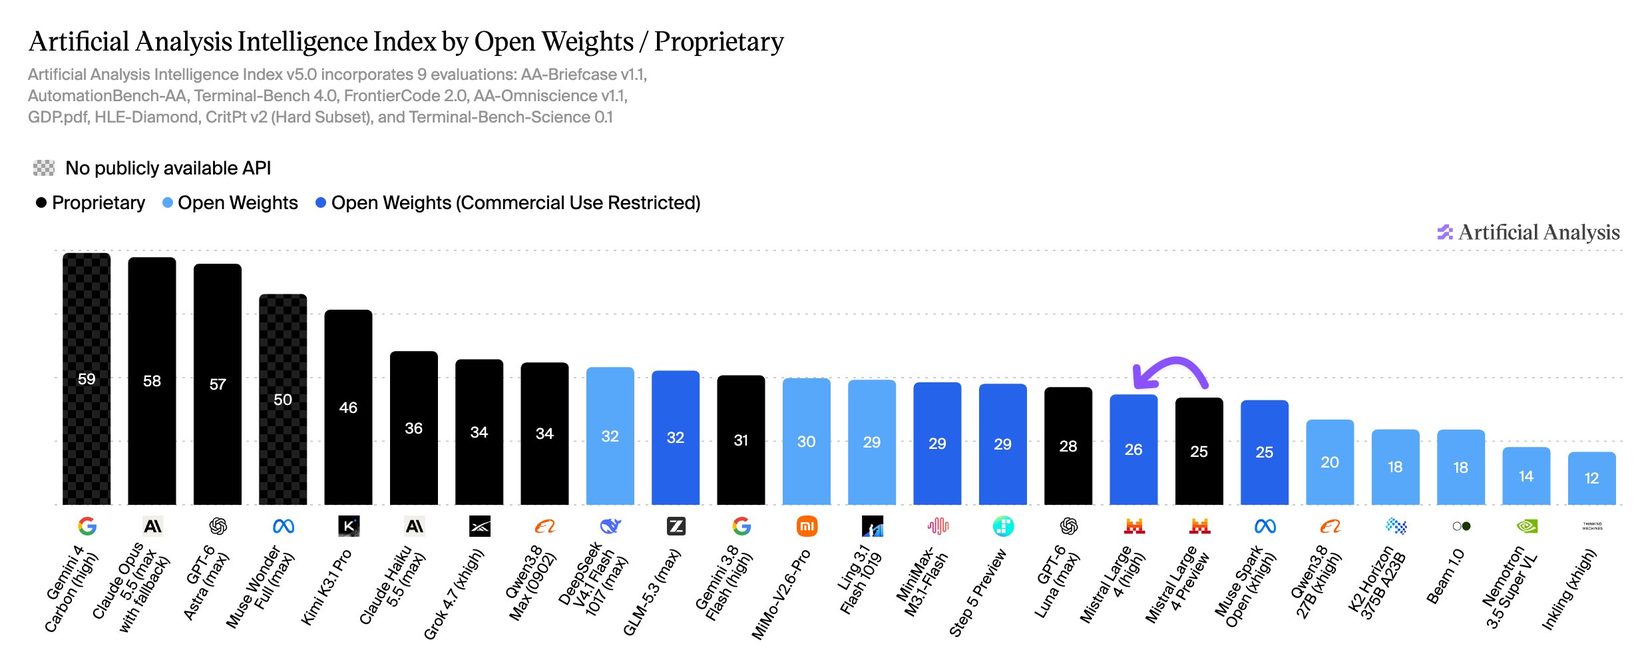
- 독립 평가기관 Artificial Analysis의 코딩 작업 종합지수에서 가중치 공개 모델 2위를 기록했습니다. Mistral Vibe(코드를 수정하고 시험하는 AI 개발 도구)와 함께 평가한 결과입니다. 답을 찾는 데 더 많은 노력을 쓰는 high 설정에서 48점입니다.
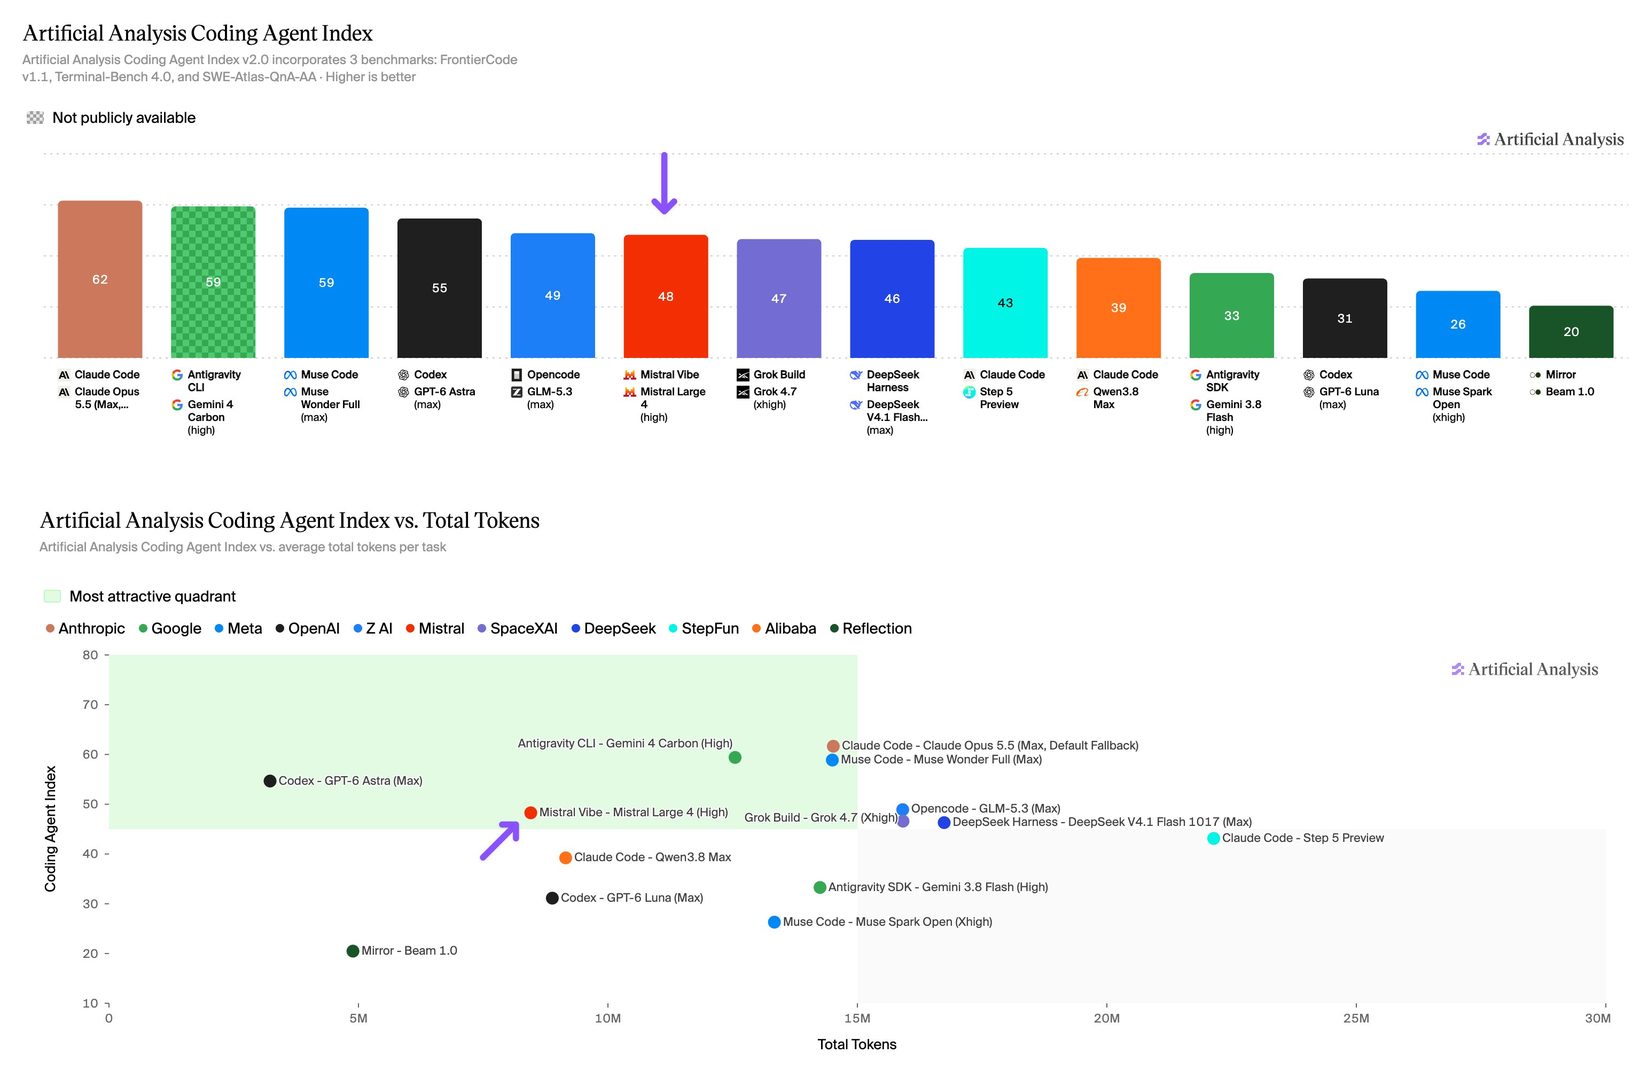
내부 코드를 외부 서비스에 보내기 어려운 조직에는 모델을 직접 운영할 수 있다는 점이 중요합니다. 다만 서버를 마련하고 관리하는 비용은 따로 계산해야 합니다.
이번 코딩 평가에서 Mistral Large 4와 Mistral Vibe 조합의 과제당 총 사용량은 평균 850만 토큰이었습니다. 49점을 받은 GLM-5.3과 OpenCode 조합의 평균 1,590만 토큰보다 적었습니다. 모델마다 함께 사용한 도구가 다르므로, 이 순위를 모든 코딩 환경의 성능 순서로 받아들이기는 어렵습니다.
그 밖에: 보안 취약점을 찾고 재현·수정하는 능력을 재는 Artificial Analysis Cyber Index에서는 51점으로 현재 가중치 공개 모델 중 3위였습니다. 이용 조건인 Mistral Ecosystem Open-Weight License는 사용·수정·상업화를 허용하지만, 모델을 서비스로 제공하는 사업에는 별도 상업 라이선스를 요구합니다.
시사점: 개발팀에는 코딩 AI의 사용료를 줄이거나 자체 서버에서 운영할 선택지가 늘었습니다. 도입을 검토한다면 실제 쓰는 개발 도구에서 자기 코드로 품질과 비용을 비교해 볼 만합니다.
#MistralLarge4 #가중치공개 #코딩AI
출처 5💬 @ArtificialAnlys🔥 @ArtificialAnlys🔥 @ArtificialAnlysMistral 공식 발표Artificial Analysis 독립 평가
2. Codex·Work, Pro 한도 확대…ChatGPT Pro·Business에 API 크레딧 제공
- OpenAI는 Codex(코딩 작업을 돕는 AI 도구)와 업무용 ChatGPT Work의 Pro 100·500 사용 한도를 이전의 두 배로 늘렸습니다. Pro 200은 예고한 한도 축소를 철회했습니다. 이미 높은 한도였던 이용자는 그대로 유지하고, 낮은 한도였던 이용자는 두 배로 늘어 같은 수준이 됩니다.
- 별도로 ChatGPT Pro·Business 구독자에게 API 사용료 크레딧을 제공합니다. Pro는 월 요금제 100·200·500달러에 맞춰 같은 금액의 크레딧을 받습니다.
- Business의 API 크레딧은 유료 Standard 좌석당 월 20달러, Premium 좌석당 월 100달러입니다. 업무공간 전체가 함께 쓰며 월 상한은 500달러입니다.
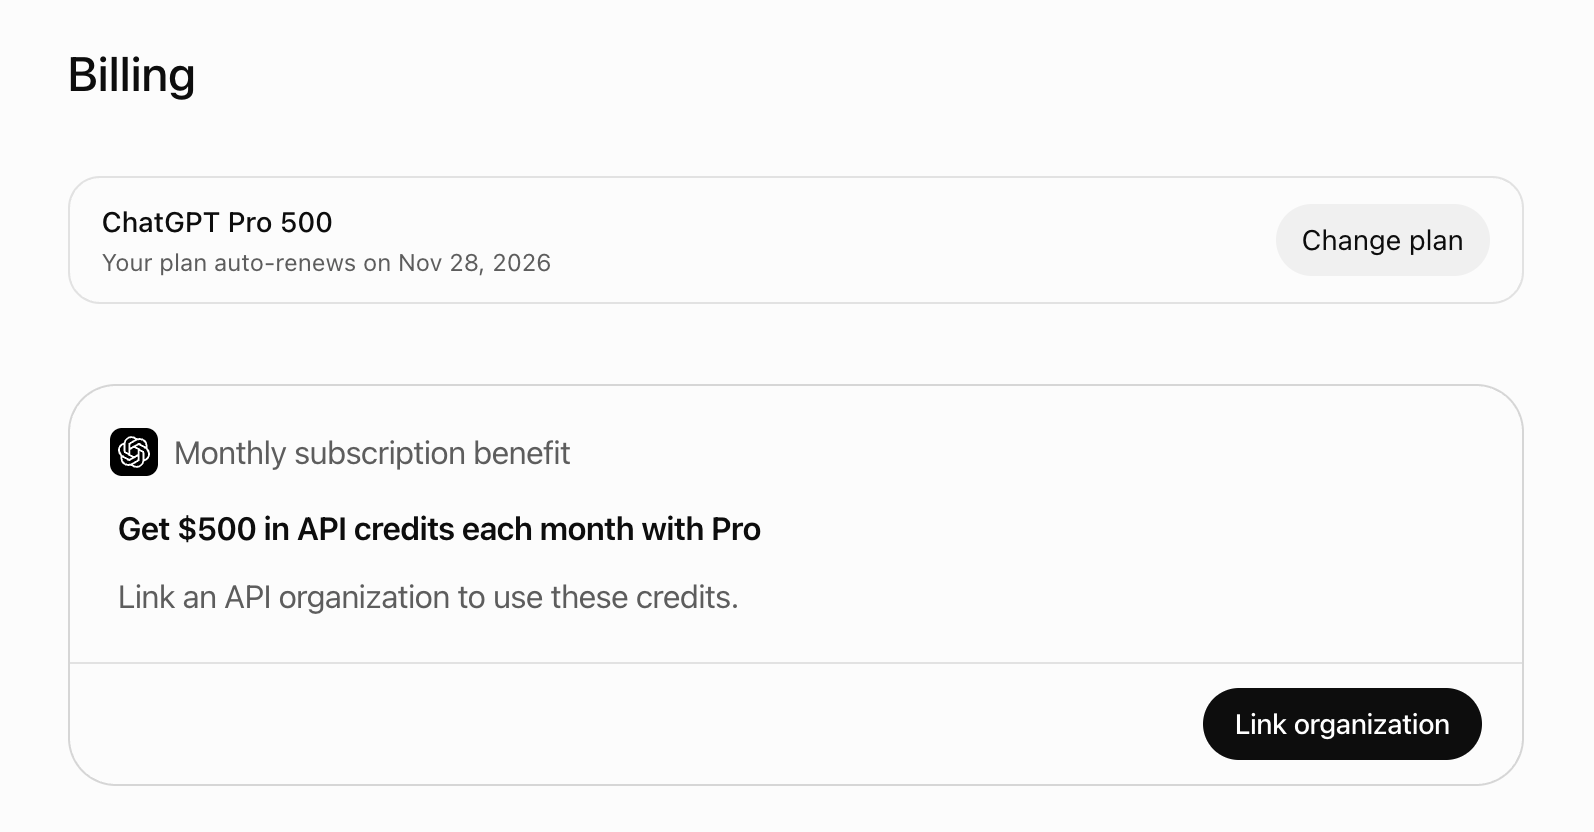
이 크레딧은 별도 앱이나 AI 에이전트(여러 단계를 거쳐 일을 수행하는 AI)를 시험할 때 API 사용료로 쓸 수 있습니다. 유료 구독을 시작한 지 7일 이상이어야 하며 무료 체험·무상 구독은 제외됩니다. 구독 또는 Business 업무공간과 크레딧을 받을 API 이용 조직 양쪽의 소유자여야 하고, 연결에 쓰는 두 계정의 이메일도 같아야 합니다.
ChatGPT의 결제 설정이나 API 플랫폼에서 조직을 연결하고 직접 신청해 활성화해야 합니다. 이후 자격과 혜택이 유지되는 동안 구독 갱신 때 자동 지급됩니다.
첫 지급액은 남은 결제 기간에 비례합니다. 미사용분은 해당 결제 주기 끝에 만료돼 이월되지 않습니다. Business 연간 선결제는 1년치를 한꺼번에 받고 연간 결제 주기 끝에 만료됩니다.
그 밖에: 담당자 공지는 Business Premium의 사용 한도도 두 배로 늘린다고 안내했습니다. API 크레딧은 ChatGPT·로그인한 Codex의 한도를 늘리지 않으며, API 키로 이용하는 Codex에도 쓸 수 없습니다.
시사점: 한도에 자주 막혔다면 사용량 화면에서 반영된 한도를 확인할 만합니다. 앱을 시험하려는 Pro·Business 구독자는 결제 설정에서 API 혜택을 신청하고 만료일까지의 사용 계획을 세울 수 있습니다.
#Codex #ChatGPT #API크레딧
출처 6💬 @ajambrosino💬 @ChatGPT💬 @alexmichaelAPI 혜택 공식 문서요금·공유 한도Pro 한도 변경
3. Particle-1, DeepSeek 기반 코딩 모델 공개…출력량 줄여 비용 절감 제시
- Particle이 DeepSeek V4.1 Flash를 추가 학습한 코딩 모델 Particle-1을 공개했습니다.
- 코딩·데이터 작업을 평가한 회사 자체 시험에서 출력 토큰 절감은 회사가 비교한 DeepSeek V4.1 Flash 대비 28.4~52.2%였습니다. 한 번 시도해 과제를 해결한 비율도 비교 모델의 통계적 오차 범위 안이었다고 설명합니다.
- 여러 모델을 연결해 쓰는 Vercel AI Gateway에서도 제공을 시작했습니다. 오류 수정과 코드 변경 계획 등에 사용할 수 있습니다.
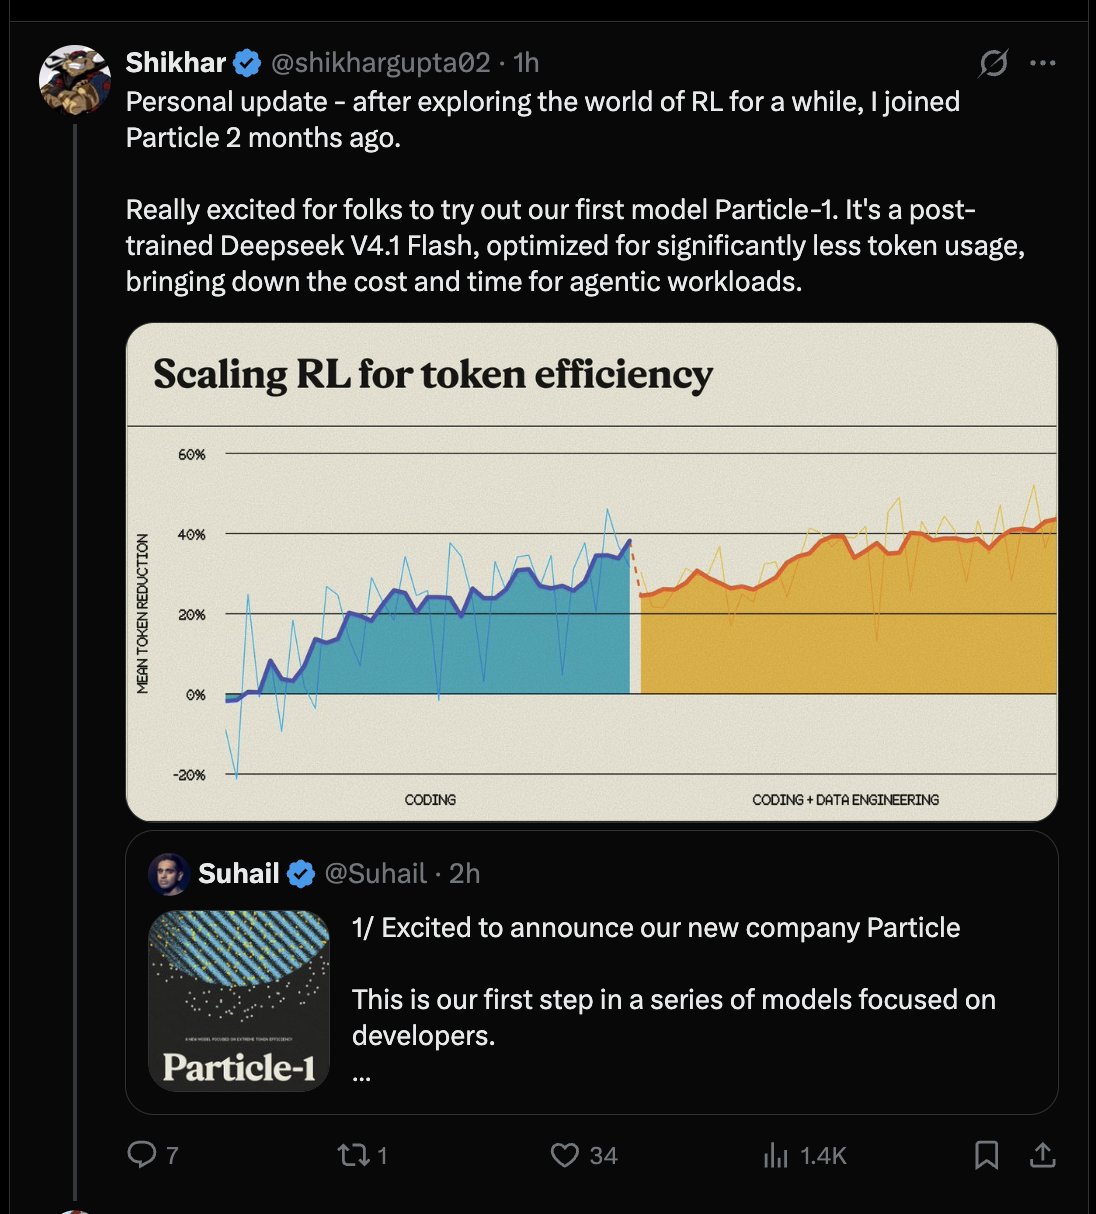
AI에 개발 작업을 맡기면 최종 답변뿐 아니라 해결 방법을 검토하고 수정·확인을 반복하는 과정에서도 사용량이 쌓입니다. Particle은 불필요한 재검토와 시행착오를 줄였다고 설명합니다.
회사가 보고한 과제당 평균 비용 절감은 34.4~51.6%입니다. 다만 이전 입력을 재사용해 할인받는 비율을 95%로 고정한 자체 시험 결과여서, 실제 청구액도 같은 비율로 줄어든다고 단정할 수는 없습니다. 비교 모델의 세부 버전은 확인하지 못했습니다.
그 밖에: Merge도 자사 모델 연결 서비스 Merge Gateway에서 Particle-1을 제공한다고 알렸습니다.
시사점: 개발 작업을 AI에 반복해서 맡기는 팀이라면 작업당 비용과 대기를 줄일 후보가 생겼습니다. 도입 전에는 같은 과제를 끝까지 해결하는지와 결과물의 품질을 함께 비교할 만합니다.
#Particle1 #코딩AI #AI비용
출처 5🔥 @vercel_dev🔥 @merge_api🔥 @teortaxesTexParticle 공식 발표Vercel 제공 개시
4. Phonic 1, 독립 음성 종합평가 1위…고객응대 과제에서 앞서
- Artificial Analysis가 한국 시간 10월 30일 공개한 평가에서 Phonic 1 (High)이 음성 종합지수 87.1점으로 1위에 올랐습니다. 고지능 설정으로 시험한 결과이며, Grok Voice 3.0의 86.9점과는 근소한 차이입니다.
- Tau Voice(규정을 지키며 고객 문제를 끝까지 해결하는 모의 음성상담 시험)에서는 모의 고객응대 해결률 79.9%로 선두입니다. 다음 모델보다 5.4%포인트 높았습니다.
- 모델명을 가리고 사람이 직접 대화한 뒤 고르는 선호도 평가에서는 30개 모델 중 8위였습니다. 종합 1위가 모든 항목의 1위를 뜻하지는 않습니다.
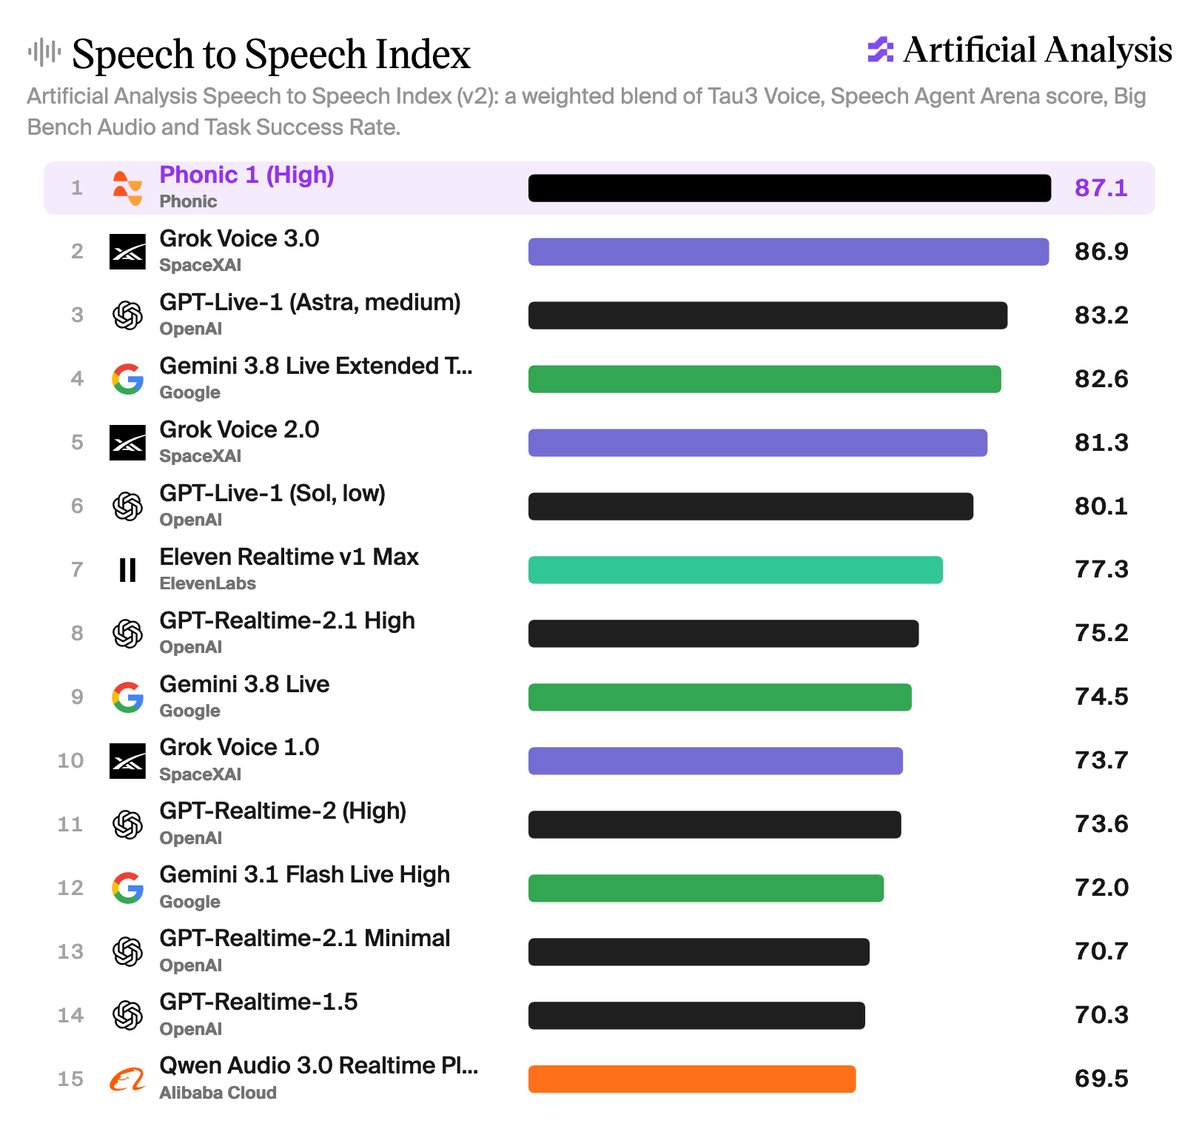
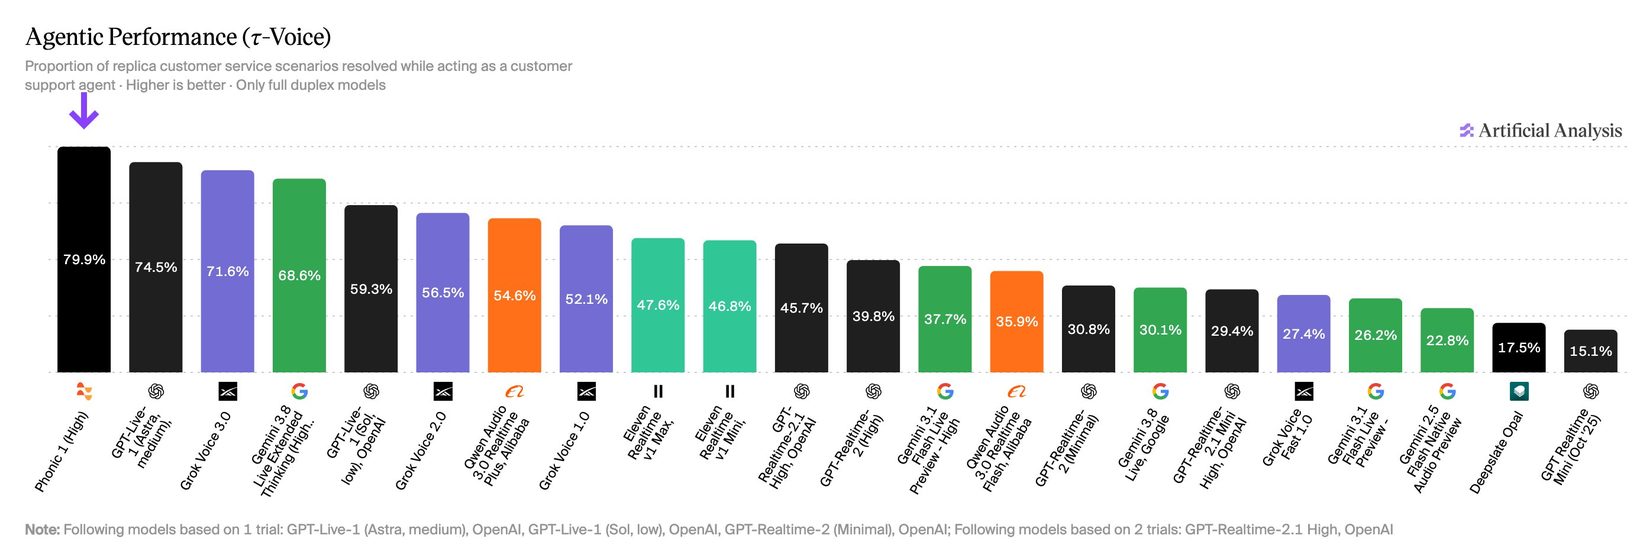
종합지수는 음성으로 들은 문제를 푸는 능력·모의 고객응대·사람의 선호·대화 과제 성공률을 같은 비중으로 합칩니다. Tau Voice는 항공권 변경이나 반품처럼 여러 단계를 거치는 업무에서 회사 규정과 도구를 제공하고, 마지막 업무 기록이 정답과 맞는지 확인합니다.
이번 결과는 대화 선호와 업무 완수를 함께 살펴볼 이유를 보여 줍니다. 다만 실제 고객센터의 처리율이나 한국어 상담 성적으로 옮겨 읽을 수는 없습니다.
그 밖에: 음성 AI를 만드는 도구 LiveKit Agents에서도 Phonic 1을 연결해 사용할 수 있다고 LiveKit이 안내했습니다.
시사점: 상담 AI를 고를 때는 목소리를 들어 보는 데 더해, 우리 회사의 예약 변경·환불 규정을 지키며 업무를 마치는지도 시험할 만합니다.
#Phonic1 #음성AI #고객응대
출처 7💬 @ArtificialAnlys💬 @ArtificialAnlys🔥 @ArtificialAnlys🔥 @livekit평가표평가 방식LiveKit 문서
5. NVIDIA Nemotron 3.5 Transcribe, 회의 받아쓰기·화자 구분을 한 모델로
- NVIDIA가 Nemotron 3.5 Transcribe의 가중치를 공개했습니다. 받아쓰기와 화자 구분, 번역, 녹음 내용에 대한 질문을 한 모델에서 처리합니다.
- 받아쓰기는 40개 언어, 영어와의 양방향 번역은 31개 언어를 지원합니다. 누가 말했는지 표시하는 기능은 한국어를 포함한 13개 언어에서 제공합니다.
- 최대 1시간 녹음에서 발언자 8명까지 구분합니다. 사람 이름이나 전문용어를 미리 알려 줘 받아쓰기의 참고 정보로 쓸 수도 있습니다.
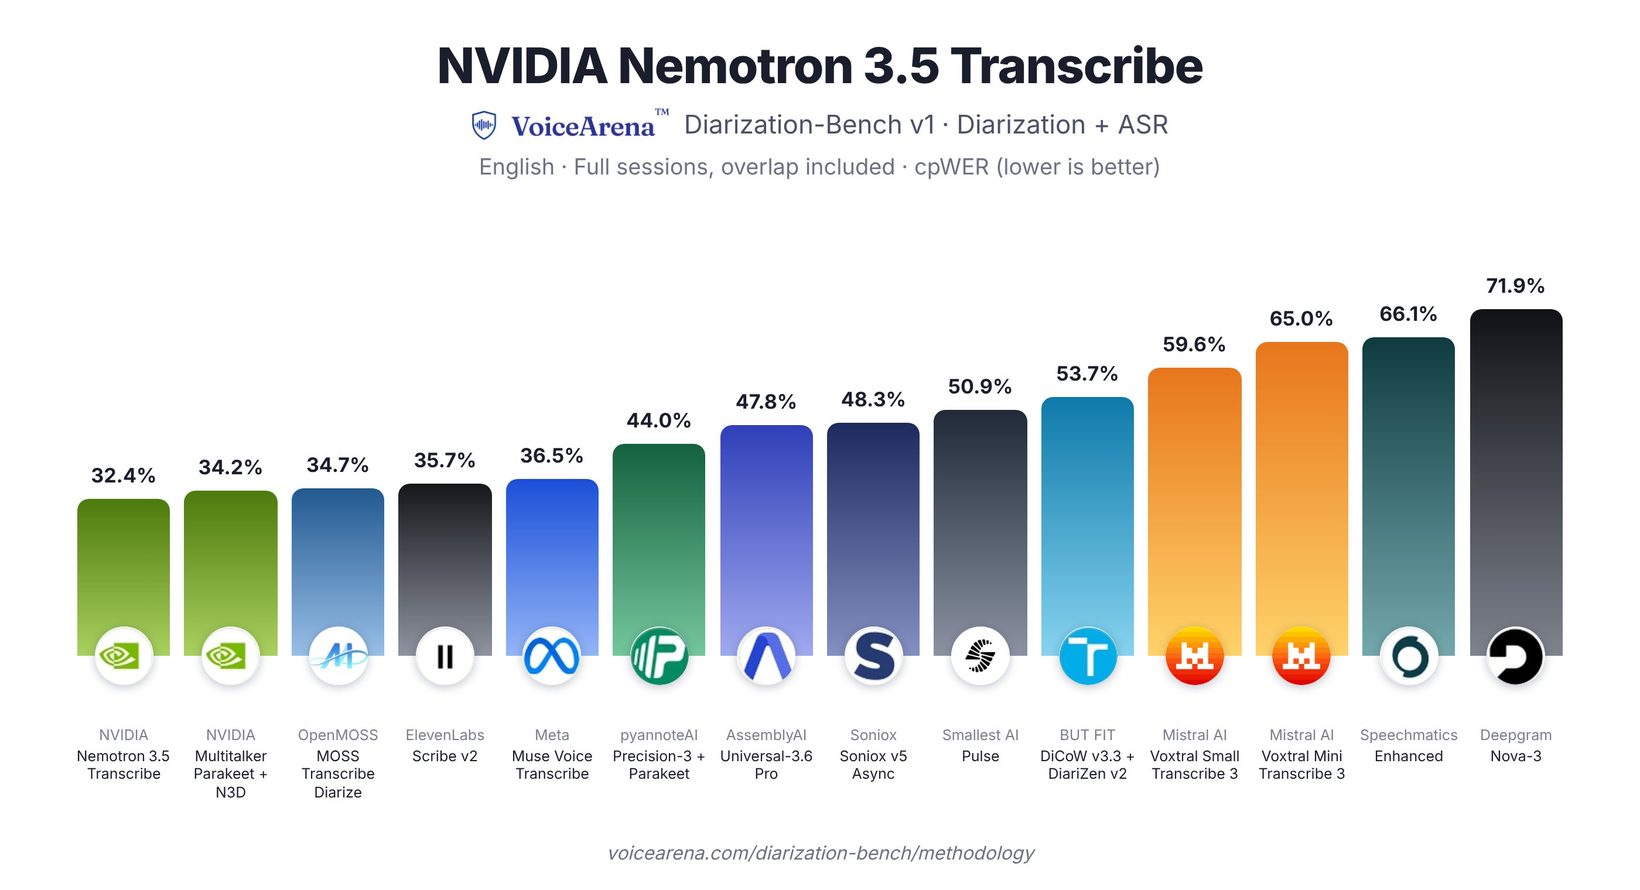
회의 대본을 읽을 때는 발언 내용만큼 누가 그 말을 했는지도 중요합니다. 이 모델은 같은 녹음에 지시를 바꿔 발언자 표시가 붙은 대본이나 번역문을 만들고, 회의에서 결정한 내용을 물을 수 있게 합니다. 다만 발언자 표시는 녹음 안의 목소리를 구분하는 기능이며 실제 인물의 신원을 알아내는 것은 아닙니다.
차트는 NVIDIA가 소개한 VoiceArena 평가 수치이며, 이 리포트가 평가를 재현하거나 실시간 순위를 확인한 결과는 아닙니다. 영어 회의에서 받아쓰기와 발언자 배정을 함께 채점하므로 한국어 성능이나 단순 받아쓰기 정확도로 확대할 수는 없습니다.
그 밖에: 녹음 내용 질문 기능은 영어로 학습됐습니다. Mac용 앱 Nativ도 이 모델을 기기 안에서 실행하는 지원을 발표했지만, 앱 제작자의 설명이며 이 리포트에서 재현한 결과는 아닙니다.
시사점: 회의 기록을 만드는 팀은 대본·발언자 표시·번역을 함께 처리할 선택지가 생겼습니다. 녹음 파일 처리용이므로 실시간 자막과 구분하고, 중요한 이름·발언자·답변은 원음을 확인해야 합니다.
#NVIDIA #음성인식 #회의기록
출처 5💬 @kimmonismus💬 @vishalsingh2972💬 @Nativ_AINVIDIA 공식 발표모델 설명서
6. Rime Prism, 말하기 전 답변을 확인할 수 있는 음성 모델 공개
- Rime이 음성을 듣고 음성으로 답하는 기업용 모델 Prism을 공개했습니다.
- 답변을 말하기 전 텍스트로 내보내, 기업의 프로그램이 내용을 점검하거나 문구를 수정할 수 있도록 했습니다.
- 회사 설명에 따르면 말투와 웃음 같은 음성 정보도 반영하며, 답하는 도중에도 이용자 말을 듣습니다.
예를 들어 고객센터에서 환불 조건을 안내한다면, 답변 문구를 회사 규정과 대조한 뒤 음성으로 내보내도록 구성할 수 있습니다. 통화가 끝난 뒤 기록을 살피는 절차에 더해 말하기 전 답변 점검을 넣는 셈입니다.
다만 실제로 잘못된 안내를 얼마나 줄일지는 기업이 어떤 규칙을 연결하고 시험하느냐에 달려 있습니다.
그 밖에: Rime은 베타 고객과 함께 각 기업의 통화 자료로 모델을 추가 학습시키는 도구를 개발 중이라고 밝혔습니다.
시사점: 음성 AI를 도입할 기업은 답변 속도와 함께, 필수 안내가 빠지거나 잘못된 약속이 담겼을 때 발화 전에 수정할 수 있는지 시험해 볼 만합니다.
#Rime #Prism #음성AI
출처 3🔁 @lilyjcliffordRime 공식 발표Prism 안내
7. 🆕 그 밖의 신기능·신제품 — Ideogram 부분 편집·Basecamp의 Claude 연결
- Ideogram 4.5 Precise Edit: 사진 일부를 고치는 도구에 편집 범위 설정이 추가됐습니다.
- 회사에 따르면 최대 2K(2048×2048픽셀 분량) 영역을 원래 해상도로 수정하고, 범위 밖은 원본 그대로 보존합니다.
- fal: 고칠 곳을 표시해 편집 범위를 자동으로 잡거나, 직접 지정할 수 있습니다.
상품 사진의 가방 색이나 라벨 글자만 바꾸려는 작업에 쓸 만합니다. 편집할 부분을 원래 크기로 처리하므로 사진 전체의 해상도를 유지할 수 있습니다.
다만 자동 범위 설정에서 수정 대상이 한도를 넘으면 전체 사진을 축소해 처리할 수 있어, 큰 영역을 고칠 때는 주의가 필요합니다.
그 밖에: Basecamp 공동 창업자 DHH는 Claude와 업무 관리 도구를 연결하는 Basecamp for Claude 공개를 알렸습니다.
보안 분야에서는 Johnny Wang이 알려진 소프트웨어 취약점을 재현하는 코드를 만들도록 학습한 Hinoki Offensive One을 공개하고 즉시 이용 가능하다고 알렸습니다. 성능과 구체적인 이용 조건은 독립적으로 확인하지 못했습니다.
시사점: 상품 사진을 수정할 때는 고칠 범위를 작게 지정하고, 결과물의 글자·색과 전체 크기를 확인할 만합니다.
#Ideogram #이미지편집 #Basecamp
출처 7💬 @ideogram_ai💬 @fal💬 @dhh🔖 @wang_johnnyIdeogram 공식 안내편집 조건Basecamp 공식 안내
오늘의 감정·온도
오늘의 실무 팁 — 쉽게 풀어 쓴 사용법 6가지
1. 자체 운영은 서버 비용까지 비교합니다 Mistral Large 4를 직접 운영하려면 사용료 외에 서버와 관리 비용도 듭니다. 지금 쓰는 코딩 도구에서 같은 작업을 시켜 품질과 총비용을 함께 확인합니다.
2. 구독 혜택은 신청 여부와 만료일을 봅니다 ChatGPT의 API 크레딧은 대상 구독자도 직접 신청해 활성화해야 합니다. 결제 주기가 끝나면 남은 금액이 사라지므로 사용할 앱과 기간부터 정합니다.
3. 비용 절감은 끝낸 작업을 기준으로 봅니다 Particle-1의 토큰 절감률은 회사가 정한 시험 조건에서 나온 값입니다. 같은 과제를 끝까지 해결했는지 확인하고 실제 청구액과 기다린 시간을 비교합니다.
4. 상담 AI에는 실제 업무 규정을 넣어 봅니다 Phonic의 모의 상담 결과와 Rime의 답변 점검 기능은 서로 다른 판단 근거입니다. 예약 변경·환불처럼 우리 회사 규정이 필요한 예시로 업무 완수와 잘못된 안내를 함께 살핍니다.
5. 회의 기록은 이름과 발언자를 원음으로 확인합니다 NVIDIA 모델의 발언자 표시는 녹음 속 목소리를 구분하는 기능입니다. 중요한 결정과 사람 이름은 원음을 듣고 고치며, 한국어 회의는 별도로 시험합니다.
6. 사진 편집은 고칠 범위를 작게 지정합니다 Ideogram의 부분 편집은 지정 범위 밖을 보존하도록 설계됐습니다. 결과를 받을 때 글자·색뿐 아니라 사진 전체 크기가 유지됐는지도 확인합니다.
📦 확인 방식 가격·이용 조건·기능은 공식 발표와 문서에서, 독립 평가 수치는 평가기관 자료에서 가져왔습니다. 회사·제작자의 자체 시험과 사용 성과 중 재현되지 않은 내용은 외부 독립 검증 전입니다.
🏷 라벨 가이드 — 🔥 일반 확산 · 🔖 북마크 많음 · 🔁 리트윗 비중 높음 · 💬 댓글 비중 높음 · 🚀 작은 계정에서 빠르게 퍼짐