AI 브리핑 ·
Muse·Meta AI, 기억과 작업 지속 개선
5분 브리핑
약 2분 · 6개 흐름무슨 일이 있었고 나에게 무슨 의미인지 먼저 보고, 궁금한 소식은 본문으로 이어 보세요.
전체 분석 8분으로 바로 가기 ↓- Muse·Meta AI, 중요한 기억을 덜 잊고 막힌 작업을 이어 가는 모델로 업데이트
내게 의미여러 차례 대화하며 일을 맡긴다면 앞서 정한 조건과 도중에 바꾼 요청이 유지되는지 확인할 만합니다. 완료했다는 답변과 실제 결과물도 대조해야 합니다.
- Inkling 2 Small, ARC-AGI-2 독립 평가 81.7%…가중치는 공개 예정
내게 의미웹 제작용 AI를 고를 때 비교할 후보가 늘었습니다. 직접 설치할 계획이라면 실제 가중치 공개 뒤 실행 요건과 이용 조건을 확인해야 합니다.
- Claude, 지난 기록으로 틀린 기억을 고치는 실험 공개
내게 의미AI에게 일을 이어 맡길 때는 기억의 근거를 보존하는 것이 도움이 될 수 있습니다. 게임 실험에서 확인한 효과가 실제 업무에서도 얼마나 이어질지는 별도 확인이 필요합니다.
- PSI, Anthropic 비공개 모델로 양자컴퓨터 난제 증명했다고 발표
내게 의미연구팀은 AI가 오래된 미해결 문제의 증명에 기여했다는 발표와 함께, 다른 연구자가 재검사할 자료를 공개했습니다. 성과를 평가할 때 사람이 맡은 역할과 공개된 증명 자료를 함께 살펴볼 수 있습니다.
- Arete-27B, Qwen3.8-27B의 정치적 답변 성향을 바꾼 공개 모델 출시
내게 의미공개 모델은 답변의 관점도 선택 대상이 될 수 있습니다. 정치·사회 문제에 활용한다면 평소 묻는 질문을 기존 모델과 나란히 시험하고, 답변 속 사실은 원자료와 대조할 만합니다.
- 🆕 그 밖의 신기능·신제품 — Antigravity 음성 대화·Higgsfield Miracle
Google의 AI 개발 도구 Antigravity에 Gemini Live(실시간 음성 대화 모델) 기반 음성 모드가 들어왔습니다. 말로 작업을 맡기고 답을 들을 수 있습니다. · 앱에서는 AI의 답변 도중 끼어들어 음성으로 방향 수정을 하거나 작업 중단을 요청할 수 있습니다.
내게 의미Antigravity 이용자는 작업 중 수정 지시를 말로 전달해 볼 수 있습니다. Miracle은 공개 후 원하는 부분만 바뀌는지와 처리 속도를 확인해야 합니다.
주요 키워드 TOP 5: Muse·Meta AI · Inkling 2 Small · Claude 기억 · AI 수학 연구 · Arete | 메인 이벤트: Meta가 기억과 작업 지속 능력을 개선한 모델을 Muse와 Meta AI에 배포하기 시작했습니다.
AI에 앞서 정한 조건을 다시 알려 주거나 중간에 멈춘 일을 사람이 이어받아야 하면, 일을 맡기는 편리함이 줄어듭니다. Meta는 이 부담을 줄이도록 기억과 작업 지속 능력을 훈련한 모델의 배포를 시작했습니다. 독자는 반복 설명이 줄고 맡긴 일이 실제로 끝나는지 살펴볼 만합니다. 오늘 확인된 새 대형 범용 모델 출시는 적습니다.
시각은 인용 게시물의 작성 시각을 한국 시각(KST)으로 바꾼 값이며, 실제 출시 시각을 뜻하지 않습니다.
1. Muse·Meta AI, 중요한 기억을 덜 잊고 막힌 작업을 이어 가는 모델로 업데이트
- Meta가 Muse Wonder로 훈련한 특화 모델을 Muse와 Meta AI에 배포하기 시작했습니다.
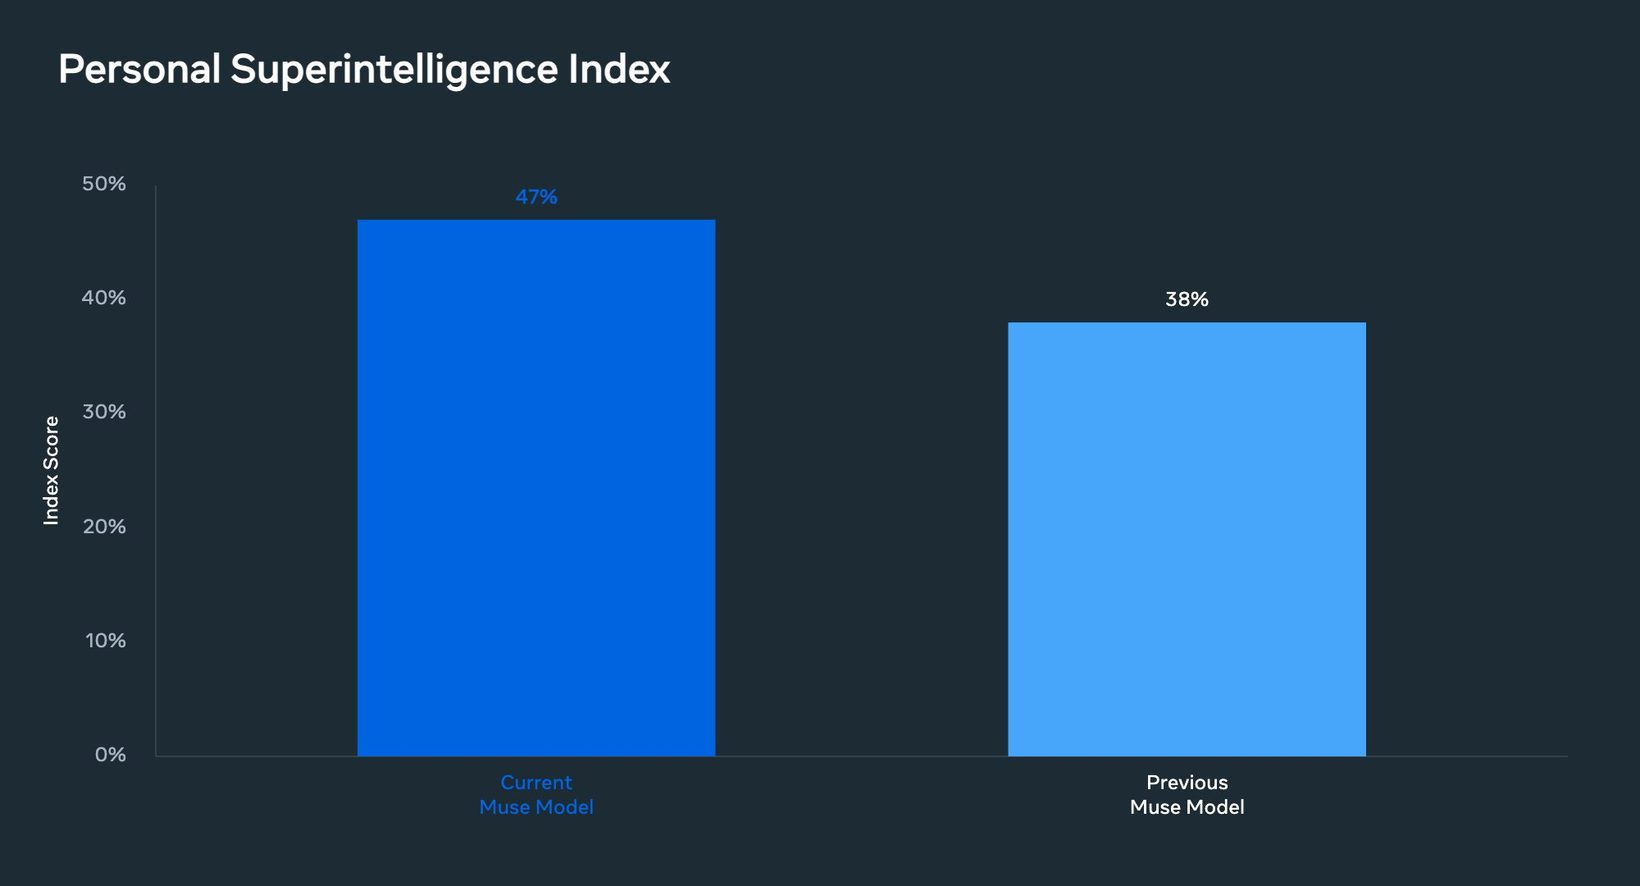
- Active Memory(중요한 정보를 기억하고 필요할 때 활용하는 능력)를 도입했습니다. Muse의 중요 정보 망각이 기존의 절반 이하로 줄었다는 회사 설명입니다(원문은 2.4배 감소).
- Active Focus(막혀도 대안을 찾아 작업을 이어 가는 능력)도 적용했습니다. Muse에서 예상치 못한 문제가 생기는 일상 과제의 완료 성과가 67% 개선됐다는 자체 평가입니다.
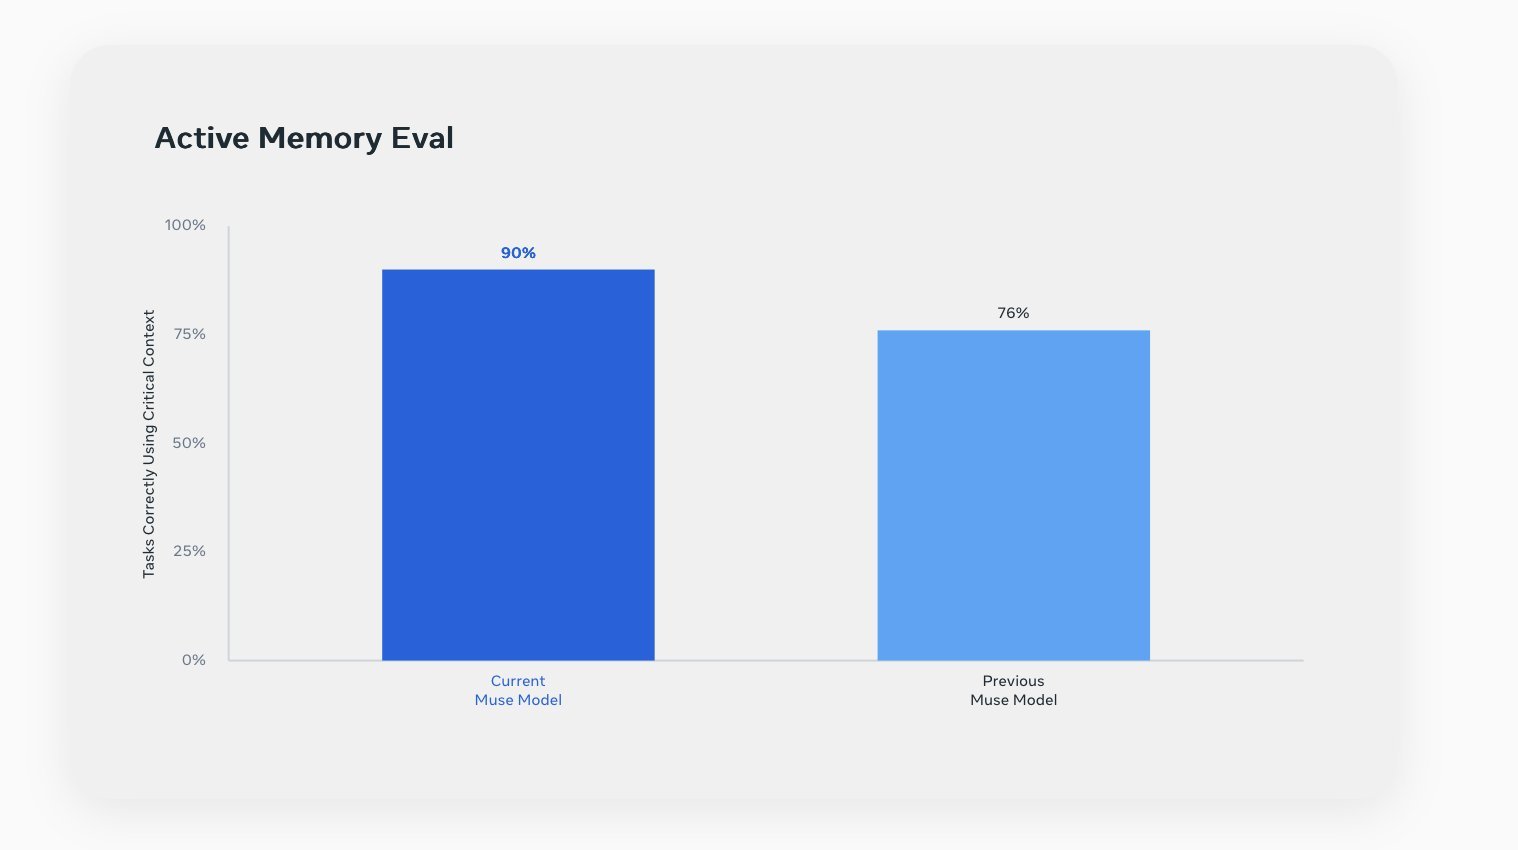
앞서 알려 준 조건을 AI에 다시 설명하거나, 막힌 작업을 사람이 이어받아야 한다면 편리함이 줄어듭니다. Meta는 잠깐 필요한 정보와 오래 유지할 정보를 구분하고, 시간이 지나도 유효한지 판단하도록 훈련했다고 설명합니다. 작업 중 지시 변경을 따라가고 장애가 생기면 재시도하거나 대안을 찾게 했습니다. 목표는 반복 설명을 줄이고 맡긴 일을 이어 가는 경험입니다.
다만 망각 감소와 완료 성과는 Muse의 회사 자체 평가입니다. Meta AI에서도 같은 개선 폭이 측정됐다는 뜻은 아닙니다.
그 밖에: Meta AI의 단계별 문제 풀이·추가 질문·대화 방향 전환 대응도 개선했다는 회사 설명입니다. 한국 제공 범위는 이번 발표에서 확인되지 않습니다.
시사점: 여러 차례 대화하며 일을 맡긴다면 앞서 정한 조건과 도중에 바꾼 요청이 유지되는지 확인할 만합니다. 완료했다는 답변과 실제 결과물도 대조해야 합니다.
#Muse #MetaAI #기억과작업지속
출처 4💬 @finkd💬 @alexandr_wang💬 @InomsxbtMeta 공식 발표
2. Inkling 2 Small, ARC-AGI-2 독립 평가 81.7%…가중치는 공개 예정
- Thinking Machines의 Inkling 2 Small이 ARC-AGI-2(예시 그림에서 규칙을 찾아 새 문제를 푸는 시험)에서 높은 추론 설정으로 정답률 81.7%를 기록했습니다. ARC Prize의 독립 평가 결과입니다.
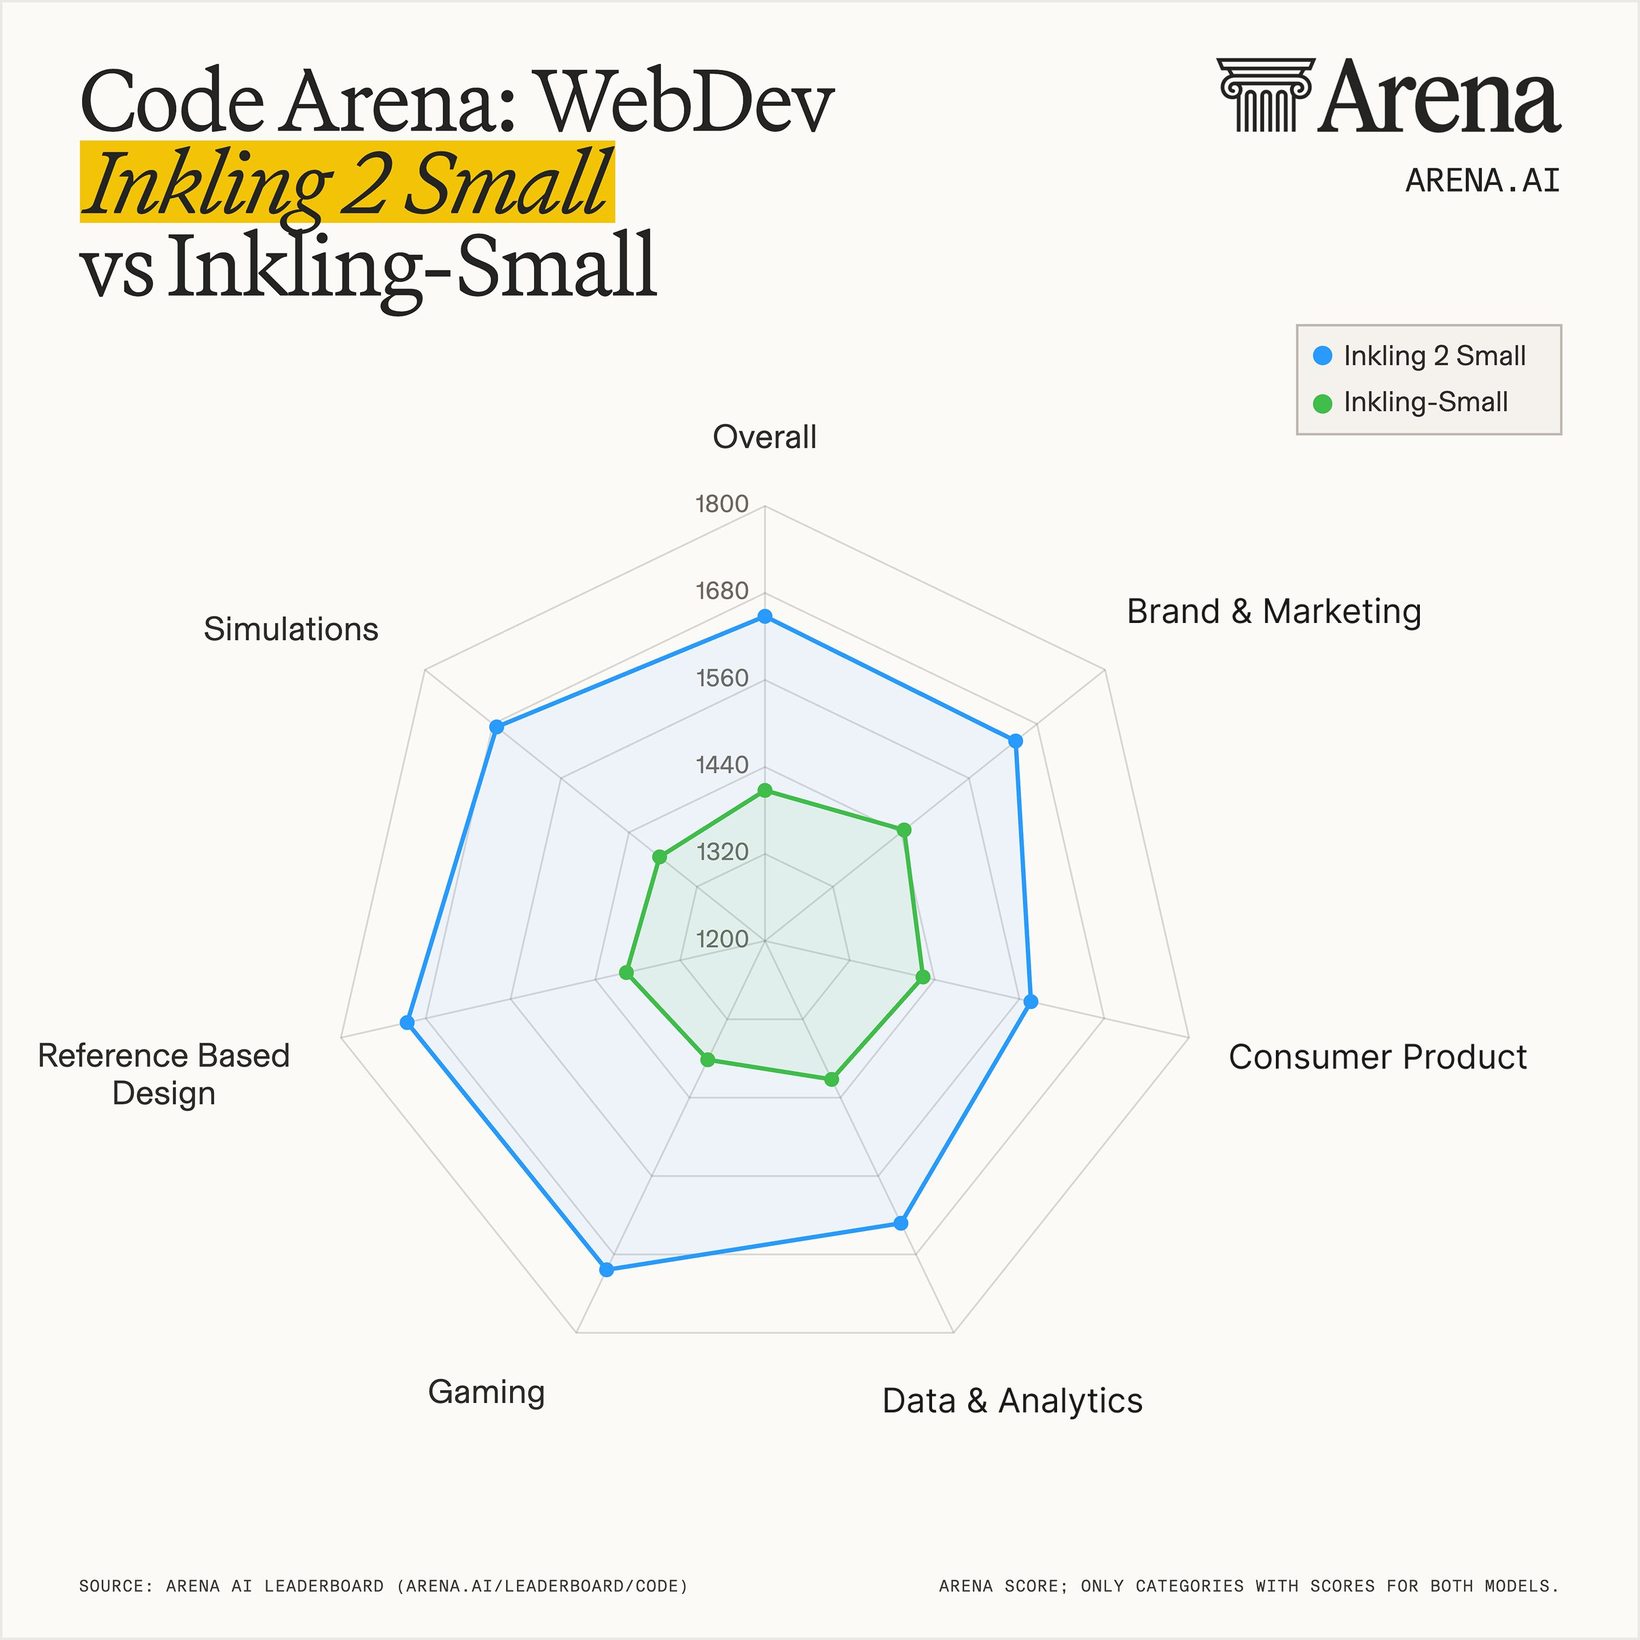
- Arena는 Code Arena: WebDev(웹 제작 결과를 비교하는 평가)에서 이전 Inkling-Small보다 전체 점수가 240점 올랐다고 발표했습니다.
- 지금은 Tinker(모델을 이용하거나 추가 학습시키는 서비스)에서 사용할 수 있으며, 모델을 직접 구동하는 데 필요한 가중치는 공개 예정입니다.
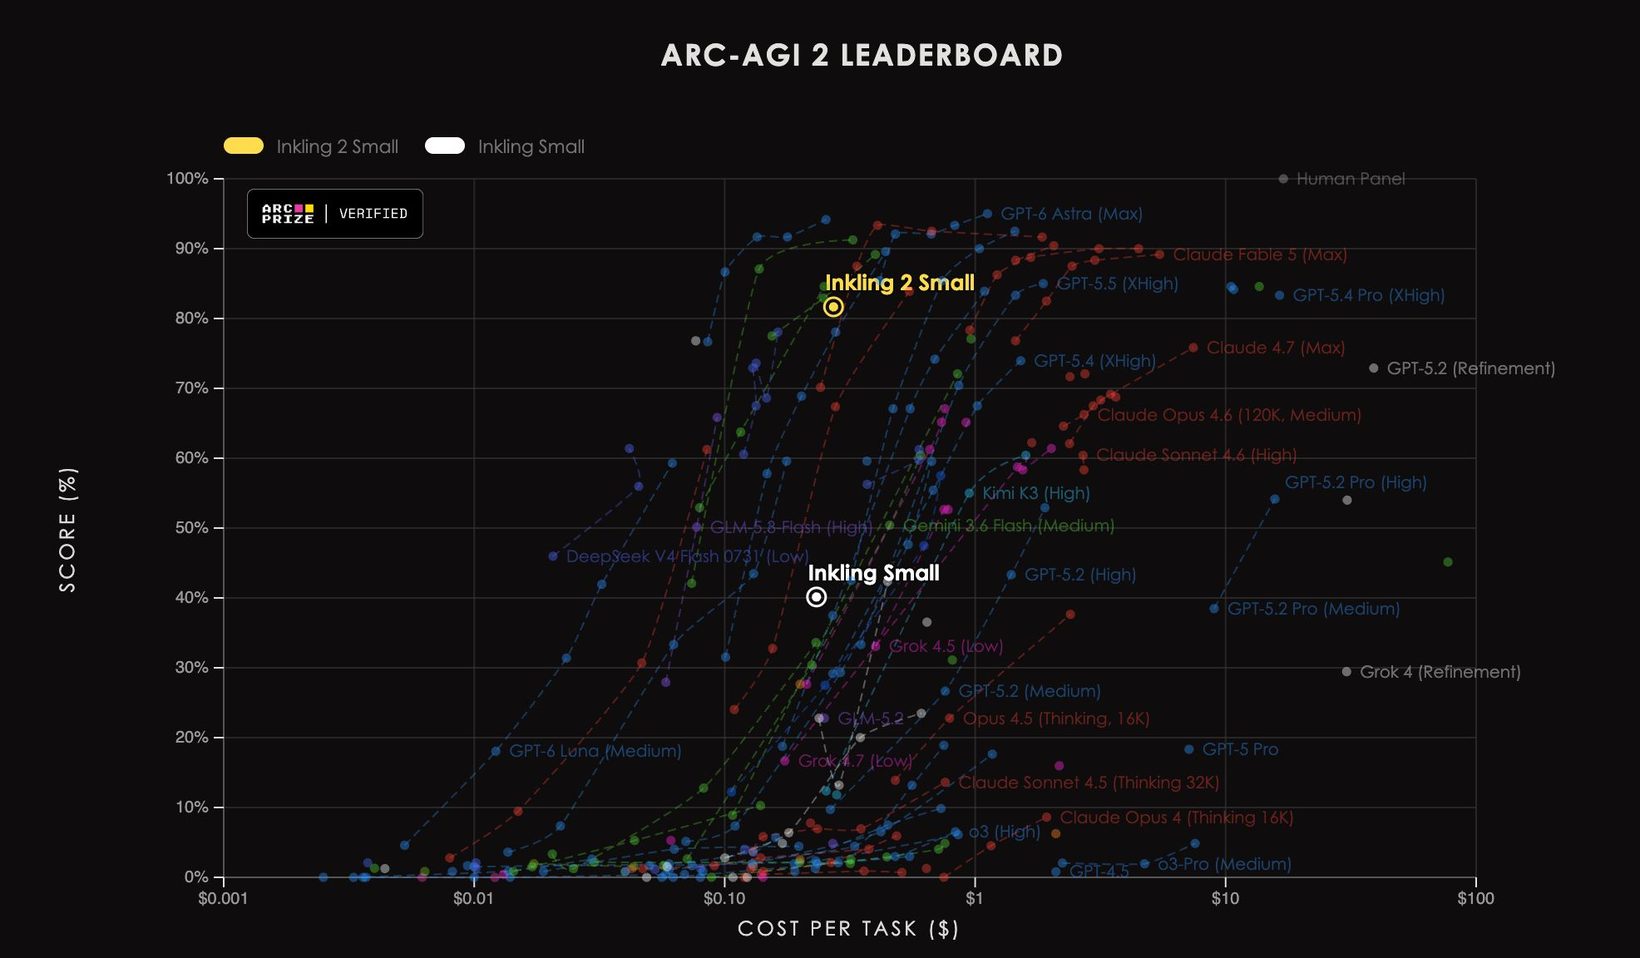
ARC Prize가 확인한 점수는 일반에 공개하지 않은 평가 문제군에서, 답을 내기 전 계산을 많이 쓰는 XHigh 설정으로 얻은 결과입니다. ARC Prize는 평가 당시 자신들이 시험한 가중치 공개 모델들의 점수를 넘었다고 밝혔습니다. ARC Prize가 발표한 문제당 평가 비용은 0.27달러로, 해당 시험 조건에서의 비용입니다.
Arena의 웹 제작 평가 개선도 함께 확인됐습니다. 그림 퍼즐과 웹 제작이라는 서로 다른 과제에서 새 모델의 변화가 드러났습니다. 다만 퍼즐 정답률이 일반 업무의 성공률을 뜻하지는 않습니다.
그 밖에: Soumith Chintala는 코딩 도구 OpenCode에서 Inkling 2 Small을 한시적으로 무료 제공한다고 알렸습니다. Thinking Machines는 11월 5일 발표에서 외부 안전성 시험을 마친 뒤 다음 주 가중치를 공개할 계획이라고 밝혔습니다.
시사점: 웹 제작용 AI를 고를 때 비교할 후보가 늘었습니다. 직접 설치할 계획이라면 실제 가중치 공개 뒤 실행 요건과 이용 조건을 확인해야 합니다.
#Inkling2Small #독립평가 #가중치공개
출처 5🔥 @arcprize💬 @arena🔥 @soumithchintalaARC Prize 평가Thinking Machines 발표
3. Claude, 지난 기록으로 틀린 기억을 고치는 실험 공개
- Anthropic은 Claude가 작업 사이에 지난 기록을 되짚는 ‘dreaming(기억 정리 작업)’ 실험 결과를 공개했습니다. 지난 기록으로 기억 교정이 가능하다는 설명입니다.
- 회사의 Pokémon Red 게임 실험에서 틀린 위치 메모를 고친 경우에는 다음 도시에 도착했습니다. 고치지 않은 경우에는 길을 되돌아가며 목적지에 이르지 못했습니다.
- Claude 모델인 Opus 5.5와 Fable 5는 현재 목표와 다음 행동에 필요한 기억을 골라 남겼습니다. 이 가운데 Opus 5.5는 메모를 갱신하며 게임을 끝냈습니다.
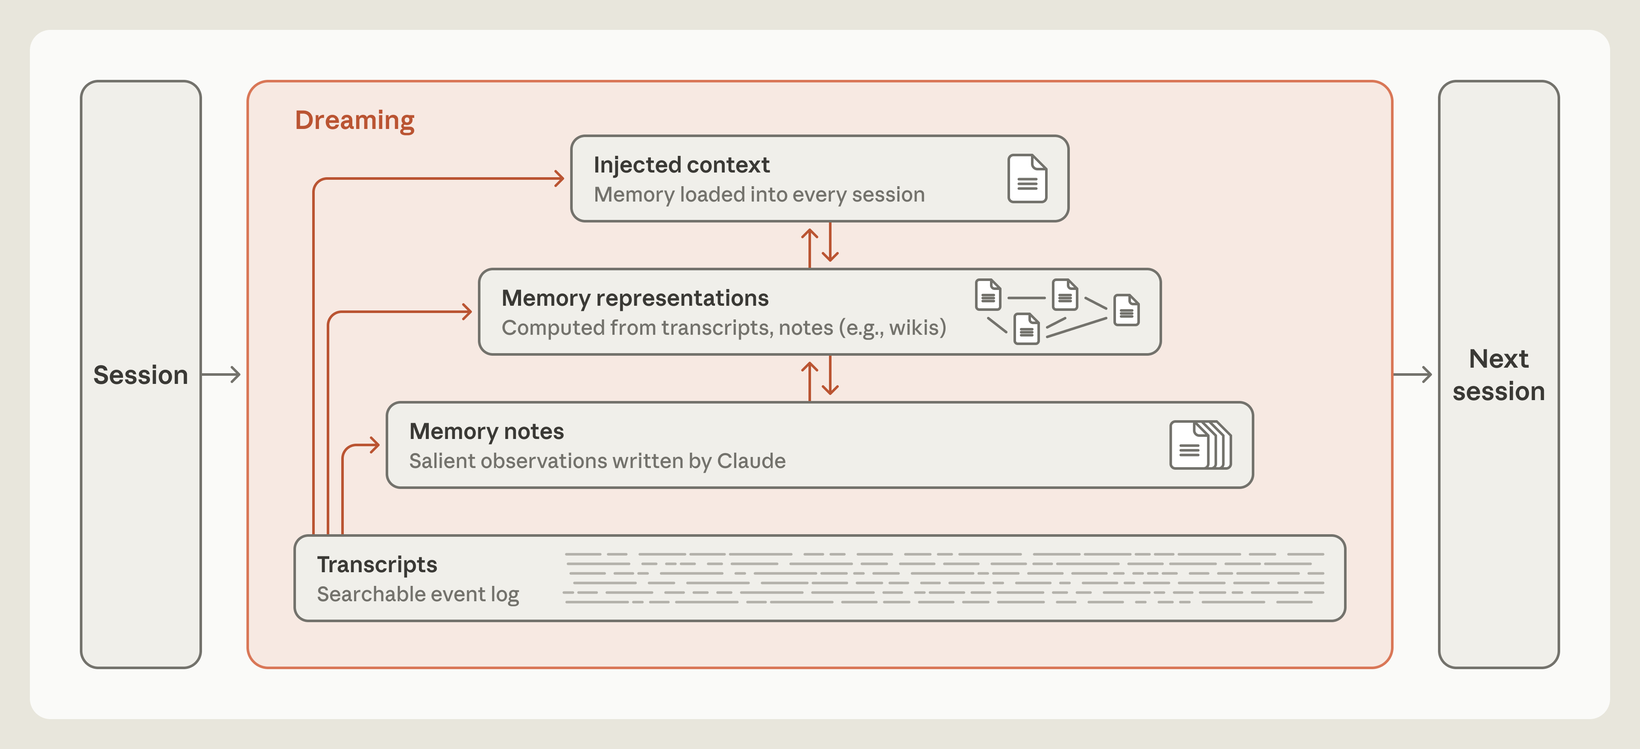
게임 속 Claude는 동굴 입구의 회복 시설을 반대편에 있다고 잘못 기억했습니다. 그래서 동굴을 통과했다고 판단하고 움직이다가 이전 길로 떨어졌습니다. 연구진이 지난 작업 기록과 메모를 대조하게 하자 Claude가 오류를 찾아 고쳤고, 동굴로 돌아가 진행을 이어 갔습니다.
AI가 틀린 메모를 다음 작업에서도 믿으면 같은 실패를 반복할 수 있음을 보여 준 사례입니다.
그 밖에: 이번 글은 회사의 실험 결과를 소개하며, 일반 Claude 앱의 새 기능 배포를 알리는 발표는 아닙니다. Anthropic은 기억 점검에도 계산 자원이 들며, 무엇을 얼마나 자주 확인할지는 남은 과제라고 설명합니다.
시사점: AI에게 일을 이어 맡길 때는 기억의 근거를 보존하는 것이 도움이 될 수 있습니다. 게임 실험에서 확인한 효과가 실제 업무에서도 얼마나 이어질지는 별도 확인이 필요합니다.
#Claude #AI기억 #오류교정
출처 4💬 @RLanceMartin🔥 @TekonBurns💬 @PawelHurynAnthropic 원문
4. PSI, Anthropic 비공개 모델로 양자컴퓨터 난제 증명했다고 발표
- AI 과학 연구 기업 Physical Superintelligence(PSI)가 11월 6일 Aaronson–Ambainis 추측을 증명했다며 논문과 증명 자료를 공개했습니다. 양자컴퓨터의 계산상 이점에 관한 수학 문제로, 2008년부터 미해결 상태였습니다.
- 연구팀은 자체 연구 시스템이 비공개 Anthropic 모델을 활용해 실행 사흘째 완전한 증명을 얻었다고 밝혔습니다. 모델의 구체적인 이름은 공개하지 않았습니다.
- Lean(수학 증명을 단계별로 검사하는 프로그램)의 검사 통과를 보고했습니다. 사람이 문제를 정하고 논문을 검토했다는 역할도 밝혔습니다.
PSI는 무작위 입력에 예·아니요로 답하는 문제에서, 대부분의 입력에 대해서는 양자컴퓨터가 데이터를 읽는 횟수를 일반 컴퓨터보다 기하급수적으로 줄일 수 없다고 설명합니다. 어떤 문제에서 양자컴퓨터의 큰 이점을 기대할 수 있는지 그 조건을 좁혀 주는 결과입니다. 이 연구가 다루는 이점은 입력을 확인하는 횟수를 기준으로 합니다.
그 밖에: 공개 저장소는 검사 대상 명제가 원래 추측과 일치하는지 사람이 확인해야 한다고 명시합니다. 사람이 읽는 논문 전체의 설명도 기계 검사의 보증 범위에 포함되지 않습니다.
시사점: 연구팀은 AI가 오래된 미해결 문제의 증명에 기여했다는 발표와 함께, 다른 연구자가 재검사할 자료를 공개했습니다. 성과를 평가할 때 사람이 맡은 역할과 공개된 증명 자료를 함께 살펴볼 수 있습니다.
#Anthropic #AI연구 #양자컴퓨팅
출처 4🔥 @MTSlive🔥 @DocumentingAGIPSI 공식 발표증명 자료
5. Arete-27B, Qwen3.8-27B의 정치적 답변 성향을 바꾼 공개 모델 출시
- Nous Research가 Qwen3.8-27B를 추가 훈련한 Arete-27B를 공개했습니다.
- 표현의 자유·민주주의 등 7개 영역의 803개 질문으로 자체 평가한 결과, ‘선전 포함 답변’ 비율이 22%에서 0.9%로 줄었다고 밝혔습니다.
- 개발팀이 실시한 일반 능력·자동 작업 수행 시험에서는 큰 성능 저하를 관찰하지 않았다고 설명합니다.
Nous Research는 ‘서구 가치관 강화’를 훈련 목표로 밝혔습니다. 위 비율은 두 모델 모두 답변 전 별도 사고 과정을 거치는 ‘추론 모드’를 끈 조건에서 비교한 결과입니다. 평가에서는 중국 정부 입장으로 사실을 대체하거나 그 입장을 지지·정당화하는 답변을 ‘선전 포함’으로 분류합니다. 해당 입장임을 밝히며 소개하는 경우는 제외합니다. 이 비율이 줄었다고 모든 주제에서 객관성이 확보됐다는 뜻은 아닙니다.
그 밖에: 모델 파일은 Apache 2.0 라이선스로 공개했습니다. 답변 채점에는 또 다른 AI를 사용했으며, 이번 수치는 개발팀이 설계하고 실행한 자체 평가입니다.
시사점: 공개 모델은 답변의 관점도 선택 대상이 될 수 있습니다. 정치·사회 문제에 활용한다면 평소 묻는 질문을 기존 모델과 나란히 시험하고, 답변 속 사실은 원자료와 대조할 만합니다.
#Arete27B #Qwen38 #모델가치관
출처 4💬 @iamlukethedev🔥 @NousResearch🔥 @NousResearch공식 모델카드
6. 🆕 그 밖의 신기능·신제품 — Antigravity 음성 대화·Higgsfield Miracle
- Google의 AI 개발 도구 Antigravity에 Gemini Live(실시간 음성 대화 모델) 기반 음성 모드가 들어왔습니다. 말로 작업을 맡기고 답을 들을 수 있습니다.
- 앱에서는 AI의 답변 도중 끼어들어 음성으로 방향 수정을 하거나 작업 중단을 요청할 수 있습니다.
- Higgsfield는 기존 영상의 원하는 부분을 고치는 Miracle을 발표했습니다. 선정된 이용자만 참여하는 비공개 시험 단계입니다.
Antigravity 음성 모드는 기존 대화의 맥락을 이어받습니다. 앱에서는 내 컴퓨터에서 작업을 실행하는 대화에만 쓸 수 있습니다. CLI(명령어로 쓰는 도구)에서는 1.5.0 이상이 필요합니다. CLI에서 AI의 말에 끼어들려면 해당 기능을 별도로 켜야 합니다. 파일 삭제 같은 위험한 작업은 화면에서 승인해야 합니다.
그 밖에: Miracle은 물체 색상이나 배경 등 영상 일부를 바꾸는 기능을 준비하고 있습니다. 공식 페이지에서 대기 등록을 받으며, 실시간 편집 속도의 구체적인 측정값은 출시 때 공개할 예정입니다.
시사점: Antigravity 이용자는 작업 중 수정 지시를 말로 전달해 볼 수 있습니다. Miracle은 공개 후 원하는 부분만 바뀌는지와 처리 속도를 확인해야 합니다.
#Antigravity #음성대화 #영상편집
출처 6💬 @_mohansolo🔥 @kevinhou22💬 @higgsfieldGoogle 공식 글음성 모드 공식 문서Miracle 공식 안내
오늘의 감정·온도
오늘의 실무 팁 — 쉽게 풀어 쓴 사용법 6가지
1. AI가 지켜야 할 조건을 따로 적어 둡니다 Muse와 대화하며 정한 조건과 도중에 바꾼 요청을 간단히 기록합니다. 완성한 결과가 그 조건을 지켰는지 대조합니다.
2. 평가 점수는 맡길 일과 함께 봅니다 Inkling 2 Small의 그림 퍼즐 정답률을 일반 업무 성공률로 읽지 않습니다. 웹 제작에 쓴다면 실제로 만들 페이지를 같은 조건으로 맡겨 결과를 비교합니다.
3. 기억을 고칠 수 있게 근거를 남깁니다 AI가 이전 결정을 잘못 설명하면 당시 대화나 작업 기록을 함께 보여 줍니다. 수정한 메모가 다음 작업에도 반영되는지 확인합니다.
4. AI 연구 성과는 공개 자료의 범위를 확인합니다 PSI 사례처럼 증명 검사 결과와 사람이 확인할 부분을 구분합니다. 독립 연구자의 재검토가 나왔는지도 살펴봅니다.
5. 정치·사회 답변은 원자료와 대조합니다 Arete와 기반 모델에 같은 질문을 넣어 사실과 관점이 어떻게 다른지 비교합니다. 더 마음에 드는 답변이라는 이유만으로 사실까지 맞다고 판단하지 않습니다.
6. 음성으로 바꾼 지시가 적용됐는지 확인합니다 Antigravity에서 작업 도중 수정 요청을 말한 뒤 실제 결과를 확인합니다. 파일 삭제 같은 작업은 화면의 승인 내용을 읽고 결정합니다.
📦 확인 방식 수치는 공식 발표·모델카드와 본문에 명시한 외부 평가에서 가져왔습니다. 회사 자체 성능 주장과 연구팀의 증명 성과는 외부 독립 검증 전입니다.
🏷 라벨 가이드 — 🔥 일반 확산 · 🔖 북마크 많음 · 🔁 리트윗 비중 높음 · 💬 댓글 비중 높음 · 🚀 좋아요가 적고 리트윗 비중이 높은 글