AI 브리핑 ·
Shizuku, 말하면서 듣는 음성 AI
5분 브리핑
약 2분 · 5개 흐름무슨 일이 있었고 나에게 무슨 의미인지 먼저 보고, 궁금한 소식은 본문으로 이어 보세요.
전체 분석 7분으로 바로 가기 ↓- Shizuku-Duplex, 말하면서 듣고 끼어들면 멈추는 일본어 음성 AI 데모 공개
내게 의미음성 AI를 살펴볼 때는 답변 속도와 함께 대화 중 끼어들기를 어떻게 처리하는지도 볼 만합니다. 이번에는 일본어 데모가 확인됐으며 한국어 지원은 확인되지 않았습니다.
- Qwen3.8-27B, Tencent DSpine으로 답변 생성 가속 지원
내게 의미Qwen3.8-27B를 직접 실행한다면 가속 도구를 고를 선택지가 늘었습니다. 발표된 배수를 그대로 기대하기보다 평소 작업으로 내 장치에서 비교해 보는 편이 유용합니다.
- llama.cpp, GPU 메모리에 안 들어가는 모델의 실행 개선
내게 의미큰 모델을 직접 실행한다면 장비별 설정 비교를 해볼 만합니다. 수치는 개발자 측정이므로 자신의 PC에서도 같은 모델과 작업으로 속도를 확인해야 합니다.
- Claude Code, 승인 명령의 비밀정보 저장 문제에 예방책 검토
내게 의미Claude Code로 작업을 맡긴 적이 있다면 해당 설정 파일과 과거 업로드 기록을 확인할 만합니다. 노출된 비밀번호·접속 키는 먼저 폐기·재발급하고 파일 공유를 차단해야 하며, 현재 파일만 지워도 과거 기록에는 남을 수 있습니다.
- 🆕 그 밖의 신기능·신제품 — Lyber 모델 이용·Pinky 휴대폰 조작·Rex 파일 전송
Lyber가 답변 거부를 줄였다고 설명하는 Kimi K3.1 Pro 파생 모델을 채팅과 API(다른 프로그램에서 모델을 부르는 연결 방식)로 제공합니다. 저장된 입력 재사용 요금과 사용 한도도 바꿨다고 발표했습니다.
내게 의미Lyber 이용을 검토한다면 요금·잔액과 원하는 도구의 연결 지원을 함께 확인할 만합니다. Pinky·Rex로 기기 간 작업을 맡길 때는 조작 권한과 승인 범위, 파일을 보낼 기기를 확인해야 합니다.
주요 키워드 TOP 5: Shizuku-Duplex · DSpine · llama.cpp · Claude Code · Lyber 모델 이용 | 메인 이벤트: Shizuku AI가 말하는 도중에도 듣고 끼어들기에 반응하는 일본어 음성 대화 데모를 공개했습니다.
Shizuku AI는 AI가 말하는 도중에도 이용자의 소리를 듣고, 맞장구에는 말을 이어 가다가 끼어들기에는 멈추는 일본어 데모를 공개했습니다. 이런 구분이 가능하면 이용자는 AI의 말을 끝까지 기다리지 않고 요청을 바꿀 수 있습니다. 이번에는 데모와 기술 설명이 나왔으며, 일반 이용 가능한 서비스와 한국어 지원은 확인되지 않았습니다. 추가 수집과 공식 자료를 살펴봤지만 오늘 확인된 프론티어 범용 모델의 새 소식은 적습니다.
1. Shizuku-Duplex, 말하면서 듣고 끼어들면 멈추는 일본어 음성 AI 데모 공개
- Shizuku AI가 11월 8일 일본어 음성 대화 모델 Shizuku-Duplex의 개발을 발표하고 데모·기술 설명을 공개했습니다.
- 공개 데모는 말하면서 듣는 대화를 보여 줍니다. 이용자의 맞장구에는 말을 이어 가고, 끼어들기에는 발화를 멈춥니다.
- 대화 도중 웹 검색을 맡기고, 검색이 진행되는 동안에도 대화를 이어 가는 예시를 제시했습니다.
맞장구를 칠 때마다 AI가 말을 멈추면 이야기가 끊기고, 중간에 요청을 바꾸려는데 계속 말하면 이용자가 기다려야 합니다. 이번 발표는 이처럼 말이 겹치는 상황을 다루는 일본어 대화를 보여 줍니다.
회사 설명에 따르면 대화를 맡은 모델과 검색 등 어려운 요청을 처리하는 모델이 따로 움직입니다. 검색 결과를 기다리는 동안 대화를 이어 가다가, 결과가 오면 말로 전달하는 방식입니다.
그 밖에: 회사 자체 평가에서 이용자의 발화가 끝난 뒤 응답을 시작하기까지 걸린 시간의 중앙값은 0.57초이며, 통신 지연을 뺀 서버 녹음 기준입니다. 일반 이용 가능한 서비스나 내려받을 모델 파일의 공개 여부는 확인되지 않았습니다.
시사점: 음성 AI를 살펴볼 때는 답변 속도와 함께 대화 중 끼어들기를 어떻게 처리하는지도 볼 만합니다. 이번에는 일본어 데모가 확인됐으며 한국어 지원은 확인되지 않았습니다.
#ShizukuDuplex #음성AI #자연스러운대화
출처 3🚀 @cumulo_autumn🔥 @studio_yebisuShizuku AI 공식 발표
2. Qwen3.8-27B, Tencent DSpine으로 답변 생성 가속 지원
- Tencent가 Qwen3.8-27B용 보조 모델 DSpine을 공개했습니다. 본 모델이 확인할 답변 초안을 미리 만들어 생성을 빠르게 하는 역할입니다.
- 답변 전 사고량을 낮춘 회사 자체 코드 작업 시험에서는 요청 8개를 동시에 처리한 총처리량이 일반 생성 방식의 2.71배였습니다. 한 사람이 답을 받는 시간이 같은 비율로 줄었다는 뜻은 아닙니다.
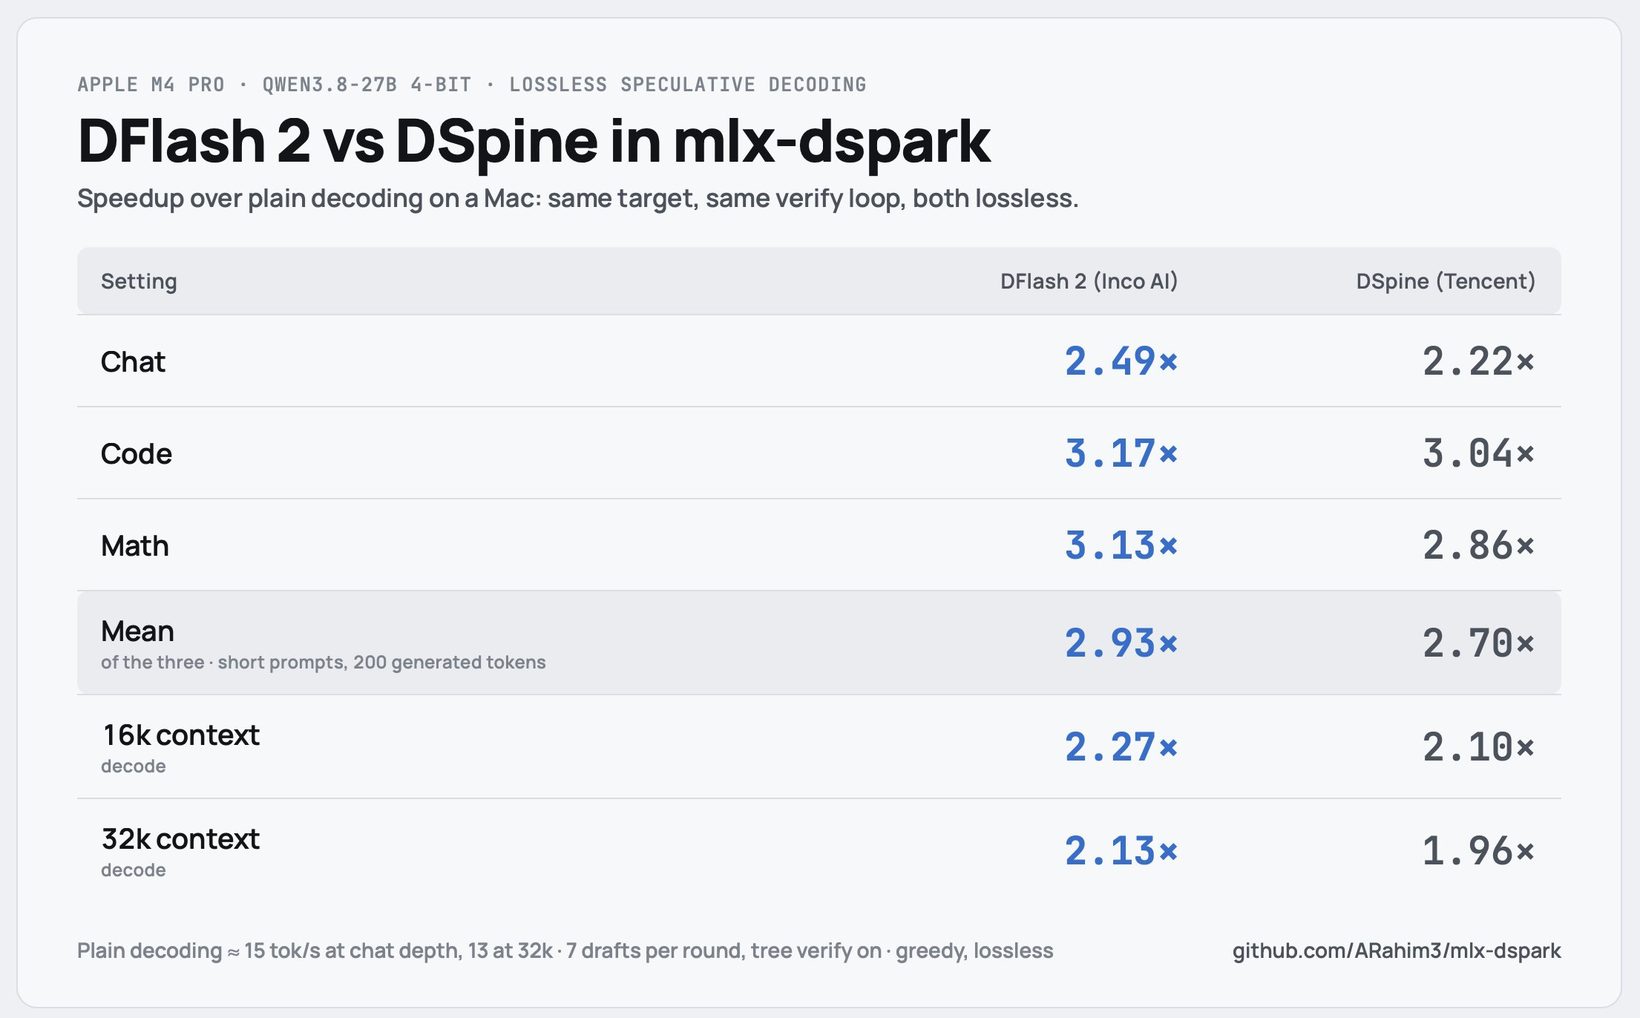
- 별도 M4 Pro 사용자 시험에서는 다른 가속 도구인 DFlash 2가 더 빨랐습니다. 대화·코드·수학의 짧은 입력 시험에서 평균 가속률은 일반 생성 대비 DFlash 2가 2.93배, DSpine이 2.70배였습니다.
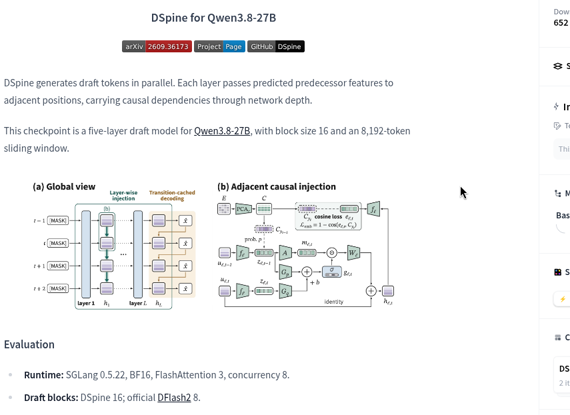
AI는 보통 토큰을 차례로 생성합니다. DSpine은 여러 토큰을 미리 제안하고 Qwen3.8-27B가 이를 확인하게 해 답변 생성을 가속합니다.
Abdur Rahim은 Mac용 실행 도구 mlx-dspark로 시험한 결과, 더 많은 초안을 확인하는 데 드는 계산 부담이 추가 이득을 상쇄했다고 설명합니다. 회사 시험과 개인 시험은 실행 환경과 측정 조건이 달라 수치를 직접 맞대어 우열을 정하기 어렵습니다.
그 밖에: 모델 파일은 Apache 2.0 라이선스로 공개됐습니다. 회사 비교에서도 한 번에 제안하는 초안 크기가 DSpine은 16토큰, DFlash 2는 8토큰으로 달랐습니다.
시사점: Qwen3.8-27B를 직접 실행한다면 가속 도구를 고를 선택지가 늘었습니다. 발표된 배수를 그대로 기대하기보다 평소 작업으로 내 장치에서 비교해 보는 편이 유용합니다.
#Qwen38 #DSpine #답변생성가속
출처 4🔥 @QwenAIFans💬 @_ARahim_Tencent 모델카드Tencent 지원 코드
3. llama.cpp, GPU 메모리에 안 들어가는 모델의 실행 개선
- PC용 AI 실행 도구 llama.cpp가 GPU(그래픽 처리장치) 메모리에 다 담기지 않는 모델의 실행 방식을 개선했습니다. 관련 변경은 한국 시각 11월 8일 정식 코드에 합쳐졌습니다.
- GPU 메모리에 없는 모델 일부를 CPU에서 직접 계산하도록 선택할 수 있습니다. CPU는 PC의 중앙처리장치입니다.
- 개발자의 Qwen3.8-Flash-Next 시험에서 글 생성 속도가 초당 24.2토큰에서 47.6토큰으로 높아졌습니다. GPU 메모리에 자주 쓰는 모델 일부만 담은 조건의 결과입니다.
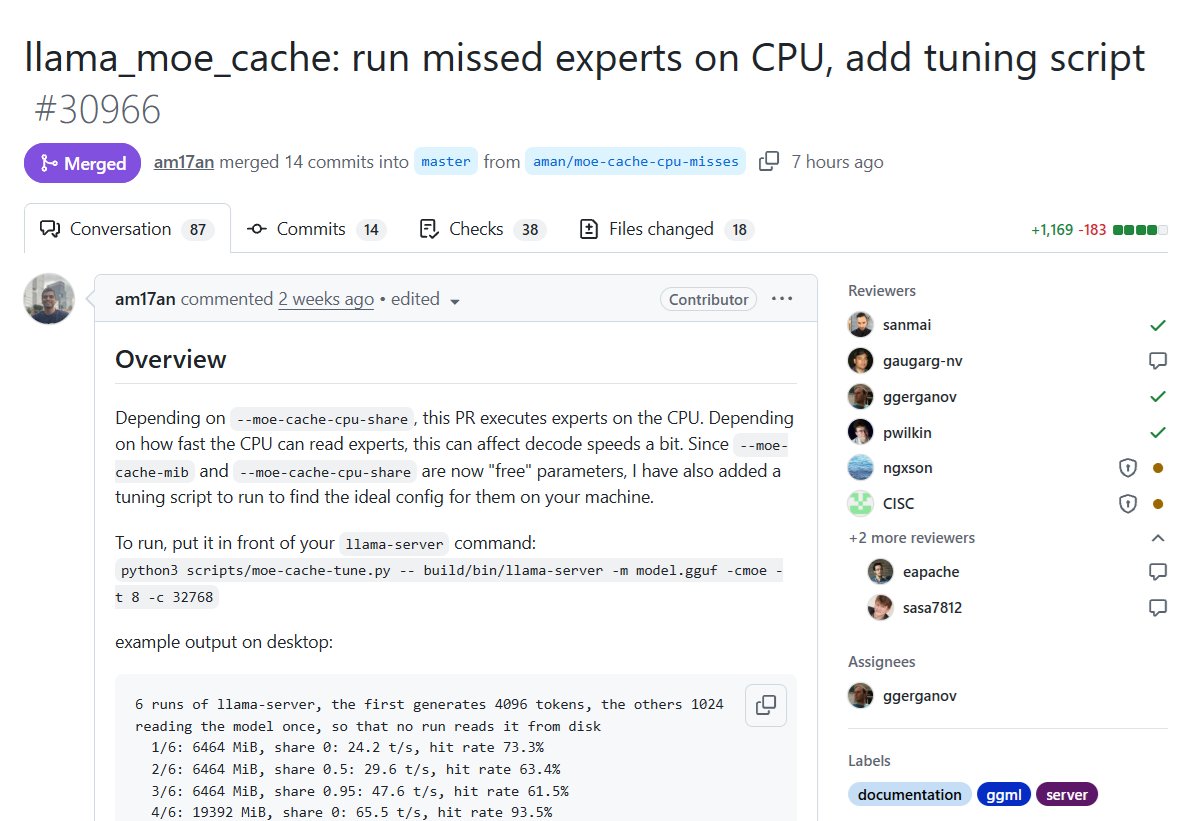
대상은 모델 안에서 필요한 부분만 골라 계산하는 MoE 방식입니다. llama.cpp는 자주 쓰는 부분을 GPU 메모리에 보관합니다. 여기에 없는 부분이 필요하면 데이터를 GPU로 옮기는 데 시간이 들 수 있습니다. 이번 변경은 그중 일부를 CPU가 계산하게 해 데이터 이동 부담을 줄입니다.
위 시험에서는 GPU 메모리에 없는 부분의 계산을 CPU가 맡는 비율을 0%에서 95%로 높였습니다. 기존 PC에서 큰 모델을 돌리는 사람에게 실행 속도를 조절할 선택지가 늘어난 셈입니다.
그 밖에: GPU 메모리에 더 많은 부분을 담은 설정에서는 같은 비율 변경으로 초당 65.5토큰에서 54.1토큰으로 느려졌습니다. 메모리 배정과 CPU 분담을 장비에 맞게 추천하는 조정 스크립트도 함께 추가됐습니다.
시사점: 큰 모델을 직접 실행한다면 장비별 설정 비교를 해볼 만합니다. 수치는 개발자 측정이므로 자신의 PC에서도 같은 모델과 작업으로 속도를 확인해야 합니다.
#llamacpp #로컬AI #실행개선
출처 3🔥 @TeksEdge공식 PR #30966공식 사용 문서
4. Claude Code, 승인 명령의 비밀정보 저장 문제에 예방책 검토
- Claude Code에서 ‘다시 묻지 않기’를 선택하면, 승인한 명령의 비밀번호까지 프로젝트 설정 파일에 저장될 수 있습니다.
- 보안업체 Apiiro는 공개 코드 공유 서비스 GitHub의 해당 설정 파일 1,122개에서 비밀정보 1,379개를 찾았다고 밝혔습니다. 실제 접속 가능 여부를 시험한 수치는 아닙니다.
- Claude Code 책임자 Boris Cherny는 기본 비밀정보 탐지와 자동 승인 모드의 보완을 검토하겠다고 밝혔습니다. 예방책은 검토 단계입니다.
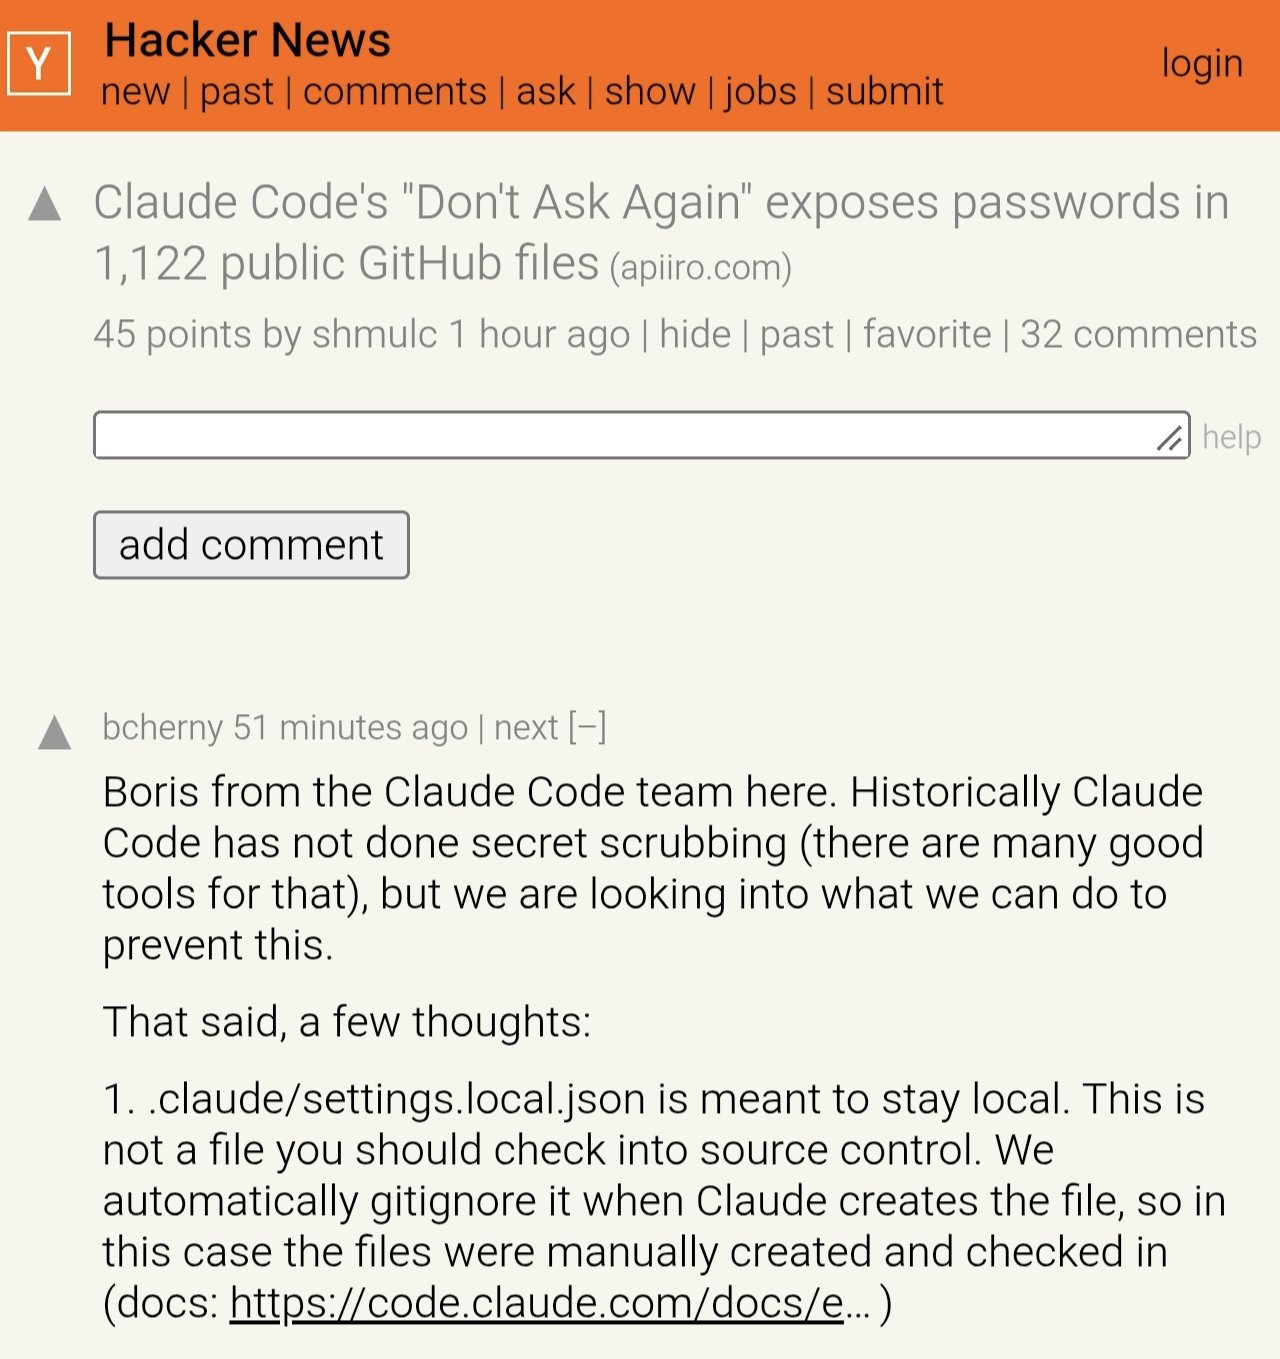
AI에게 데이터베이스에 연결해 확인해 달라고 맡긴 뒤 승인 버튼을 누르는 과정에서 생기는 문제입니다. Claude Code는 같은 명령을 다시 허용하기 위해 .claude/settings.local.json이라는 개인용 설정 파일에 명령을 기록합니다. 명령 안에 비밀번호가 직접 들어 있으면 비밀번호도 함께 저장됩니다. 이 파일을 코드와 함께 GitHub에 올리면 다른 사람이 읽을 수 있습니다.
Apiiro는 파일을 공유 대상에서 자동으로 빼는 장치가 있어도, 이미 공유 대상으로 등록된 파일이나 다른 컴퓨터로 옮긴 프로젝트까지 보호하지는 못한다고 설명합니다.
그 밖에: Paweł Huryn은 자신의 Windows 환경에서 Claude Code가 만든 기존 파일들이 공유 제외 대상에 등록되지 않았다고 보고했습니다. Cherny도 자동 승인 모드에서 같은 문제가 생길 수 있다는 지적을 받고 개선을 검토하겠다고 답했습니다.
시사점: Claude Code로 작업을 맡긴 적이 있다면 해당 설정 파일과 과거 업로드 기록을 확인할 만합니다. 노출된 비밀번호·접속 키는 먼저 폐기·재발급하고 파일 공유를 차단해야 하며, 현재 파일만 지워도 과거 기록에는 남을 수 있습니다.
#ClaudeCode #비밀정보보호 #승인설정
출처 4💬 @PawelHuryn💬 @thecsguyApiiro 원문Boris Cherny 답변
5. 🆕 그 밖의 신기능·신제품 — Lyber 모델 이용·Pinky 휴대폰 조작·Rex 파일 전송
- Lyber가 답변 거부를 줄였다고 설명하는 Kimi K3.1 Pro 파생 모델을 채팅과 API(다른 프로그램에서 모델을 부르는 연결 방식)로 제공합니다. 저장된 입력 재사용 요금과 사용 한도도 바꿨다고 발표했습니다.
- Pinky는 AI 에이전트(도구를 써서 일을 수행하는 AI)가 iPhone·Android 휴대폰을 조작하도록 연결하는 무료 오픈소스 컴퓨터 앱입니다.
- Rex(여러 컴퓨터의 작업을 이어서 관리하는 도구)의 개발자는 기기 사이 파일 끌어놓기·복사와 붙여넣기 기능을 추가했다고 알렸습니다.
Lyber 공식 페이지의 Kimi K3.1 Pro Abliterated 요금은 100만 토큰당 새 입력 4달러·저장된 입력 재사용 0.40달러·출력 15달러입니다. 계정당 동시 요청은 16개이며, 최대 출력은 65,536토큰이라고 안내합니다. 이메일 인증과 유료 이용 잔액이 필요하고 공유 서버 용량의 제약을 받습니다. 파생 모델 제공을 원본 Kimi의 능력 향상으로 볼 수는 없습니다.
Pinky 개발팀은 결제·송금을 사용자 승인 뒤 진행하게 하고, 메시지 전송·삭제도 먼저 묻도록 설정할 수 있다고 설명합니다. 사용자가 컴퓨터에서 휴대폰 조작을 이어받을 수도 있다는 설명입니다. 초기 이용자들은 화면 조작과 앱 안에서 자료를 찾아본 경험을 전했습니다.
Rex 개발자는 Mac Studio에서 만든 프로그램을 다른 기기로 보내 시험하거나, 원격 컴퓨터의 AI에 스크린샷을 전달하는 예를 들었습니다.
그 밖에: Lyber의 답변 거부 감소 주장은 직접 시험하지 않았습니다. Pinky는 초기 시험판으로 기기·기능별 검증이 끝난 상태는 아닙니다. Rex도 시험 제공 중이며 운영체제마다 이용 범위가 다릅니다.
시사점: Lyber 이용을 검토한다면 요금·잔액과 원하는 도구의 연결 지원을 함께 확인할 만합니다. Pinky·Rex로 기기 간 작업을 맡길 때는 조작 권한과 승인 범위, 파일을 보낼 기기를 확인해야 합니다.
#Lyber #Pinky #Rex
출처 9🔁 @LyberAI💬 @LyberAILyber 공식 안내🔥 @brucexu_eth🔁 @shi_jinwei🔥 @almonkPinky 공식 저장소Rex 공식 소개Rex 공식 이용 안내
오늘의 감정·온도
오늘의 실무 팁 — 쉽게 풀어 쓴 사용법 6가지
1. 음성 AI에는 대화 도중 요청을 바꿔 봅니다 맞장구를 칠 때와 말을 멈춰 달라고 할 때 반응이 다른지 살펴봅니다. 일본어 데모의 동작이 한국어에서도 같을 것이라고 가정하지 않습니다.
2. 속도 비교는 평소 쓰는 작업으로 합니다 같은 질문과 답변 길이로 가속 도구를 비교합니다. 여러 요청의 총처리량과 한 사람이 기다리는 시간을 구분합니다.
3. 큰 모델은 장치 설정도 함께 확인합니다 CPU가 계산을 더 맡는 설정이 항상 빠르지는 않습니다. GPU 메모리 배정과 함께 바꿔 보고 실제 속도를 확인합니다.
4. 공개된 비밀번호는 먼저 교체합니다 설정 파일과 과거 업로드 기록을 함께 확인합니다. 이미 노출됐다면 현재 파일 삭제에 앞서 비밀번호나 접속 키를 폐기·재발급합니다.
5. 휴대폰 조작은 승인 범위를 정해 둡니다 Pinky를 시험한다면 결제·송금과 메시지 전송·삭제의 승인 설정부터 확인합니다. 초기 시험판인 만큼 실제 중요한 작업 전에 조작을 직접 살펴봅니다.
6. 파일을 보낼 기기를 확인합니다 Rex로 파일을 옮길 때는 받는 컴퓨터와 파일 내용을 먼저 확인합니다. 작업에 필요한 자료만 보내고, 전달된 파일이 맞는지 확인합니다.
📦 확인 방식 수치는 공식 발표·모델카드·보안 조사와 본문에 명시한 개발자·개인의 시험 보고에서 가져왔습니다. 회사와 개발자의 성능 주장은 외부 독립 검증 전입니다.
🏷 라벨 가이드 — 🔥 일반 확산 · 🔖 북마크 많음 · 🔁 리트윗 비중 높음 · 💬 댓글 비중 높음 · 🚀 좋아요가 적고 리트윗 비중이 높은 글