AI 브리핑 ·
Claude 5.2, 가격 낮추고 더 빠르게
5분 브리핑
약 2분 · 6개 흐름무슨 일이 있었고 나에게 무슨 의미인지 먼저 보고, 궁금한 소식은 본문으로 이어 보세요.
전체 분석 9분으로 바로 가기 ↓- Claude Fable·Mythos 5.2 공개, 가격 낮추고 코딩·추론 개선
내게 의미기존 모델이 어려워했던 작업을 새 버전으로 다시 시험해 볼 만합니다. 평소 맡기는 같은 작업으로 결과의 정확도·대기시간·실제 이용료를 함께 비교하면 모델을 바꿀지 판단하는 데 도움이 됩니다.
- Muse Ember 출시, Haiku급 평가 점수에 작업당 비용 약 3분의 1
내게 의미문서 읽기나 코드 수정을 자주 맡긴다면 반복 업무용 선택지가 늘었습니다. 평소 쓰는 작업으로 결과의 정확도와 총요금을 함께 비교해야 하며, 평가에서 나온 3분의 1 비율이 내 업무에도 그대로 적용되지는 않습니다.
- Claude Haiku·GPT-6 Luna, 새 문서 판단 시험에서 전문 모델 앞서
내게 의미서류 업무용 AI를 고른다면 개별 질문의 정답률과 함께 문서 한 장을 끝까지 정확히 처리한 비율을 확인할 만합니다. 이번 결과는 정해진 시험 조건의 외부 측정값이며, 실제 업무에서는 비용·대기 시간과 사람이 검토할 범위도 함께 비교해야 합니다.
- Nuplex 1.0·Emma 공개, 말하는 도중 표정으로 반응하는 영상 대화
내게 의미영상 대화 AI를 평가할 때는 답변 내용과 함께 내가 말하는 동안 어떻게 반응하는지도 살펴볼 만합니다. 자연스러운 표정이 답변의 정확성까지 보장하지는 않습니다.
- Google TPU 8tx·8i Max 발표, 민감한 데이터 처리와 긴 입력에 맞춘 시스템
내게 의미기업이 AI에 맡길 업무를 넓히려면 자료 처리 중의 보안과 큰 입력을 감당할 장비도 함께 살펴야 합니다. 이번 발표는 민감 자료와 긴 작업에 맞춘 선택지를 제시합니다.
- 🆕 그 밖의 신기능·신제품 — Unreal Engine 5.9 MegaJam Preview·HeyGen 모델 체험·Exact
Unreal Engine 5.9 MegaJam Preview는 게임 제작 화면 안에서 AI 코딩 도구와 함께 작업하는 기능을 제공합니다. 정식판이 아닌 시험판이며, 해당 기능도 실험 단계입니다.
내게 의미제작 도구를 고를 때 체험과 실제 사용 조건을 함께 살펴볼 만합니다. HeyGen은 모델 체험과 API 연결을 소개하며, Unreal Engine과 Exact는 시험 단계라는 조건이 붙습니다.
주요 키워드 TOP 5: Claude 5.2 · Muse Ember · 문서 판단 평가 · Nuplex · Google TPU | 메인 이벤트: Anthropic이 Claude Fable·Mythos 5.2를 공개하고 이용료를 낮췄습니다.
Anthropic은 Claude Fable·Mythos 5.2의 이용료를 낮추면서 답변 생성도 빨라졌다고 발표했습니다. 복잡한 코드 수정이나 자료 분석을 맡길 때 비용과 기다리는 시간이 함께 부담이 되는 만큼, 기존 모델이 어려워했던 작업을 다시 비교해 볼 이유가 생겼습니다. 다만 성능 개선은 회사 측 평가이며, Fable과 Mythos의 이용 가능 범위도 다릅니다. 보조 수집과 공식 자료까지 확인했지만, 오늘 확인된 범용 모델의 새 출시는 Anthropic과 Meta의 발표에 집중됐습니다. 아래 시각은 수집된 발표·평가 게시물의 한국 시각(KST) 기준입니다.
1. Claude Fable·Mythos 5.2 공개, 가격 낮추고 코딩·추론 개선
- Anthropic이 Claude Fable 5.2와 Claude Mythos 5.2를 공개했습니다. 회사에 따르면 코딩·추론·이미지 이해가 개선됐으며, 각각의 5.1 버전보다 출력 속도가 최대 30% 빨라졌습니다.
- 두 모델의 API(다른 프로그램에서 모델을 호출하는 연결 방식) 이용료를 내렸습니다. 100만 토큰당 입력 8달러·출력 40달러입니다.
- Fable은 일반 제공하며, Mythos는 보안·생명과학 연구를 위해 심사를 거친 조직에 제공합니다. 공개 범위가 다릅니다.
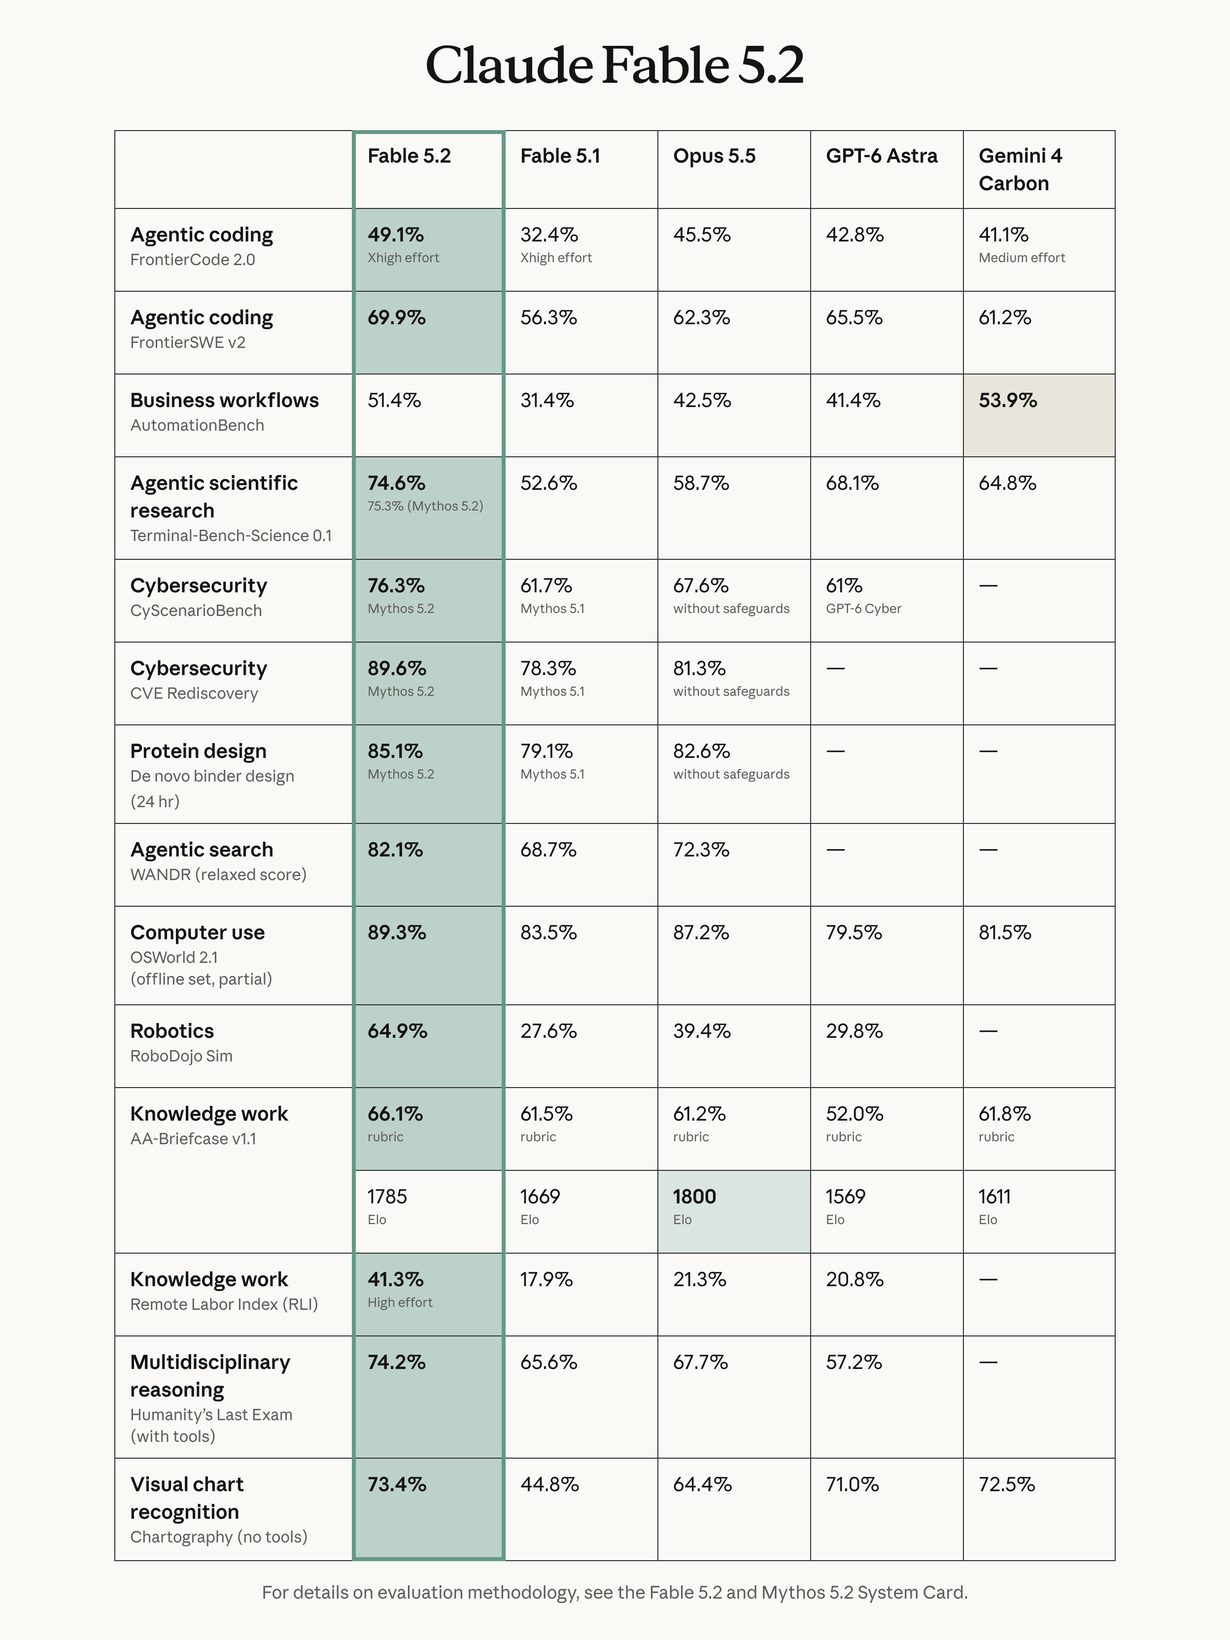
복잡한 코드 수정이나 자료 분석을 맡기는 이용자에게는 비용과 대기시간을 함께 비교할 이유가 생겼습니다. 두 제품은 같은 기본 모델을 바탕으로 하며, Fable에는 사이버보안·생물학 분야의 악용 방지 장치가 적용됩니다.
Anthropic은 일상적인 코딩·지식 작업은 Claude Opus 5.5로 시작하고, 더 어려운 작업에서 Fable이나 Mythos를 쓰라고 권합니다. 회사는 출시 전 외부 평가기관의 시험도 거쳤다고 밝혔습니다. 표의 성능 수치는 회사 측 평가이며, 실제 작업에서의 효과는 별도로 확인해야 합니다.
그 밖에: 선택형 고속 모드는 토큰 생성 속도를 최대 2.5배로 높인다는 설명입니다. 요금은 100만 토큰당 입력 16달러·출력 80달러로 일반 모드보다 높습니다.
시사점: 기존 모델이 어려워했던 작업을 새 버전으로 다시 시험해 볼 만합니다. 평소 맡기는 같은 작업으로 결과의 정확도·대기시간·실제 이용료를 함께 비교하면 모델을 바꿀지 판단하는 데 도움이 됩니다.
#ClaudeFable #ClaudeMythos #모델이용료
출처 6💬 @claudeai🔥 @claudeai🔥 @claudeaiAnthropic 공식 발표공식 모델 문서🔥 @Ronny_MiniMax
2. Muse Ember 출시, Haiku급 평가 점수에 작업당 비용 약 3분의 1
- Meta가 반복 업무용 모델 Muse Ember를 출시했습니다. 코딩 도구 Muse Code와 Meta Model API에서 쓸 수 있습니다.
- 독립 평가기관 Artificial Analysis의 Intelligence Index(여러 능력 시험을 합친 종합 지표)에서 약 36점으로 Claude Haiku 5.5와 비슷했습니다. 두 모델 모두 답변 전 생각에 쓰는 계산량을 최대로 설정한 결과입니다. 평가 작업당 평균비용은 약 0.14달러로, Haiku의 약 0.41달러 대비 3분의 1 수준입니다.
- 한 번에 약 100만 토큰을 다루며 글·이미지·음성·영상을 입력받습니다. 기본 요금은 100만 토큰당 입력 0.10달러·출력 0.50달러입니다.
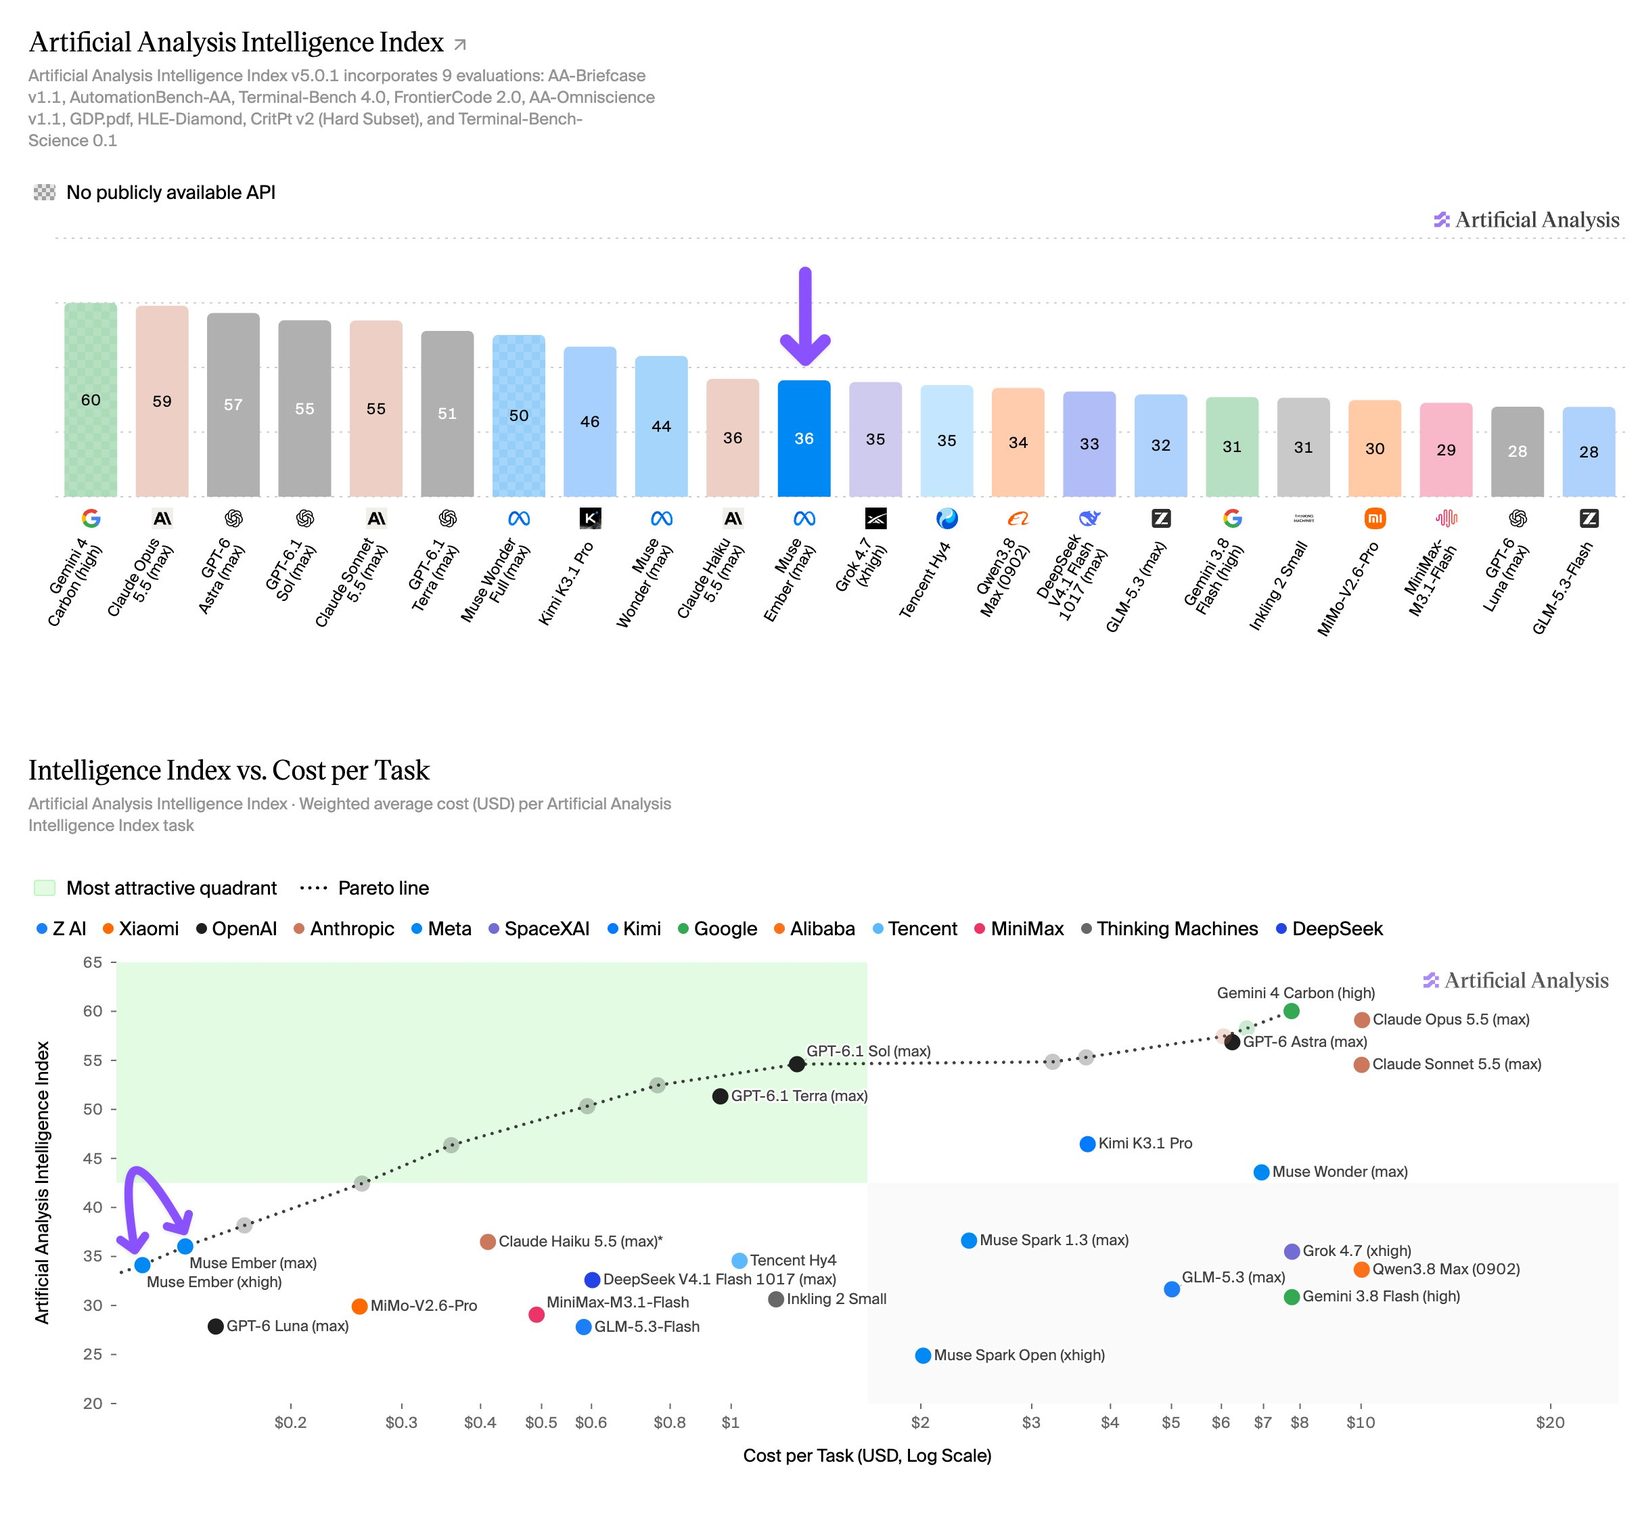
문서에서 필요한 항목을 뽑거나 코드의 작은 수정을 반복할 때는 요청마다 드는 비용이 쌓입니다. Ember와 Haiku의 기본 토큰 단가는 동일하지만, 이번 평가의 작업당 평균비용에는 차이가 났습니다. 여러 평가 과제의 비용을 종합한 값이므로 실제 업무의 청구액과 구분해야 합니다.
종합 점수는 정답률을 뜻하지 않으며, 점수가 비슷하다고 모든 능력이 같은 수준은 아닙니다. 코드 변경을 실제 프로젝트에 반영할 수 있는지 보는 한 시험에서는 Ember가 뒤졌지만, 다른 코딩 시험에서는 앞섰습니다. Artificial Analysis는 지식 질문에서 답변을 거절하는 비율도 높았다고 보고했습니다.
그 밖에: Meta는 Muse Wonder Full을 활용해 학습한 첫 출시 모델이라고 설명했으며, OpenCode도 Ember 지원을 알렸습니다. 공식 API 문서에 따르면 입력이 20만 토큰을 넘는 요청에는 더 높은 요금이 적용됩니다.
시사점: 문서 읽기나 코드 수정을 자주 맡긴다면 반복 업무용 선택지가 늘었습니다. 평소 쓰는 작업으로 결과의 정확도와 총요금을 함께 비교해야 하며, 평가에서 나온 3분의 1 비율이 내 업무에도 그대로 적용되지는 않습니다.
#MuseEmber #작업당비용 #반복업무
출처 8🔥 @AIatMeta💬 @ArtificialAnlys🔥 @alexandr_wang💬 @alexandr_wang🔥 @opencodeMeta 공식 발표Meta API 문서💬 @garrytan
3. Claude Haiku·GPT-6 Luna, 새 문서 판단 시험에서 전문 모델 앞서
- 독립 평가기관 Artificial Analysis의 Decision Index v2(문서 판단 등 여러 능력을 묶은 시험)에서 Claude Haiku 5.5 (Max)는 77점, GPT-6 Luna (Max)는 76점을 기록했습니다. 선택지에서 답을 고르는 전문 판단 모델 Drex Max v1.1은 73점입니다.
- 새 문서 시험 AA-Paperclip은 이력서·영수증·송장·연구 논문 1,500개를 씁니다. 문서마다 판단 5개와 사실 추출 10개를 모두 맞혀야 통과합니다.
- 평가기관 발표에서 문서 전체 정답률은 Haiku 92%, Luna 86%, Drex Max 63%였습니다. 정답 여부와 모델이 답에 부여한 확신도를 함께 반영한 종합 점수와는 별도 수치입니다.
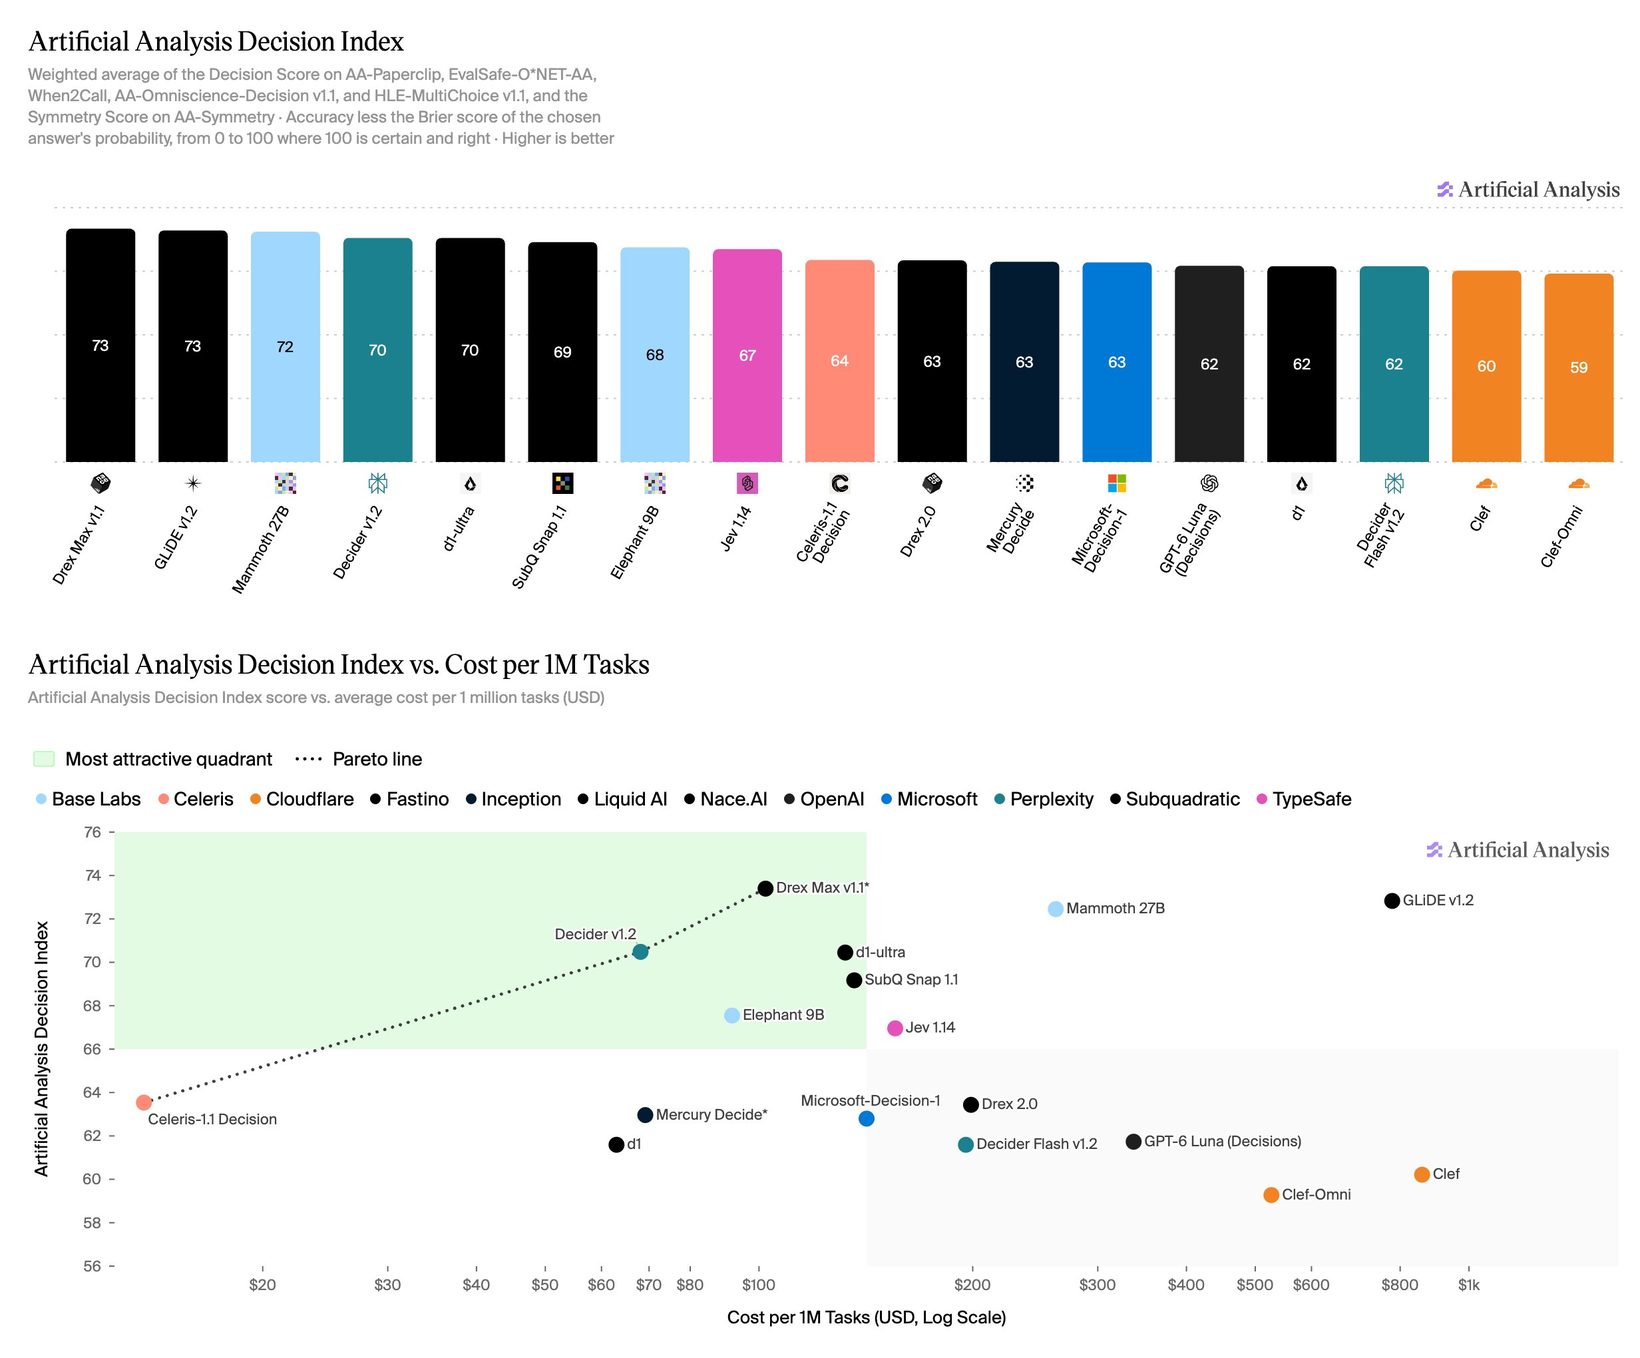
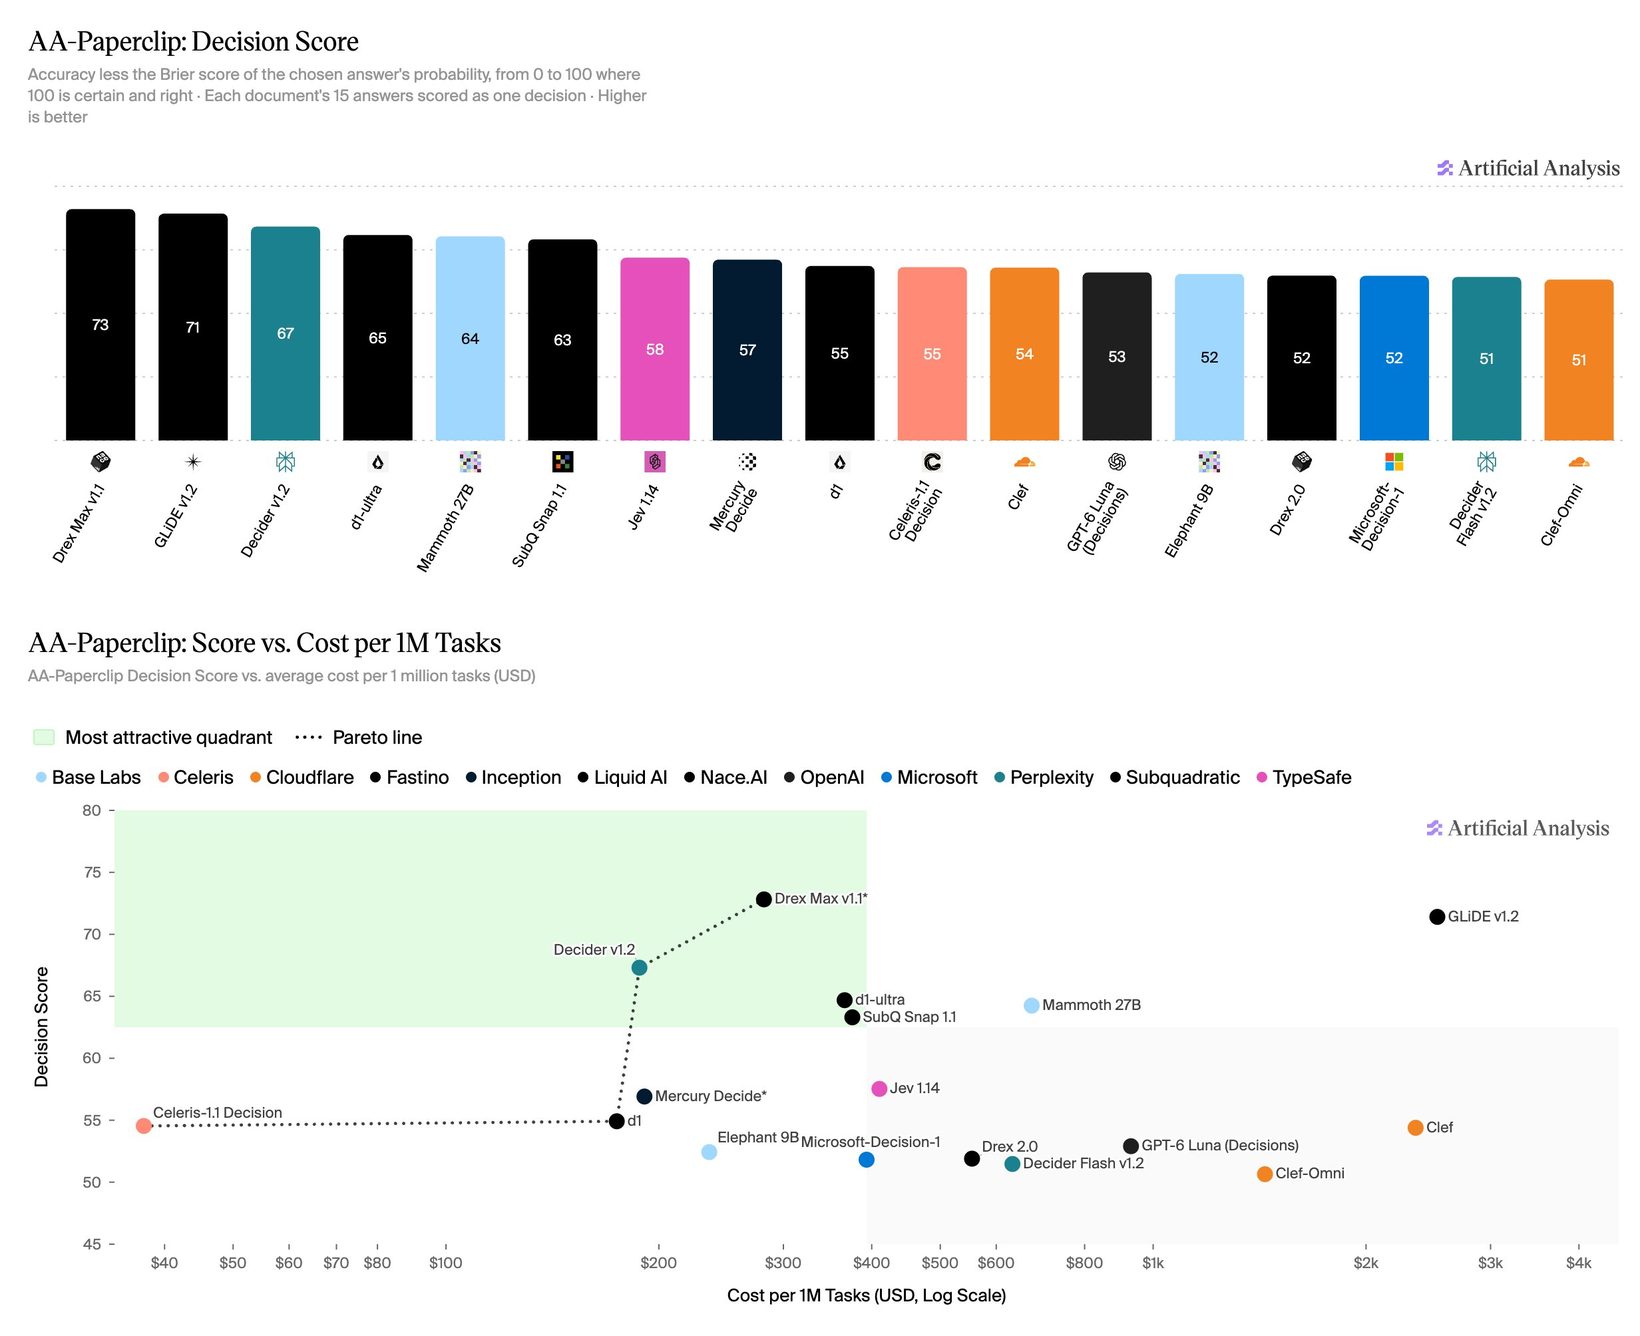
문서에서 금액을 찾아내는 일과 규정에 맞춰 처리 여부를 판단하는 일은 함께 필요할 수 있습니다. 이 시험은 문서 한 장의 답을 전부 맞혔는지 확인해, 개별 답의 정확도만 보면 작아 보이던 차이를 드러냅니다. Drex Max는 개별 답의 97%를 맞혀 Haiku의 99%와 가까웠지만, 문서 전체를 통과한 비율에서는 차이가 컸습니다.
확신도를 함께 채점하는 이유도 실무와 연결됩니다. AI가 확신이 낮은 답을 사람에게 넘기려면 확신과 실제 정답률이 잘 맞아야 하기 때문입니다.
그 밖에: 종합 지수 기준 Luna (Max)는 Drex Max v1.1보다 작업당 비용이 약 15배, 소요 시간이 약 40배였습니다. 정확도가 높아도 같은 비용과 속도로 쓸 수 있다는 뜻은 아닙니다.
시사점: 서류 업무용 AI를 고른다면 개별 질문의 정답률과 함께 문서 한 장을 끝까지 정확히 처리한 비율을 확인할 만합니다. 이번 결과는 정해진 시험 조건의 외부 측정값이며, 실제 업무에서는 비용·대기 시간과 사람이 검토할 범위도 함께 비교해야 합니다.
#문서AI #독립평가 #업무자동화
출처 5💬 @ArtificialAnlys💬 @ArtificialAnlys💬 @ArtificialAnlys평가 설명문서 시험 설명
4. Nuplex 1.0·Emma 공개, 말하는 도중 표정으로 반응하는 영상 대화
- Nuance Labs가 음성·영상 모델 Nuplex 1.0과 이를 바탕으로 만든 AI 대화 캐릭터 Emma를 공개했습니다. 듣기와 말하기를 동시에 처리하는 모델이며, 이용 범위를 제한한 시험 공개입니다.
- 회사 설명에 따르면 Emma는 상대가 말하는 도중에도 반응합니다. 얼굴 표정과 시선으로 듣고 있다는 신호를 보내고, 말할 차례를 주고받도록 설계했습니다.
- 회사는 체험 페이지와 Nuplex Beta API를 안내했습니다. 현재 영어만 지원하고 18세 이상 대상이며, 공식 지원 지역에 한국은 포함되지 않습니다.
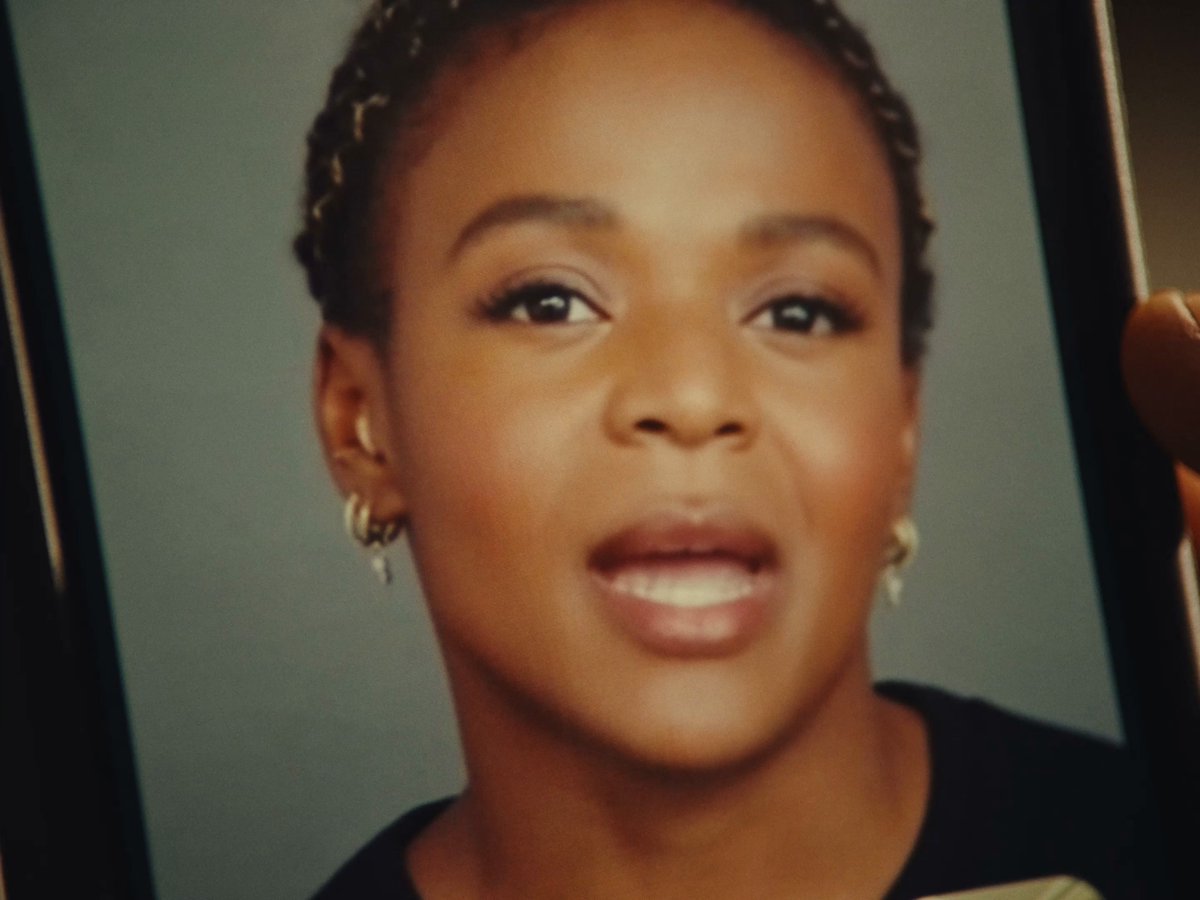
사람과 영상 통화를 할 때는 상대가 입을 열기 전에도 눈빛과 고개 움직임을 보고 말을 이어 갈지 판단합니다. Emma는 이런 비언어적 신호를 AI 대화에 넣으려는 시도입니다.
회사는 실제 배우와 협업해 얼굴과 목소리를 만들고, 눈 깜빡임이나 고개 움직임까지 캐릭터에 맞게 설계했다고 설명합니다. 소개한 동작은 회사 발표와 데모에 근거하며, 실제 통화나 API 이용은 직접 시험하지 않았습니다.
그 밖에: 회사는 Emma가 대화 중 너무 일찍 끼어들거나 늦게 반응할 수 있다고 밝힙니다. 연결 상태가 좋지 않으면 입 모양·시선·고개 움직임이 어색해질 수도 있다고 설명합니다.
시사점: 영상 대화 AI를 평가할 때는 답변 내용과 함께 내가 말하는 동안 어떻게 반응하는지도 살펴볼 만합니다. 자연스러운 표정이 답변의 정확성까지 보장하지는 않습니다.
#Nuplex #Emma #영상대화AI
출처 3🔁 @fangchangma🔥 @omarsar0Nuance Labs 공식 발표
5. Google TPU 8tx·8i Max 발표, 민감한 데이터 처리와 긴 입력에 맞춘 시스템
- Google이 11월 9일 AI 계산용 전용 칩인 TPU의 새 시스템 8tx와 8i Max를 발표했습니다. 기존 8세대 칩을 활용해 구성·보안·메모리를 바꾼 시스템입니다.
- TPU 8tx는 계산 중에도 민감 데이터와 모델 정보를 보호하도록 설계했습니다. 정부와 규제 산업에서 비공개 자료로 AI를 실행하는 용도를 겨냥합니다.
- TPU 8i Max는 방대한 코드나 긴 영상을 한꺼번에 다루도록 메모리에서 데이터를 읽고 보내는 능력을 키웠습니다.
파일을 보관하거나 전송할 때 암호화해도, 컴퓨터가 계산하려면 메모리에서 내용을 풀어야 하는 경우가 많습니다. Google은 8tx에서 이 처리 구간까지 하드웨어로 격리해 계산 중 데이터 보호를 제공한다고 설명합니다.
민감 자료를 별도 시스템 사이로 옮기지 않고도 모델을 업무에 맞게 조정하고 실행할 수 있다는 구상입니다.
그 밖에: 8i Max는 TPU 8i 칩 2개를 하나로 묶었습니다. 회사가 제시한 2배는 8i 대비 계산 능력과 메모리 대역폭, 즉 일정 시간에 옮길 수 있는 데이터양에 관한 수치입니다.
시사점: 기업이 AI에 맡길 업무를 넓히려면 자료 처리 중의 보안과 큰 입력을 감당할 장비도 함께 살펴야 합니다. 이번 발표는 민감 자료와 긴 작업에 맞춘 선택지를 제시합니다.
#GoogleTPU #데이터보호 #긴입력
출처 4🔥 @googlecloud🔥 @sundarpichai💬 @mark_kGoogle 공식 발표
6. 🆕 그 밖의 신기능·신제품 — Unreal Engine 5.9 MegaJam Preview·HeyGen 모델 체험·Exact
- Unreal Engine 5.9 MegaJam Preview는 게임 제작 화면 안에서 AI 코딩 도구와 함께 작업하는 기능을 제공합니다. 정식판이 아닌 시험판이며, 해당 기능도 실험 단계입니다.
- HeyGen이 개발자용 Platform과 모델 체험 공간 Playground 공개를 알렸습니다. 기존 영상·음성·아바타(화면 속 디지털 인물) 모델을 시험한 뒤 API로 이어 쓸 수 있다는 발표입니다.
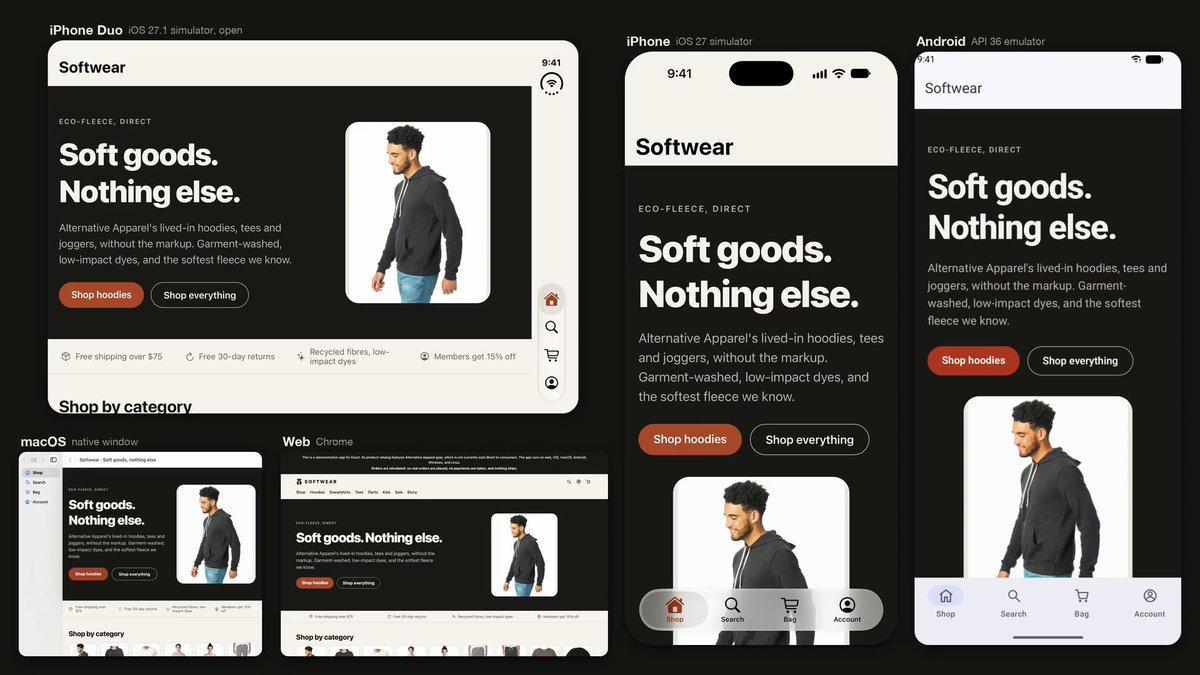
- Exact는 같은 앱을 웹·macOS·iOS·Linux에서 실행하도록 만드는 도구입니다. AI가 앱을 만들고 화면을 조작해 시험하도록 설계됐습니다.
Unreal Engine에서는 Unreal Assistant라는 편집기 패널에 평소 쓰는 AI 코딩 도구를 연결해 작업을 맡깁니다.
그 밖에: Unreal Engine 공식 공지는 불안정할 수 있는 시험판인 만큼 프로젝트 복사본에서 시험하라고 권합니다. Exact도 기능과 사용 방식이 계속 바뀌는 초기 시험판입니다.
시사점: 제작 도구를 고를 때 체험과 실제 사용 조건을 함께 살펴볼 만합니다. HeyGen은 모델 체험과 API 연결을 소개하며, Unreal Engine과 Exact는 시험 단계라는 조건이 붙습니다.
#UnrealEngine #HeyGen #Exact
출처 7🚀 @UnrealEngine🔁 @HeyGenDev🔥 @expoUnreal Engine 공식 공지HeyGen 공식 안내Exact 공식 저장소💬 @tianyi
오늘의 감정·온도
오늘의 실무 팁 — 쉽게 풀어 쓴 사용법 6가지
1. 모델 비교에는 같은 작업을 씁니다 「Your coding agents made you a manager」는 AI에게 일을 맡길 때도 팀을 관리하는 역량이 필요하다고 설명합니다. 새 모델을 비교할 때도 원하는 결과와 완료 기준을 먼저 적고 같은 요청을 사용합니다.
2. 비용 절감 글은 조건부터 읽습니다 「How to Cut Your Agent Bill by 90% With Jev Engineering and Kimi K3」는 작업에 따라 모델을 골라 쓰는 방법을 소개하는 글이며, 제목의 절감률은 이 리포트에서 검증한 수치가 아닙니다. Ember의 평가 비용 비율이나 이 주장을 내 업무에 적용하기 전에 결과의 정확도와 실제 청구액을 함께 봅니다.
3. 플러그인이 필요한 기능을 먼저 정합니다 「Growing Together with Our Plugin Community」에서 DeepSeek Harness는 기본 기능도 외부 플러그인으로 대체할 수 있다고 설명합니다. 플러그인(기능을 추가하는 확장 도구)을 고를 때는 기존 기능으로 충분한지와 내 작업에 필요한 차이를 먼저 확인합니다.
4. 서류는 질문별 점수와 전체 완료를 나눠 봅니다 금액 추출과 처리 여부 판단이 모두 필요한 문서로 시험합니다. 답을 일부 맞힌 비율과 문서 한 장을 완전히 처리한 비율을 구분하고, 사람이 검토할 범위를 정합니다.
5. 영상 대화는 지원 지역과 언어를 확인합니다 Emma는 영어·성인 대상의 제한된 시험 공개이며 한국은 공식 지원 지역에 포함되지 않습니다. 표정이 자연스럽다는 이유만으로 답변 내용까지 정확하다고 판단하지 않습니다.
6. 제작 도구 시험판은 복사본에서 씁니다 Unreal Engine의 새 기능은 중요한 원본 프로젝트를 복사해 시험합니다. Exact도 초기 시험판인 만큼 실제 배포에 쓸 기능과 이용 조건을 먼저 살펴봅니다.
📦 확인 방식 수치는 회사 공식 발표와 Artificial Analysis의 독립 평가에서 가져왔으며 두 종류를 본문에서 구분했습니다. 회사가 발표한 성능 개선과 데모의 실제 업무 효과는 외부 독립 검증 전입니다.
🏷 라벨 가이드 — 🔥 일반 확산 · 🔖 북마크 많음 · 🔁 리트윗 비중 높음 · 💬 댓글 비중 높음 · 🚀 좋아요가 적고 리트윗 비중이 높은 글